预计阅读 3 分钟
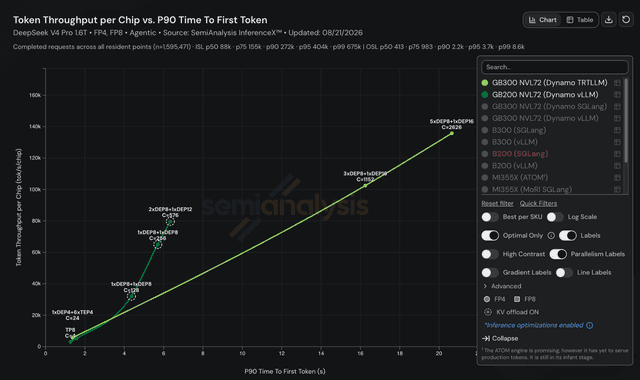
DeepSeek V4 Pro 的 AgentX 结果:GB200 与 GB300 的机架级分离式部署
两者都依赖 PD 分离,GB300 额外使用 DEP32 宽专家并行解码,而差距体现在首 token 延迟而非 token 速率上
- agentx
- agentic
- benchmark
- +8
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
7 篇文章
预计阅读 3 分钟
两者都依赖 PD 分离,GB300 额外使用 DEP32 宽专家并行解码,而差距体现在首 token 延迟而非 token 速率上
预计阅读 3 分钟
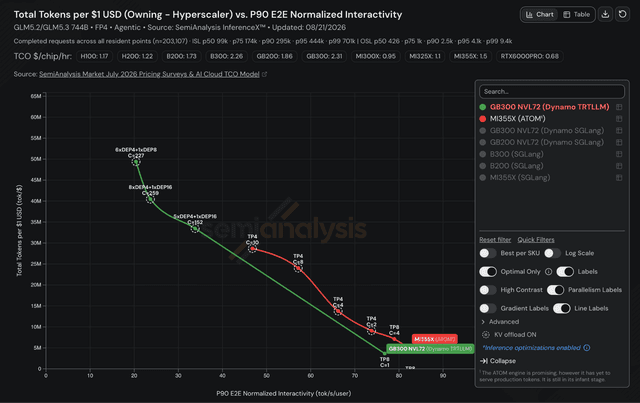
AMD 厂商引擎在每美元性能上胜出的区间,以及端到端归一化交互性究竟衡量什么
预计阅读 2 分钟
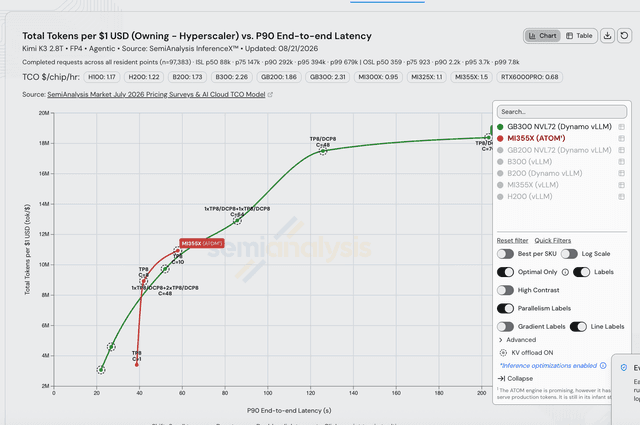
AMD 的厂商引擎在每美元性能前沿上赢下了实打实的一段,而 Hopper 连服务 K3 都很吃力
预计阅读 3 分钟
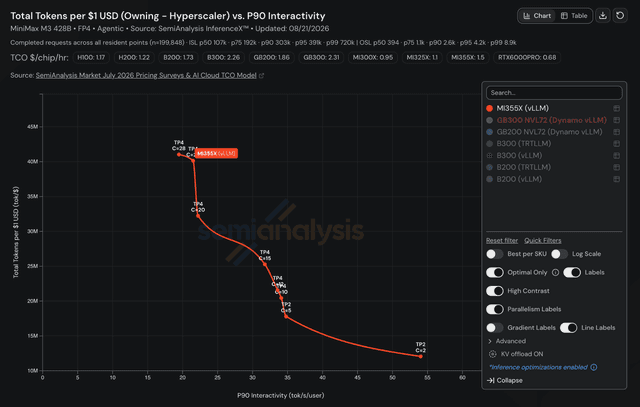
Dynamo router 成为瓶颈,没有提交使用上下文并行,而 AMD 完全没有用上 KV offload

预计阅读 11 分钟
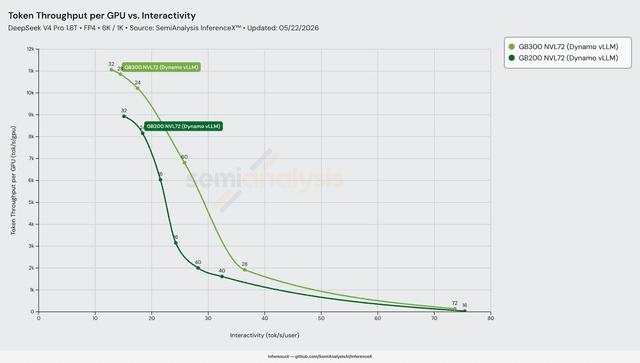
DSv4-Pro FP4 8K/1K,Dynamo+vLLM,两套机架均采用分离式部署。GB300 多出 50% 的 HBM(每 GPU 288 GB vs 192 GB)解锁了 GB200 无法容纳的更宽预填充+解码配方——尽管单 GPU TCO 溢价 20%,曲线中段性价比仍提升 2.31 倍。

预计阅读 9 分钟
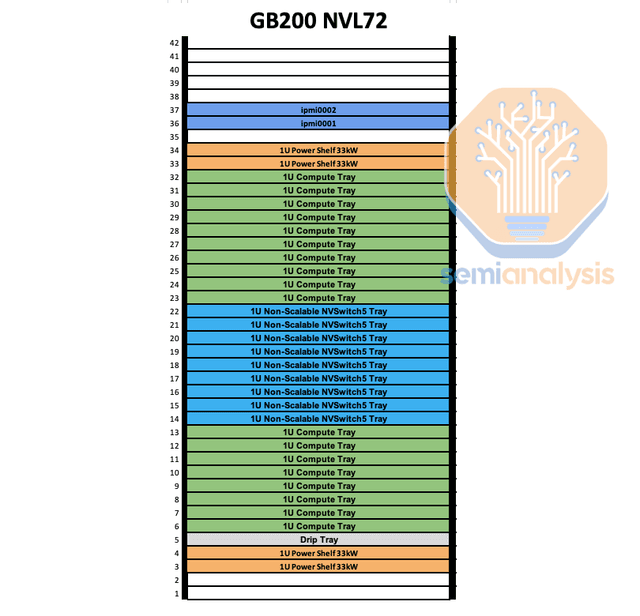
DeepSeek R1 FP4 1k/1k。NVL72 的 72-GPU NVLink 扩展域允许解码使用最高 EP=32 的宽专家并行,而 B200 的 8-GPU NVLink 岛通过 RoCEv2 上限为 EP=8

预计阅读 7 分钟
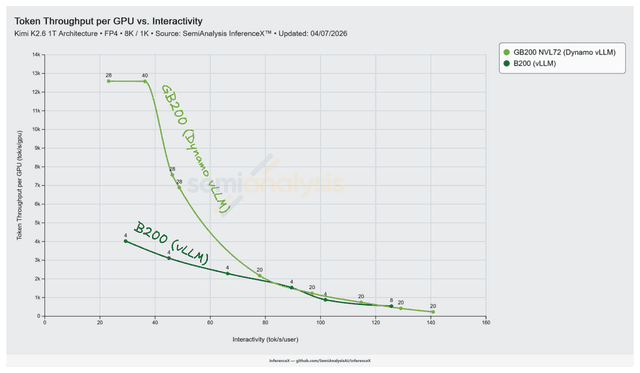
NVL72 的机架级 NVLink 使 Dynamo vLLM 能够以最高 Decode EP 16 运行 Kimi K2.5 宽 EP,在 8k/1k NVFP4 下峰值吞吐量从 4,021 提升至 12,587 tok/s/GPU