预计阅读 3 分钟
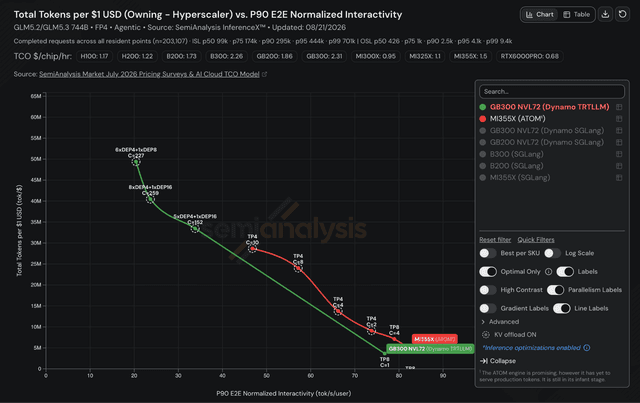
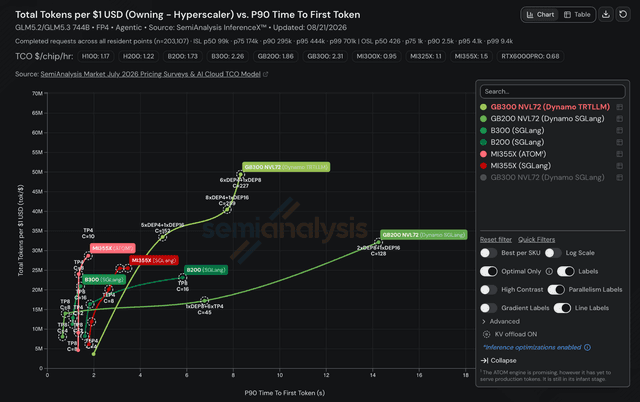
GLM 5.3 的 AgentX 结果:MI355X ATOM 在部分曲线上胜过 GB300 NVL72
AMD 厂商引擎在每美元性能上胜出的区间,以及端到端归一化交互性究竟衡量什么
- agentx
- agentic
- benchmark
- +9
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
5 篇文章
预计阅读 3 分钟
AMD 厂商引擎在每美元性能上胜出的区间,以及端到端归一化交互性究竟衡量什么
预计阅读 2 分钟
在这个运行点上,即便 AMD 硬件白送也仍然填不平差距
预计阅读 20 分钟
运行在 NVIDIA GPU 上的 TileRT 软件能否与 Cerebras、Groq LPU、SambaNova 竞争?批大小为 1、分离式引擎、高吞吐量预填充引擎、高交互性解码引擎

预计阅读 11 分钟
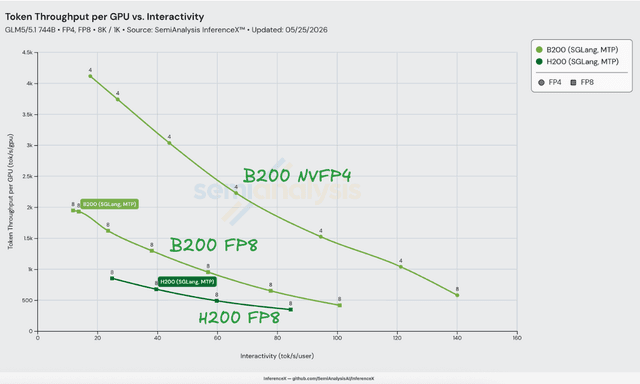
两款 GPU 均运行 SGLang EAGLE MTP;Blackwell 世代在峰值处带来约 1.2 倍的性价比提升,NVIDIA GLM-5-NVFP4 检查点搭配 FlashInfer TRT-LLM 稀疏 MLA 在 8K/1K 场景下再叠加约 2.4–3.0 倍优势

预计阅读 7 分钟
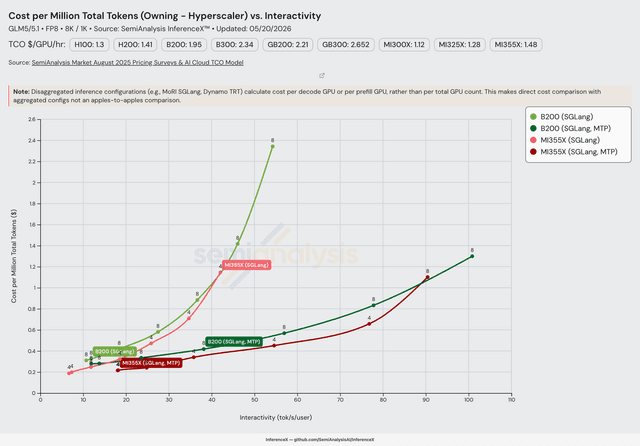
GLM-5 发布 14 周后,AMD 在 MI355X 上同时实现了 SGLang FP8 的 MTP 和非 MTP 方案 — 通过 TileLang 实现的融合 MLA + FP8 KV 缓存在大部分性能 Pareto 前沿上将单节点 FP8 成本曲线翻转为 AMD 占优