预计阅读 2 分钟
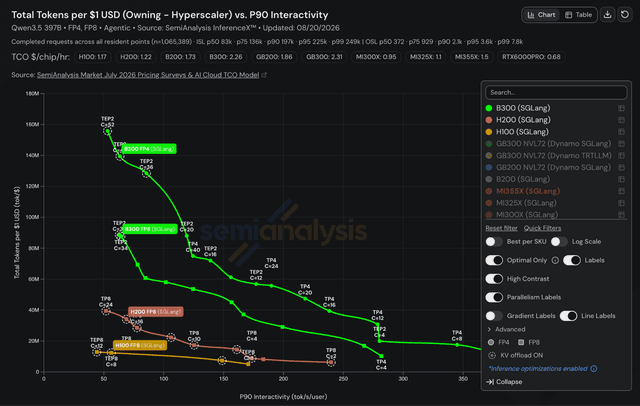
Qwen3.5 397B 的 AgentX 结果:B300 FP4 的每美元性能是 H100 的 12 倍
在长上下文 agentic 工作负载上,四年硬件迭代加上 4 位格式能换来什么
- agentx
- agentic
- benchmark
- +9
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
2 篇文章
预计阅读 2 分钟
在长上下文 agentic 工作负载上,四年硬件迭代加上 4 位格式能换来什么

预计阅读 13 分钟
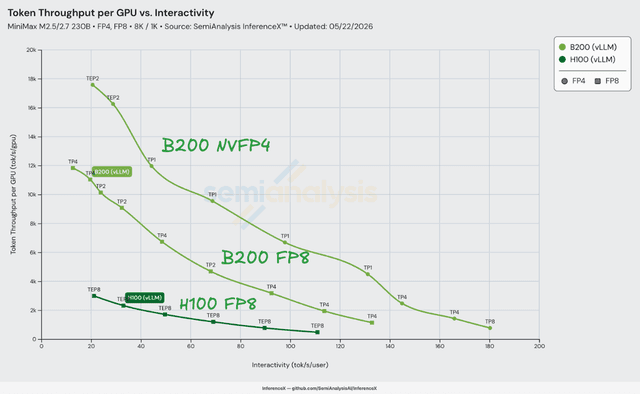
vLLM PR #36307 为 MiniMax 在 B200 上解锁了 trtllm-gen FP8 MoE 模块化内核;结合 NVFP4,在 8K/1K 负载下性能/成本从 22 tok/s/user 时的 4.0 倍扩大到 110 tok/s/user 时的 8.2 倍