预计阅读 3 分钟
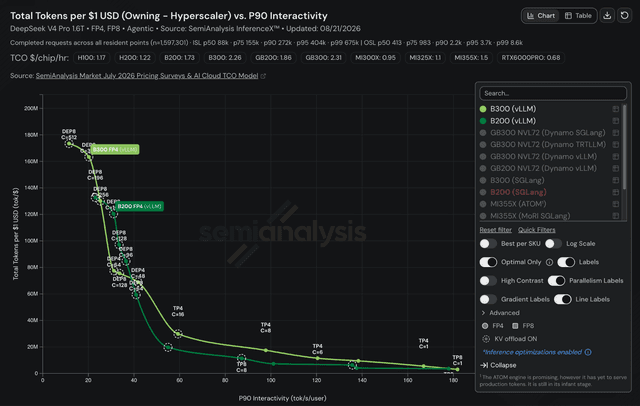
DeepSeek V4 Pro 的 AgentX 结果:B200 对比 B300 与 KV cache 工作集
多出 50% 的 HBM 能挤出额外吞吐量,逐点遥测数据说明了它究竟从何而来
- agentx
- agentic
- benchmark
- +6
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
6 篇文章
预计阅读 3 分钟
多出 50% 的 HBM 能挤出额外吞吐量,逐点遥测数据说明了它究竟从何而来
预计阅读 2 分钟
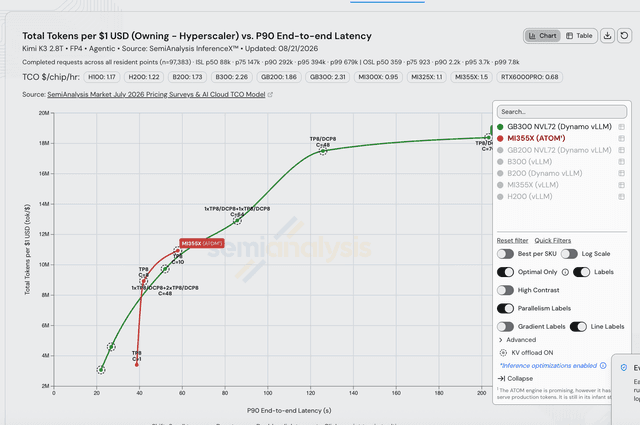
AMD 的厂商引擎在每美元性能前沿上赢下了实打实的一段,而 Hopper 连服务 K3 都很吃力
预计阅读 2 分钟
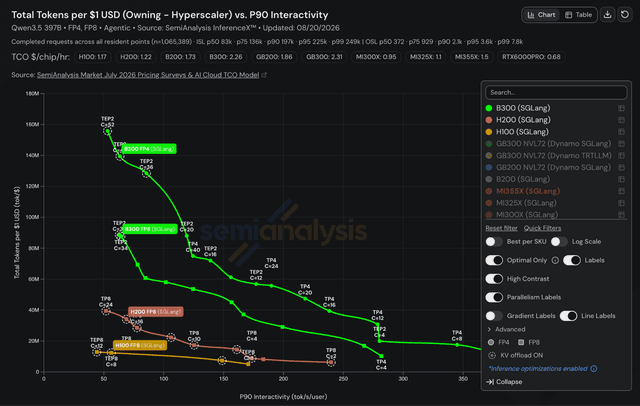
在长上下文 agentic 工作负载上,四年硬件迭代加上 4 位格式能换来什么
预计阅读 31 分钟
第0天推理性能、InferenceX、26天内性能提升100倍、每百万 token 成本、Huawei 950DT 推理 Trace 分析

预计阅读 11 分钟
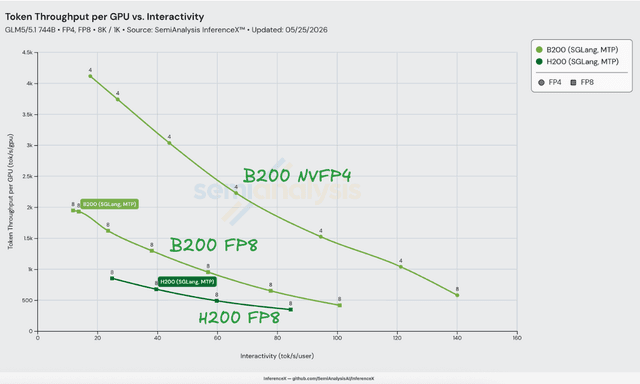
两款 GPU 均运行 SGLang EAGLE MTP;Blackwell 世代在峰值处带来约 1.2 倍的性价比提升,NVIDIA GLM-5-NVFP4 检查点搭配 FlashInfer TRT-LLM 稀疏 MLA 在 8K/1K 场景下再叠加约 2.4–3.0 倍优势

预计阅读 12 分钟
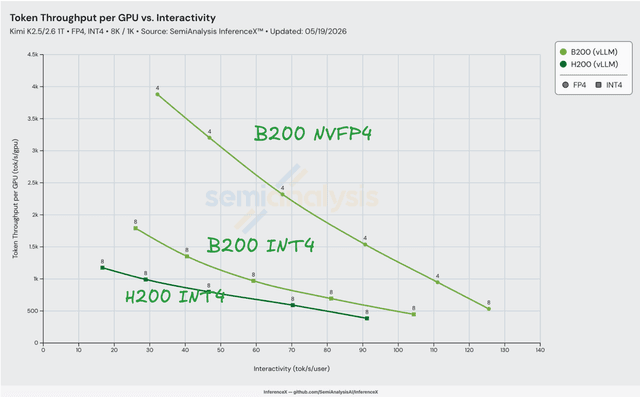
在 vLLM 8K/1K 工作负载下,B200 NVFP4 路径在 30–90 tok/s/user 推理区间内每百万 tokens 成本比 H200 INT4 低 2.71x–2.95x,比同一 B200 硬件上的 INT4 低 2.45x–2.74x。三个因素——B200 的 HBM 带宽、HBM 容量和 NVFP4 张量核心——可清晰分解该优势