本文由 Bryan Shan、Cam Quilici、Alec Ibarra、Kimbo Chen、Myron Xie 和 Dylan Patel 撰写,于 2026 年 9 月 18 日首发于 SemiAnalysis newsletter。
此版本转载文章的公开部分及原始图表,订阅内容仍保留在原文。文中的性能对比对应发布时的配置与软件,并非当前排名。
Engram 在标准 token embedding 之上增加了可学习的多 token 查表。重复出现的局部模式可以直接取回向量,从而减少通过注意力层和前馈层重建这些模式的工作。
Engram 模型架构优化可以降低同等模型质量所需的 HBM 容量。 这并不意味着 HBM 不再有巨量需求,而是说明模型架构会继续围绕约束进行创新。
这种架构天然适合参数 offload:每个 token 只访问少量 embedding 行,行地址取决于 token ID,而非隐藏状态。运行时可以在前面层计算时,从主机 DRAM prefetch 这些行,让表保留在 HBM 之外,无需传输整块权重矩阵。我们的 Memory Model 包含逐季度 HBM、DRAM 和 NAND 供需的最新估算。
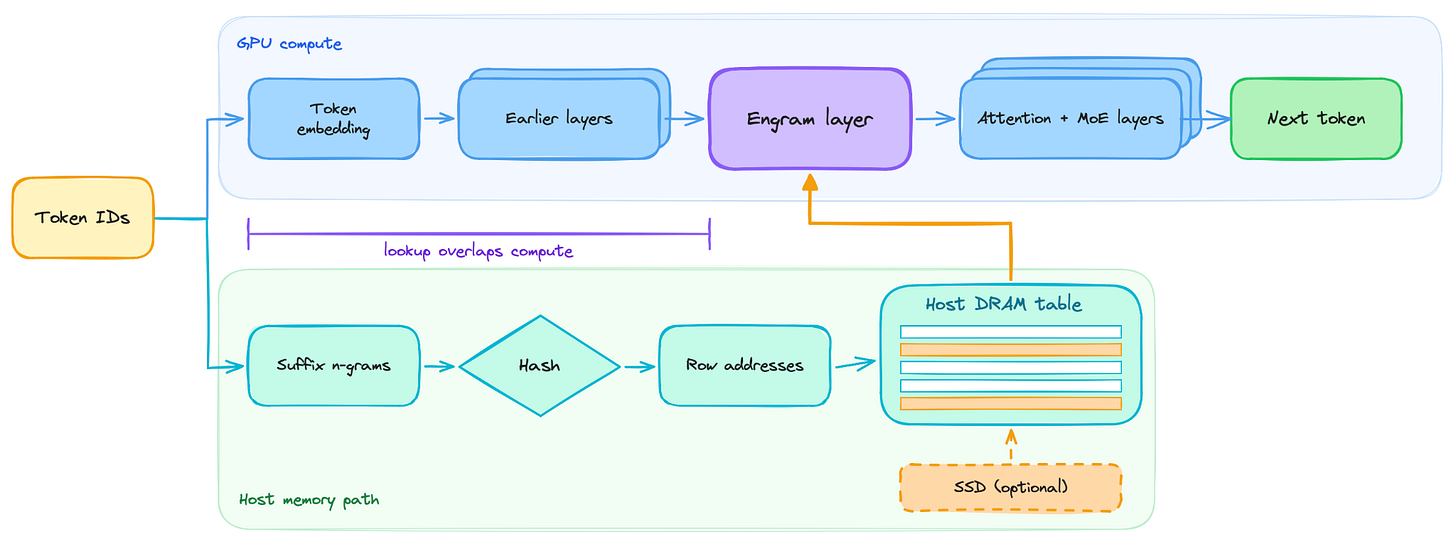
Offload 为模型权重和 KV cache 释放 HBM,可能支持更大的 batch 或更多并发会话。当 DRAM 成为下一个容量约束时,NVMe 可以再提供一层。推荐系统已经在较快内存中缓存高频或近期访问的 embedding 行,并把较冷的行存放在 SSD。NVIDIA 调整路线图,将 Rubin Ultra 每芯片 HBM 从 1024GB 大幅下调到约 200GB 之后,Engram 这类模型架构优化可能有所帮助。
我们的 DeepSeek-V4.1-Flash 配置中,Engram 约占用 189 GiB 内存。我们将其替换为内存映射(mmap)文件,测量 offload 到 SSD 后的服务性能。
本文后面将展示 Engram offload 实验,以及 InferenceX 对 DeepSeekv4.1 Flash 等 Engram 模型在全部 6 款 NVIDIA GPU SKU 和 MI355X 上的官方智能体推理服务结果。 不出所料,在极受欢迎的 DeepSeekV4.1 Flash 上,CUDA 护城河仍让 MI355X 明显落后。
我们还会展示,即使 GPU 的 HBM 容量很高,把 Engram offload 到 DRAM,也可能在 Pareto 曲线的大部分区间获得比保留在 HBM 中更好的性能。
几乎所有主要算力买家都复现、验证和/或支持过我们的基准测试,包括 Google Cloud、Microsoft Azure、Oracle、Meta 等。它也获得了 vLLM、LMCache、SGLang、PyTorch、Huggingface 等 ML 社区项目的支持,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等主要实验室的支持。
如果这些开源基准测试和数据对你有帮助,欢迎给 InferenceX GitHub 仓库点 Star! InferenceX 是全球唯一覆盖 TPUv7、Jalapeño、NVIDIA Rubin NVL72、AMD,并即将加入 SambaNova 和 Trainium 的推理基准测试。由于 AgentX 场景贴近真实智能体推理负载,AMD 也已承诺合作推进 MI455X UALoE72。
Engram 的收益
DeepSeek 没有公开原论文训练的两个 Engram 模型。我们使用已发布的代码和训练超参数,在 fineweb-edu 上复现其配置,每次运行估计消耗 6E18 FLOPs。我们观察到了相同的 U 形 scaling:
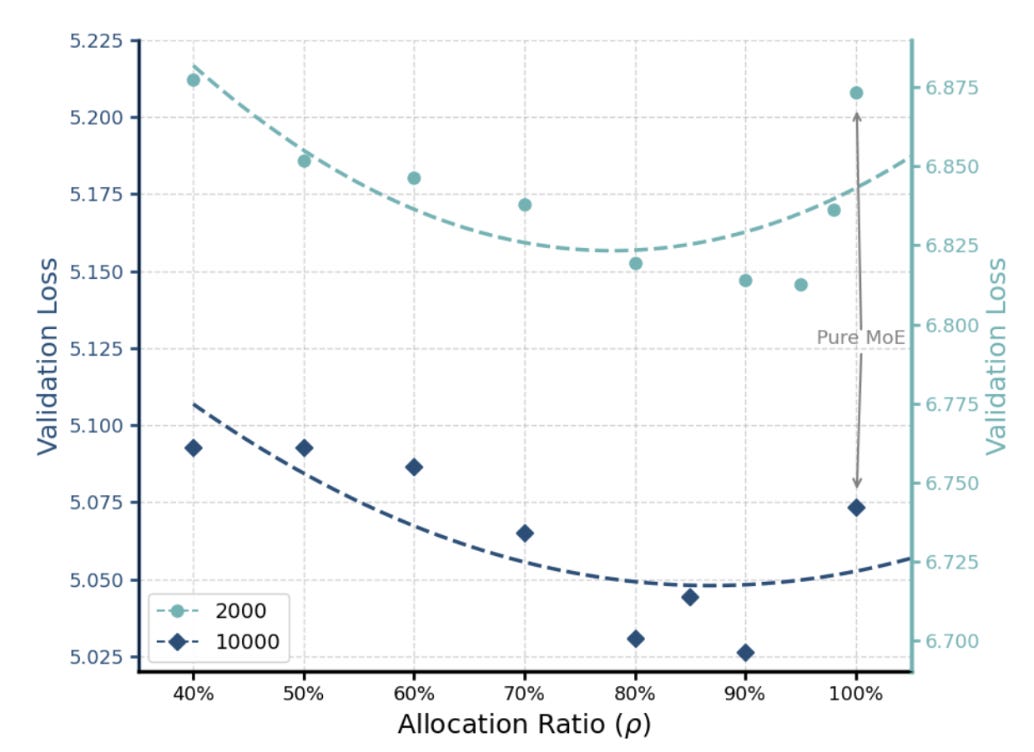
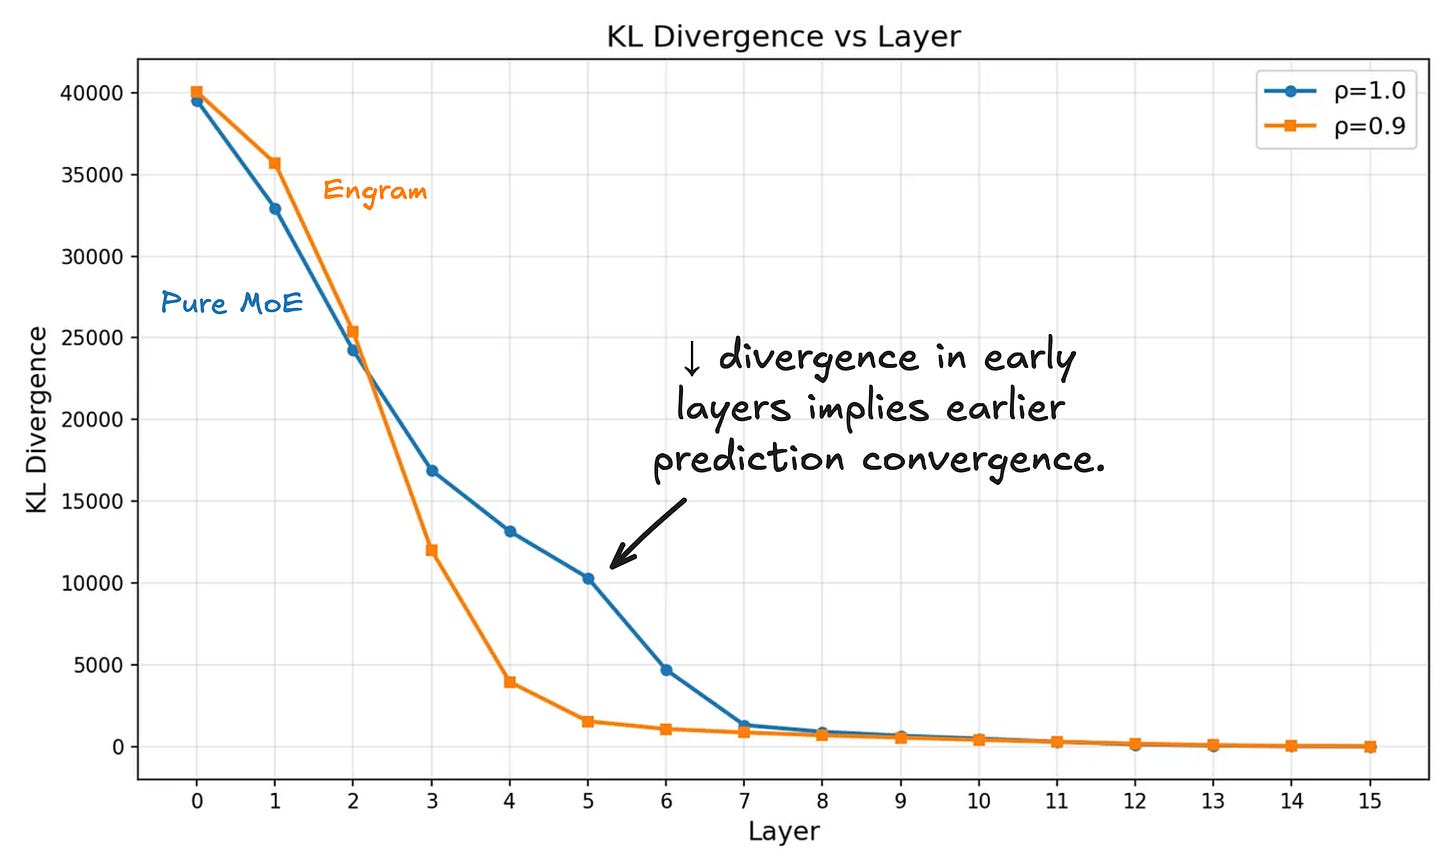
Engram 的表现优于纯 MoE 基线。我们也复现了 DeepSeek 的另一项结果:使用 Engram 时,较早层的表示与较晚层的表示相似。
模型记住了什么?
与原始 Engram 论文类似,可以通过探查 gate 分数,观察 DeepSeek-V4.1-Flash 最依赖哪些 n-gram。我们的 gate 扫描找到了名字、代码片段、关系性表述和模板文字。这里选取示例主要看是否有趣,而不是 gate 强度排名。
一个意外的结果是 Wright : Ace Attorney。
这些例子说明,可学习记忆优化的是训练目标,而不是判断哪些事实值得保存。许可证、参考文献片段、API 框架代码和网页固定元素都能提供预测捷径,因此增加 Engram 容量的价值可能取决于数据准备后保留了什么。这不说明表容量被“浪费”:对评估语料的扫描既不能确定训练时见过什么,也不能确定每类内容占据多少容量。
对于 offload,强 gate 并不能识别缓存热行。低 gate 也不会自动省掉读取:计算 gate 需要已经取回的 key,并会抵消融合内核的性能收益。若要跳过读取,需要另一个在检索之前运行的有用性预测器。
移除 Engram
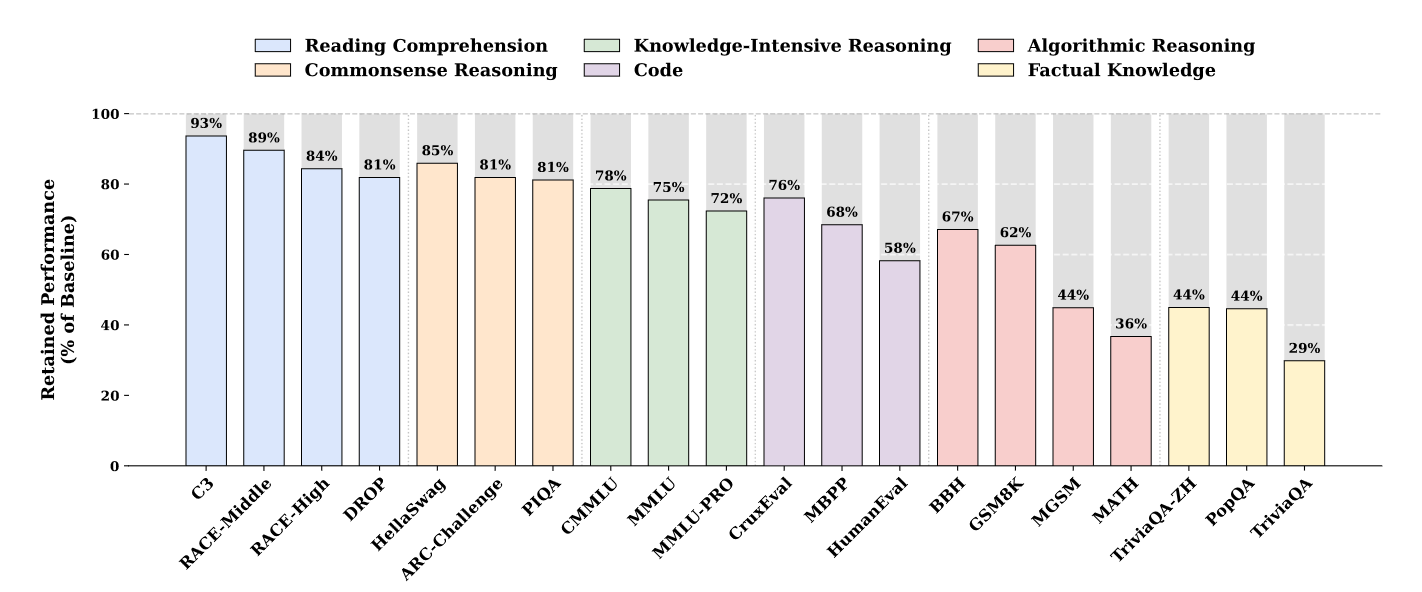
在原论文的推理时消融中,事实知识基准只保留了原性能的 29–44%,阅读理解则保留了 81–93%。这是训练与推理不匹配造成的。因此,退化程度衡量的是这个已训练模型对 Engram 的依赖,而不是分别训练的有 Engram 和无 Engram 模型之间的性能差距。
在我们的消融中,抑制 Engram 会恶化所有评估领域的 token 似然,尤其是百科文本和若干代码语料。意外的是,GSM8K 准确率仍处于实测运行间波动范围内,移除 Engram 没有可测影响。
Engram 不是放在一个保持不变的 MoE 旁边、可随意拔掉的词典。移除它会改变下游特征与专家选择。
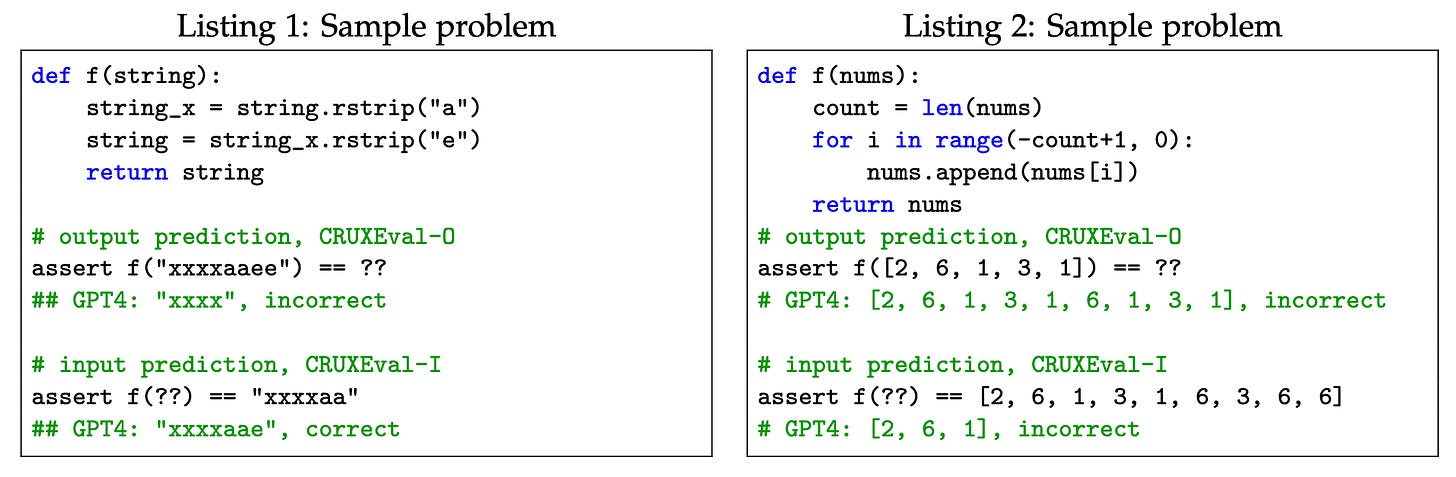
我们在 CRUXEval 上通过 teacher forcing 固定 token,并对参考答案评分,以测试重新路由究竟造成损害还是起到补偿作用。CRUXEval 是小型 Python 函数的代码推理基准,要求模型根据函数代码和输入预测输出。
移除 Engram 后,答案损失从 0.2848 升至 0.3093 bits/token。若再强制消融后的模型沿用启用 Engram 时的专家选择,结果更差,达到 0.3375 bits/token。
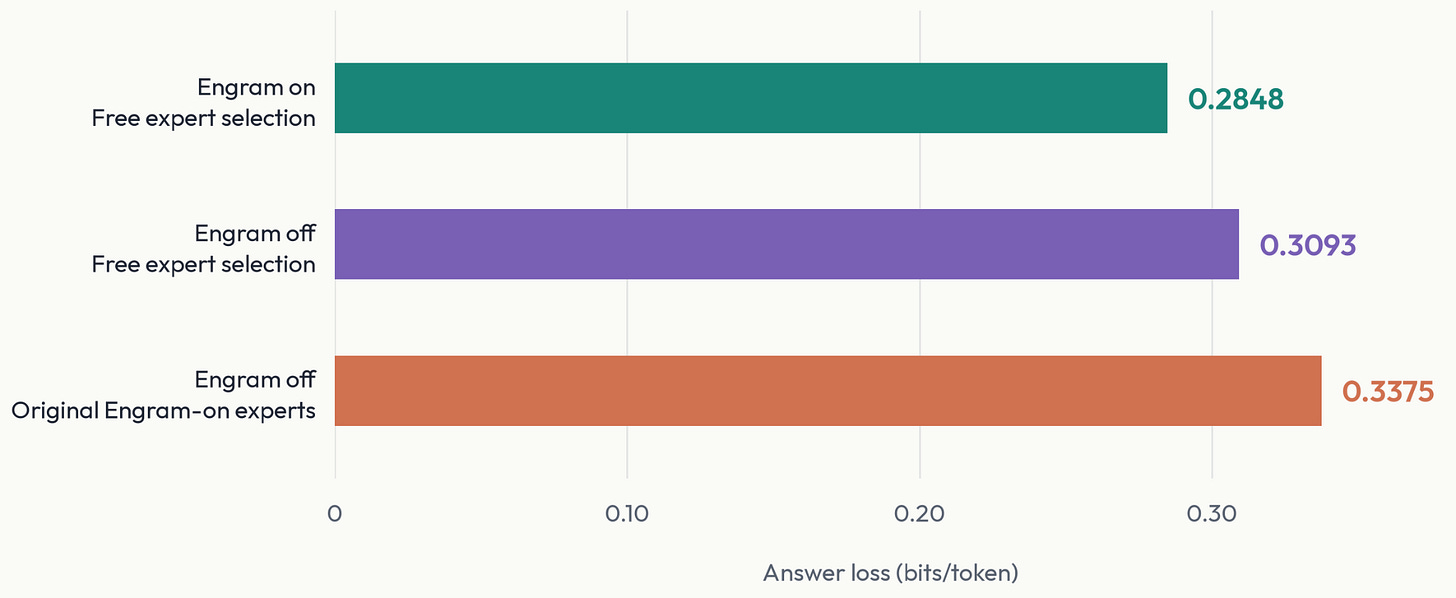
重新路由部分补偿了缺失的记忆。记忆特征与专家选择共同工作,并不存在清晰的“记忆存事实、专家做推理”分工。
在同一 CRUXEval 上,无论在哪个阶段移除 Engram,都会降低准确率并增加生成 token 数;全程移除时变化最大。
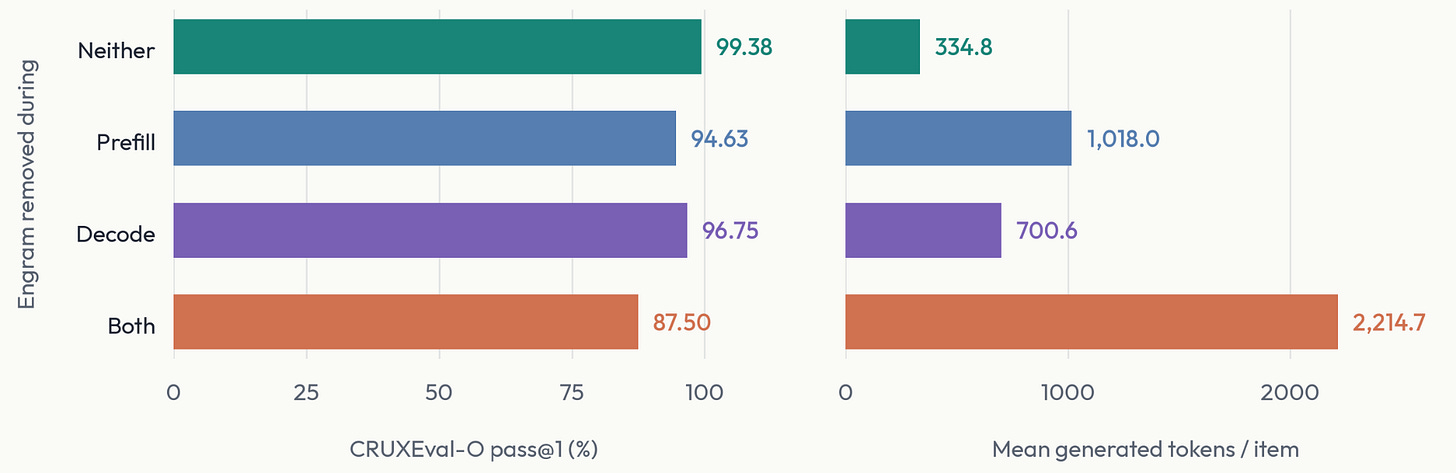
只在 prefill 保留 Engram,比只在 decode 保留能得到更多正确答案。可能的原因是传给 decode worker 的 KV cache 语义更丰富,从而缓解了部分性能损失。
智能体推理服务性能
Engram 表虽然很大,但每次查表很小。DeepSeek-V4.1-Flash 在两个 Engram 层分别请求 24 行,整个模型每处理一个 token 位置约需 12.4 KiB;分到四个 GPU 时,每 GPU 约为 3.1 KiB。
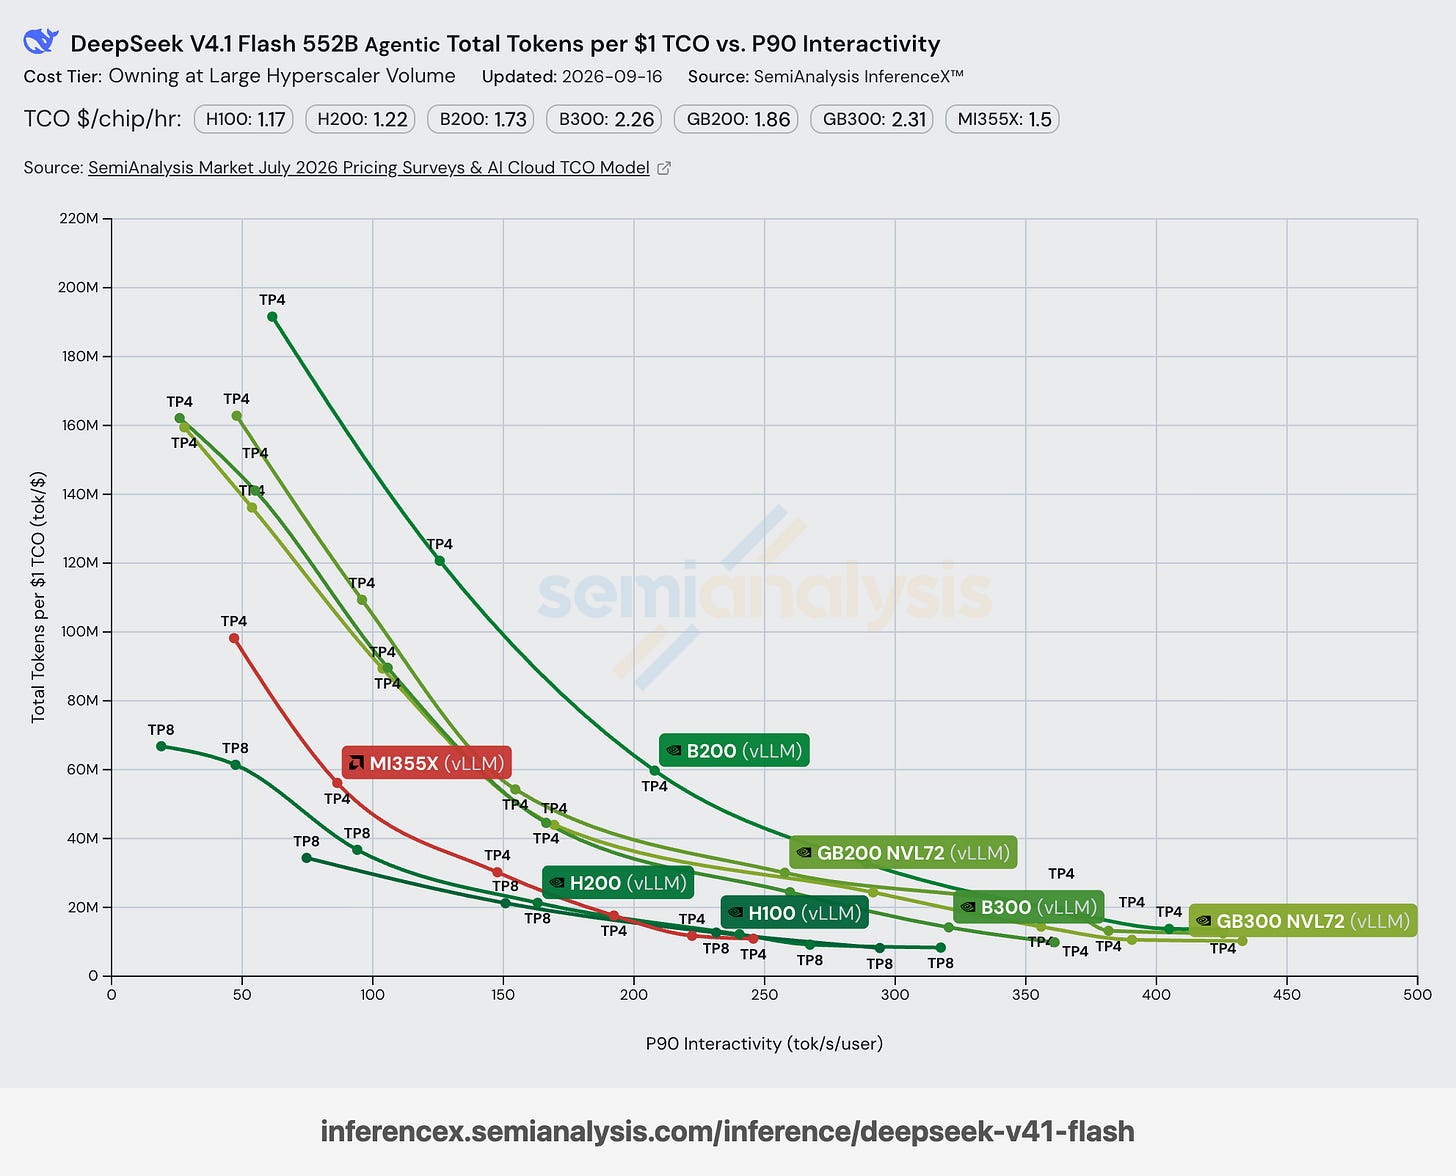
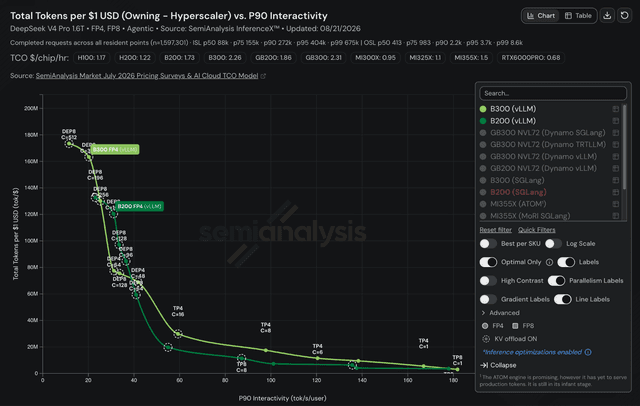
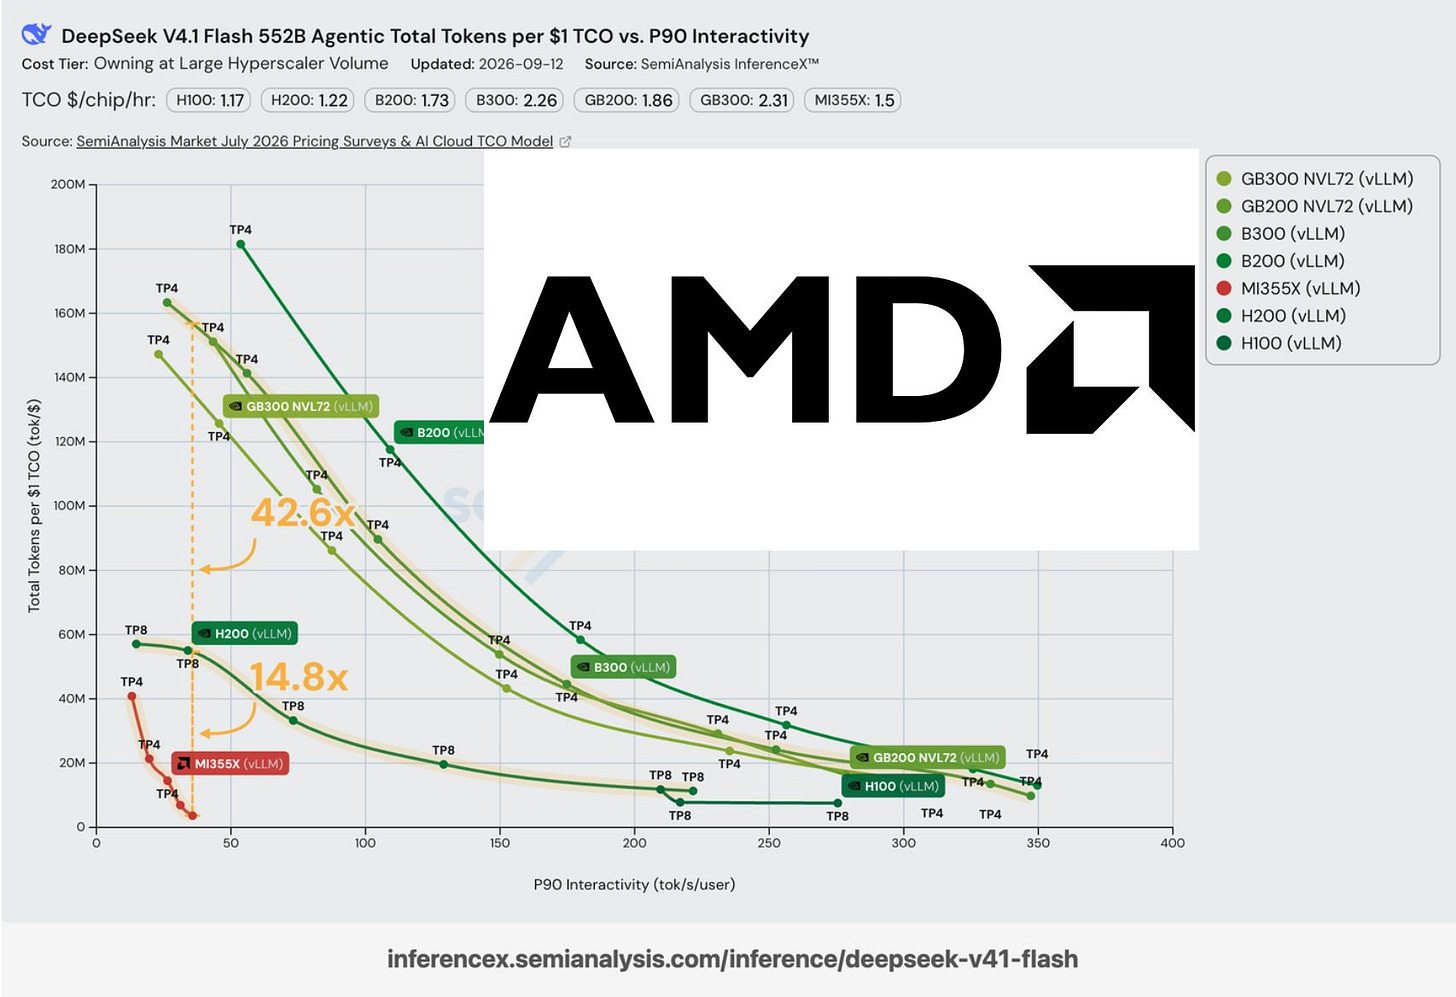
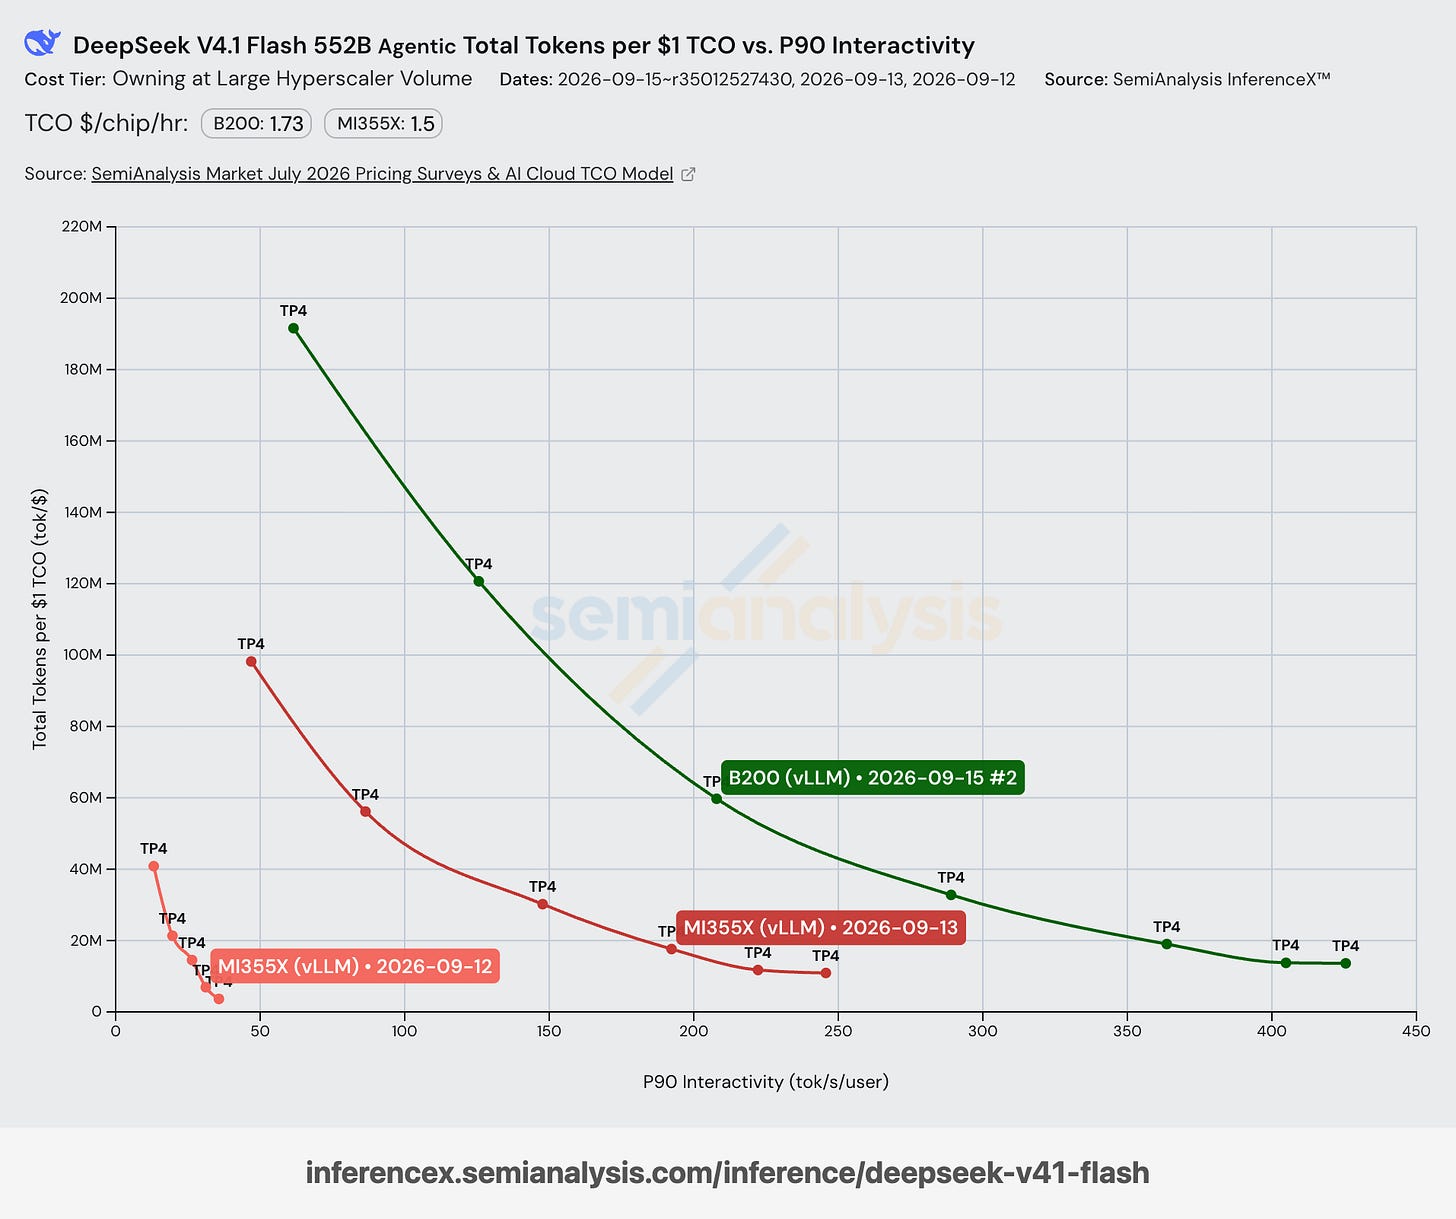
截至模型发布第 7 天,即使按 MI355X 更低的 TCO 归一化,其每美元性能仍比 B200 差 2–4 倍。完整总拥有成本拆分来自我们的 AI Cloud TCO Model,以及每月对 100 多家 GPU 云厂商和 GPU 云客户的市场调查。
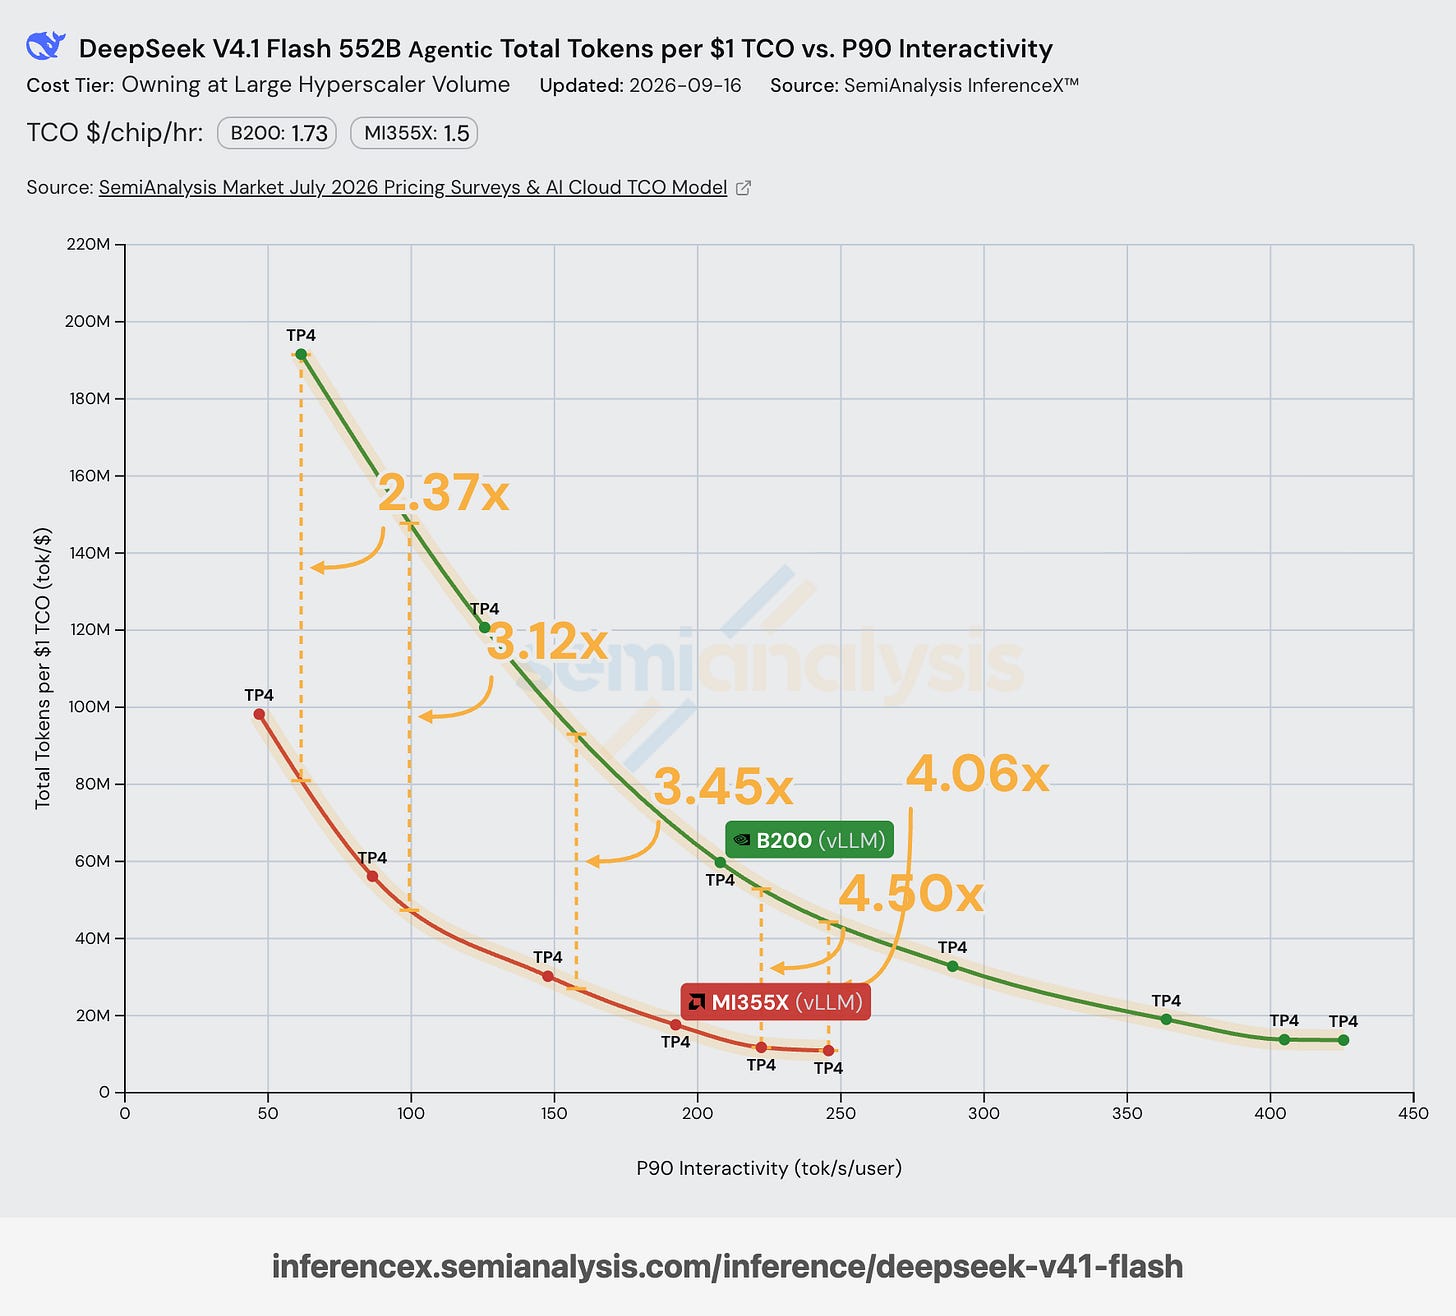
DeepSeekv4.1 Flash 发布当天,NVIDIA vLLM 在 H100、H200、B200、B300、GB200、GB300 全部 6 款 SKU 上开箱即用,没有遇到问题!这要归功于 NVIDIA 和 Interact 团队的出色工作!相比之下,AMD vLLM 在发布当天无法运行 DeepSeekv4.1 Flash。
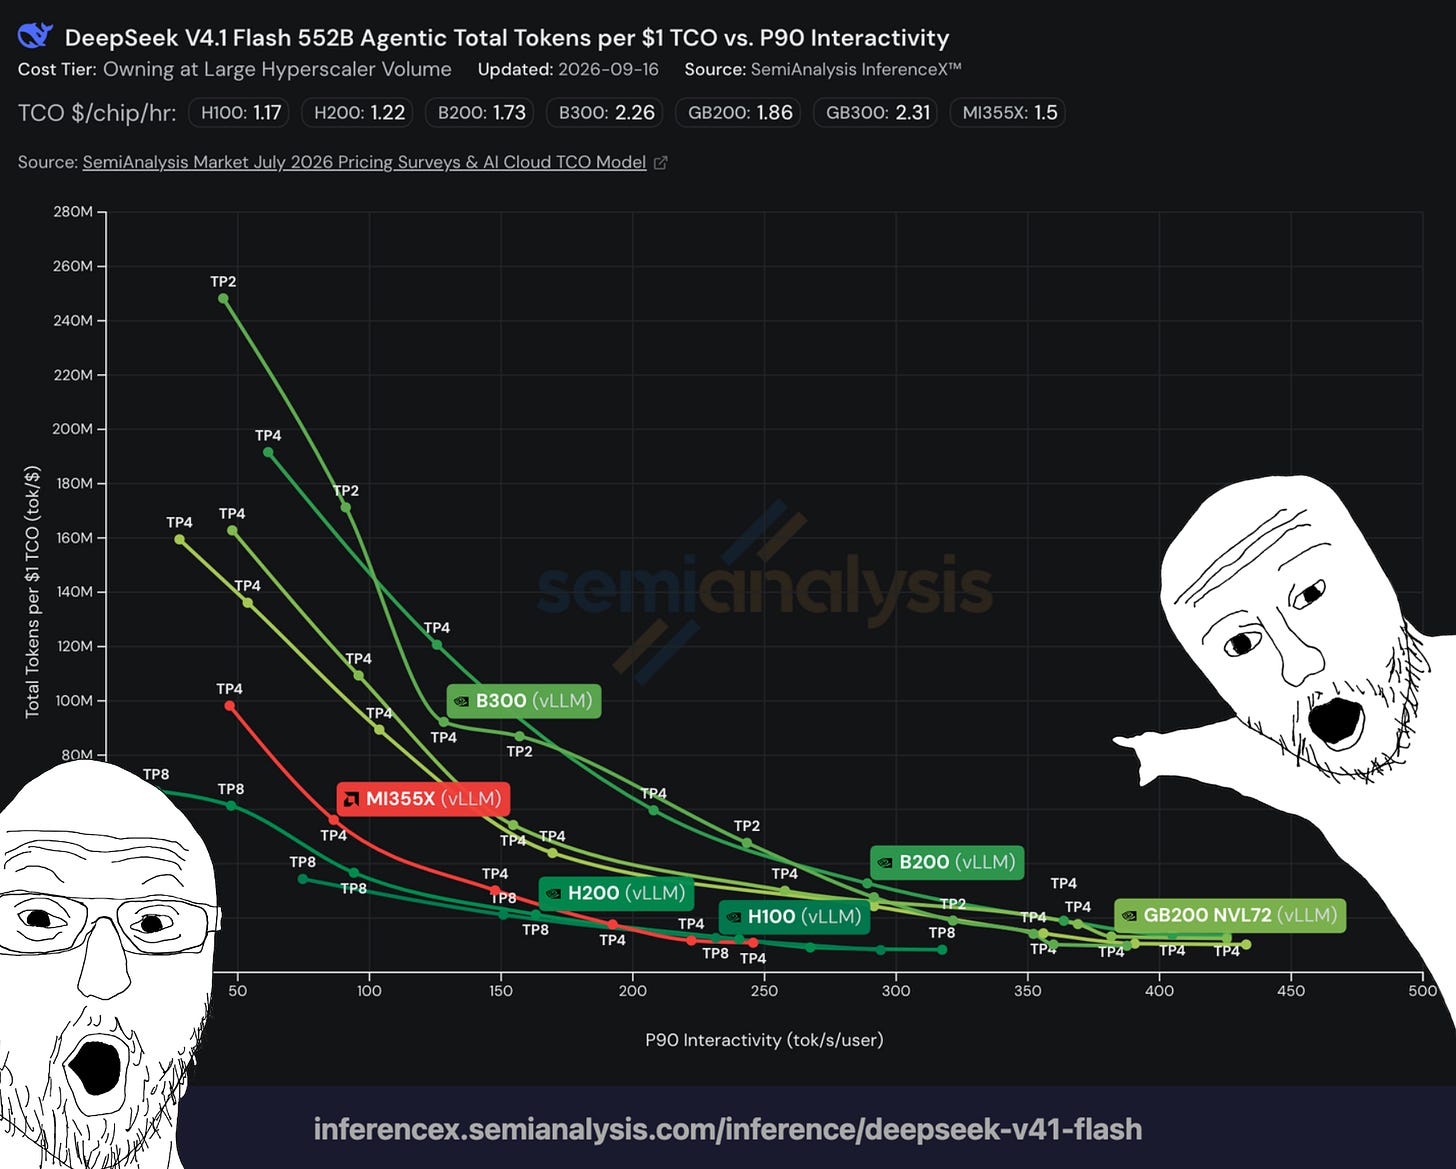
AMD 的 vLLM 文档要求使用 vllm/vllm-openai-rocm:deepseekv41-flash-0909,但从模型发布第 0 小时到第 23 小时,AMD 都没有公开该镜像。AMD 宣称“SPEED IS THE MOAT”,却直到第 23 小时仍未发布。我们希望 AMD 团队今后改善模型发布首小时的支持流程。
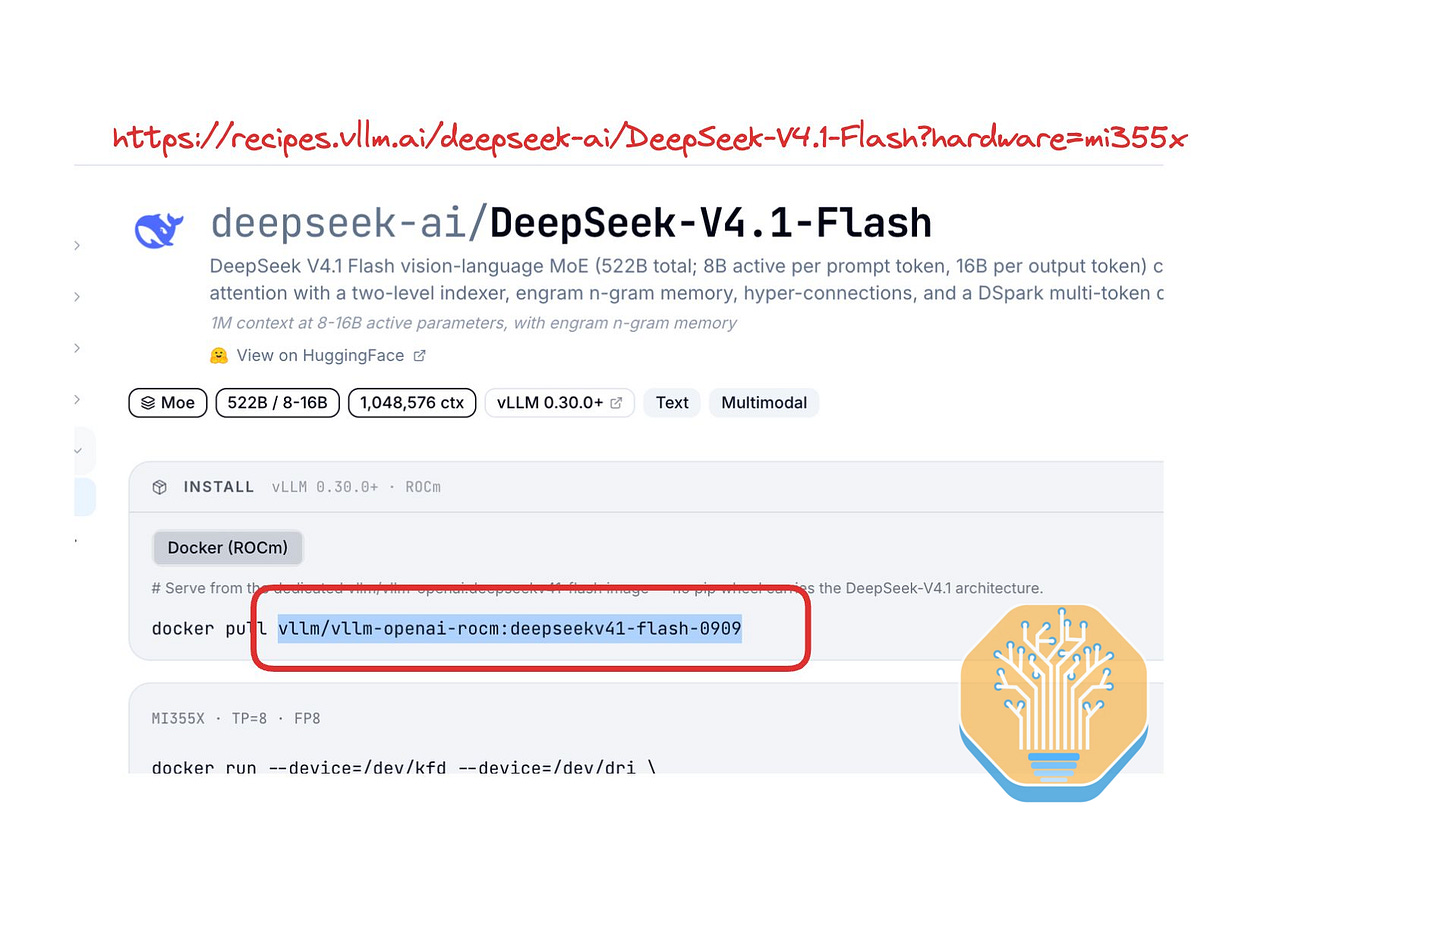
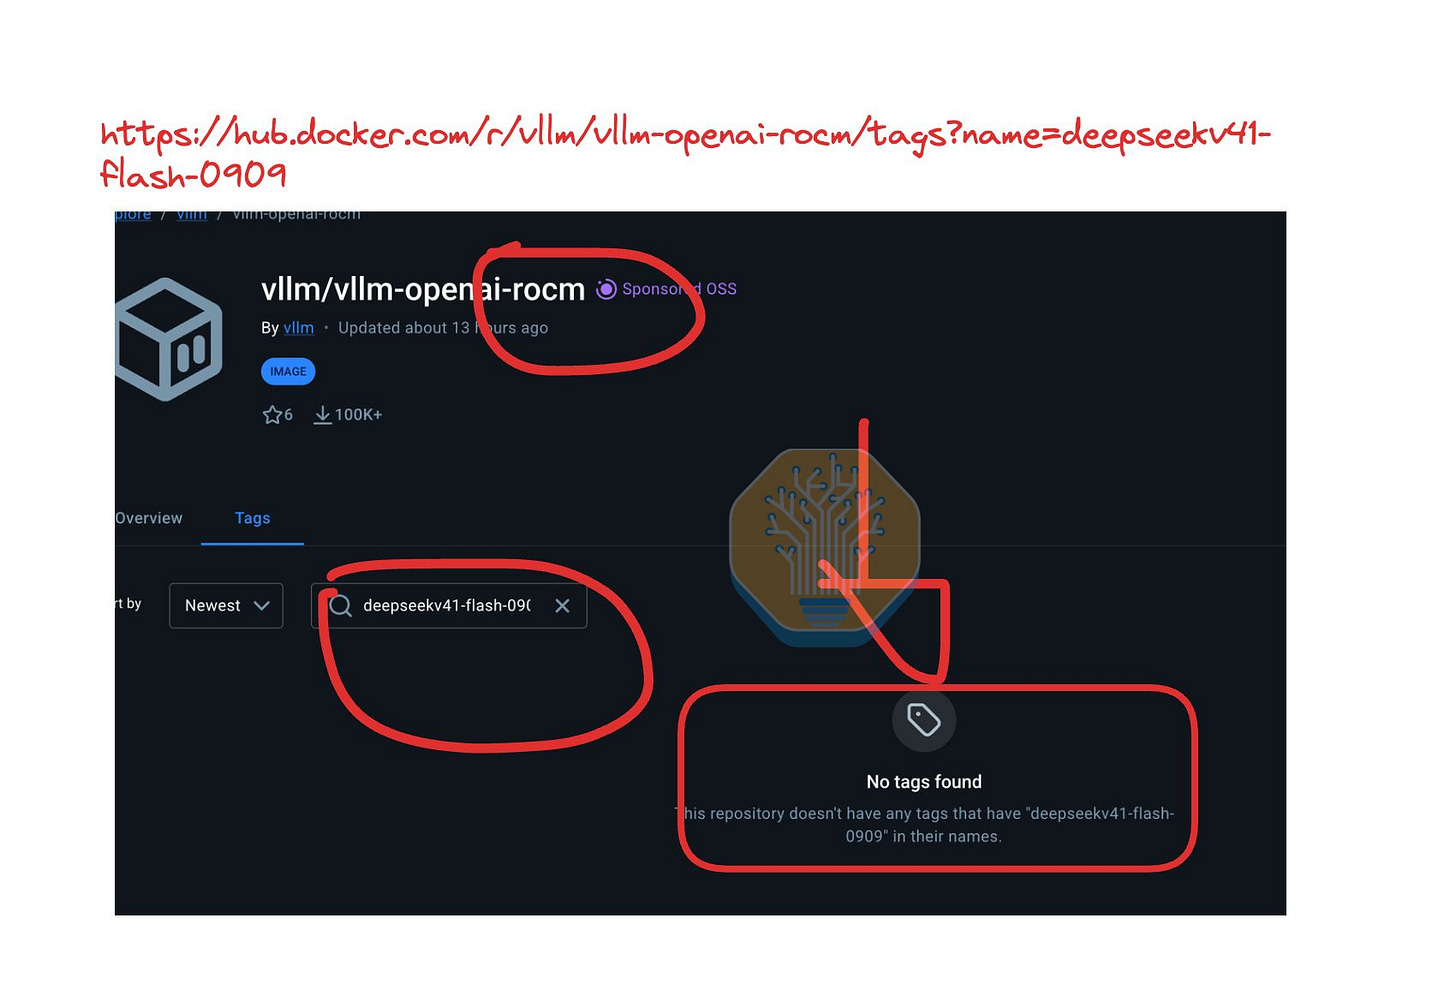
等到所谓“day 0”支持镜像终于公开时,其每美元性能最多比 H200 差 14.8 倍,比 B200/B300 差 42 倍。
CUDA 护城河的力量来自 NVIDIA 与庞大的 600 万开发者社区生态的合作,其中包括大部分 vLLM、SGLang 和 Tokenspeed 维护者。这使 CUDA 能在发布首日就完成优化。
总体而言,AMD 确实取得了明显进展,但每美元性能仍比 B200 差 2–4 倍。
AgentX 中 Engram DRAM offload 带来的性能提升
HBM 与 DRAM offload 使用同一个 GPU 内核选择和反量化行。HBM 版本读取 GPU 内存;统一虚拟寻址(UVA)版本则直接读取固定页主机内存。
两者都支持完整 decode graph。把表移入 HBM 只加速稀疏查表,并不改变 decoder 的计算和通信,因此整体收益很小,却占用了原本可供 KV cache 使用的内存。
把 Engram offload 到 DRAM 的另一个好处,是每副本可以使用更少的 GPU,从而降低通信开销。例如,在 B300 上启用 Engram offload 后,我们能从 TP4 改成 TP2,Pareto 曲线最多提升 1.6x。
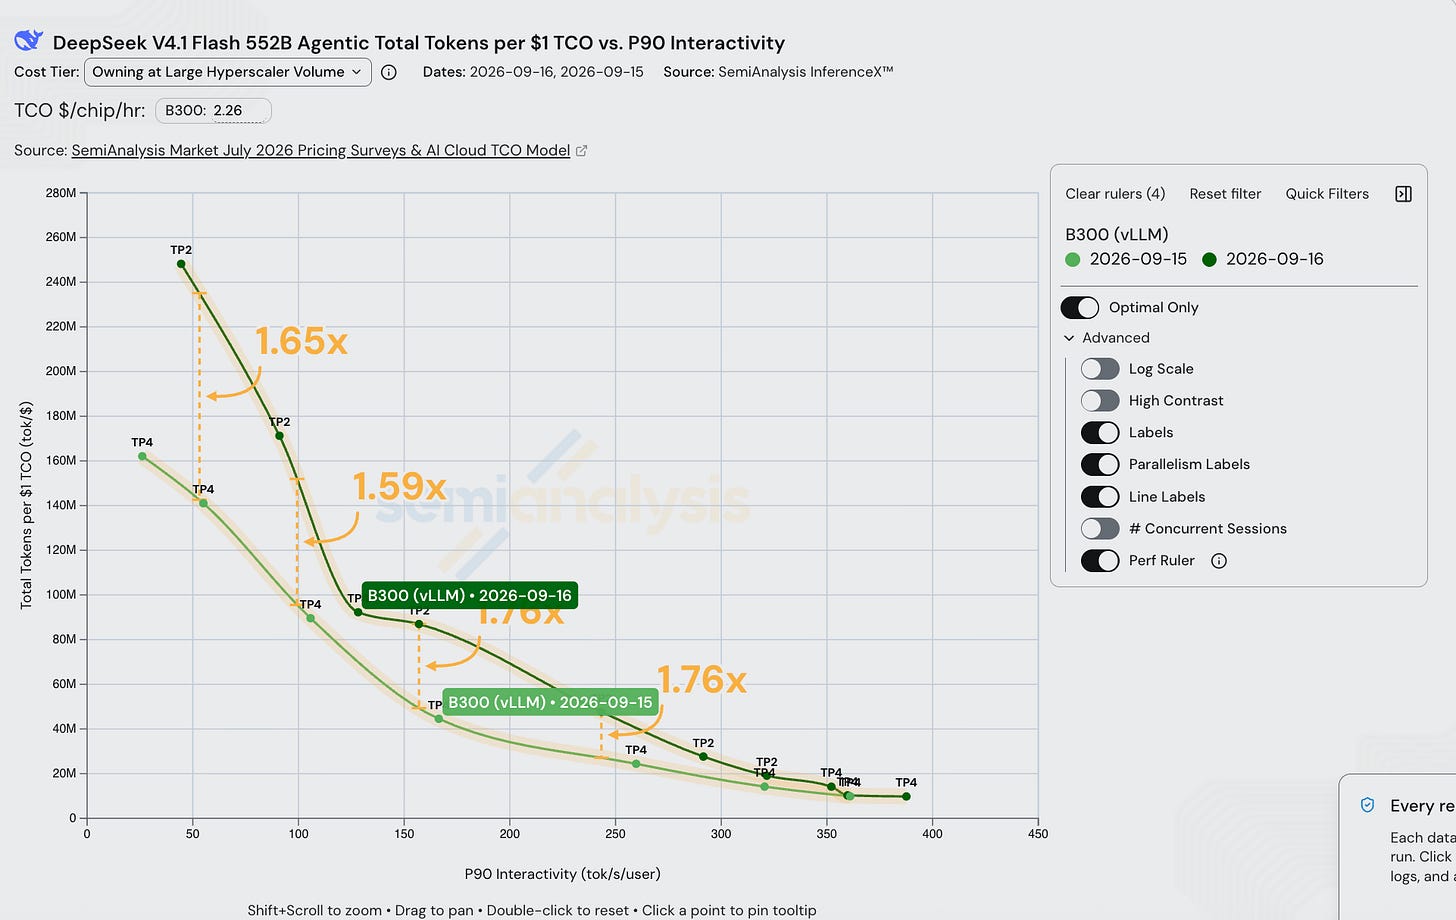
在模型质量相同时,因为 Engram 可以 offload 到主机 DRAM,所需 HBM 更少。因此 HBM 带宽比容量重要得多。对于最依赖内存带宽的推理负载,4-hi HBM 的单位带宽成本最低,因此每 token 成本也最低。如果中国继续带来更多革命性的模型架构创新,未来甚至可能走向 0Hi HBM 堆叠。
此外,在 B300 和首周软件栈上,把 Engram 表移回 HBM 并未改善结果,差异仍在运行间波动范围内。这来自异步执行、计算重叠等 DRAM offload 优化。
SSD offload
我们在 B200 上创建了一个未经优化的 vLLM fork,把 Engram 表放入本地 SSD 上的内存映射文件。当其他应用需要 RAM 时,文件支持的映射允许操作系统回收表页面。已经缓存在内存中的页面可以直接提供数据,无需再次读取 SSD。还需要说明,我们未能启用 GDS。
这个未经优化的 SSD 实现改变了行抵达 GPU 的路径:先把行 ID 复制到 CPU,去重后将所需行收集到固定页缓冲区,再把这些行复制回 GPU 并反量化。这些工作在 GPU 执行 graph 的片段之间运行。原生 UVA 则直接在 GPU 上选择并反量化行,避免 CPU 往返。
Warm 文件系统缓存可以消除物理 SSD 读取,但协调、行收集和传输仍然存在。因此,即使文件已经缓存在 RAM 中,也可能比固定页 DRAM 表更慢。这里比较的是完整服务路径,并未单独拆分各项操作耗时。
在 total tokens per dollar 和 P90 interactivity 两项指标上,B200 DRAM 都优于两条实测 SSD 服务曲线。在约 125 tokens/s/user 时,DRAM 每美元提供 1.21 亿 total tokens,SSD 为 5200 万。
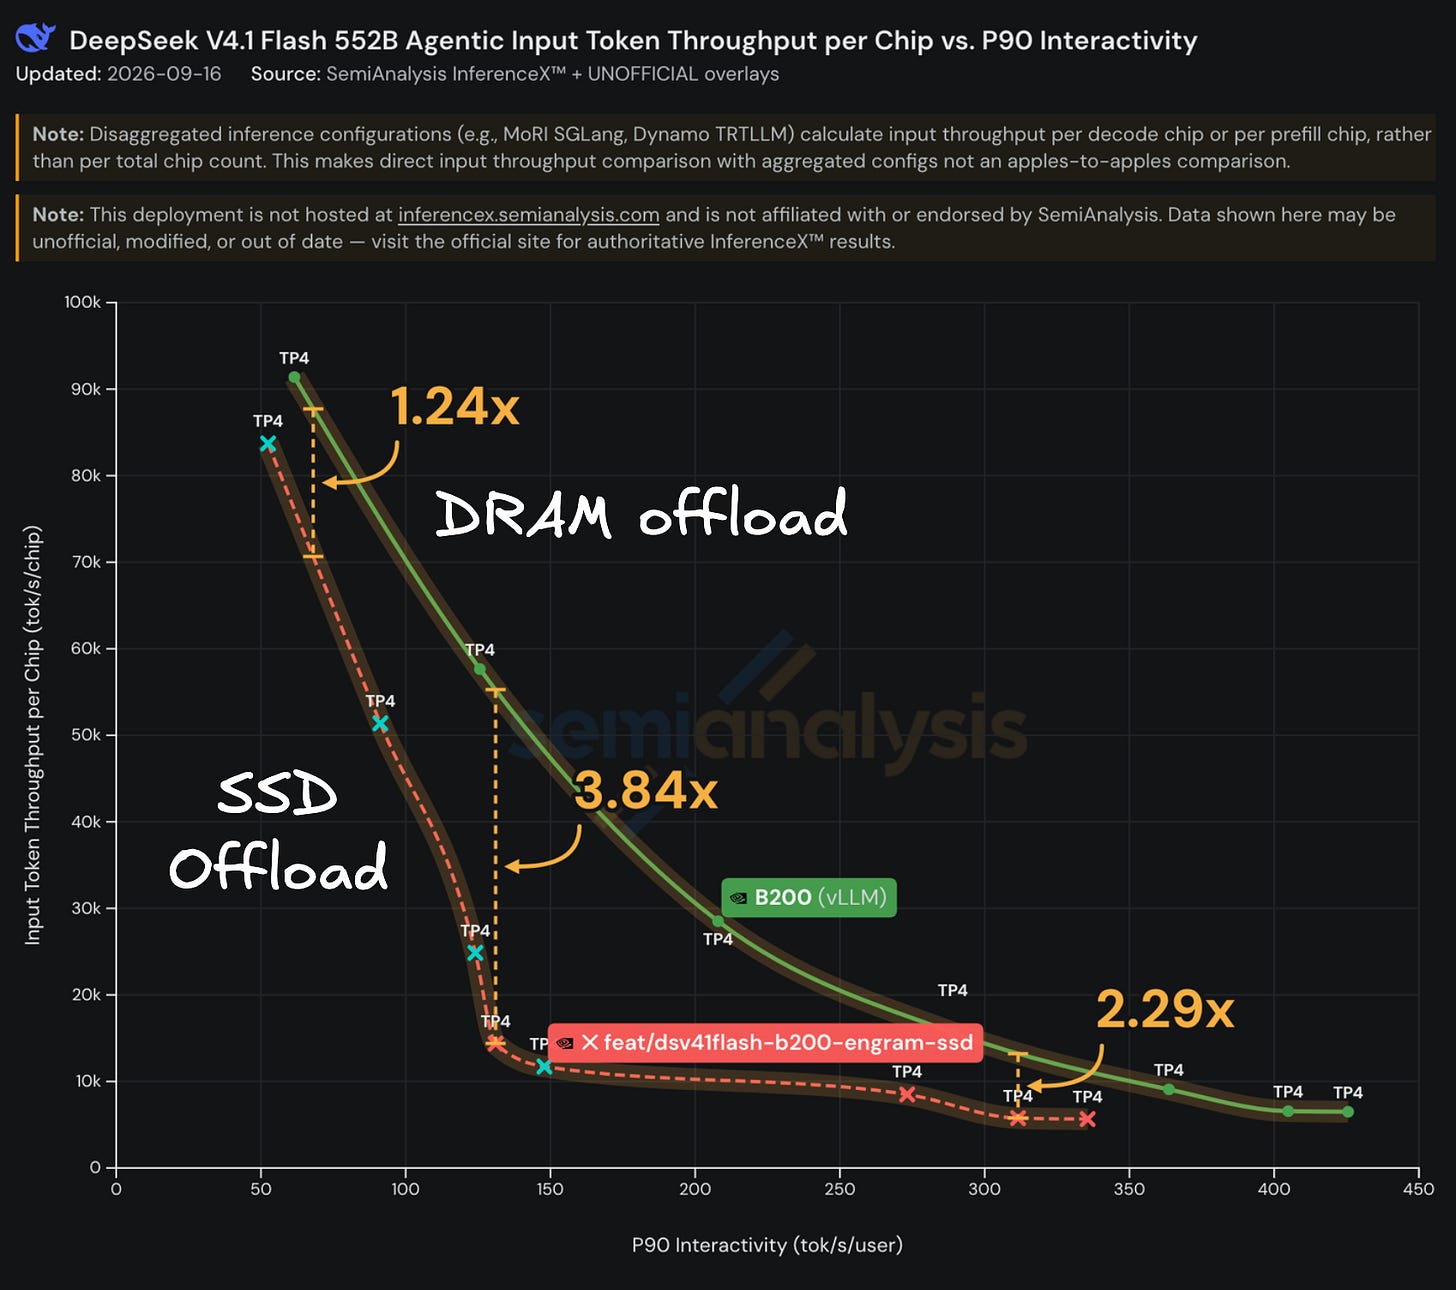
对于生产服务,SSD offload 很可能不值得这种取舍。在我们测试的 B200 配置中,SSD offload 两项指标都落后:每个实测 SSD 点,都能找到 P90 interactivity 更高、每美元 total tokens 更多的 DRAM 替代点。
便宜的存储不会自动带来便宜的推理服务。把 Engram 移到 SSD 后,仍然需要相同的四个昂贵 GPU 和服务器其余部分。只有回收 RAM 能带来更便宜的服务器配置,或额外可用容量,才会产生经济收益。当前未经优化的路径两者都没有实现,而表页面驻留时,文件系统缓存仍然占用 RAM。
机制
接下来,我们将讨论 DeepSeekv4.1 Flash、LongCat 和 Qwen3.8 Flash Next 中 n-gram 的机制与具体实现。
前往 SemiAnalysis 继续阅读订阅部分的机制分析。
相关术语
参阅 Engram、n-gram embedding、参数 offloading、UVA、内存映射文件和文件系统页缓存。
本文由英文原文翻译而来,如有歧义以英文版为准。所有文章版权归 © SemiAnalysis 所有,保留所有权利。覆盖应用源代码的 AGPL-3.0 许可证不适用于文章内容。