预计阅读 11 分钟
Rubin NVL72 Agentic 推理:每美元性能提升至 67 倍
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
- benchmark
- gpu
- inference
- +7
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
6 篇文章
预计阅读 11 分钟
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
预计阅读 3 分钟
Dynamo router 成为瓶颈,没有提交使用上下文并行,而 AMD 完全没有用上 KV offload
预计阅读 21 分钟
Rubin 基于 LUT 的 Tensor Core、Feynman、机架级架构、每兆瓦性能、每美元性能、软件改进、Rubin 公开软件栈、PyTorch、vLLM、OpenAI Triton

预计阅读 11 分钟
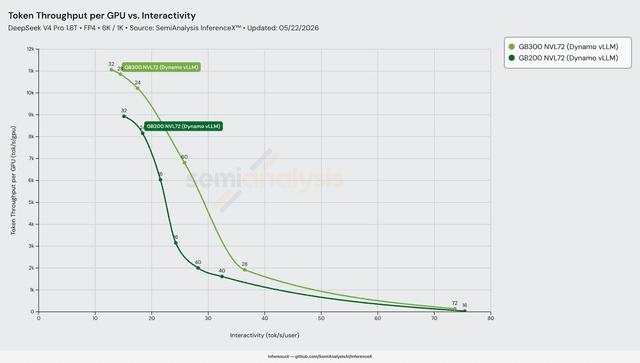
DSv4-Pro FP4 8K/1K,Dynamo+vLLM,两套机架均采用分离式部署。GB300 多出 50% 的 HBM(每 GPU 288 GB vs 192 GB)解锁了 GB200 无法容纳的更宽预填充+解码配方——尽管单 GPU TCO 溢价 20%,曲线中段性价比仍提升 2.31 倍。

预计阅读 9 分钟
DeepSeek R1 FP4 1k/1k。NVL72 的 72-GPU NVLink 扩展域允许解码使用最高 EP=32 的宽专家并行,而 B200 的 8-GPU NVLink 岛通过 RoCEv2 上限为 EP=8