本文由 Kimbo Chen、Alec Ibarra、Wenyao Gao、Pratt Bhatt、Bryan Shan 和 Dylan Patel 撰写,于 2026 年 9 月 28 日首发于 SemiAnalysis newsletter。
此处转载文章的公开部分,保留了 9 月 28 日的基准测试快照。仅限订阅者阅读的网络安全分析仍请参阅原文。
稀疏注意力如何影响 DRAM/NAND 内存需求
稀疏注意力会如何影响 HBM、NAND 等存储器的潜在市场规模(TAM)?稀疏注意力选出最相关的 top-k 个 token 参与注意力计算,从而降低核心缩放点积注意力(SDPA)操作的内存占用和带宽需求。但在实际系统中,这种效率提升并不会直接转化为整体内存节省。具体来说,top-k 选择通常仍需要将完整上下文保留在 HBM 中,因此稀疏注意力并没有消除内存容量瓶颈。
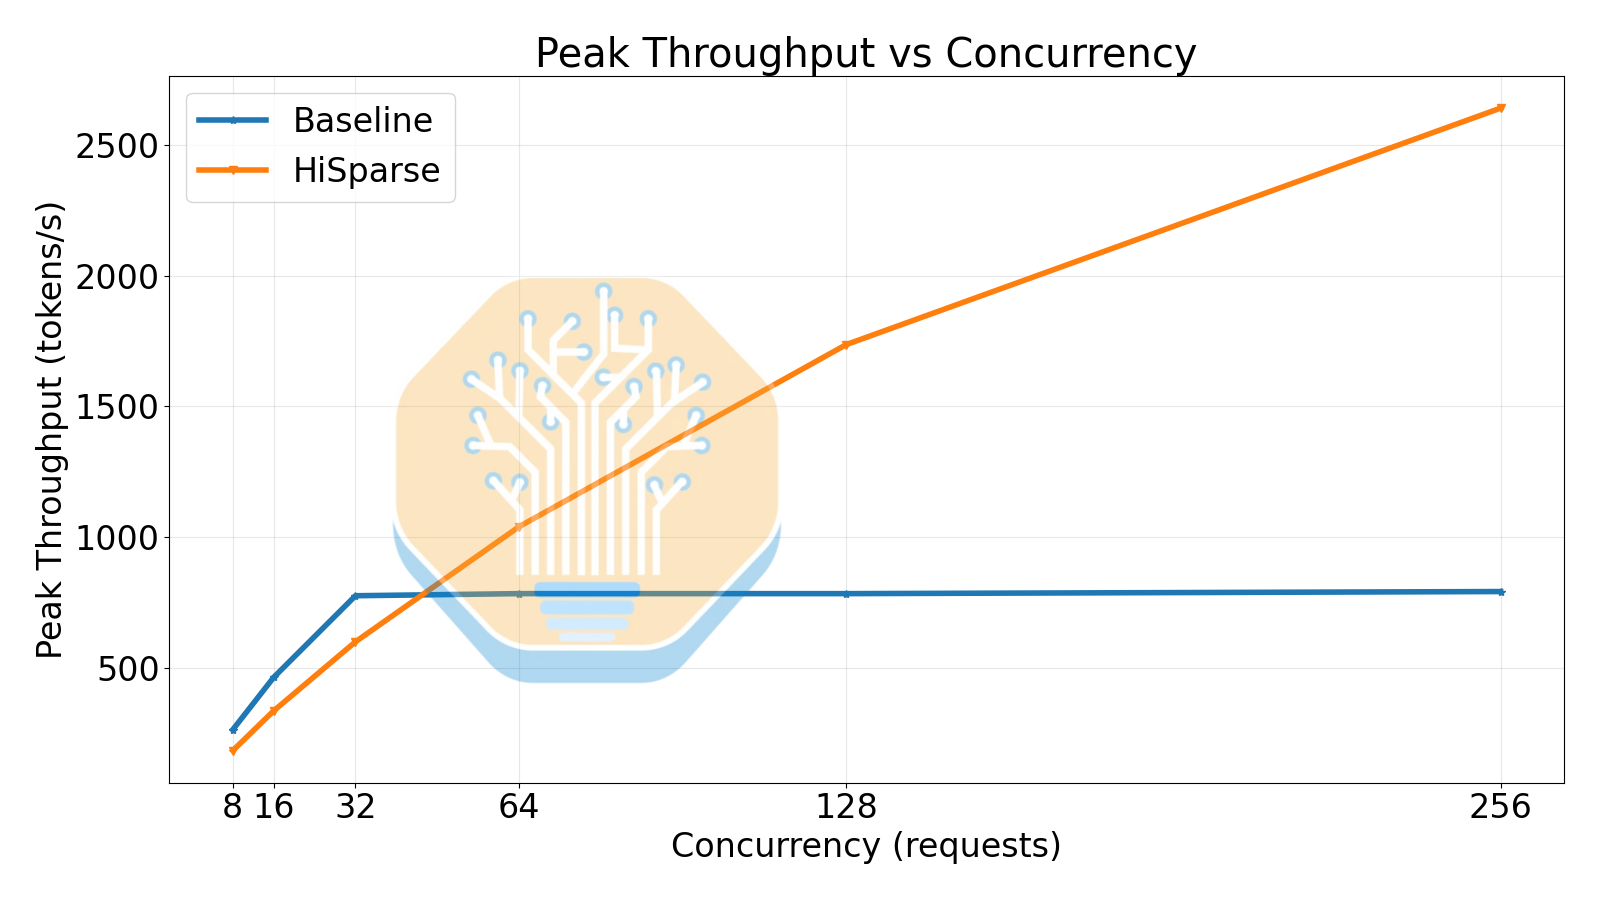
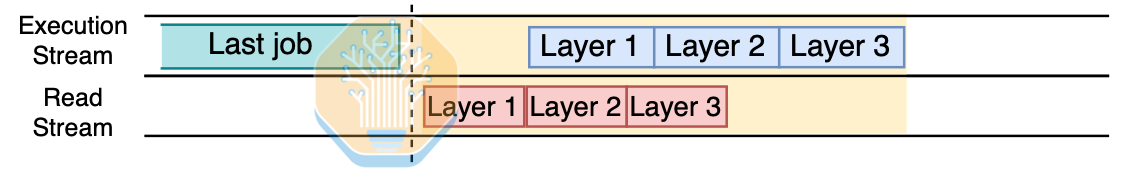
为突破这一限制,SGLang 团队设计了分层内存系统 HiSparse,主动将 KV cache 条目从设备 HBM offload 到主机 DRAM。HiSparse 的行为类似 LRU(最近最少使用)缓存:当 top-k 选择发生缓存未命中时,从 DRAM 向 HBM 加载 token;同时按 LRU 淘汰策略将 token 从 HBM offload 到 DRAM。为降低未命中的延迟,HiSparse 将第 N 层的 KV cache 加载与第 N-1 层的执行重叠。这种逐层重叠机制最早用于 HiSparse 的前期工作 HiCache。
借助 HiSparse,SGLang 在高并发、长上下文场景下大幅提高了吞吐量,代价是 top-k 缓存未命中时产生的 I/O 开销。
稀疏注意力降低了 SDPA 操作的 KV cache 内存和带宽需求,但并未降低整体内存容量占用。 HiSparse 也说明,系统优化可以突破稀疏注意力面临的容量限制,因此仅凭稀疏注意力本身的内存特征,无法完整判断系统的 KV cache 效率。下面我们结合 Z.ai GLM-5 系列的设计与实际推理部署,进一步讨论稀疏注意力模型的服务特征。
GLM5.3 智能体推理服务
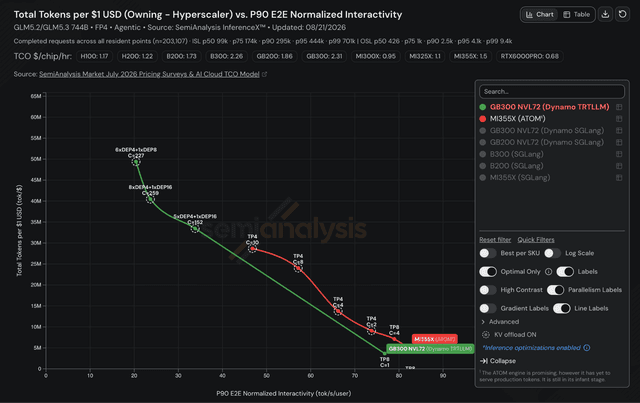
在我们的实时基准测试平台 InferenceX 上,当响应速度为每秒 150 token 时,GB300 在本次比较中取得了最低的建模服务成本。GB300 的单 GPU token 吞吐量更高,尽管每小时成本也更高,其成本效率仍优于 GB200。GB300 结果使用 Dynamo-TRT-LLM,GB200 结果使用 Dynamo-SGLang。
我们采用 9 月 28 日的 AgentX 快照,说明 GLM-5.3 的推理服务特征。成本估算使用 InferenceX 的超大规模基础设施自有及运营成本模型。总 token 包含输入与生成的输出,也包含跨轮次复用的缓存输入历史。流式生成速度以 p90 interactivity 衡量,首 token 延迟则单独评估。
在每秒 150 token 的响应速度下,GB200 每百万总 token 的成本约为 $0.044,运行 ATOM 的 MI355X 则为 $0.049。在相同流式生成速度目标下,前者成本约低 12%。这些数值根据实测曲线估算,并非另行进行的、恰好达到每秒 150 token 的测试结果。
本次比较使用 InferenceX 对超大规模基础设施自有及运营成本的估算。总 token 包含输入与生成的输出,也包含从缓存中复用的输入历史。
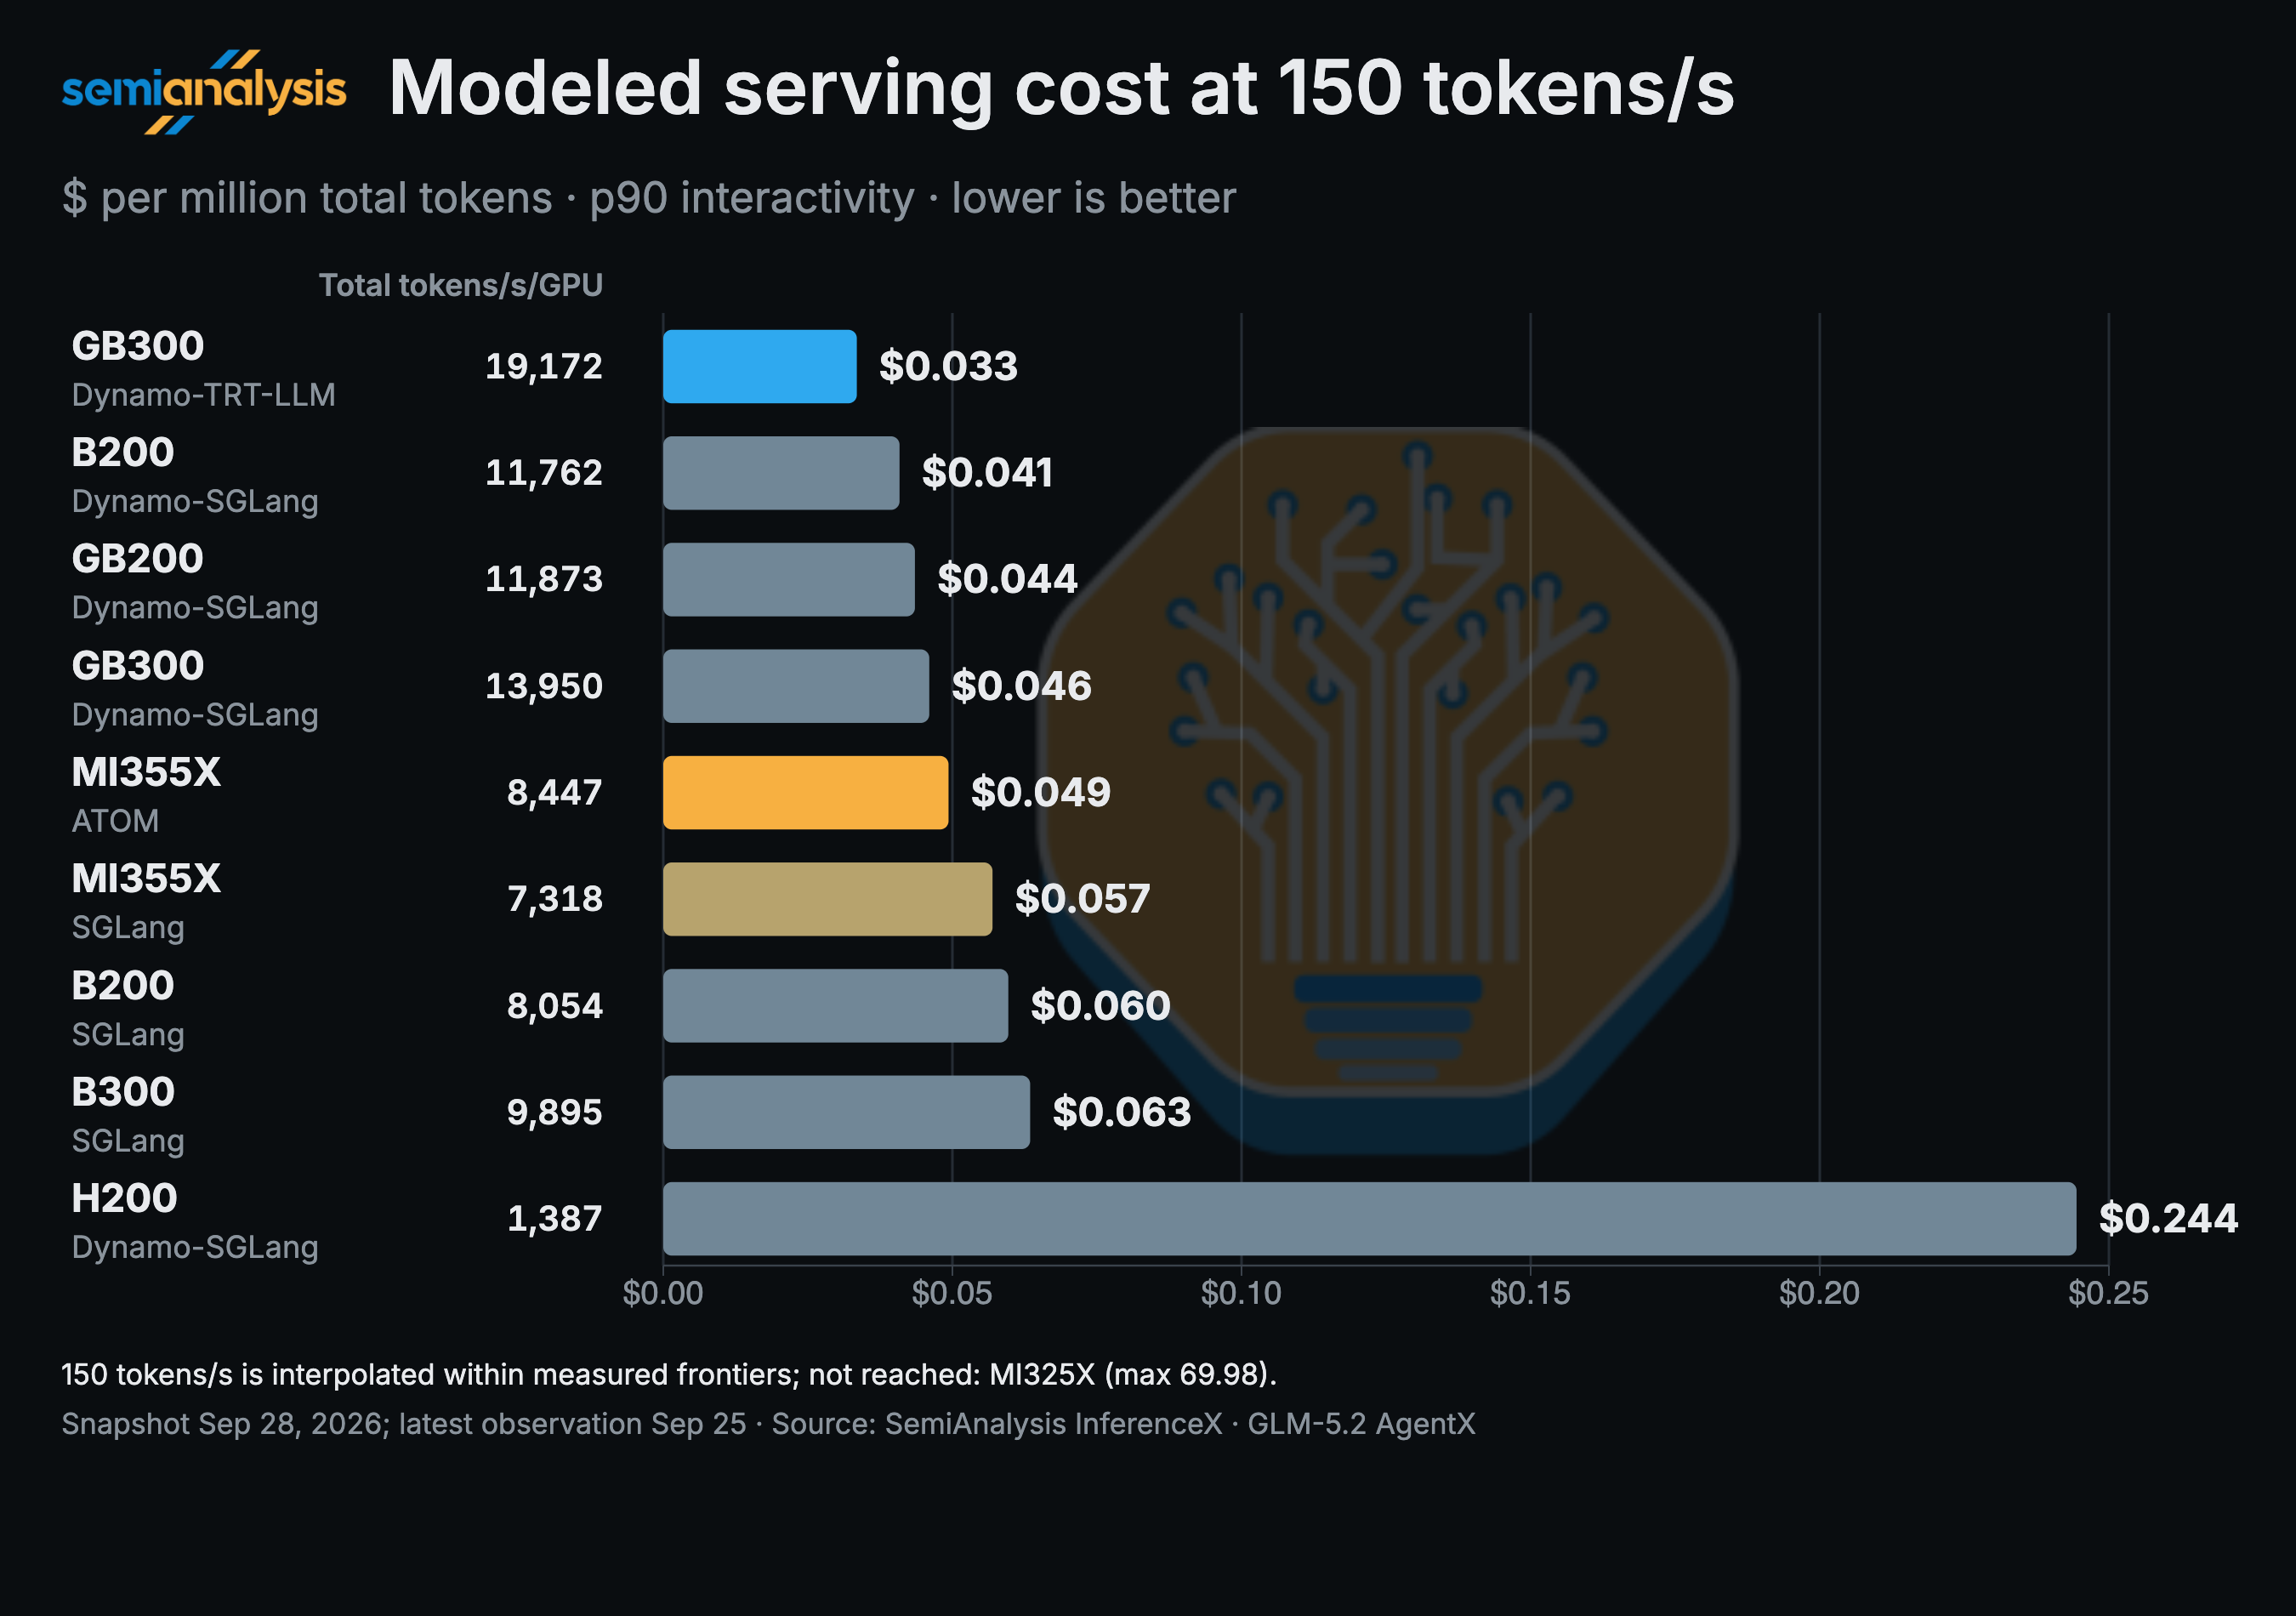
在 Dynamo-SGLang 的结果中,GB300 此处每 GPU 每秒处理约 13950 个总 token,比 GB200 的 11873 个高 17.5%。但我们假设 GB300 每 GPU 小时成本为 $2.31,GB200 为 $1.86。在这一目标速度下,GB300 更高的小时成本抵消了其吞吐量优势,且抵消幅度更大。
与 AMD 比较,在每秒 100 token 时,ATOM 的成本比 GB200 低约 13%;每秒 125 token 和 150 token 时,GB200 的成本分别低约 5% 和 12%。在这三个目标速度下,没有一方始终占据成本优势。
如果只计生成的输出,在每秒 150 token 的响应速度下,GB200 每百万输出 token 成本为 $5.92,比 MI355X ATOM 的 $6.68 低约 11%。这一指标有助于分析智能体工作负载的成本:智能体会反复复用较长的输入历史,但生成的新文本相对较少。
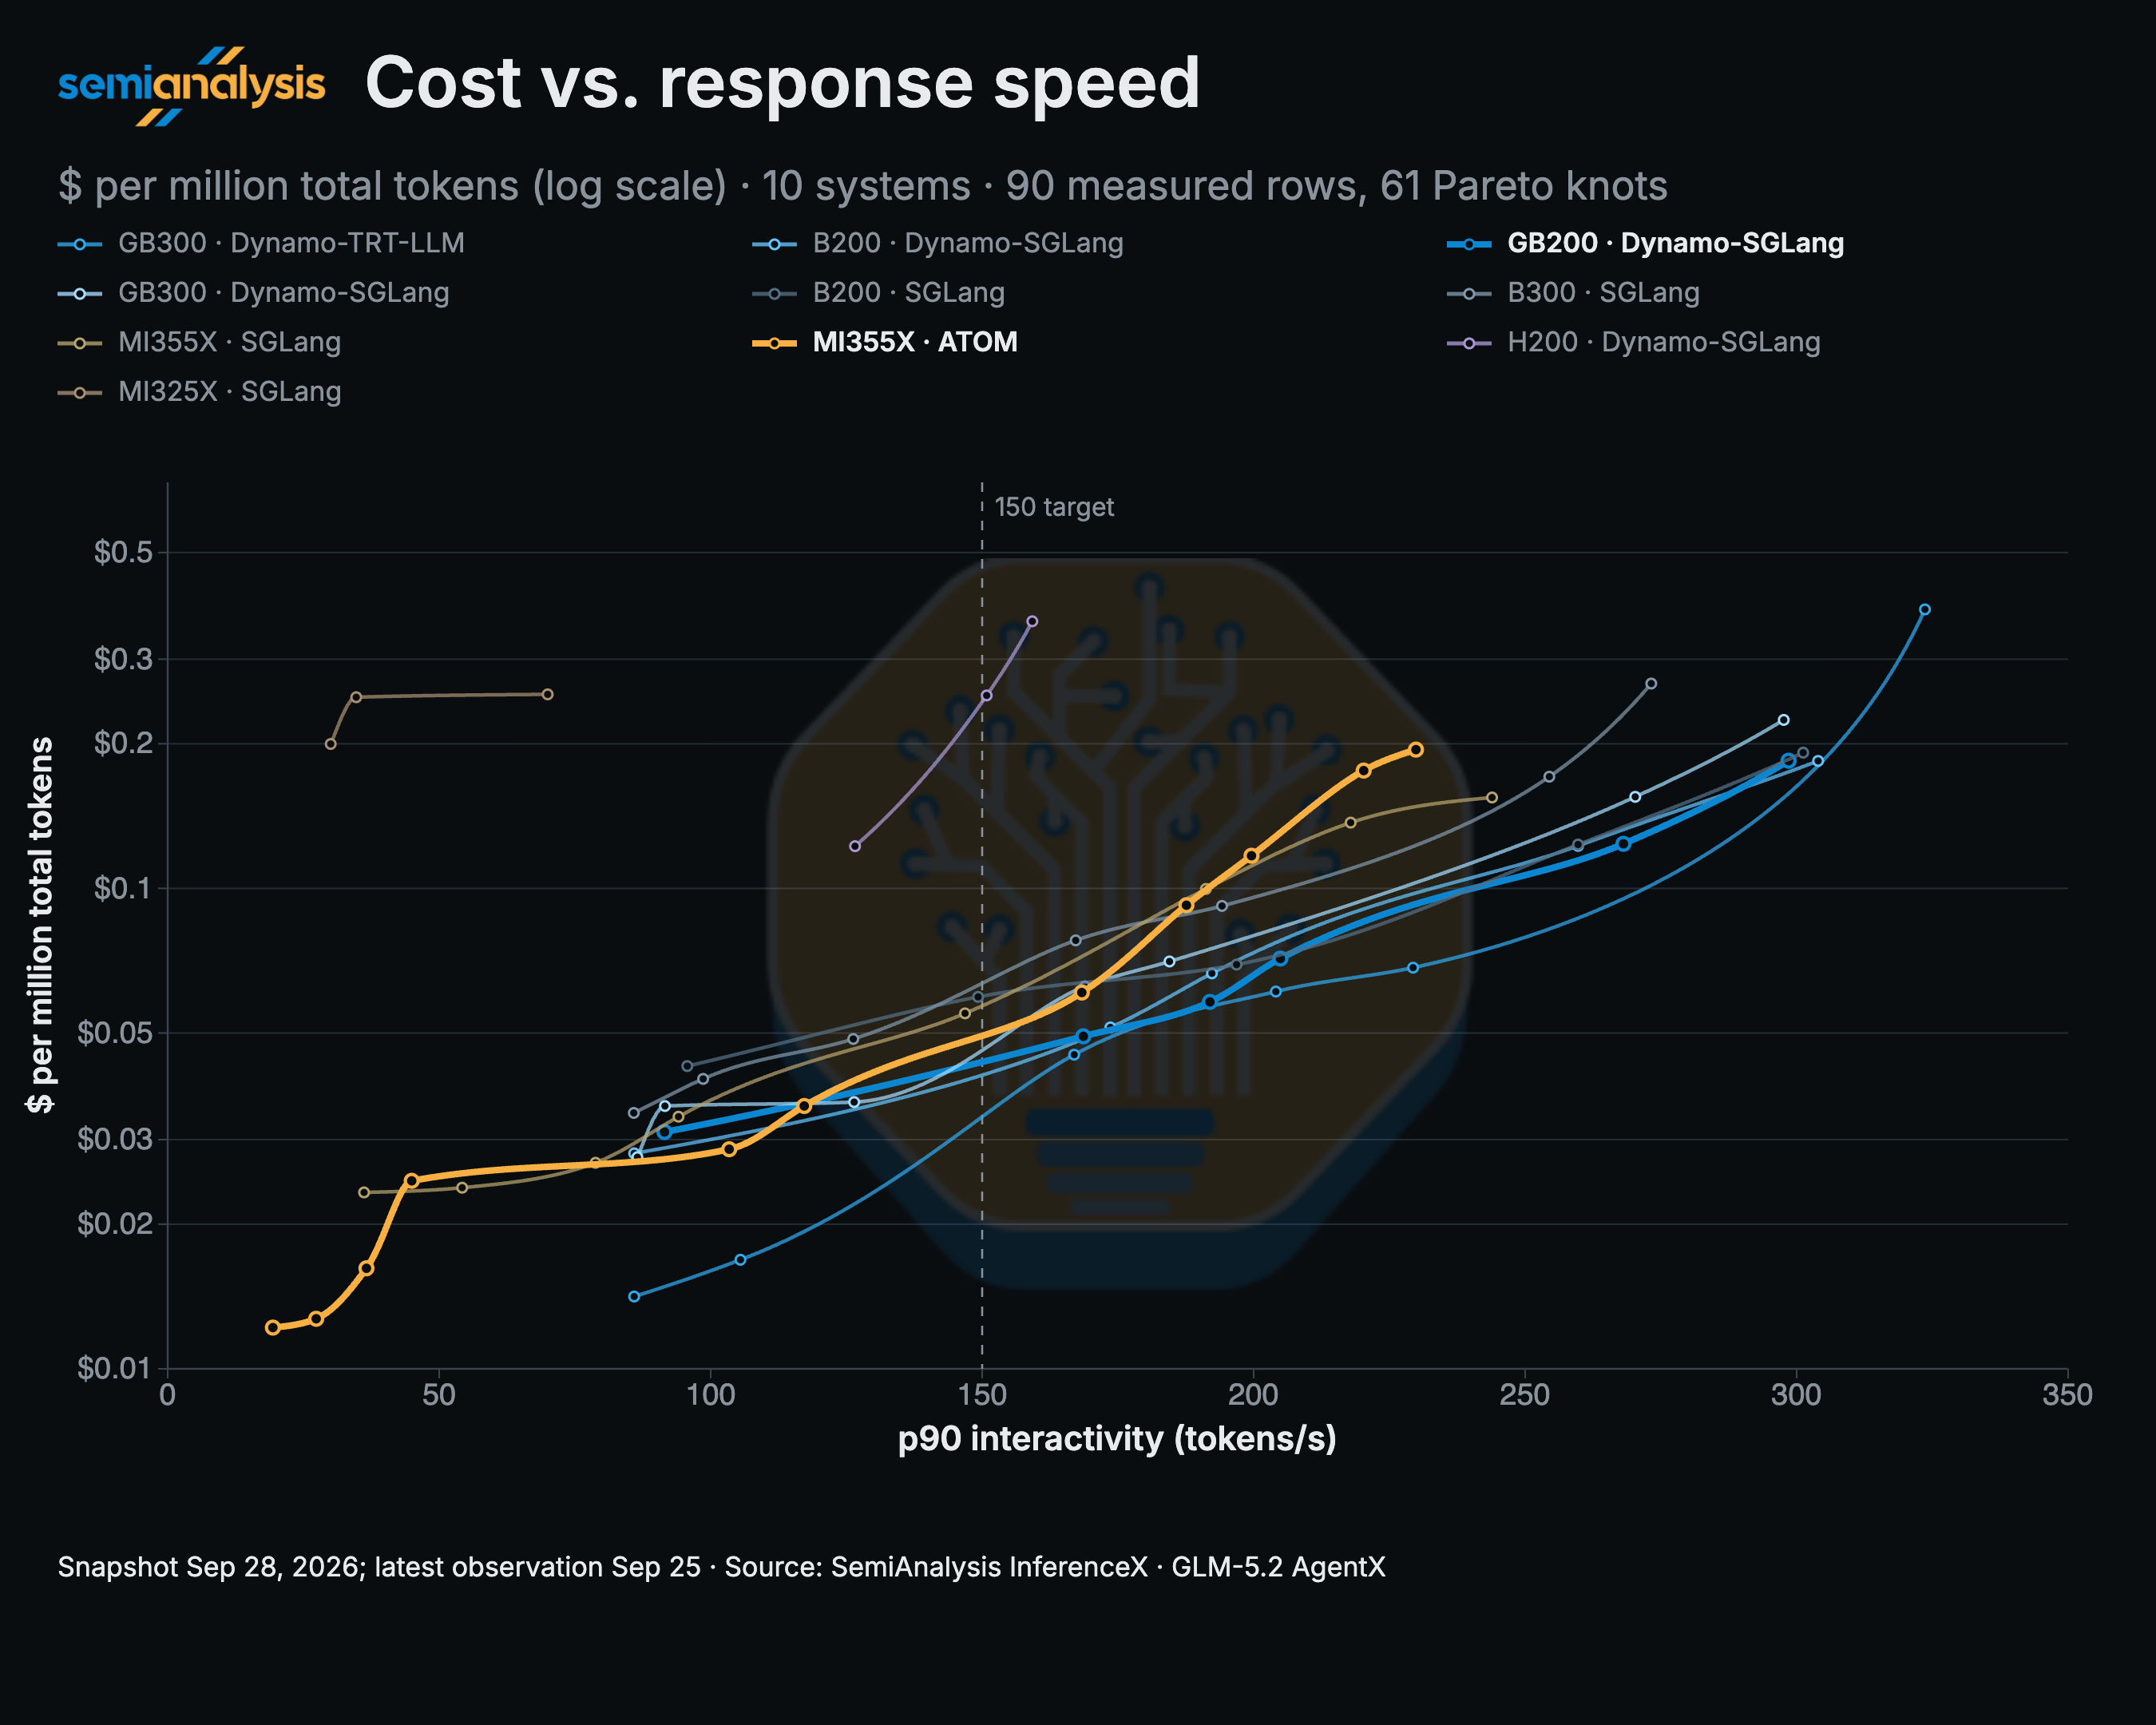
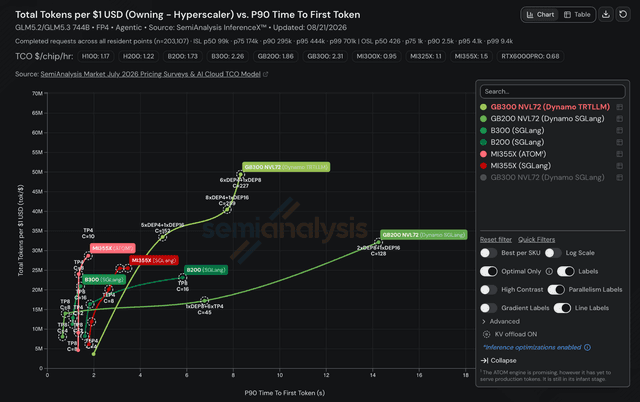
在每秒 150 token 目标两侧的 GB200 实测点,p90 TTFT(首 token 延迟)约为 14–19 秒,而 MI355X ATOM 约为 1.1–1.2 秒。GB200 部分最低成本测试的首 token 等待时间要长得多。
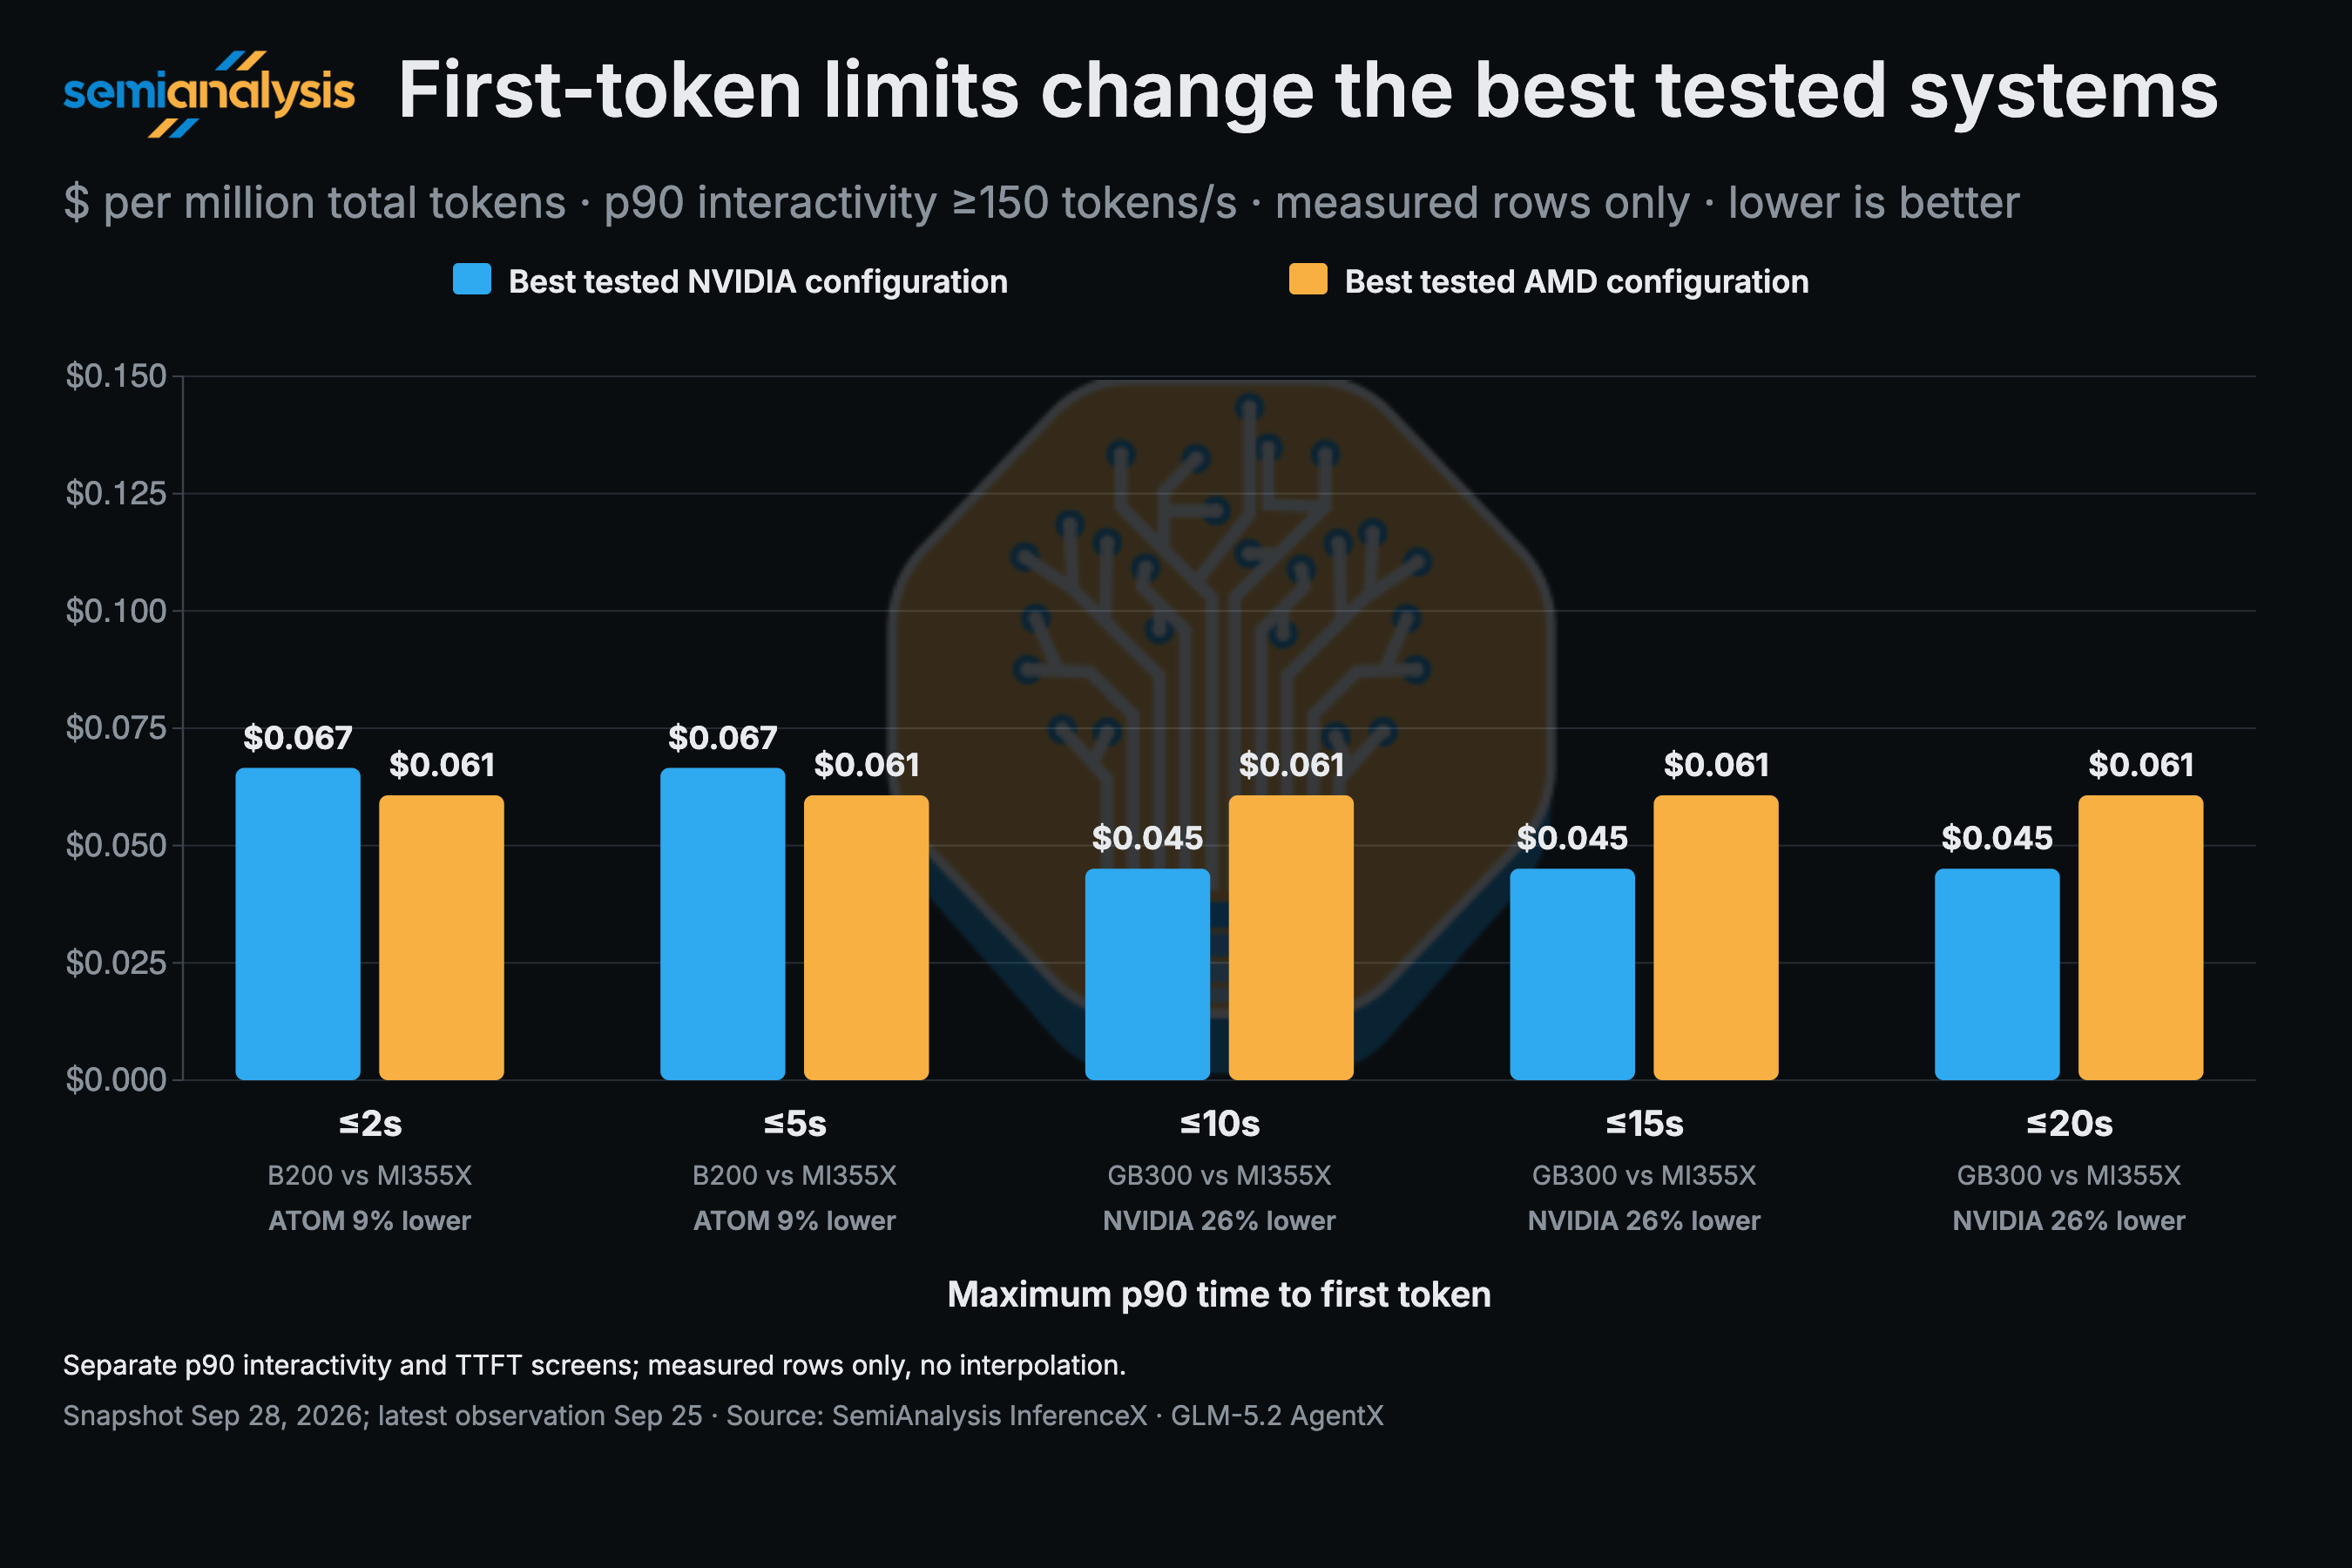
因此,我们另做一次比较,只纳入实际测试过、响应速度至少达到每秒 150 token 且 p90 TTFT 不超过两秒的配置。下图中,MI355X ATOM 每百万总 token 成本为 $0.0607,B200 Dynamo-SGLang 为 $0.0666。在两秒首 token 限制下,ATOM 的成本约低 9%。如果将限制放宽至十秒,GB300 Dynamo-TRT-LLM 也满足条件,成本为 $0.0451,比 ATOM 的 $0.0607 低约 26%。
优化
GLM 5.2 / 5.3 的注意力架构降低了内存需求,但长时间运行的智能体仍需保留较早的对话历史。GLM 通过两种方式降低处理历史的成本:KV 压缩减少每个 token 保存的缓存状态,稀疏注意力减少每次注意力操作读取的状态量。缓存存放在哪里、如何高效取回,则由推理引擎决定。
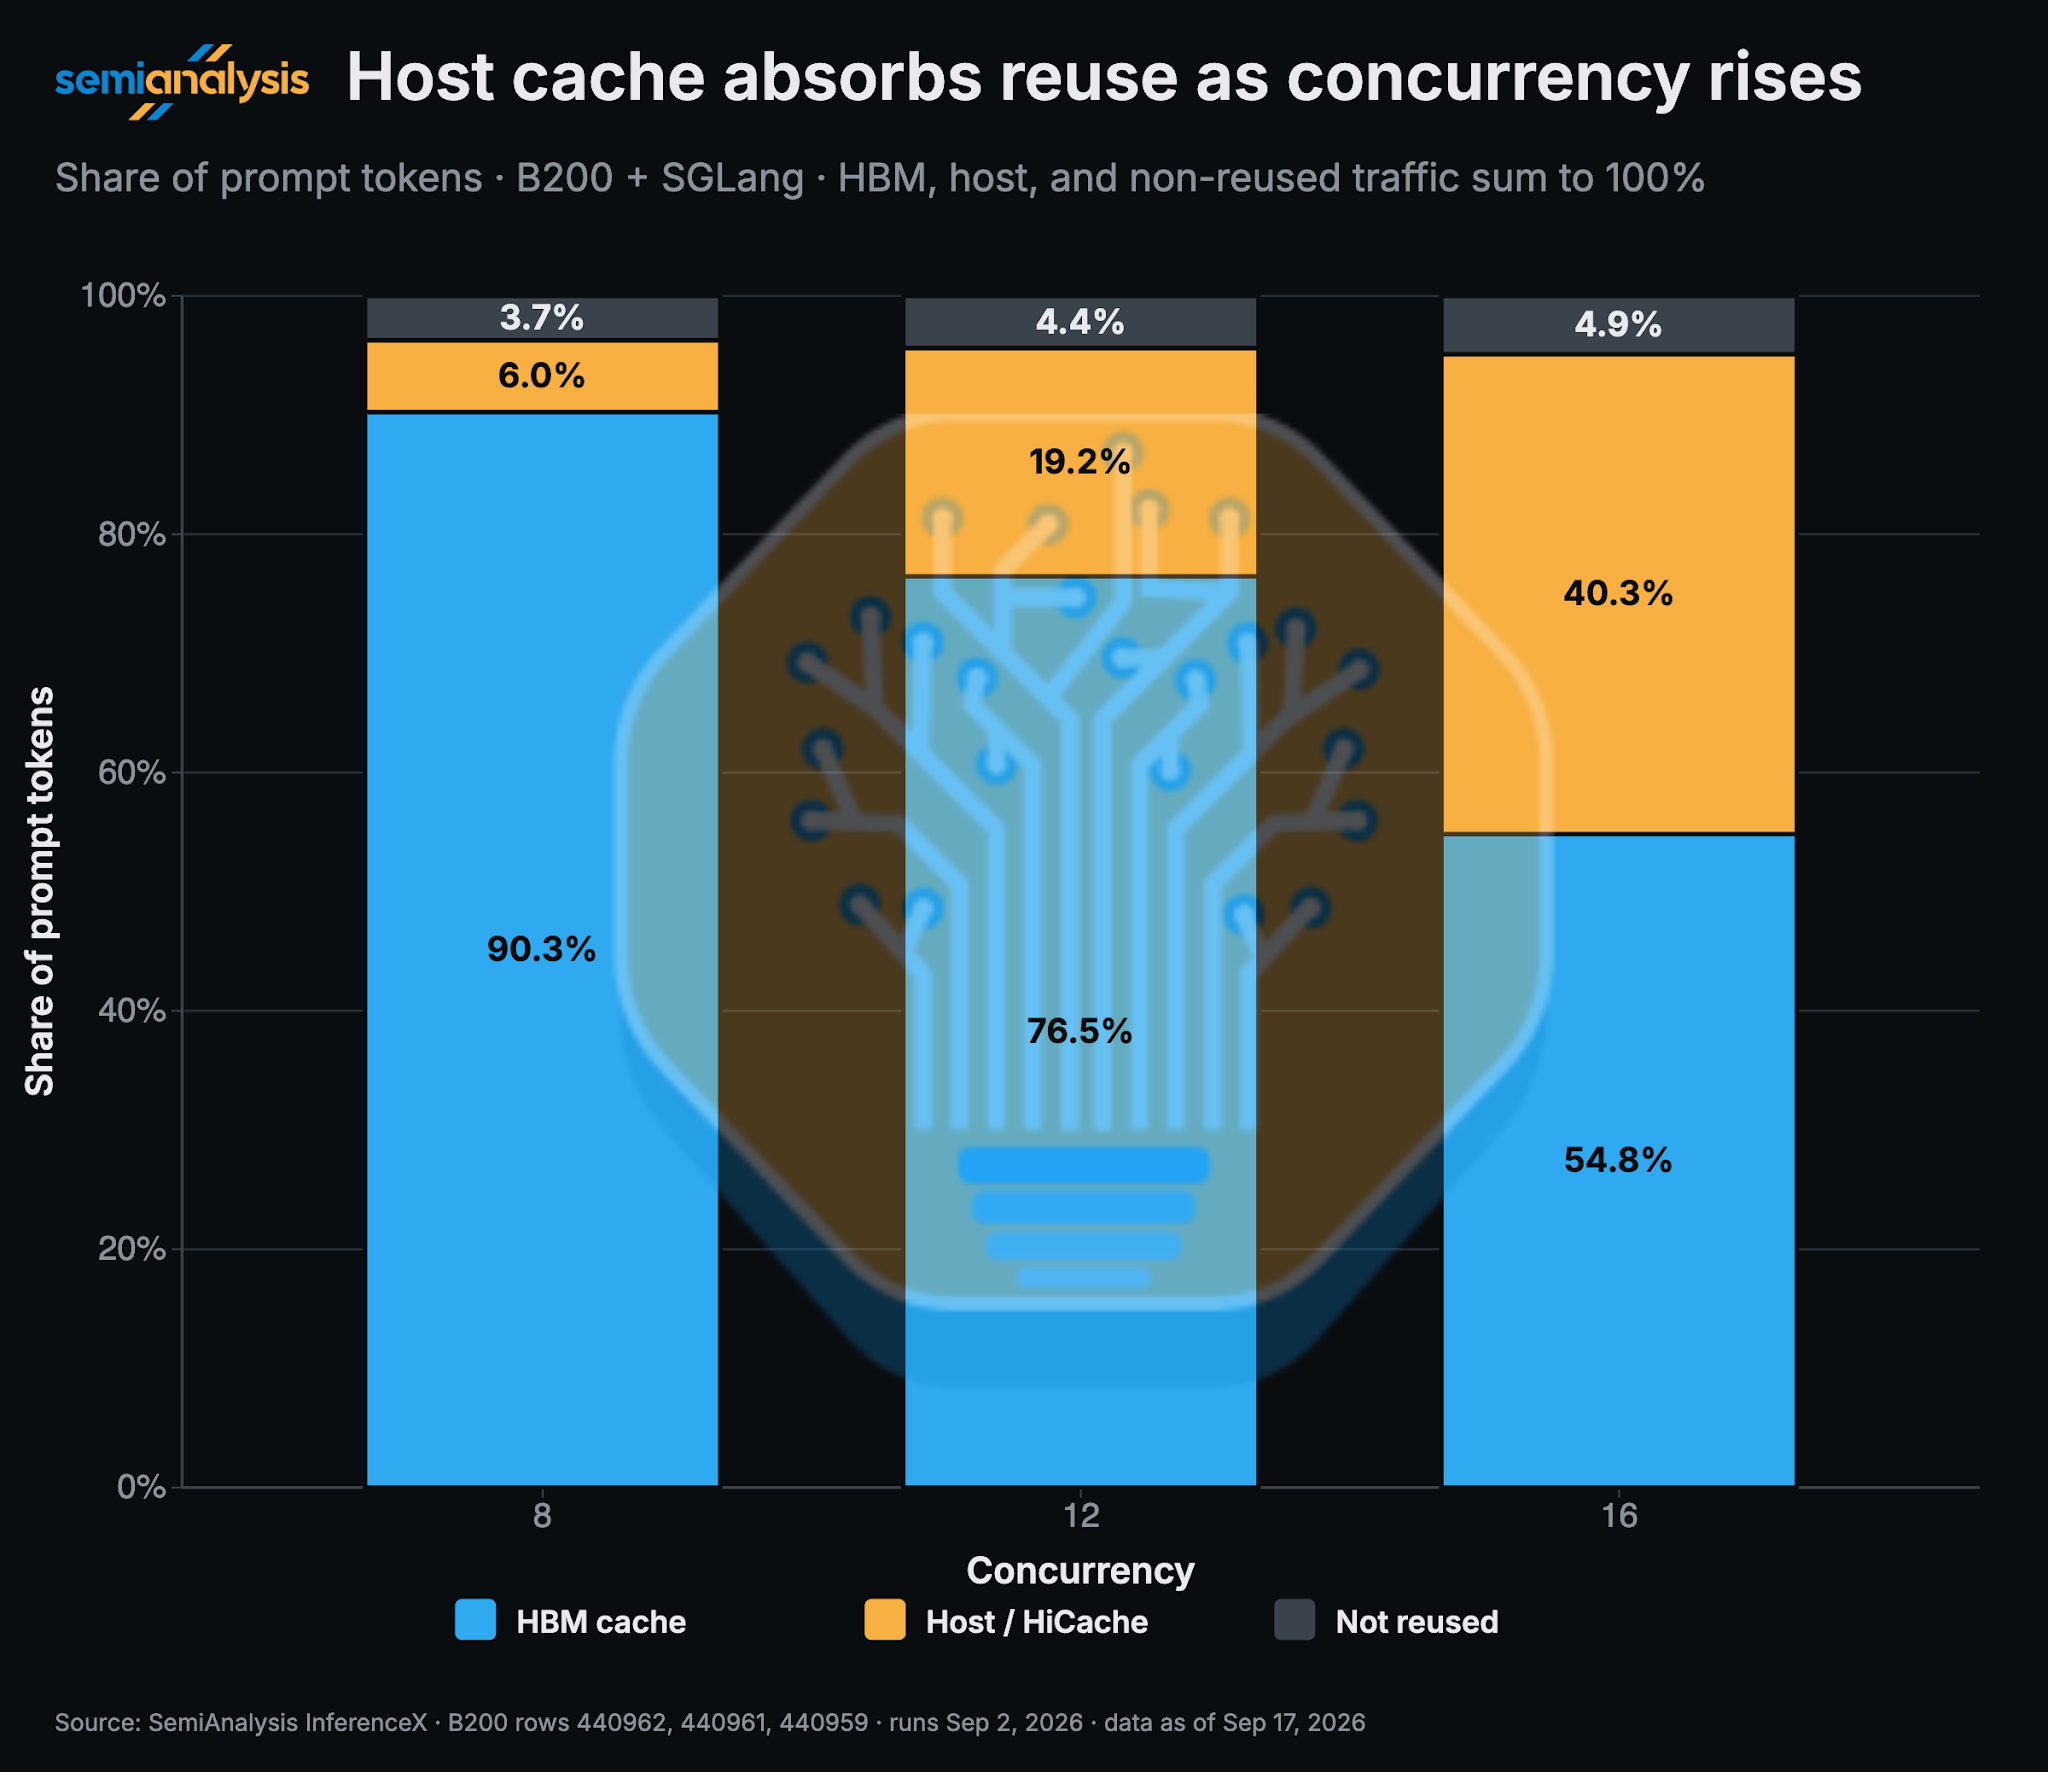
这些 B200 结果说明,GPU 内存之外也能承担大量缓存复用。当并发从 8 个请求增加到 16 个时,从 GPU 内存复用的 prompt token 比例由 90.3% 降至 54.8%;大量复用转移到主机内存,其比例由 6.0% 升至 40.3%。主机内存复用抵消了 GPU 缓存复用的大部分下降,使各并发水平下的总体缓存命中率都保持在 95% 以上。
除了缓存管理,推理引擎执行 prefill 和 decode 的方式也会影响性能。两项独立的 GLM-5.2 研究说明了这一点:
- 在一项 NVFP4 研究中,vLLM 让第一个 decode 步骤保持一致的 CUDA graph 执行路径,将平均 TPOT(每个输出 token 的时间)从约 40 ms 降至 22 ms。
- 在另一项使用 8 张 MI355X 的长上下文工作负载中,ATOM 引擎跨流水线阶段分块处理 prefill,使总吞吐量提高 98%,并将 TTFT 中位数从 28.6 秒降至 8.7 秒。
TileRT
TileRT 对 GLM5.3 的支持首先落地于 AMD MI355X。TileRT 是一种低延迟 LLM 推理引擎,将 decode 编译成单个持久化内核,减少内核启动开销,并让计算、内存访问和通信重叠。
它优先提高单用户 token 生成速度,而非追求最大批处理吞吐量;prefill 则由 vLLM 处理。
NVIDIA GPU 也能实现超高交互速度?TileRT InferenceX
收取溢价的“快速模式”证明,用户愿意为更低延迟和更快的 token 生成付费,这可能带来更高毛利率。因此,OpenAI 等前沿 AI 实验室正在评估专用推理系统,包括 Cerebras 和 NVIDIA Groq LPU。
在 AgentX 上,FP8 TileRT MI355X 的 P90 interactivity 达到最佳 FP4 MI335X 配置的 2 倍;与 GB300 NVL72 相比,interactivity 提高 40%。以往这类服务指标需要专用硬件才能实现。
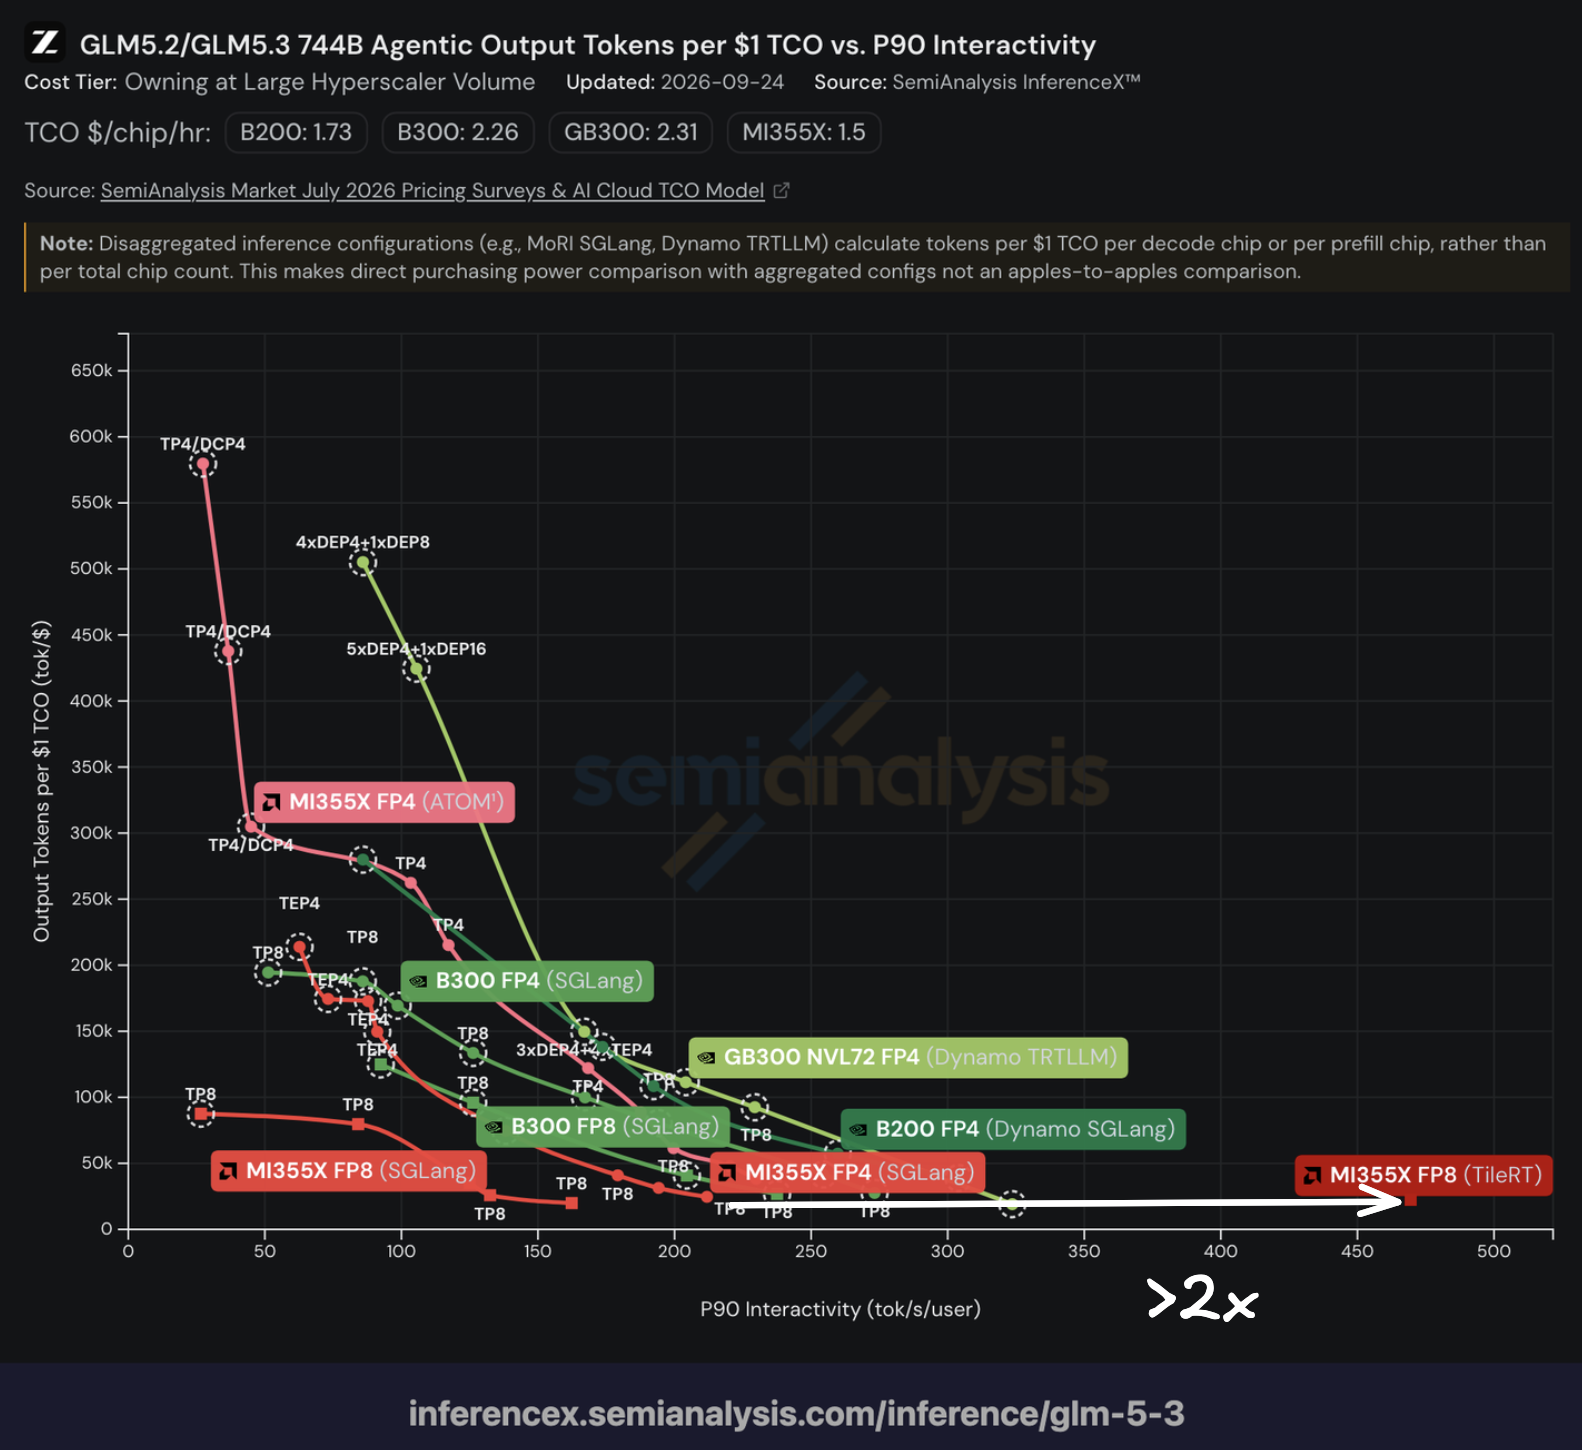
不过,TTFT 尚不理想,仍有改进空间,包括优化 KV 传输、支持 FP4,以及支持更大的 batch size。
DeepSeek Sparse Attention
GLM-5(以及 GLM-5.x 系列)是一个总参数量 744B、激活参数量 40B 的混合专家模型。每个 token 使用 1 个共享专家,并从 256 个专家中路由到 8 个,稀疏度为 32。它采用 DeepSeek Sparse Attention,本节将详细介绍。
DeepSeek V3.2 引入的 DeepSeek Sparse Attention(DSA)包含两个部分:选择 top K 个 token 的 lightning indexer,以及稀疏 Multi-Latent Attention(MLA)。
Lightning Indexer
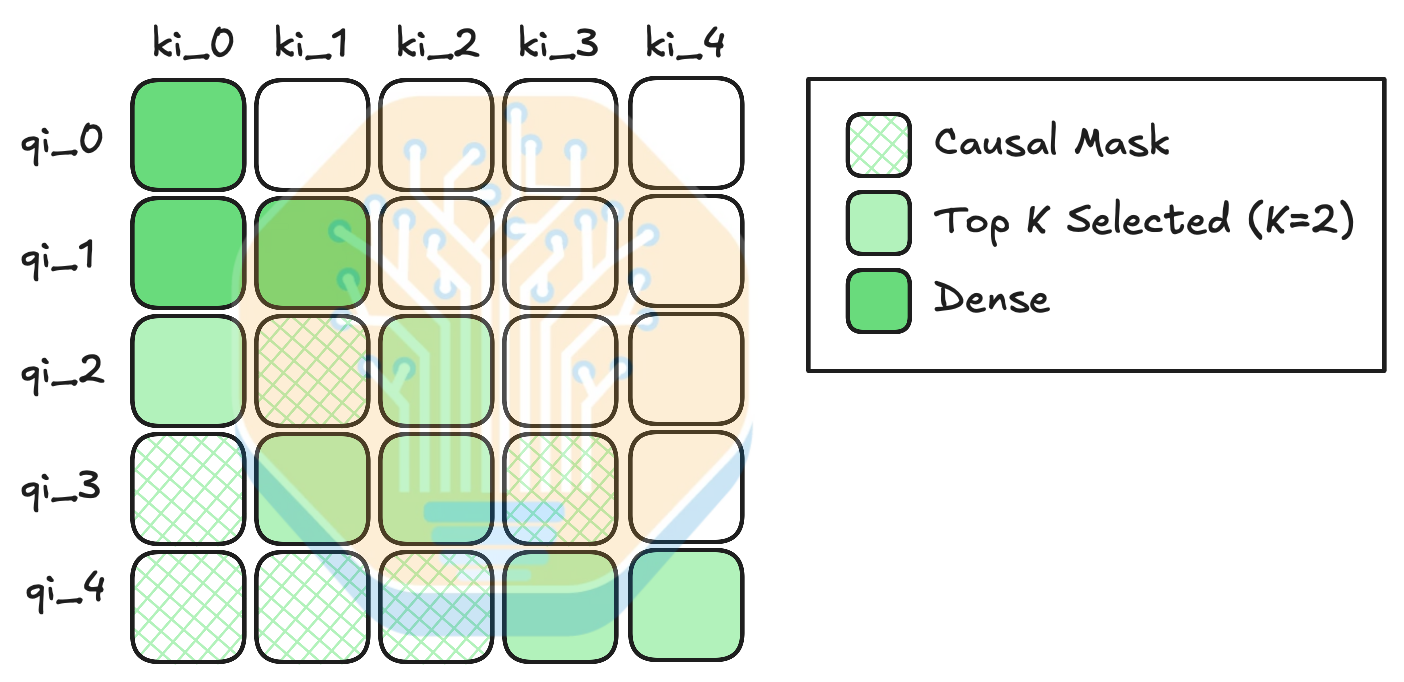
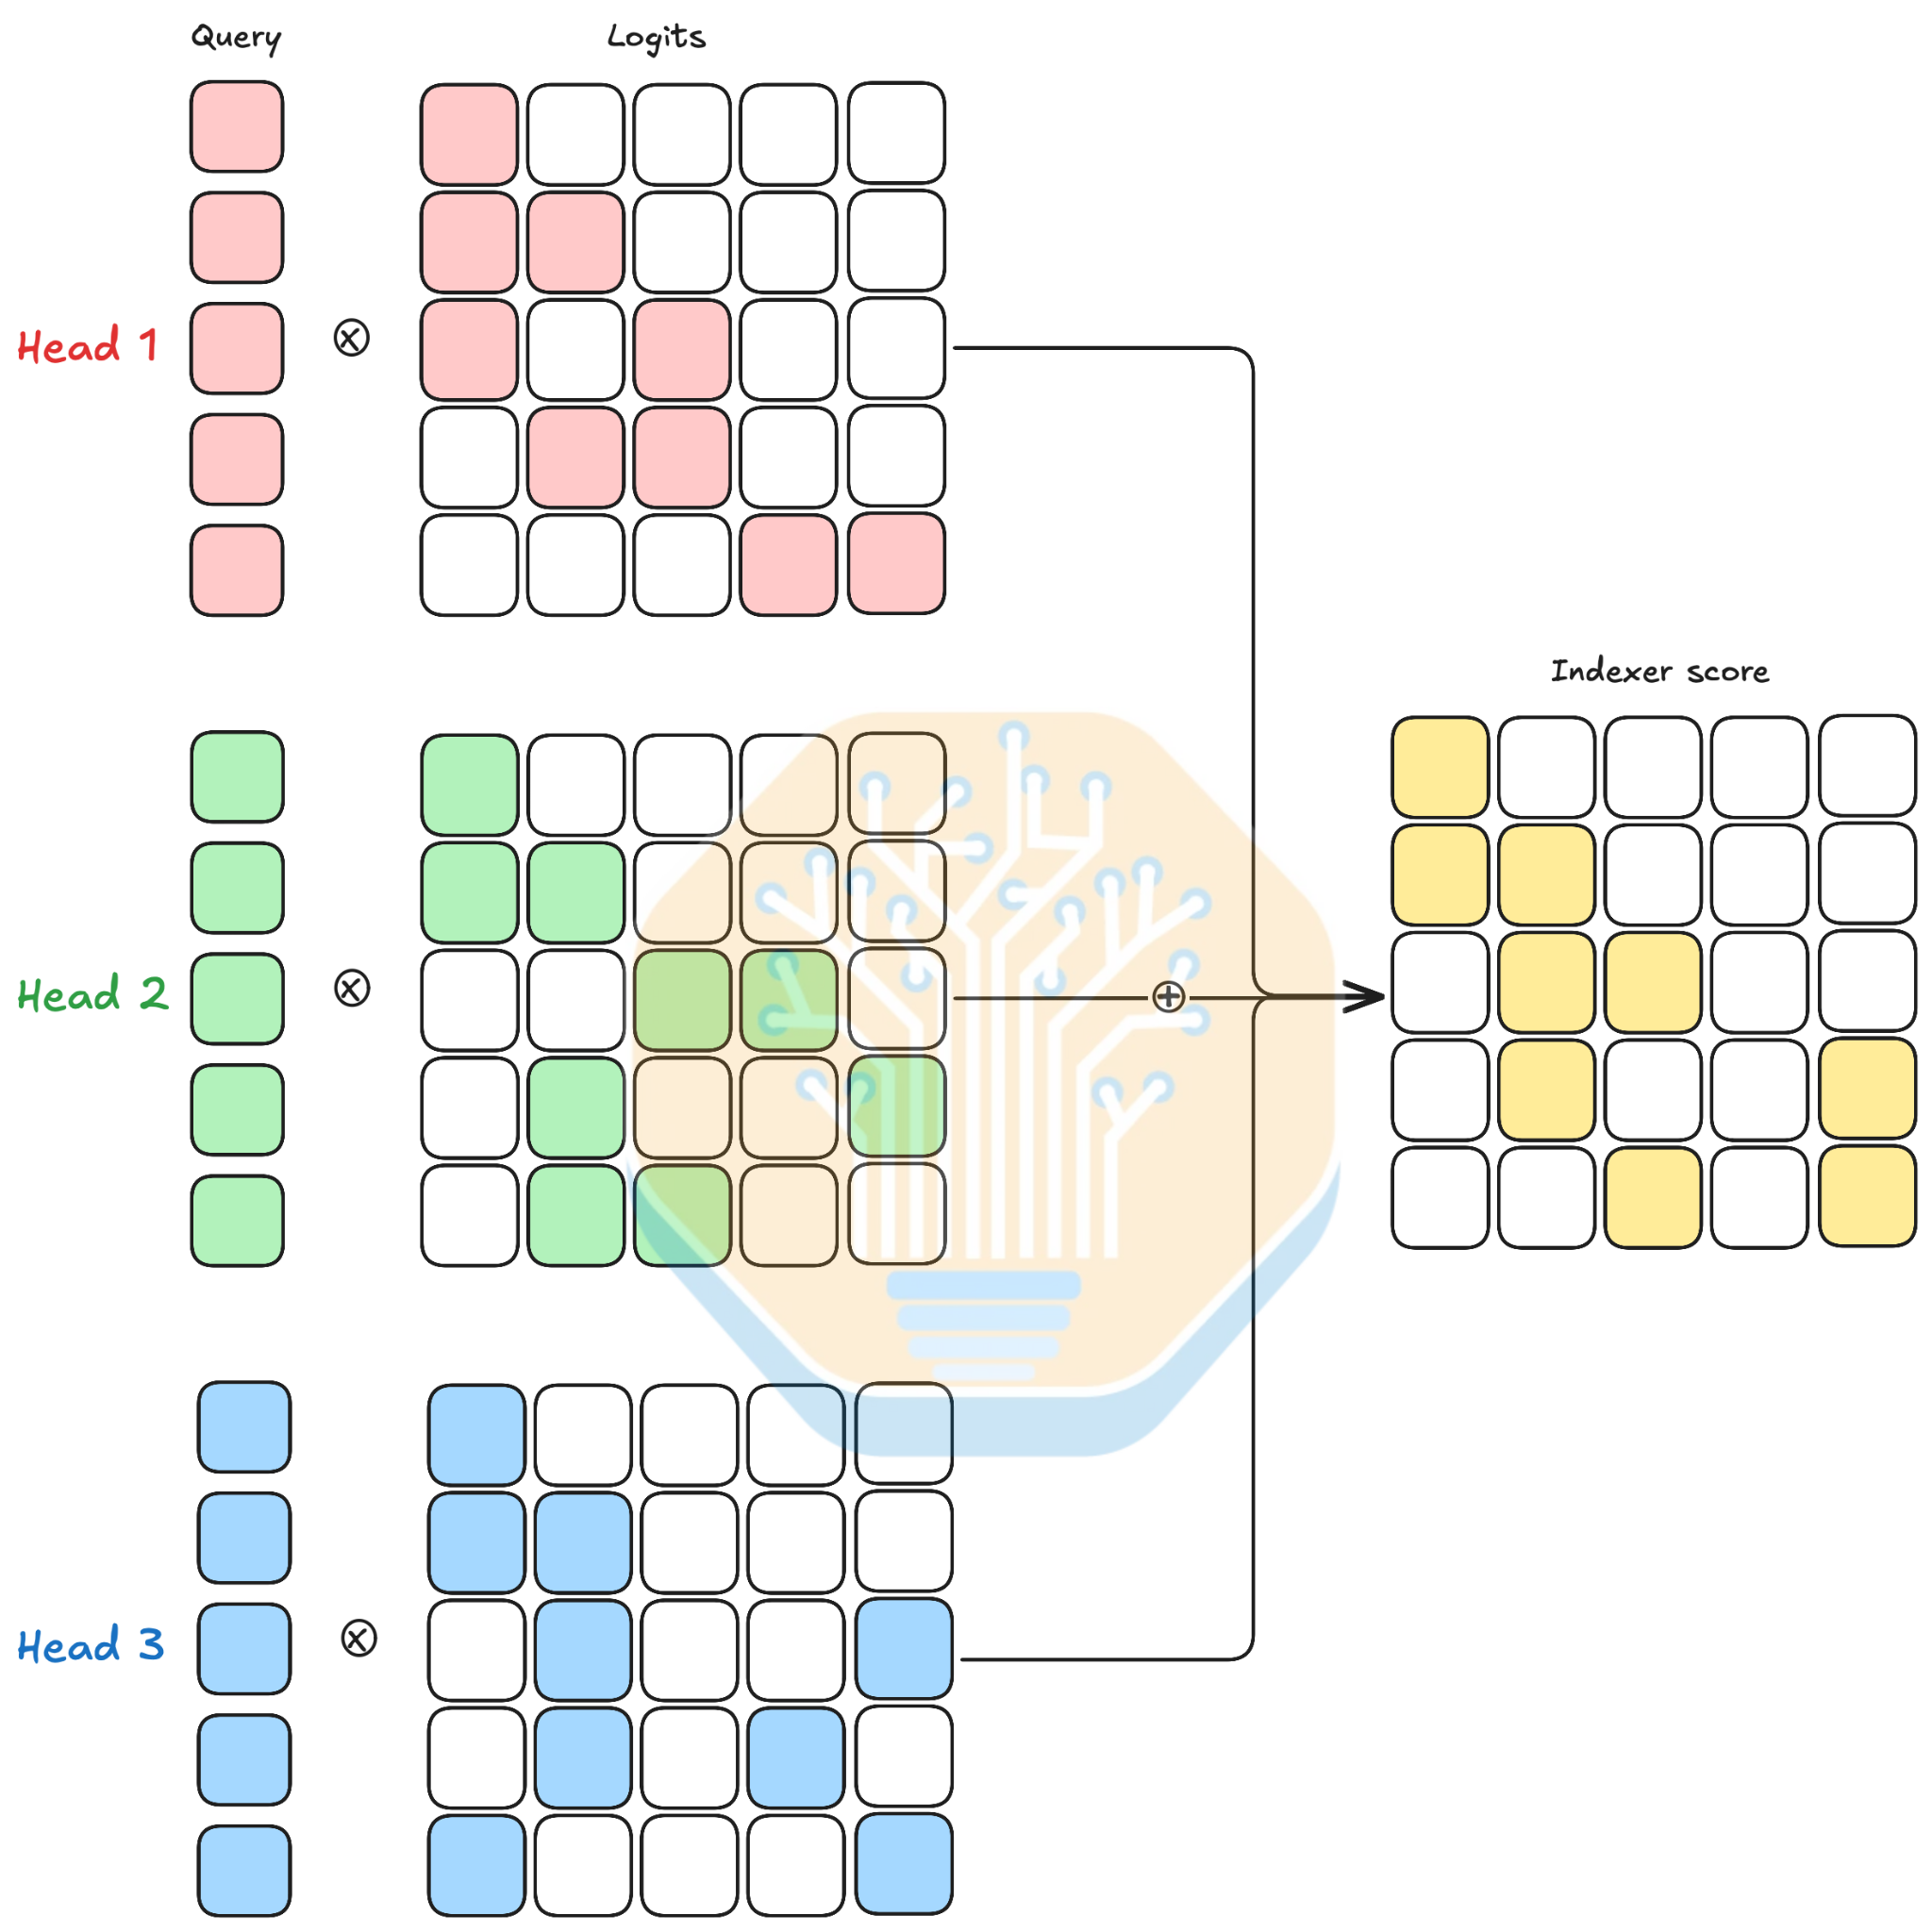
lightning indexer 在功能上类似轻量级注意力机制。query 和 key 被投影到更低维度,其中 indexer query 是多头的,key 则是单头的。选择 top K 个 token 只需要 query 与 key 的相关性分数(logits),因此 indexer 不需要 value embedding,也不需要用 softmax 对 logits 归一化。它先计算 query-key 点积,再应用 ReLU 非线性函数,然后对所有 query head 的 logits 加权求和,得到每个 token 的 indexer 分数,并据此选择 top K。这意味着,虽然 indexer 有多个 head,多个 attention head 共享同一组 token 选择结果。如果 query 可关注的 token 少于 K 个,仍使用稠密注意力;否则选取 top K。
稀疏 MLA
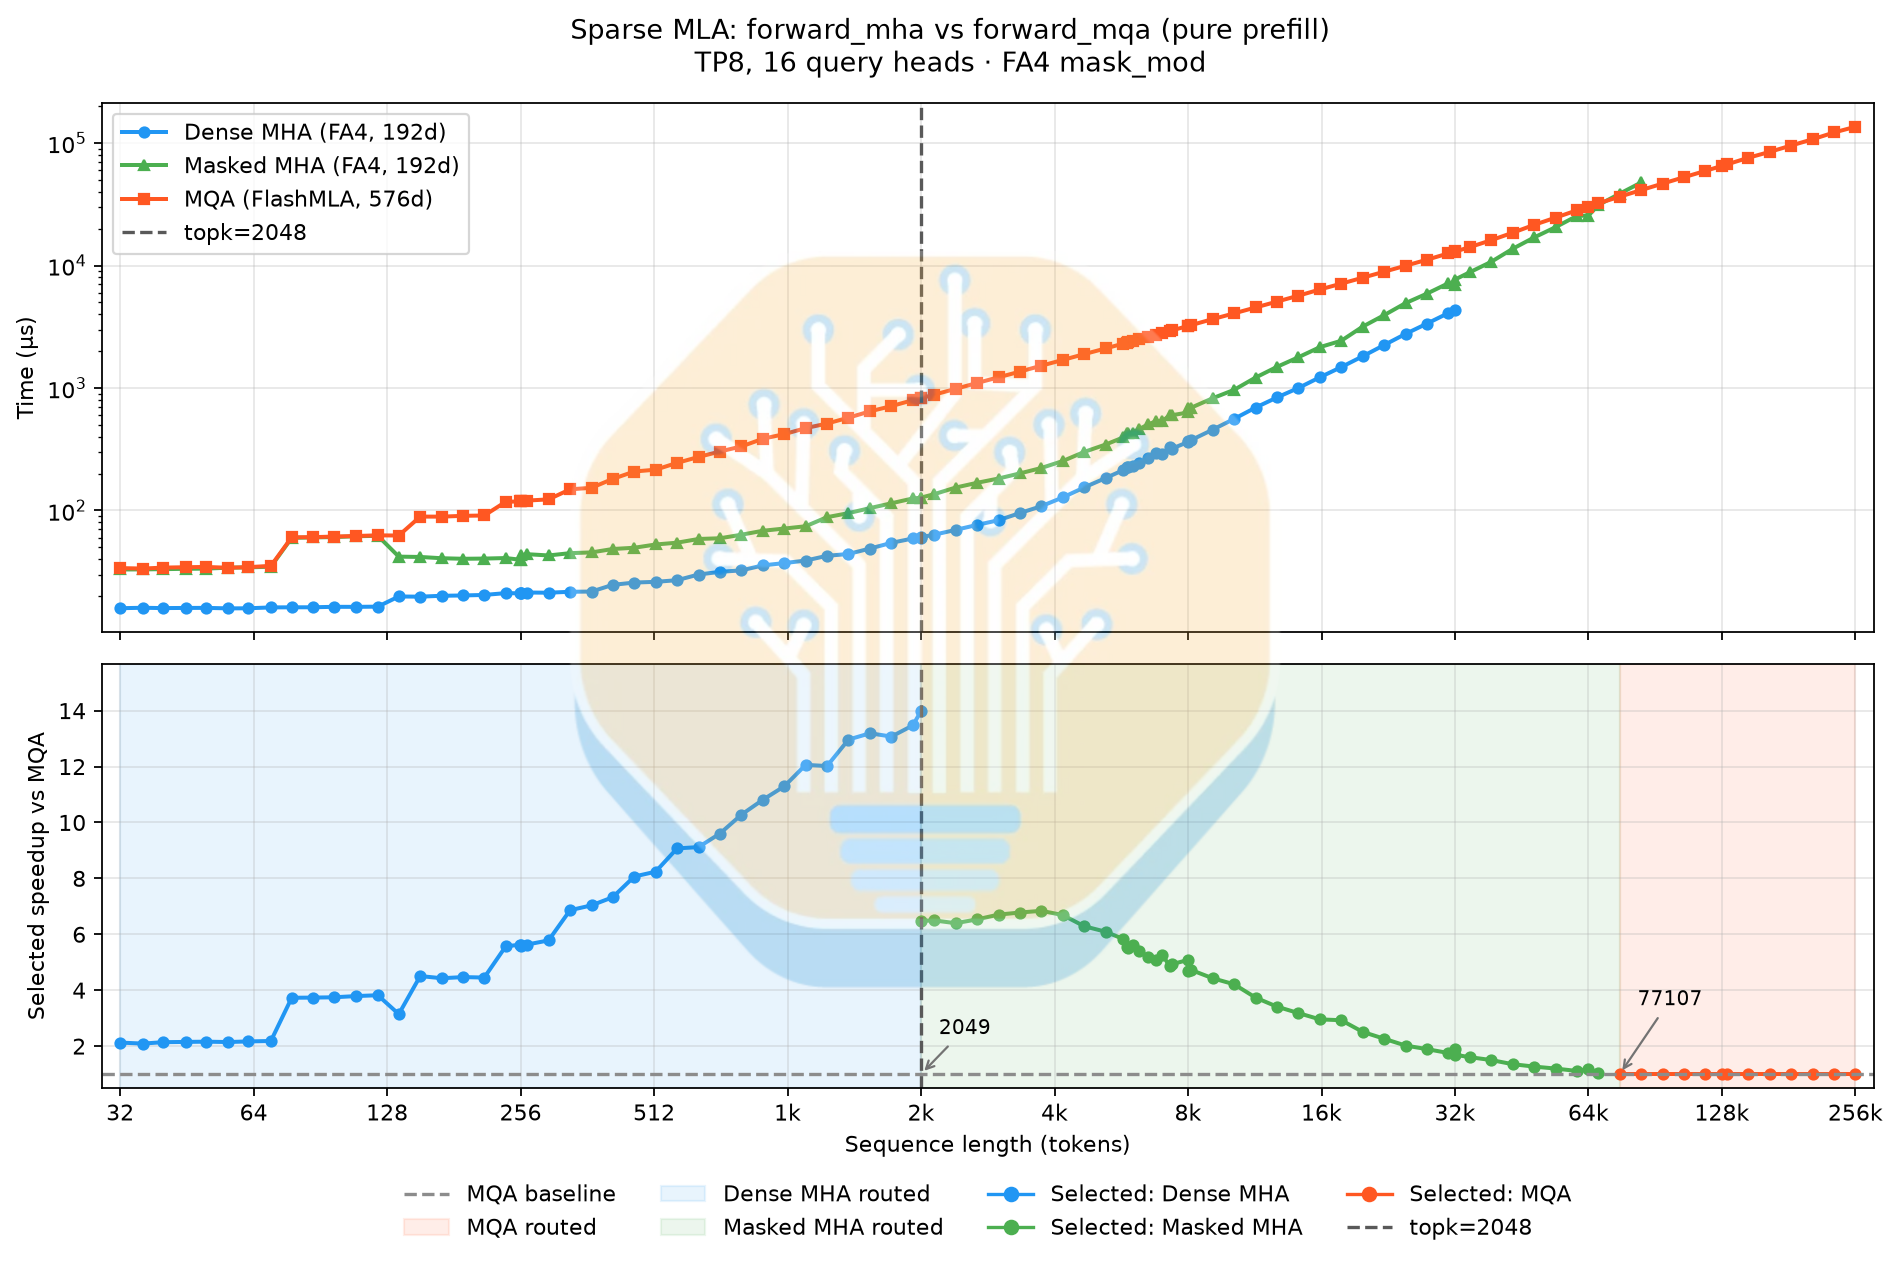
我们在 Kimi K3 文章中解释过,MLA 有 Multi-Head Attention(MHA)和 Multi-Query Attention(MQA)两种运行模式。两者各有取舍:MHA 的 FLOPs 较少,但内存成本是 42 倍;MQA 的内存成本较低,但 FLOPs 最多达到 3.4 倍。DSA 使用 MQA 模式,因为稀疏注意力关注的 token 更少,可以缓解其较高的计算量。不过,实际存在一个序列长度阈值,低于该阈值时 MHA 反而更高效。直观上,较短序列下内存加载时间的主导性较弱,FLOPs 较少的 MHA 就可能占优。vLLM 实现了这一机制:数据并行时,序列长度从 2K 到约 5K 使用 MHA;张量并行时,则从 2K 到约 77K 使用 MHA。下限设为 2K,是因为 top K 为 2048,而低于 2K 时使用稠密注意力。
MLA 的修改
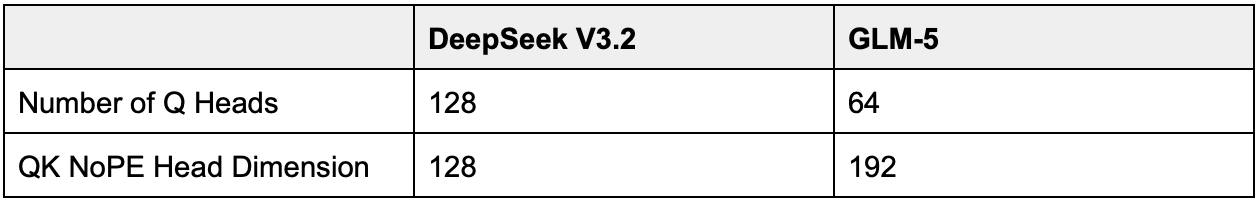
比较 GLM-5 与 DeepSeek V3.2 的 MLA 维度配置,最显著的差异是 query head 数量与 query-key head 维度。
GLM-5 技术报告提到,DeepSeek 按照 H800 的 roofline 选择 query head 数量。这很可能是指,decode 阶段 MLA 的 SDPA 算术强度大致位于 H800 的 ridge point。推导如下,假设:
L:序列长度d:head 维度r:RoPE 维度H:head 数量b:每个参数的字节数
在 MQA 模式下,FLOPs 为:
2 * H * L * (d+r)  # P = Q [H, d+r] @ K.T [d+r, L]
2 * H * L * d      # O = P [H, L] @ V [L * d]
加载的内存量为:
b * H * (d+r)  # Q
b * L * (d+r)  # K and V
因此,算术强度为:
(2 * H * L * (2 * d + r)) / (b * (d+r) * (L + H))
= (2 * H * L * (2 * d + r)) / (b * L * (d + r))  # L >> H
= (2 * H * (2 * d + r)) / (b * (d + r))
代入 DeepSeek V3.2 的配置(d = 512、r = 64、b = 2),得到:
(2 * H * (2 * 512 + 64) / (2 * (512 + 64)) ~= 2 * HH800 的实际算术强度为 258.2 FLOP/B(根据 DeepSeek,实际峰值为 865 TFLOP/s,带宽为 3.35 TB/s),代入公式可得 H ~= 128。
GLM-5 的 H = 64,query head 数量减半,这意味着它可能针对不同硬件进行了设计。代入 GLM-5 配置(d = 512、r = 64、b = 2、H = 64),算术强度为 120.8 FLOP/B。因此,我们推测 GLM-5 可能针对摩尔线程 MTT S4000 做了优化,后者约为 128 FLOP/B。摩尔线程与 Z.ai 的合作,例如 GLM-5.3-Flash 首日支持,也为这一推测提供了佐证。
此外,GLM-5 将 QK NoPE 维度从 128 提高到 192,消融实验表明,在 FLOPs 和参数量相同的约束下,这一配置更优。SDPA head 维度因此从 192 增至 256,但考虑到 head 数量减少,FLOPs 仍降低了 33%。
IndexShare
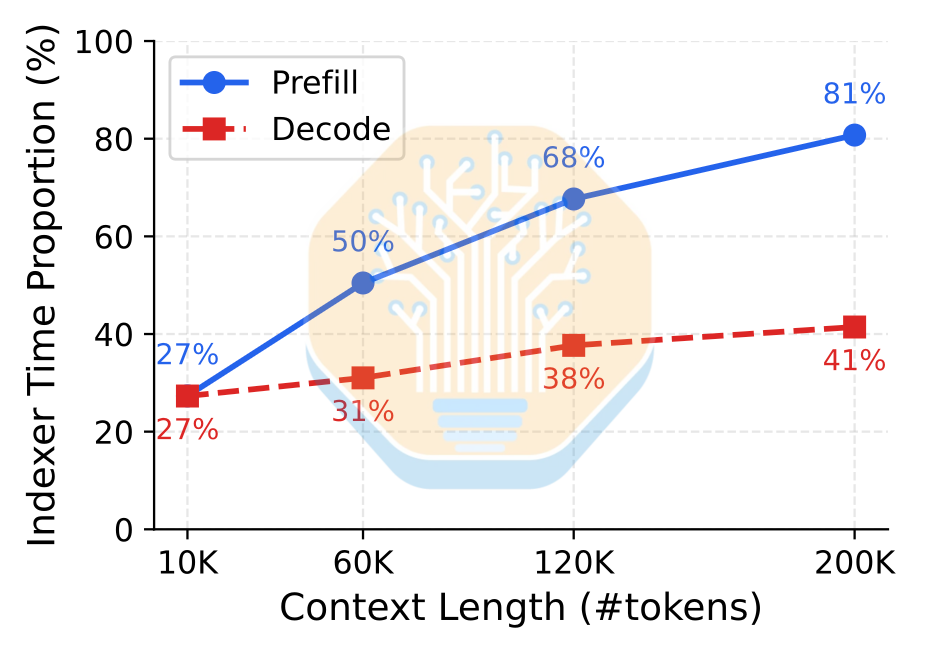
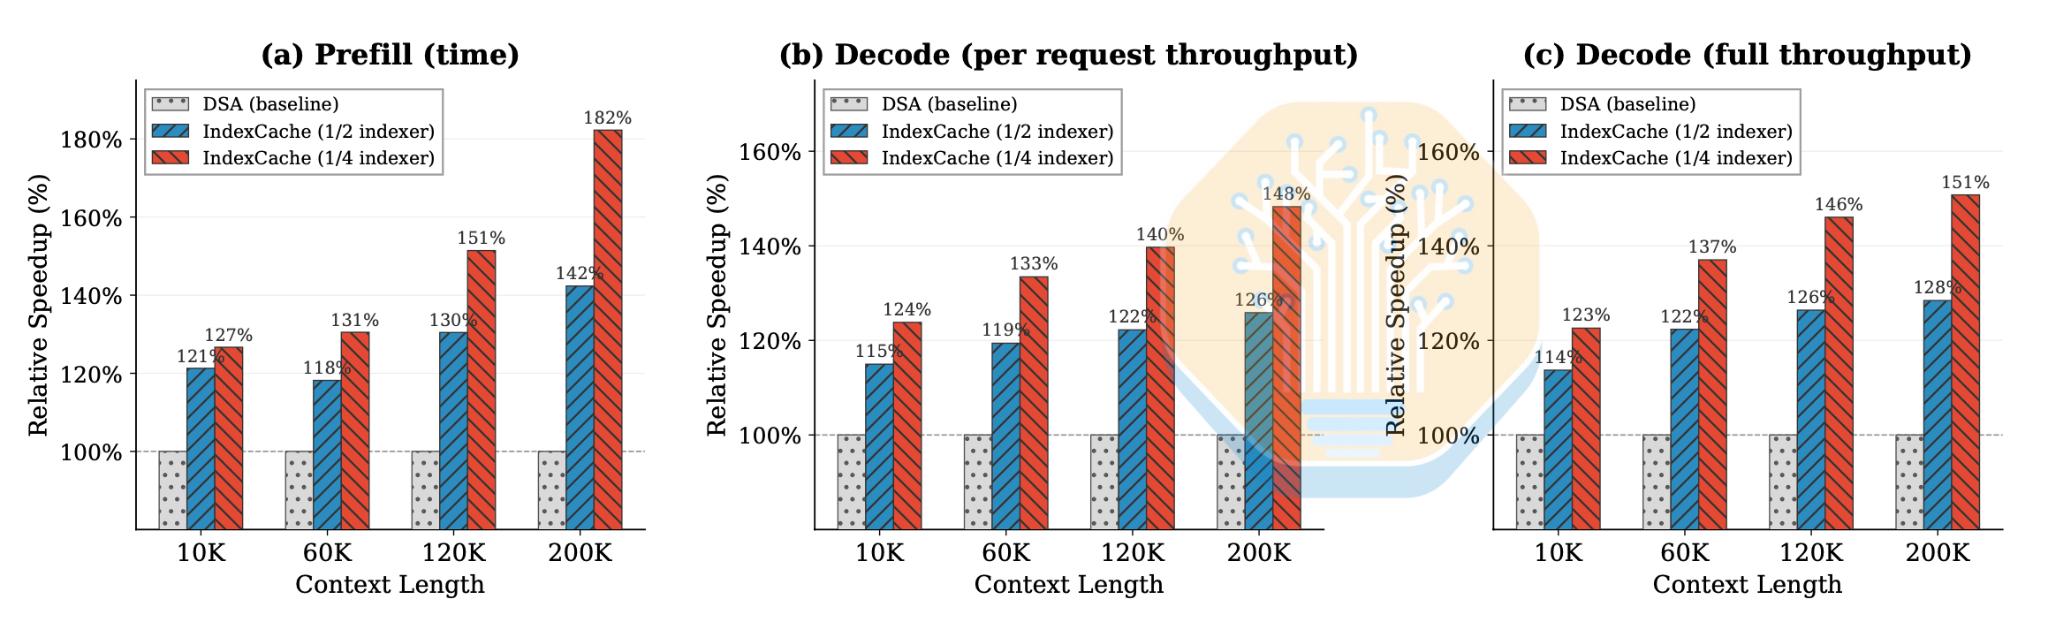
随着上下文增长,indexer 的延迟开销变得不可忽略。为降低这一开销,Z.ai 在 GLM-5.2 中提出 IndexShare(也称 IndexCache),让每 4 个 DSA 层共享一个 indexer。
IndexShare 也增加了训练和推理的复杂性。标准 DSA 训练分为两个阶段:首先是稠密 warmup,冻结除 indexer 外的全部模型权重,并执行稠密注意力计算;随后进入稀疏适应阶段,使用稀疏注意力训练整个模型。
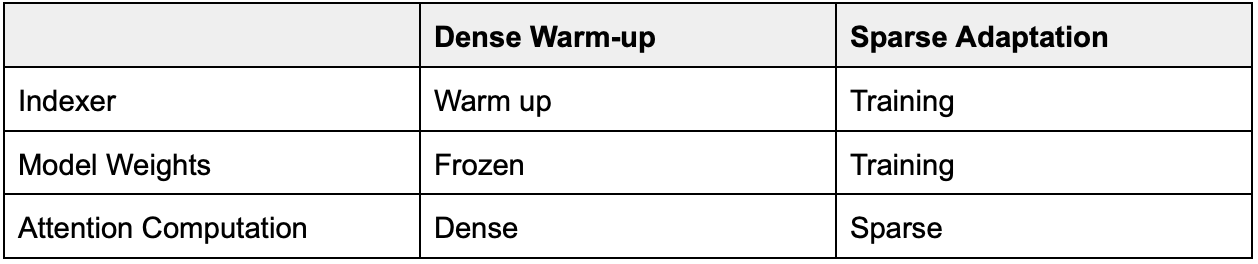
在训练目标上,indexer 使用 KL 散度目标,与各 attention head 的分数之和对齐。IndexShare 将目标改为使 indexer 的 logit 分布与共享层之间注意力分数的平均分布对齐。
推理时,indexer 通常缓存 key,类似注意力缓存 KV。多个层共享一个 indexer 后,还需要在完整计算 indexer 的层中缓存 top K 索引,供共享层复用 token 选择结果。
这一设计使 indexer cache 减少 75%,indexer FLOPs 减少 75%,并在不同上下文长度及 prefill/decode 场景下将吞吐量提高到 1.5 至 1.8 倍。
后训练设计
训练流程
完成预训练和中期训练后,GLM-5 的后训练首先进行监督微调(SFT),随后经历三个 RL 阶段:推理 RL、智能体 RL 和通用 RL。最后进行 on-policy 跨阶段蒸馏,将推理 RL 和通用 RL 的能力蒸馏回 SFT checkpoint。
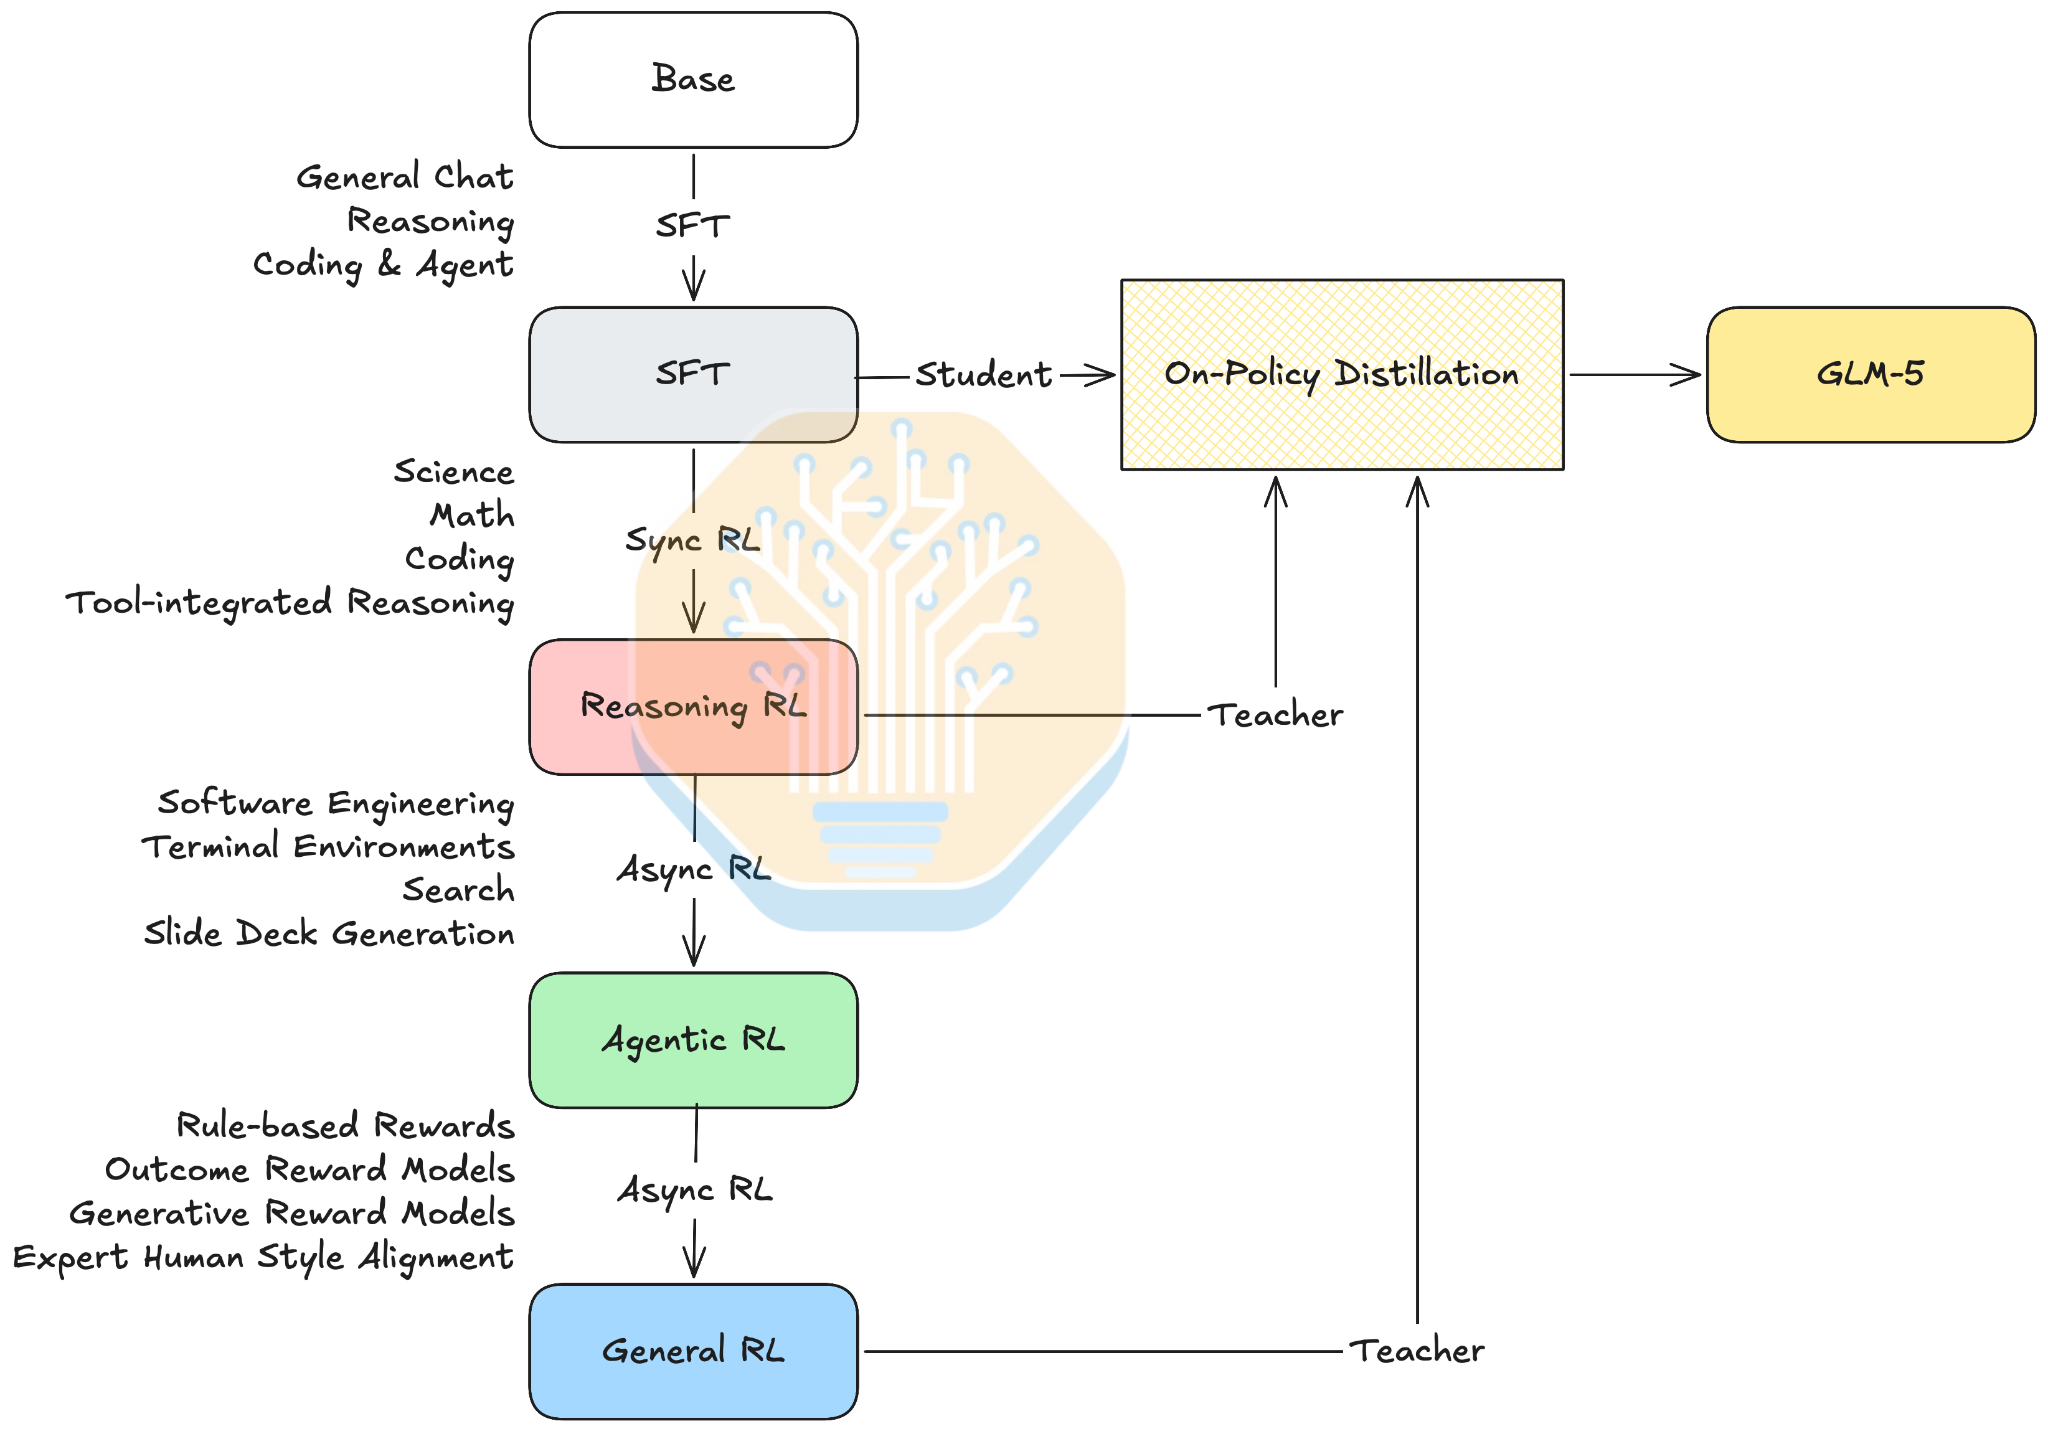
这里有两个值得注意的细节。首先,技术报告称推理 RL 模型完全采用 on-policy 训练,意味着训练是同步的。同步 RL 的系统效率较低,但训练稳定性较高。其次,on-policy 跨阶段蒸馏类似多教师 on-policy 蒸馏(MOPD):学生模型通过多个教师模型的 on-policy 蒸馏进行 RL 训练。但 MOPD 的目标是将多个专家教师合并成一个模型,而 GLM-5 在这里似乎更侧重于恢复学习新能力时损失的旧能力。如果这一理解正确,我们不确定 Z.ai 为什么只使用推理 RL 和通用 RL checkpoint 作为教师,而不是使用全部三个 RL checkpoint。
根据发布博客,GLM-5.2 可能已将 on-policy 跨阶段蒸馏替换为标准 MOPD 流程,Z.ai 称之为 parallel OPD training。Z.ai 强调了其规模与训练效率:用约两天训练,将十余个专家模型合并为最终模型。
RL 训练算法
Z.ai 在同步和异步 RL 阶段采用不同算法。下面比较它们的 RL 目标的主要差异。
同步 RL 阶段采用基于 Group Relative Policy Optimization(GRPO)的算法,并引入以下改动:
- 移除 KL 正则项,提高系统效率,并允许更激进的梯度更新。
- IcePop:根据训练与推理之间的不匹配比率,进行 token 级 masking。
- Clip-Higher:提高重要性采样比率的上限,以鼓励探索。
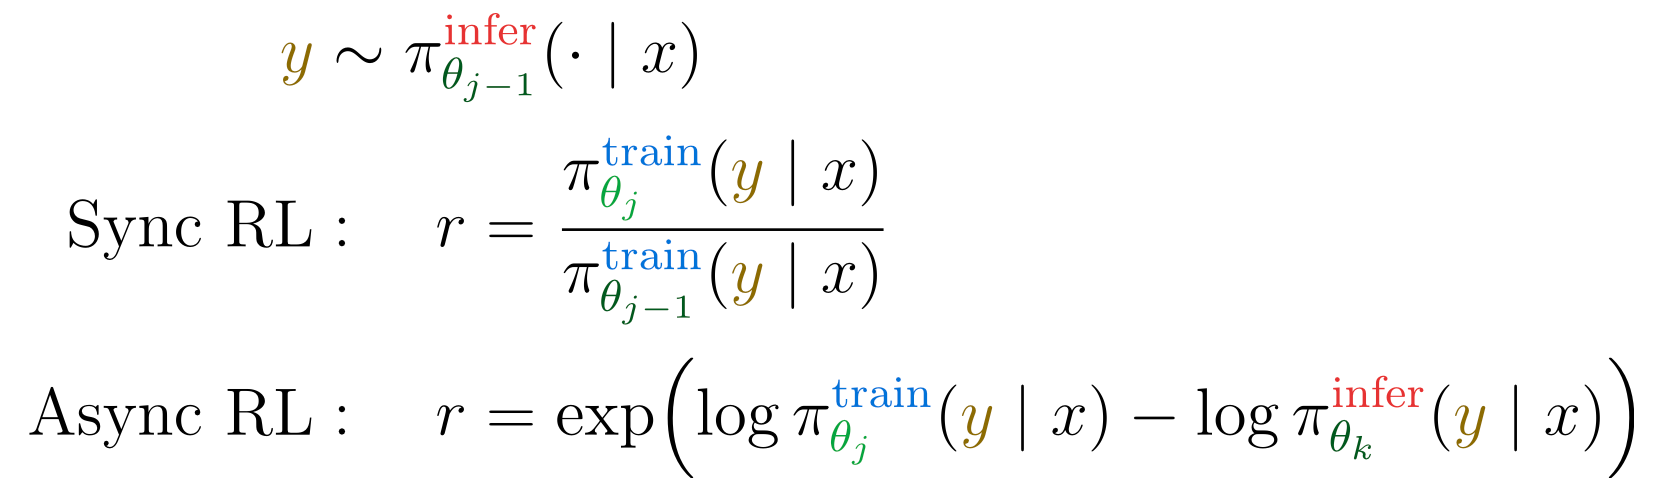
异步 RL 阶段则采用类似 REINFORCE 的算法,并加入 Direct Double-Sided Importance Sampling(DIS),一种类似 IcePop 的裁剪机制。下图比较两个 RL 阶段的 token 级目标:
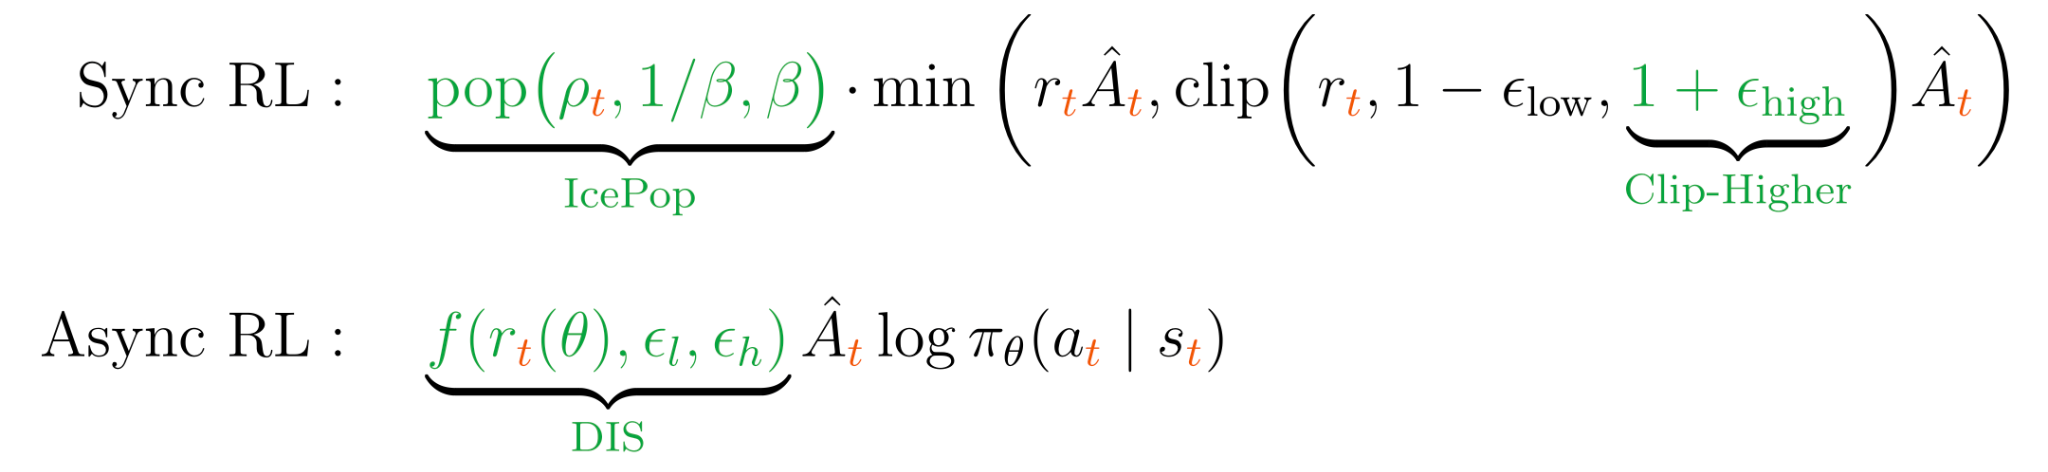
重要性采样(IS)比率比较每个采样动作在当前策略与行为策略下的概率,据此缩放该动作对训练目标的贡献。同步 RL 使用上一轮迭代的训练器策略作为行为策略,异步 RL 则使用推理策略。异步训练中,rollout 期间会发生多次策略更新,因此计算 IS 比率需要保留中间的每个 checkpoint 版本。但这会带来过高的内存与延迟开销,实际难以实现。Z.ai 因而选择使用推理策略,以提高效率、简化实现,代价是面临数值稳定性问题。
最后,比较 RL 训练、跨阶段蒸馏和长时程 RL 训练中优势值计算的主要差异。RL 训练采用 GRPO 标准的组内归一化优势值,跨阶段蒸馏则使用反向 KL 散度。
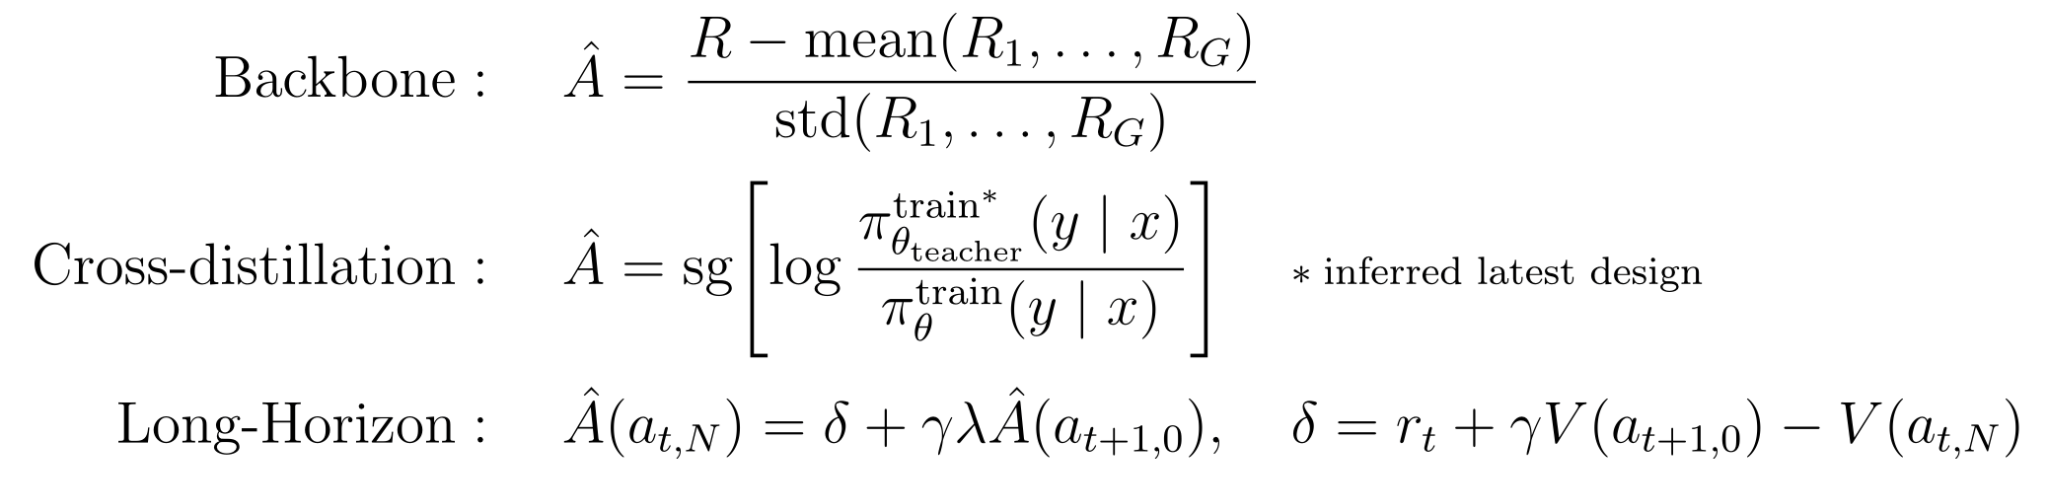
Single-Rollout Asynchronous Optimization
长时程任务会产生极长的轨迹。在 GRPO 中,轨迹长度的高方差会导致训练信号不稳定,并可能偏向更长的轨迹。更麻烦的是,RL rollout 工作负载对端到端延迟敏感,长时程任务会进一步放大慢速 rollout 的尾延迟。为缓解这一问题,Z.ai 在 GLM-5.2 的长时程 RL 训练中引入 Single-rollout Asynchronous Optimization(SAO)。受 Proximal Policy Optimization(PPO)启发,SAO 用修改后的 Generalized Advantage Estimation(GAE)替代组内归一化优势值。GAE 只需单次 rollout 即可计算优势值,不再需要对每个 prompt 进行多次 rollout,从而缓解 GRPO 的这一缺陷。
GAE 通过价值模型估计的价值计算而来;在 RL 中,价值指当前状态的预期回报。具体而言,价值模型以 rollout 为输入,为每个 token 给出价值估计。SAO 将 observation token(即工具调用结果)排除在优化之外,使 GAE 适用于智能体 RL。在此前的 GLM-5 中,跳过这些 token 即可;在 SAO 中,则需要修改优势值估计公式,绕过 observation token。关于 Bellman target 的直观解释和消融实验,可参阅 SAO 论文及其附录 A.1。
在 SAO 中,价值模型是与策略模型同步训练的独立 LLM。因此,训练初期较弱的价值模型可能导致优势值计算的方差较高。为此,SAO 提出了多种价值模型训练方法:
- Two Time-scale Update Rule:价值模型的更新频率为策略模型的两倍,即每次策略训练步骤中,同一批数据训练两次。
- Attention Parameter Freezing:冻结价值模型的全部注意力层,提高训练稳定性。
- Scaling Pre-training:扩大价值模型的预训练语料规模,用于初始化价值模型,使其在训练初期也能可靠估计价值。遗憾的是,Z.ai 没有披露预训练语料扩展的具体规模。
SAO 以额外计算开销和翻倍的内存占用为代价,用价值模型替代组采样,缓解 GRPO 的延迟问题。
后训练基础设施
Z.ai 在整个 GLM-5 系列中使用 slime 作为后训练基础设施。slime 是最好的开源 RL 训练框架之一。其设计和功能可参阅 slime GitHub 仓库,这里重点介绍两个功能。
RL rollout 的性能特征高度依赖任务,每个任务也有不同的工具与奖励函数。为提高系统效率,Z.ai 设计了基于服务器的多任务 rollout 编排器。每个任务以独立微服务运行,控制自己的 rollout 和奖励逻辑;编排器通过调节各任务的 rollout 比例与生成速度,平衡整体性能。集中管理还支持动态调整任务比例、细粒度进度监控等功能。Z.ai 称,该编排器在训练 GLM-5 时支持 1000 个并发 rollout。
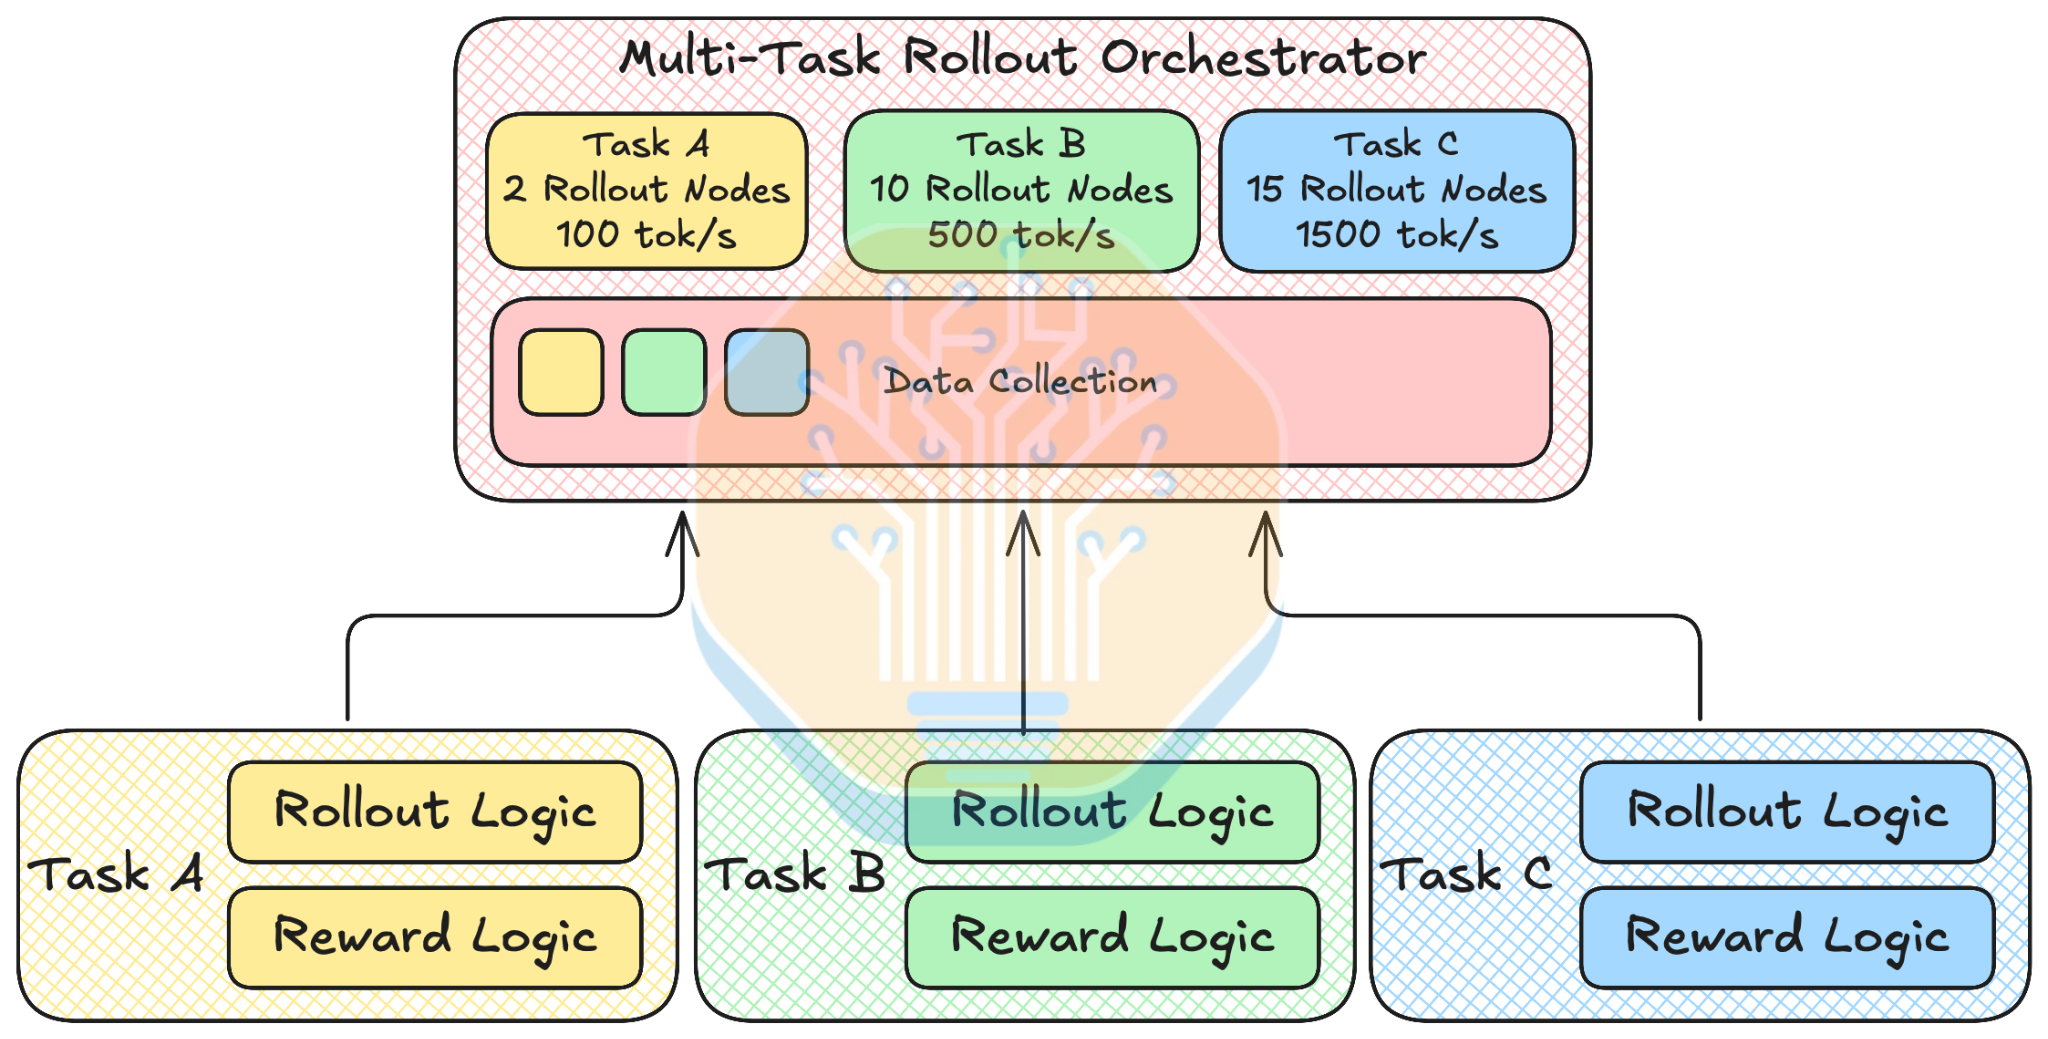
在 GLM-5.3 发布公告中,Z.ai 称除了主机内存,还使用本地存储作为缓存层,实现 MOPD 教师模型的动态切换与预取。slime PR#1538 引入 TensorBackuper 类,将教师权重保存为固定在 CPU 内存中的 PyTorch tensor,实现教师切换。当 rollout 被路由到某个教师时,TensorBackuper 对象将该教师模型复制回 GPU 内存,执行前向计算(实现见此处)。但这仍是基于 CPU 内存的权重交换,我们尚未看到基于本地存储的实现。
付费部分将分析 GLM-5.3 的网络安全能力。
本文由英文原文翻译而来,如有歧义以英文版为准。所有文章版权归 © SemiAnalysis 所有,保留所有权利。覆盖应用源代码的 AGPL-3.0 许可证不适用于文章内容。