本文最初于 2026 年 11 月 5 日发表于 SemiAnalysis newsletter,作者为 Bryan Shan、Alec Ibarra、Cam Quilici、Kimbo Chen、Wenyao Gao、Dylan Patel 和 Myron Xie。
本次转载保留原文公开可读的部分及其历史对比。文中的判断、成本假设、预测和预览状态均属于原始发表时的内容,不是新一轮基准测试结果。订阅者专享的后续内容请阅读原文。
2025 年 11 月,我们曾发文指出 Google 正在向外部客户出售 TPU。此后,Oracle、OpenAI、Anthropic 和 Meta 相继成为 TPU 客户,一次次印证了我们的判断,也与 Accelerator Model 的报告一致。
硬件需求只是一部分,NVIDIA 的护城河历来还在于软件和庞大的开发者生态。TPU 也正在这方面取得进展,与整个生态的上游维护者合作,包括 Meta PyTorch 团队、vLLM(Inferact、RedHat)、SGLang(RadixArk)、llm-d、Ray 等。读过我们 2026 年 9 月那篇介绍 Google TPU 对外开放战略的文章,就不会对此感到意外。
在 9 月的文章中,我们公布了 InferenceX 上首批第三方 TPUv7 单轮负载结果。在 Qwen 3.5 397B 的同条件 FP8 对比中,TPUv7 Ironwood 的每美元性能最高比 B200 和 B300 高 50%。
我们当时还提到,许多 Google TPU 客户在要求 AgentX 结果,因为推理支出正在转向长上下文、多轮智能体服务。
此前,Jensen 在 Dwarkesh Podcast 上说,其他芯片都没有利用好在 InferenceX 上展示性能的机会。
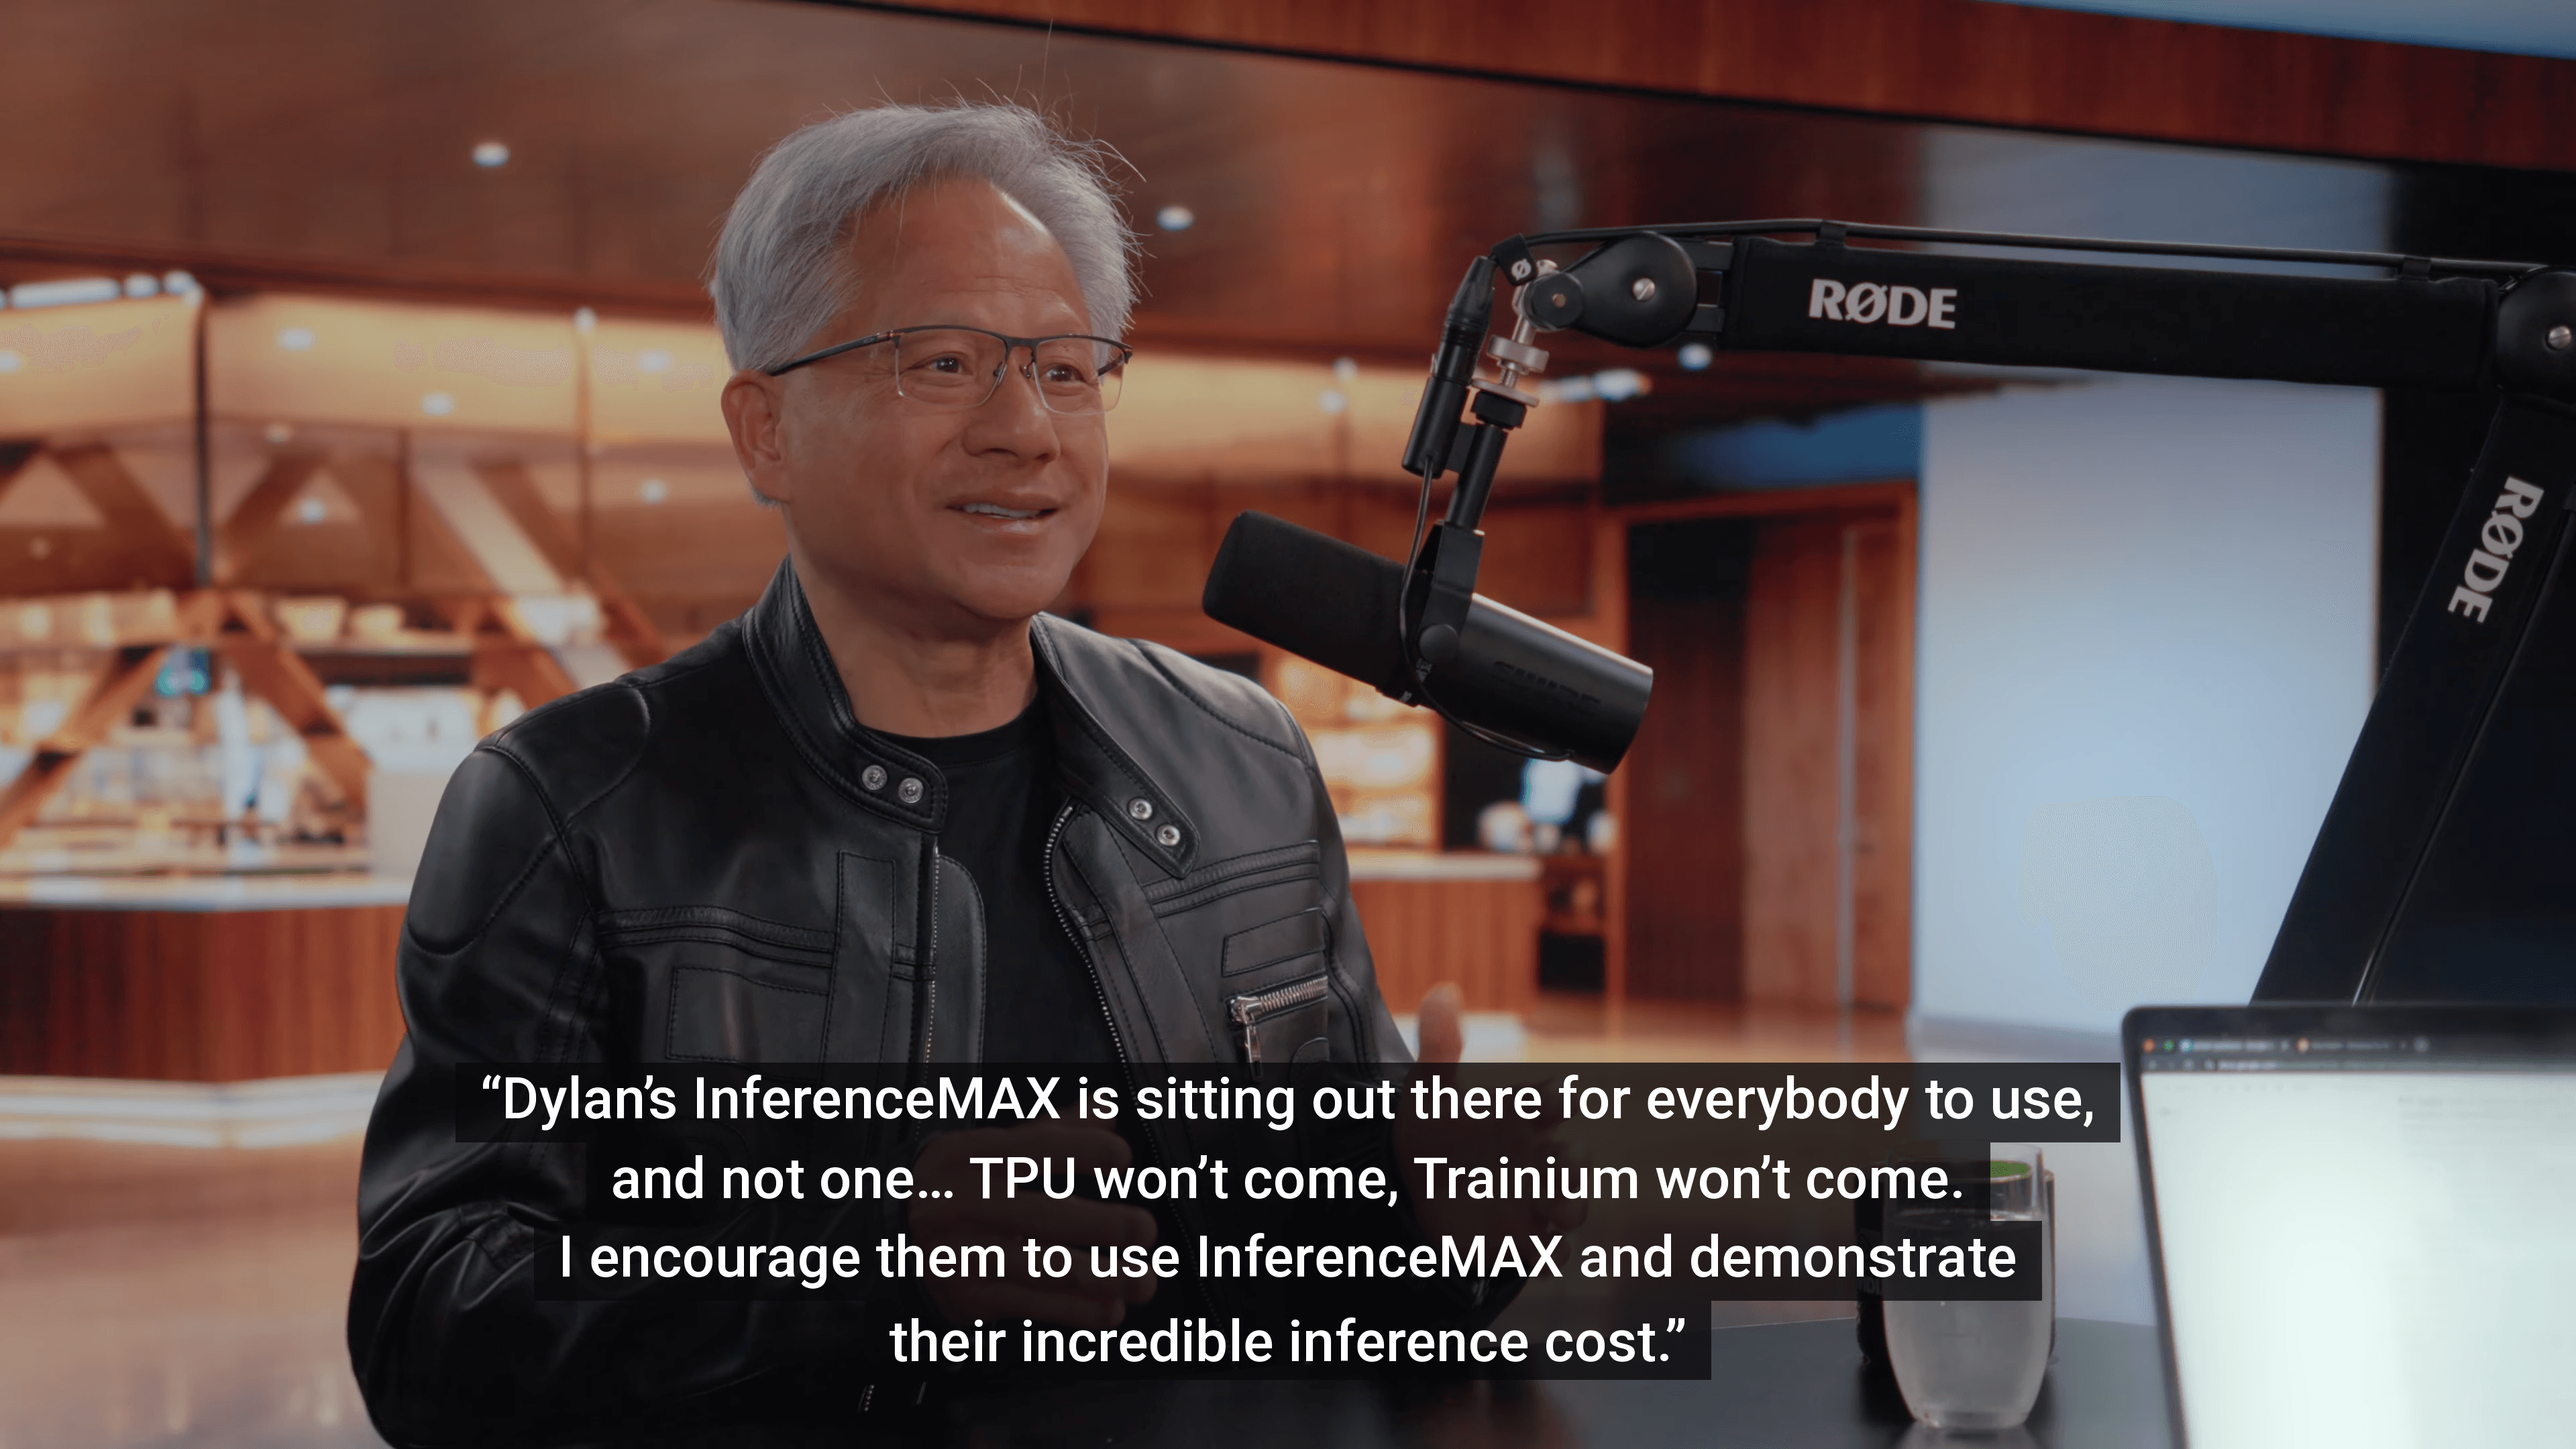
六个月后,Google 确实充分抓住了这个机会。
今天,我们发布 TPUv7 在四个模型上的首批官方长上下文、多轮、真实智能体推理基准测试结果。结果表明,按外部客户的成本口径计算,TPUv7 的每美元性能具有竞争力,或已达到当前最佳水平:
- Muse Spark Open SGLang AgentX(NVFP4 权重): 尽管模型架构是与 GPU 协同设计的,TPU 的每美元性能仍有竞争力。提交来自开源生态开发者 RadixArk,即 SGLang 的开发团队。
- GLM-5.2 vLLM AgentX(FP8): TPUv7 是成本最低的 FP8 选项。在 60 至 300 tok/s/user 范围内,每美元 token 数是 B200、B300 和 MI355X 的 1.2x 至 2.7x。NVIDIA NVFP4 仍胜过 TPUv7 FP8,但存在准确率或质量损失。
- Qwen3.5 vLLM AgentX(FP8): 使用 llm-d 分离式服务后,TPUv7 在所有交互速度下都胜过 GB300 FP8,甚至在保留更高质量与准确率的同时,追平 GB300 FP4。
- Kimi K3 vLLM AgentX(MXFP4 权重): 发布时就能与 GB300 NVL72 竞争;TPUv7 的每美元 token 数是 GB200、B200、B300 和 MI355X 的 1.15x 至 2.5x。提交来自 vLLM 开源生态开发者 Inferact。
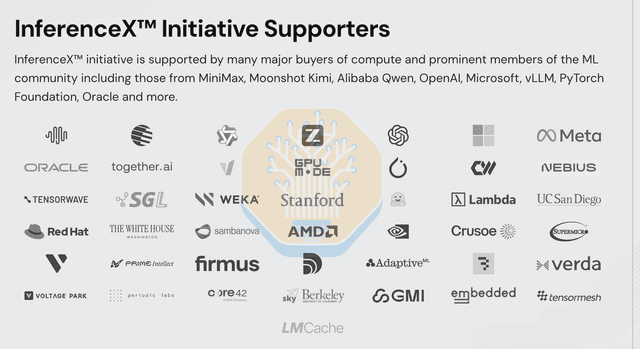
测试使用 InferenceX/AgentX。这个行业标准推理基准测试得到了几乎所有主要算力买家的支持,包括 Microsoft Azure、Oracle、Meta 等。同时,它还得到 vLLM、LMCache、SGLang、PyTorch、Huggingface 等 ML 社区,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等主要实验室的支持。
Google 的潜在和现有 TPU 客户都在向 Google 索取 AgentX 结果,因为 AgentX 十分贴近他们的实际推理负载。关于 TPUv8i、TPUv8t、TPUv9、TPUv10 的 SemiAnalysis 供应链出货估计,请参阅 Accelerator Model 中逐季度的完整拆分。
如果觉得开源基准测试和数据有用,请给 InferenceX GitHub 仓库点 Star! InferenceX 是全球唯一同时覆盖 TPUv7、OpenAI Jalapeño、Nvidia Rubin NVL72、AMD,并即将加入 SambaNova 和 Trainium2/3 的推理基准测试。
给 Jensen 的建议
NVIDIA 只会在部分模型或场景中偶尔输给 AMD,但 TPU 能提供更高或具有竞争力的每美元性能,是 NVIDIA 高层不愿接受的新局面。TPU 首次提交 Qwen3.5 397B FP8 的 AgentX 结果,表明 TPUv7 FP8 甚至能胜过 GB300 NVL72 FP4。此后,NVIDIA 立即安排工程师突击队和智能体集群按 997 节奏工作,美国和中国大陆团队加班到当地凌晨 2 点,周末也不停。遗憾的是,对 NVIDIA 而言,首轮 GB300 FP4 反击提交按外部客户成本计算,在曲线大部分区域的每美元表现仍比 TPUv7 FP8 差 1.64x。 我们认为,如果投入足够多的智能体,GB300 NVL72 FP4 可能重新取得相对 TPUv7 FP8 的小幅性能领先。但在 NVIDIA FP8 与 TPUv7 FP8 的对比中,我们认为 NVIDIA 不可能在某些模型上重新拿回 SOTA。
我们经常从 PyTorch 开源维护者和 NVIDIA 客户那里听到对官僚流程的抱怨。例如,为支持某项 PyTorch CudaGraph capture 功能而给 NVIDIA 驱动增加一个功能,这样简单的事情也能卡在“内部 NVIDIA 法务审核”中三个月。让律师阻碍技术性驱动功能并不合理。我们推动 NVIDIA 改善 ConnectX、NVSwitch、HGX Board(Vulcan、Umbriel)的 DCGM 功耗遥测时也遇到过类似问题:往往连何时能给出时间表,都要先等一个时间表。相比之下,具有创业公司心态的 AMD,在 Anush、Ramine、Vamsi、Lisa 的带领下,可以迅速开发这些功能。
NVIDIA 需要在文化上大幅削减官僚流程。这是 Jensen 必须解决的 NVIDIA 护城河面临的最大风险之一。根据我们和许多客户的经验,Nvidia 对外部建议、git commit 和反馈的响应,现在比 AMD、Google 和 Amazon 更慢。
不过,NVIDIA 也有团队正在突破这些流程,例如原 CentML 的 NVIDIA vLLM 团队。AMD 和 TPU 率先为流行的开源生产推理引擎加入创新的 Megakernel decode 支持。一周之内,NVIDIA 团队就迅速加入并合并了 Megakernel 支持,为 NVIDIA 守住阵地;该 PR 由 AMD 的 vLLM 维护者批准。
TPU 正在生态中取得明显进展,Meta 的 Muse Spark Open 和 Kimi K3.1 Pro 都已获得 TPU 的 Day 0 支持。Google 正在采用 NVIDIA 曾经的做法:向开源维护者提供大量芯片。相比之下,NVIDIA 向社区维护者提供集群,越来越像 DMV 式的官僚流程,资源投入也相当吝啬。对于一家价值 5 万亿美元的公司,我们原本期待 NVIDIA 能更慷慨地支持那些免费改进 NVIDIA 软件栈的开源开发者。希望 Jensen 能消除这些拖慢进展的流程。
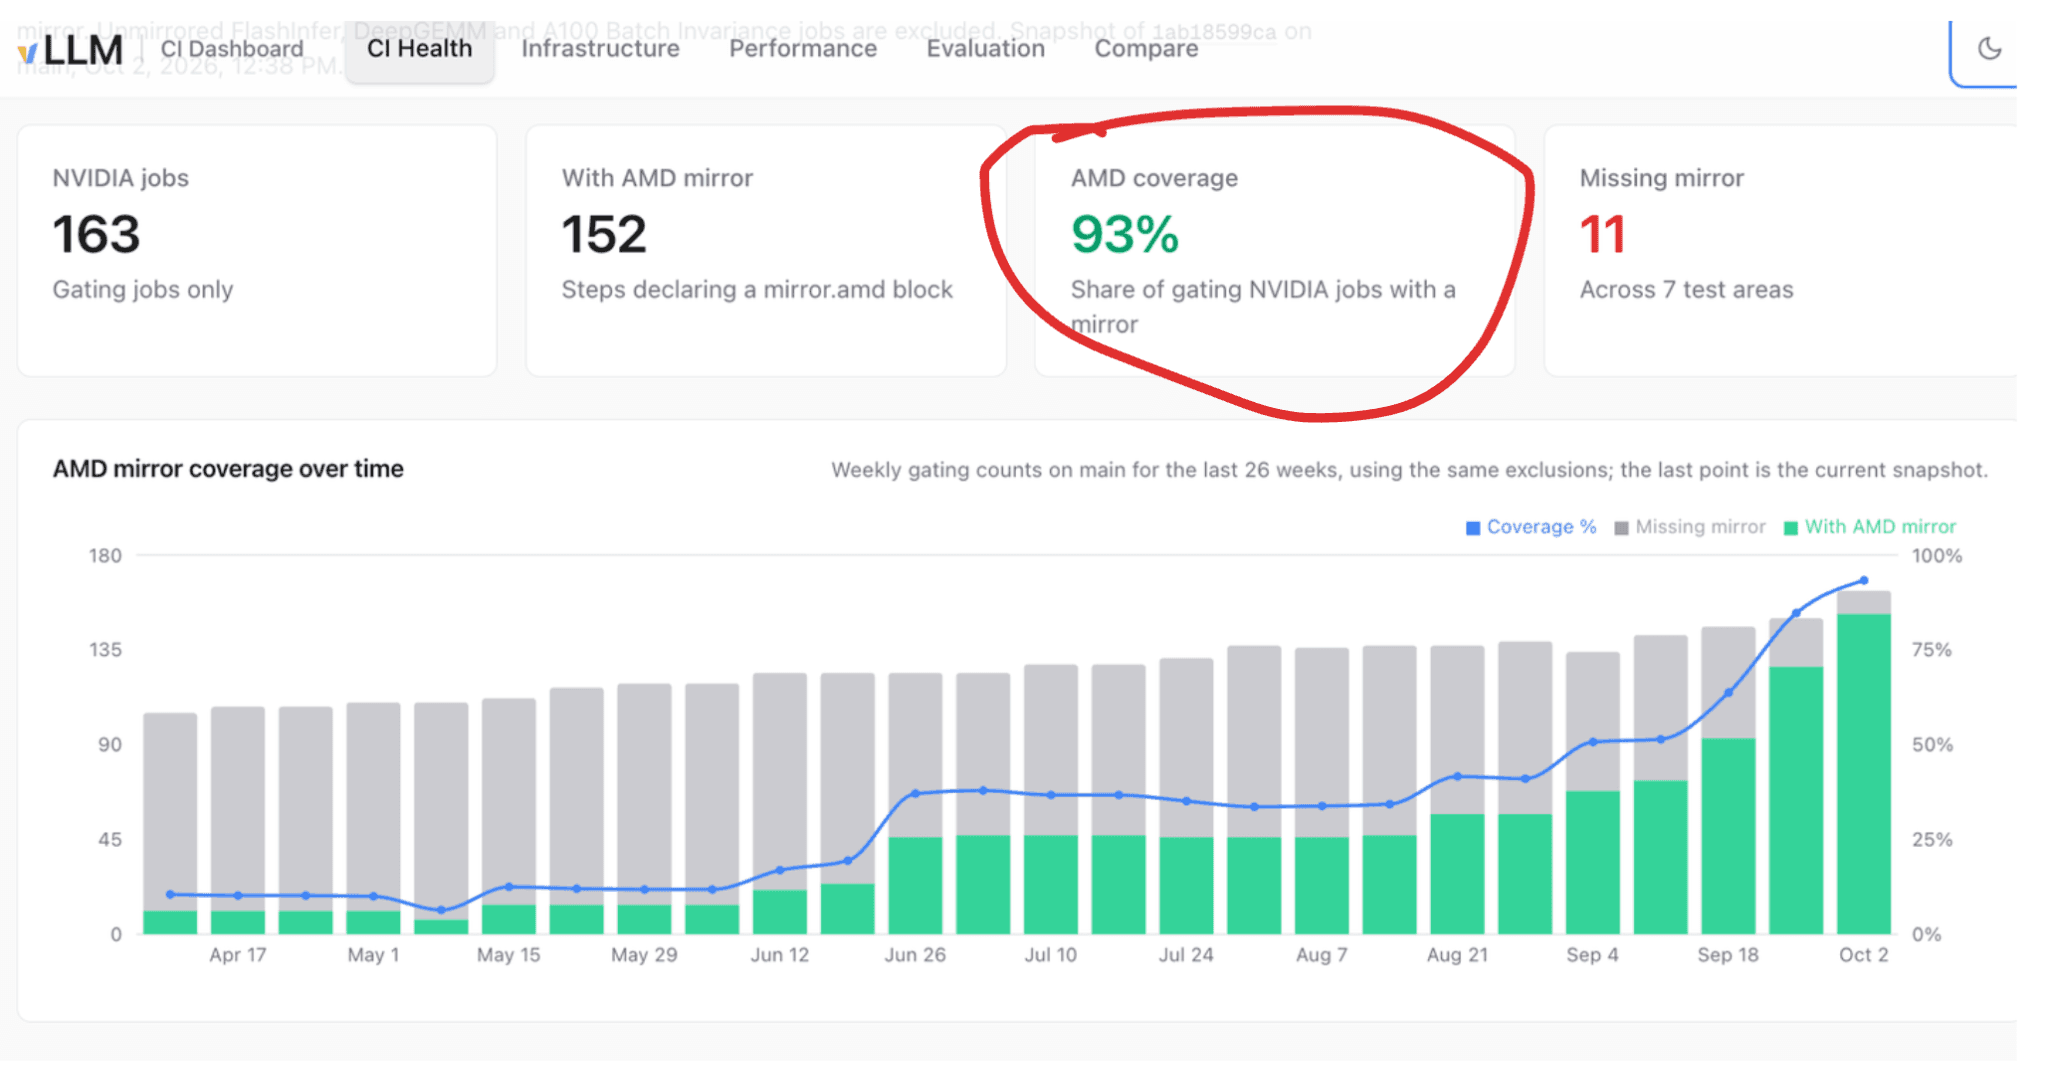
相比之下,AMD 越来越愿意投入资源,向上游 vLLM、TileRT、SGLang、Tokenspeed 等项目维护者开放大量集群,并在尽量减少官僚流程的情况下快速扩充 CI 资源。
Meta Muse Spark Open FP4 816B 在 SGLang TorchTPU 上的智能体推理性能
Meta 是 TPU 的早期采用者之一,已经通过 SGLang-TorchTPU 在生产环境中部署 TPUv7。
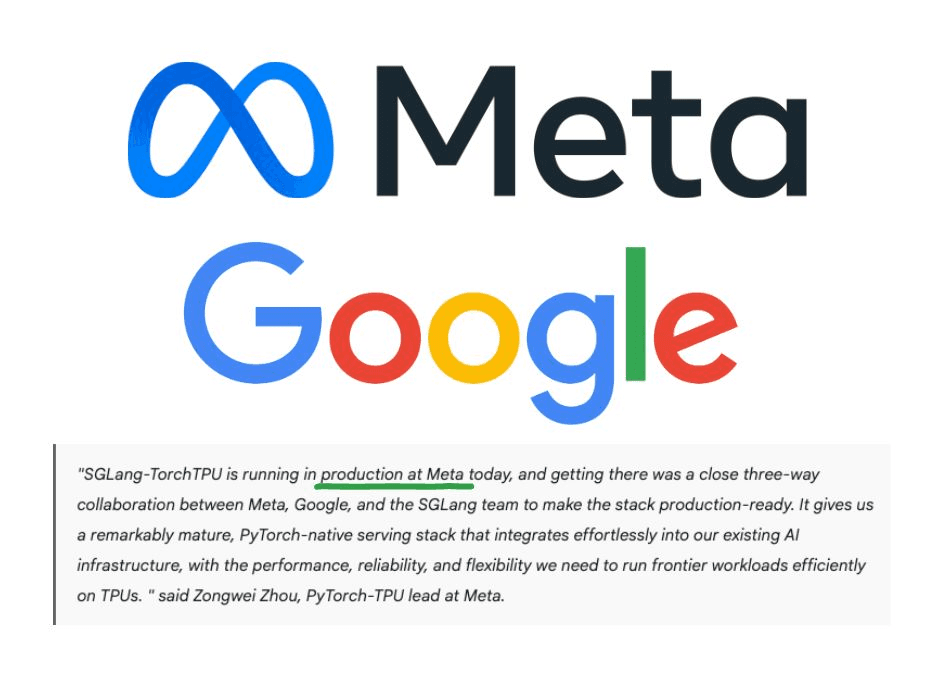
Muse Spark Open 是 Meta 最新的 816B 参数开放模型,也是 SGLang-TorchTPU 的首批支持模型之一。社区开发者、SGLang 主要维护团队 RadixArk 的提交显示,在 InferenceX 智能体推理负载下,即使采用 Meta 购买 TPU 时支付的成本口径,TPUv7 的 decode 每美元性能仍有竞争力。Meta 在生产推理中使用 SGLang 提供 LLM 服务,使用 vLLM 生成 RL 训练 rollout。从端到端延迟来看,TPUv7 仍需继续优化 prefill kernel 等部分才能具有竞争力。Decode kernel 方面,TPUv7 SGLang 使用完全融合的 megakernel,消除了 kernel launch 延迟。此外,该提交在高并发下通过 Google 开源的 TPU 原生 TPU-Sync 库,使用 SGLang HiCache 将缓存 offload 到 CPU DRAM,以提高前缀缓存命中率。
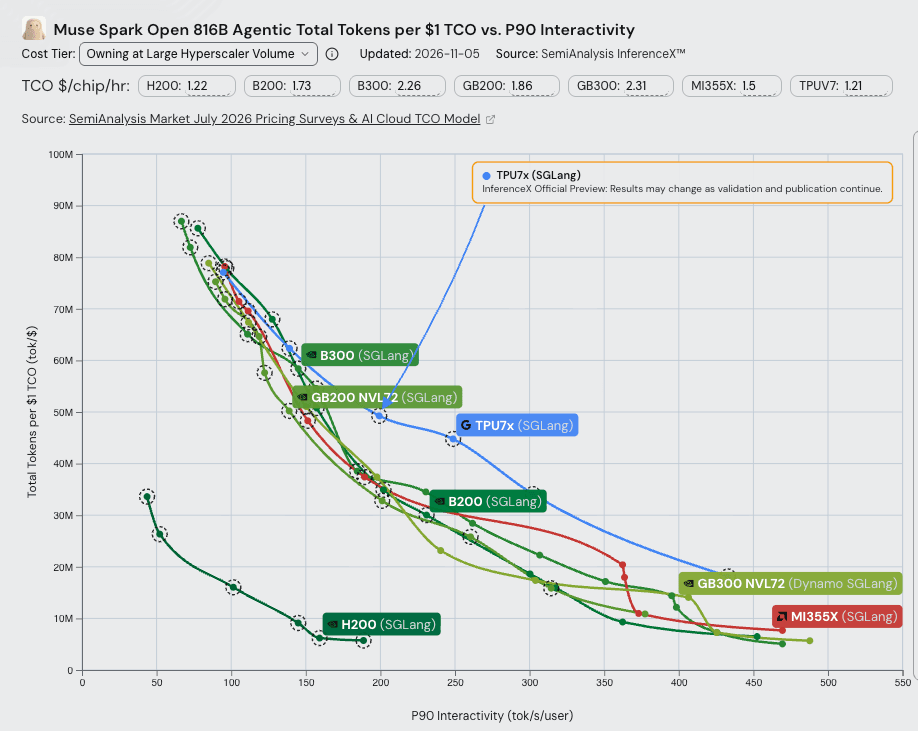
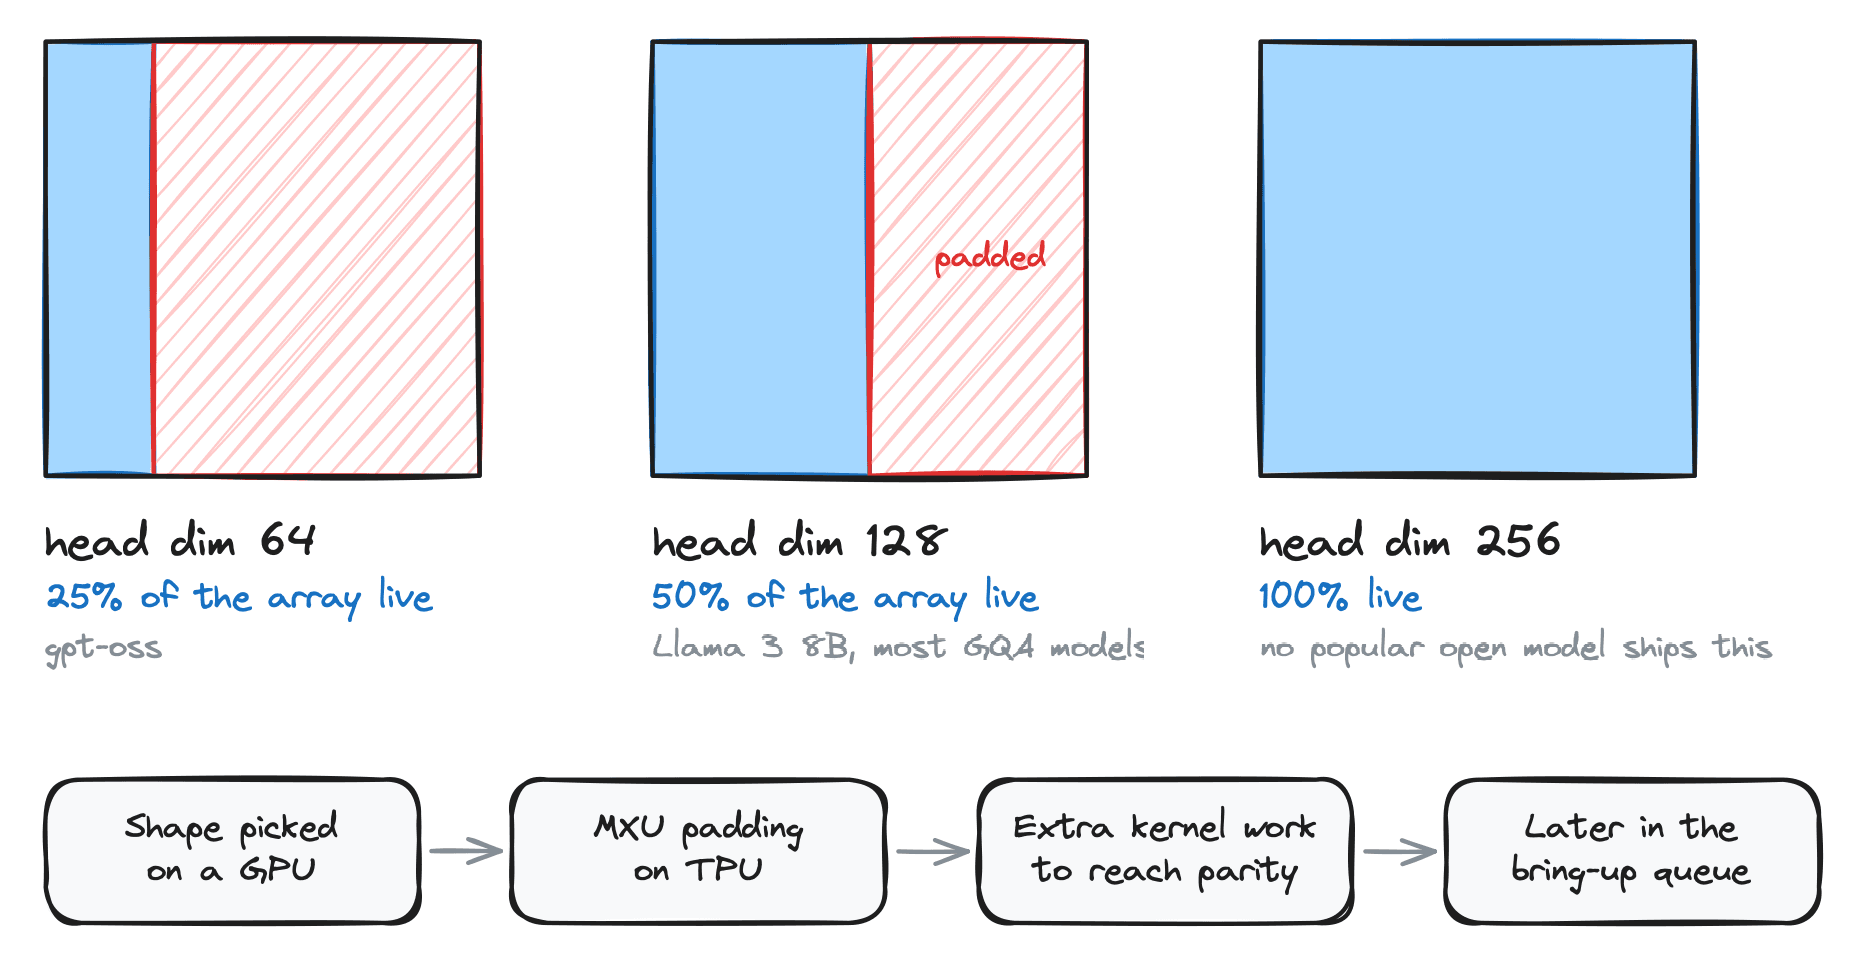
需要注意,Muse Spark Open 是一个高度针对 GPU 优化的模型,理论上并不适合 TPU。这是因为它的 head dim 为 64,这意味着在长上下文注意力中,systolic 阵列有 25% 被 padding 占据。
转载编者注:上段保留原文措辞。配套的原始示意图却将 head dim 64 标为“25% of the array live”,即 25% 的阵列参与有效计算,而不是 25% 被 padding 占据。这处原始材料内部的不一致,不应被当作整模型利用率的实测数据。
相比之下,GPU 矩阵核心使用较小的 tile,因此不同的 head dimension、专家宽度和切分后的 KV head 数,都能接近峰值。Head dimension 从 128 降至 64,在 H100 或 B200 上几乎没有额外代价,还能降低注意力层的开销。GPU 架构让研究者可以优先考虑评估表现,而不损失推理性能。
TPU 在一个对自身极不友好的模型上仍然取得有竞争力的性能,这很有意思。拥有大量 TPU 算力的实验室,例如 Anthropic、Google Deepmind,以及即将加入的 OpenAI,通常会协同设计模型,让注意力形状适配 TPU,避免这个问题。
当 TPU 遇到 attention head_dim=256 的模型架构时,就像开上兰博基尼一样全速前进。
祝贺 RadixArk 团队取得这一成绩!他们正在更新文档,让所有人都能使用这套优化后的 SGLang Muse Spark Open TPU 配置。我们期待 RadixArk 很快提交更多 AgentX 结果,证明其 SGLang-TorchTPU 软件栈已具备生产就绪能力。
GLM5.2 / 5.3 vLLM AgentX FP8 智能体推理性能
GLM-5.2/5.3 是前沿开放模型,采用 MoE Transformer,共有 744B 参数,每个 token 大约激活 39B。模型通过 DeepSeek Sparse Attention(DSA)支持 1M-token 上下文:轻量 indexer 对此前 token 打分,每个 query 只对选中的 2,048 个 token 执行完整注意力。
在 FP8 下,TPUv7 是运行 GLM-5.2 AgentX 成本最低的方式。在 60 至 300 tok/s/user 范围内,每美元 token 数是 FP8 B200、B300 和 MI355X 的 1.2x 至 2.7x;在 150 tok/s/user 时,则为 H200 的 4.4x。
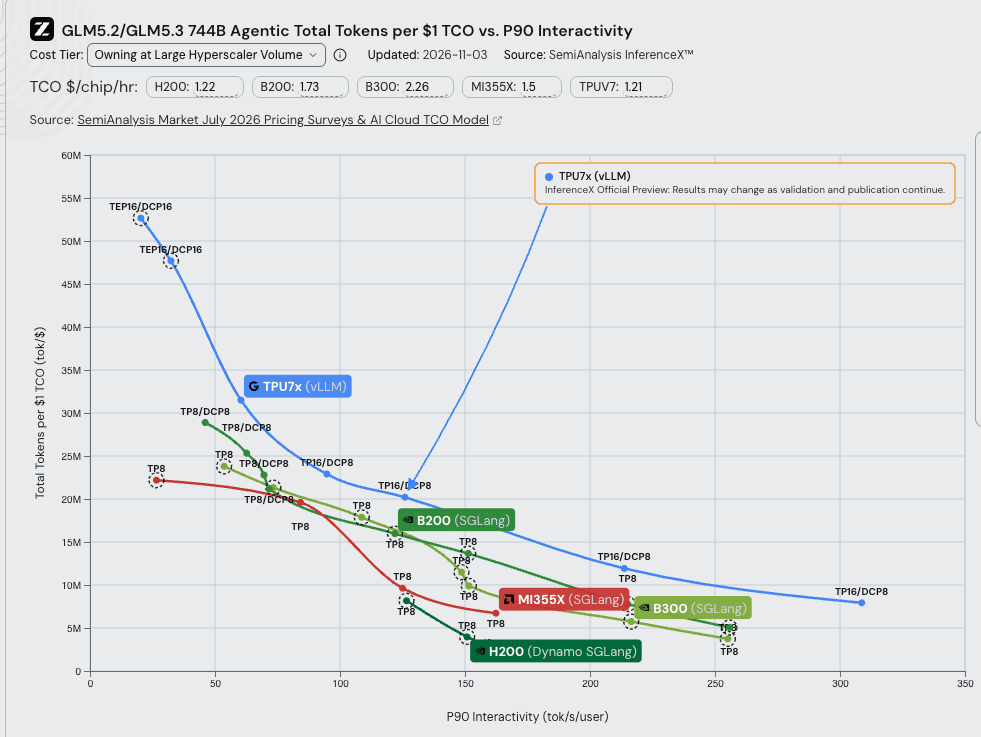
FP4 GPU 的每美元性能仍然领先
由于 GLM-5.3 原生训练时没有使用 block scale FP4 的 QAT,FP4 相比 FP8 有轻微准确率下降。大多数速度下,FP4 GPU 的每美元 token 数仍然更高,因为 TPUv7 没有原生 FP4 支持;按照我们的 Accelerator & HBM Model,需要等到 Q1 2027 的 TPUv8 才会支持 FP4。在 100 tok/s/user 时,GB300 和 GB200 FP4 的每美元 token 数分别是 TPUv7 的 3.6x 和 3.5x。FP4 将每个权重的字节数减半,而小 batch decode 受内存带宽限制。
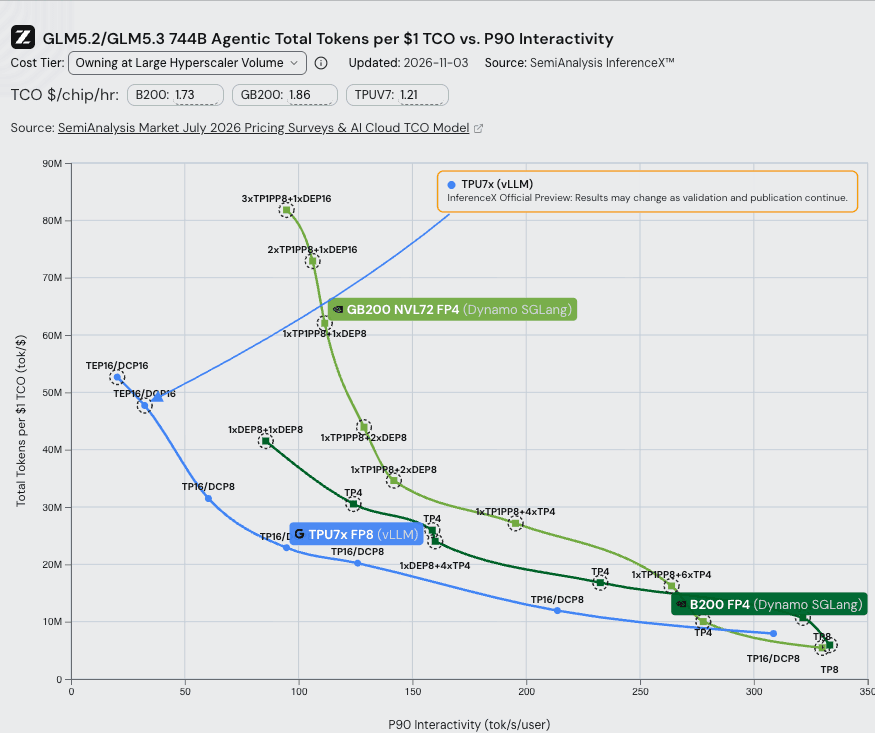
SemiAnalysis AI Cloud & TCO Model 对各种加速器价格提供完整拆分,覆盖 InferenceX 当前的所有加速器及更多产品,包括未来的 Nvidia Rubin Ultra 和 Feynman、AMD MI400 至 MI700、Google TPU v8 至 v12,以及 AWS Trainium3 至 Trainium6。
GLM-5.3 优化
GLM-5.3 AgentX 的上下文达到 1M token,每个请求超过 90% 的内容已在缓存中,因此 KV cache 容量决定了能容纳多少用户。主要有四项改动:
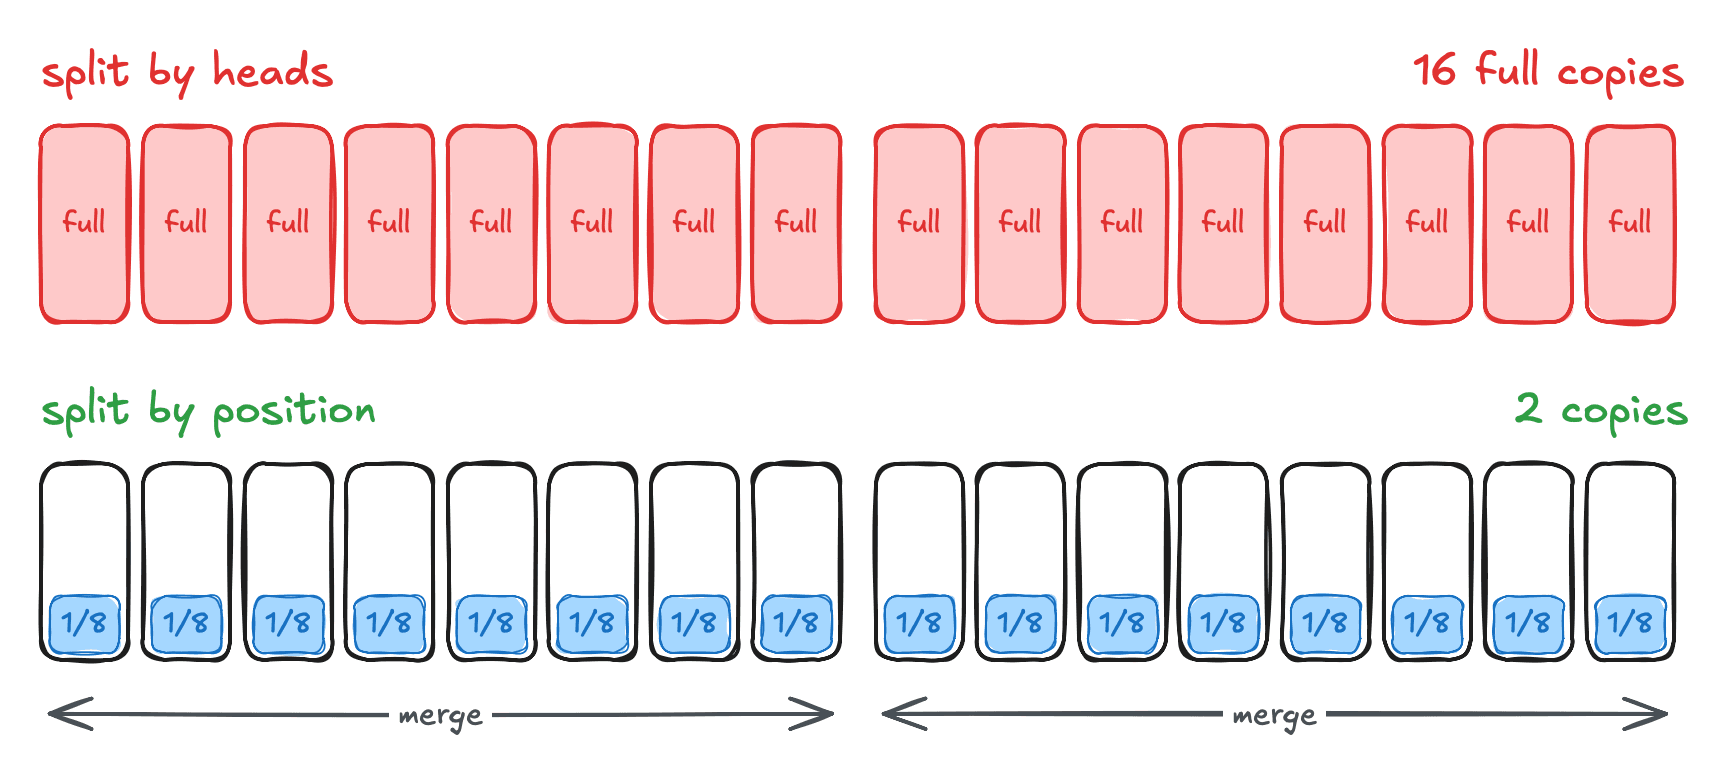
- GLM-5.3 注意力为每个 token 读取一条共享的压缩 KV 记录。如果按注意力头在设备间切分,每个设备都会复制完整缓存。Decode context parallelism(DCP)改为按序列位置切分,再在每层合并局部注意力结果。
- 每个 query 只读取 indexer 选中的 2,048 条缓存记录。TPUv7 的 SparseCore 专为分散访存设计,负责选取并 gather 这些记录,同时 TensorCore 进行注意力计算。
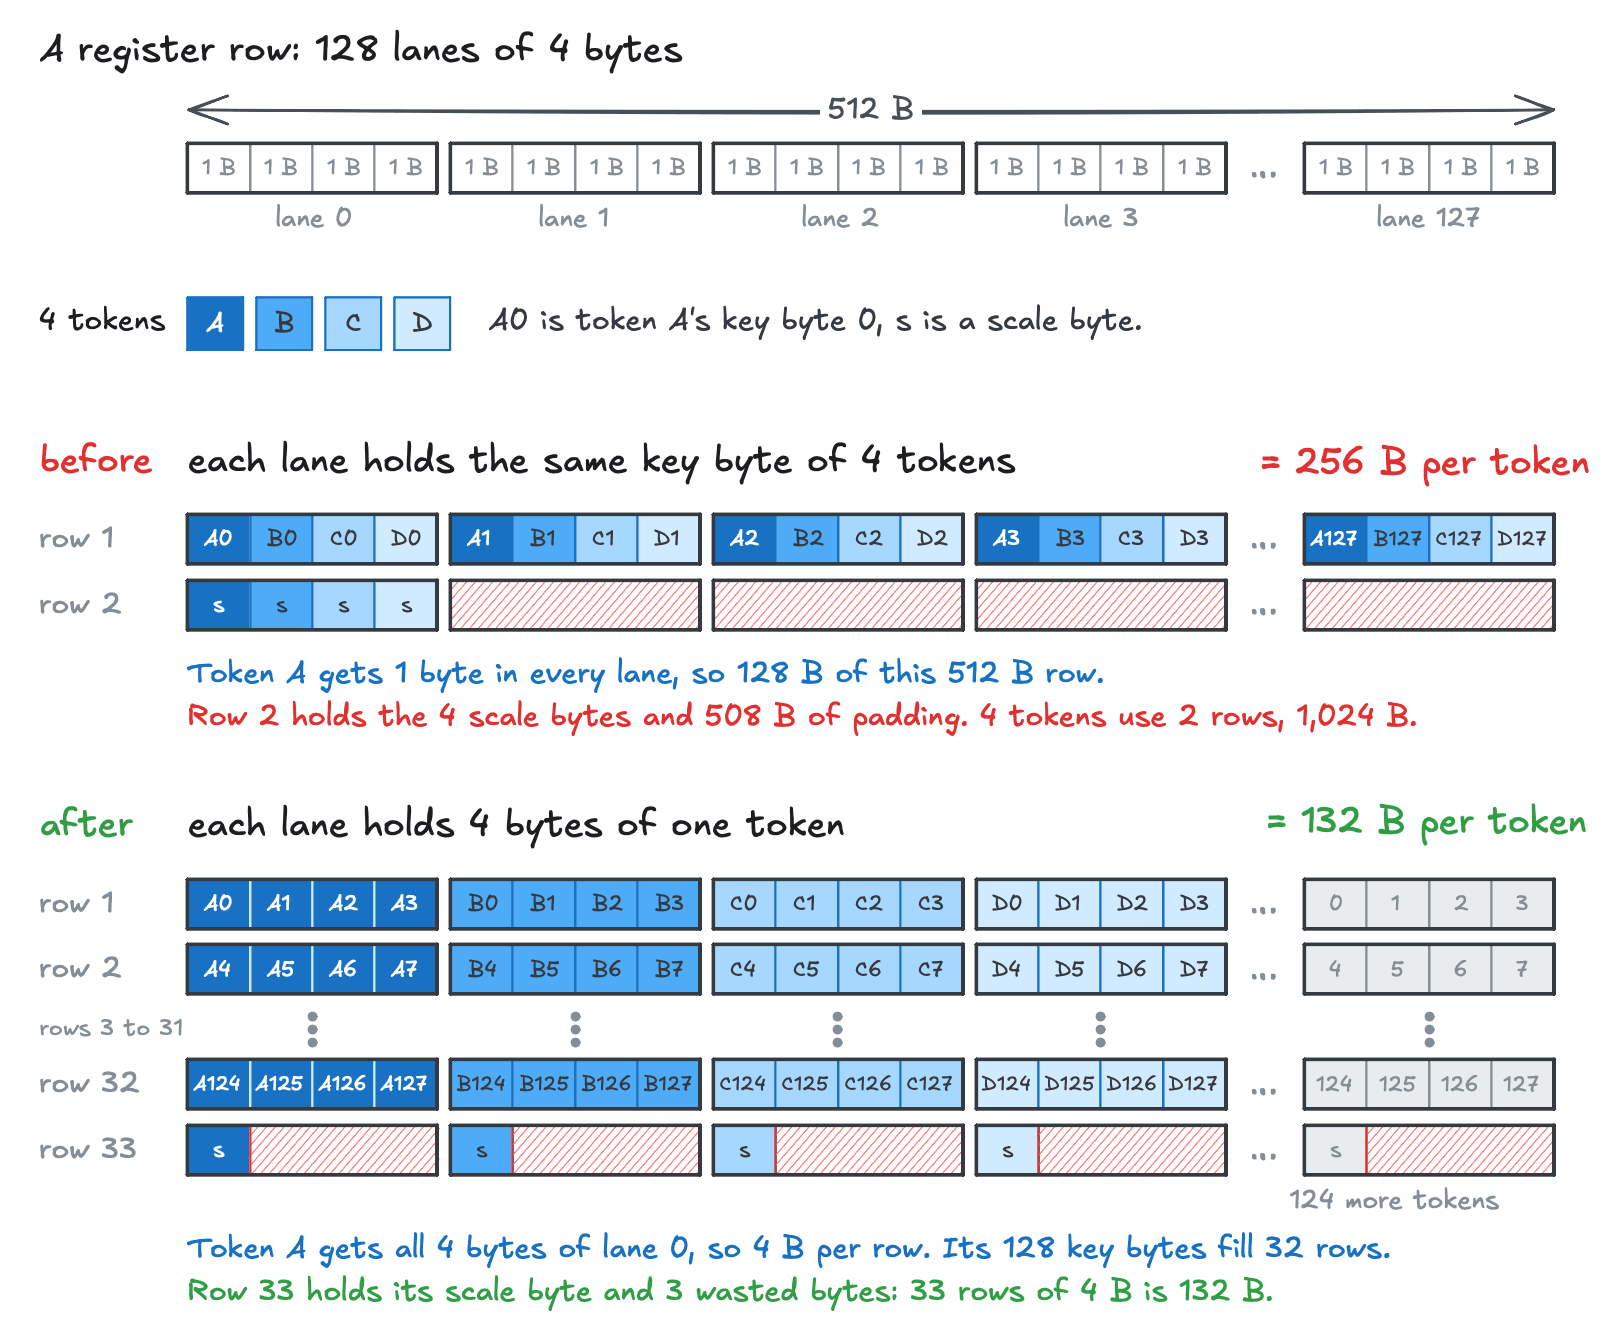
- TPUv7 的寄存器为 8 行、每行 128 lane,数据打包时可能产生碎片。Indexer 的 128 字节 key 加上 1 字节 scale,共 129 字节,比 128 宽的一行多出 1 字节,旧布局因此补齐到 256。新布局将方向转过来:token 沿每行排列,每个 token 的 key 沿纵向占 32 个四字节行,再增加一行存 scale。这样共占 132 字节,仅浪费 3 字节。
- 一个融合 kernel 执行路由;专家、all-reduce 和注意力归并被合为一次集合通信。TPU 程序按固定形状编译,因此 Google 为较小的 decode 步骤新增 4-token 和 8-token 形状,这些步骤此前会被 padding 到 16。
Qwen3.5 397B AgentX
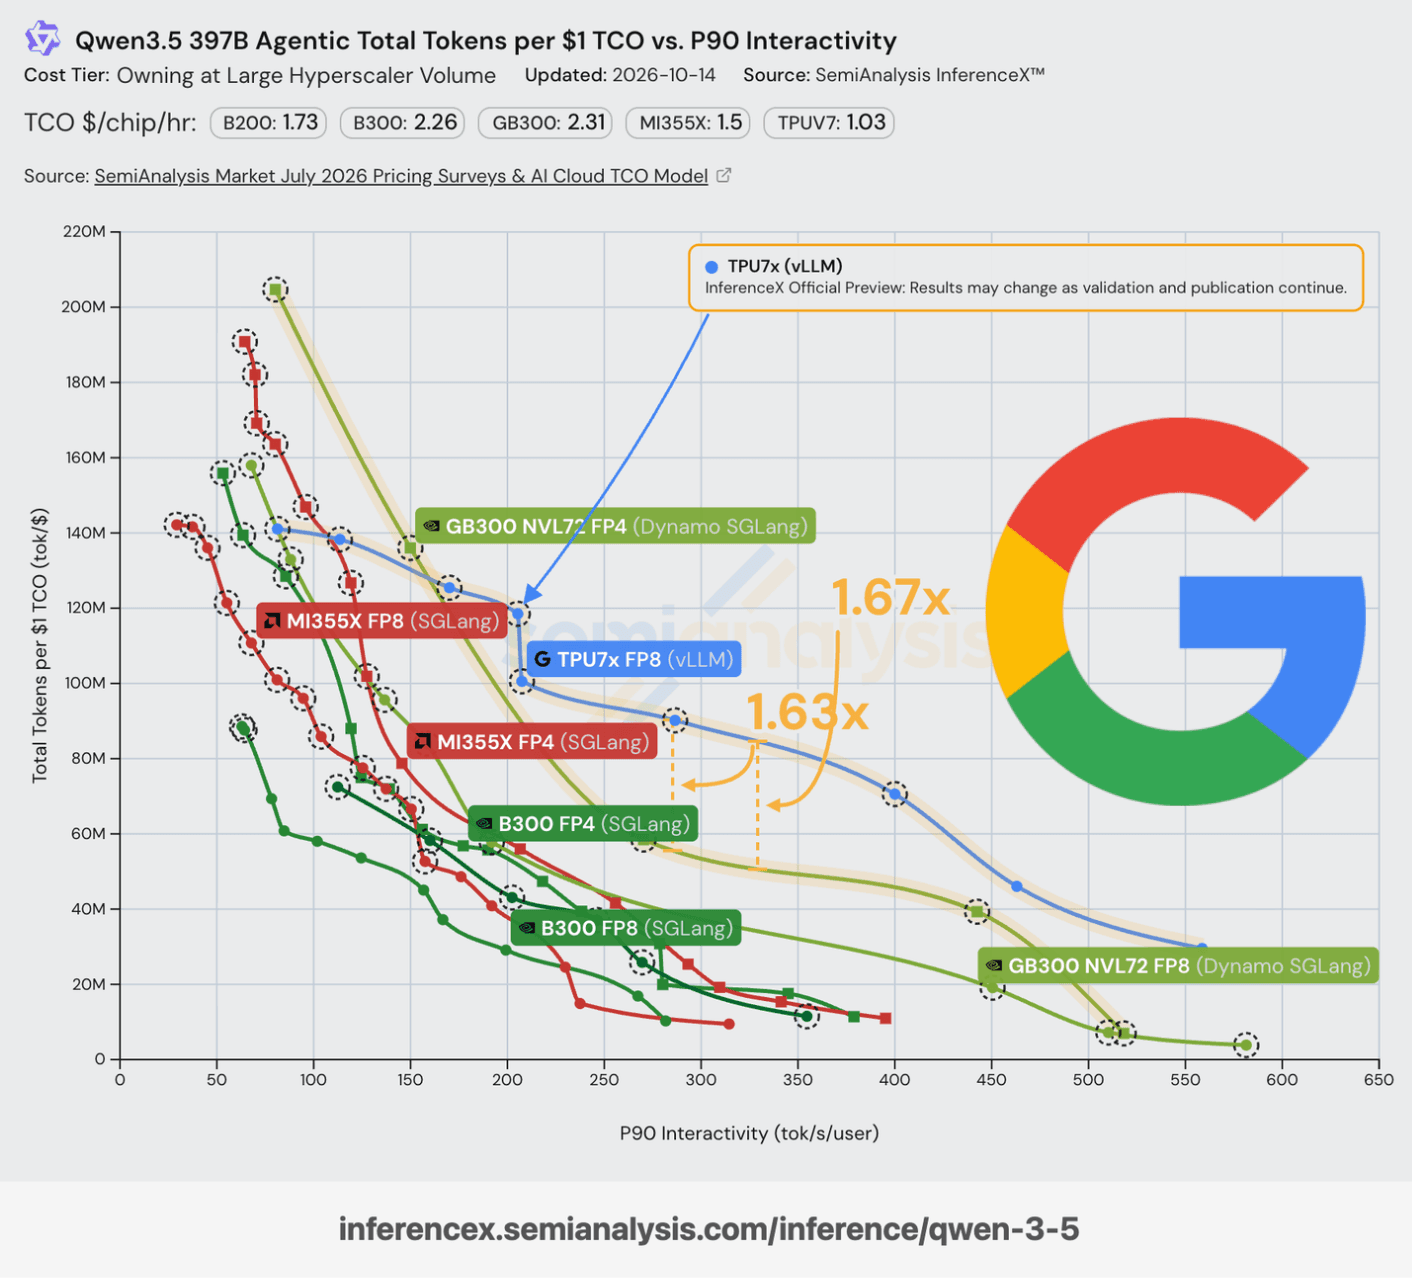
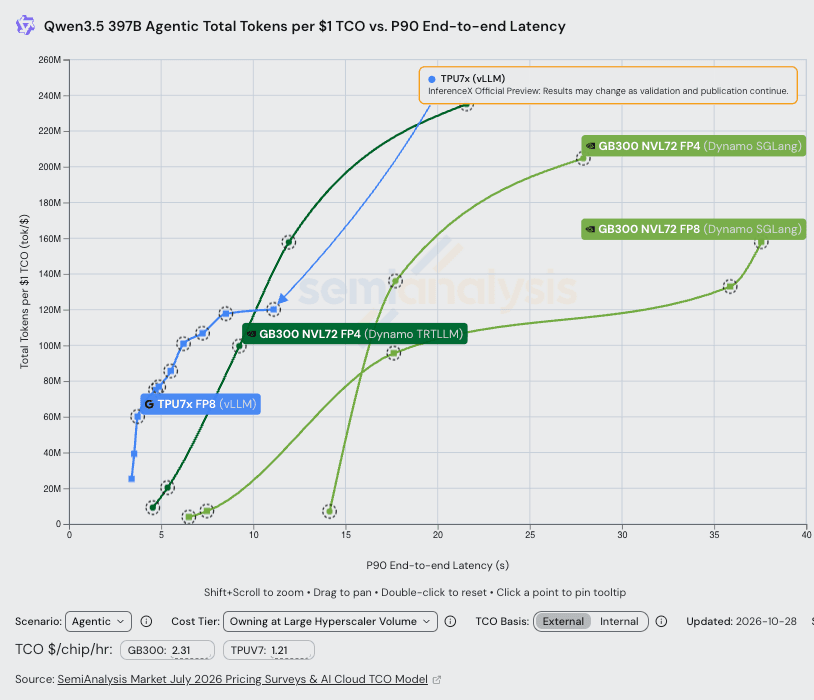
两周前,Qwen3.5 397B 成为 Google 首个向 AgentX 提交的模型。其 TPUv7 FP8 vLLM 结果表明,在我们的智能体推理基准测试上,每美元性能甚至是 FP4 GB300 NVL72 的 1.67x。
NVIDIA 可能试图声称不在意 Qwen3.5 397B,但我们分析上游 InferenceX 提交分析数据湖后发现,在某些 NVIDIA GPU SKU 上,超过 20% 的 sweep GPU 小时都花在了 Qwen3.5 上,因此这种说法很难成立。此外,负责 Qwen3.5 的 NVIDIA 工程师包括中国大陆和美国的一些顶尖 10x 推理性能工程师。显然,NVIDIA 很重视这个模型的优化。
某些大型 hyperscaler 和 AI 实验室还会使用 Qwen3.5 397B,以及基于其架构扩展到数万亿参数的版本作为代理模型,用于硬件采购和容量规划。因此,这对某些 token 工厂是一个非常重要的模型。
对于需要做采购决策的读者,我们的 AI Cloud & TCO Model 将分析扩展到集群经济性,包括现金流、投资回报和加速器残值。
AgentX 覆盖智能体负载的四个要素:
- 多轮:一个会话包含几十到几百次用户与助手交互,而聊天机器人场景通常只有少数几次。
- 长上下文:system prompt、工具定义和大量轮次让上下文快速累积。
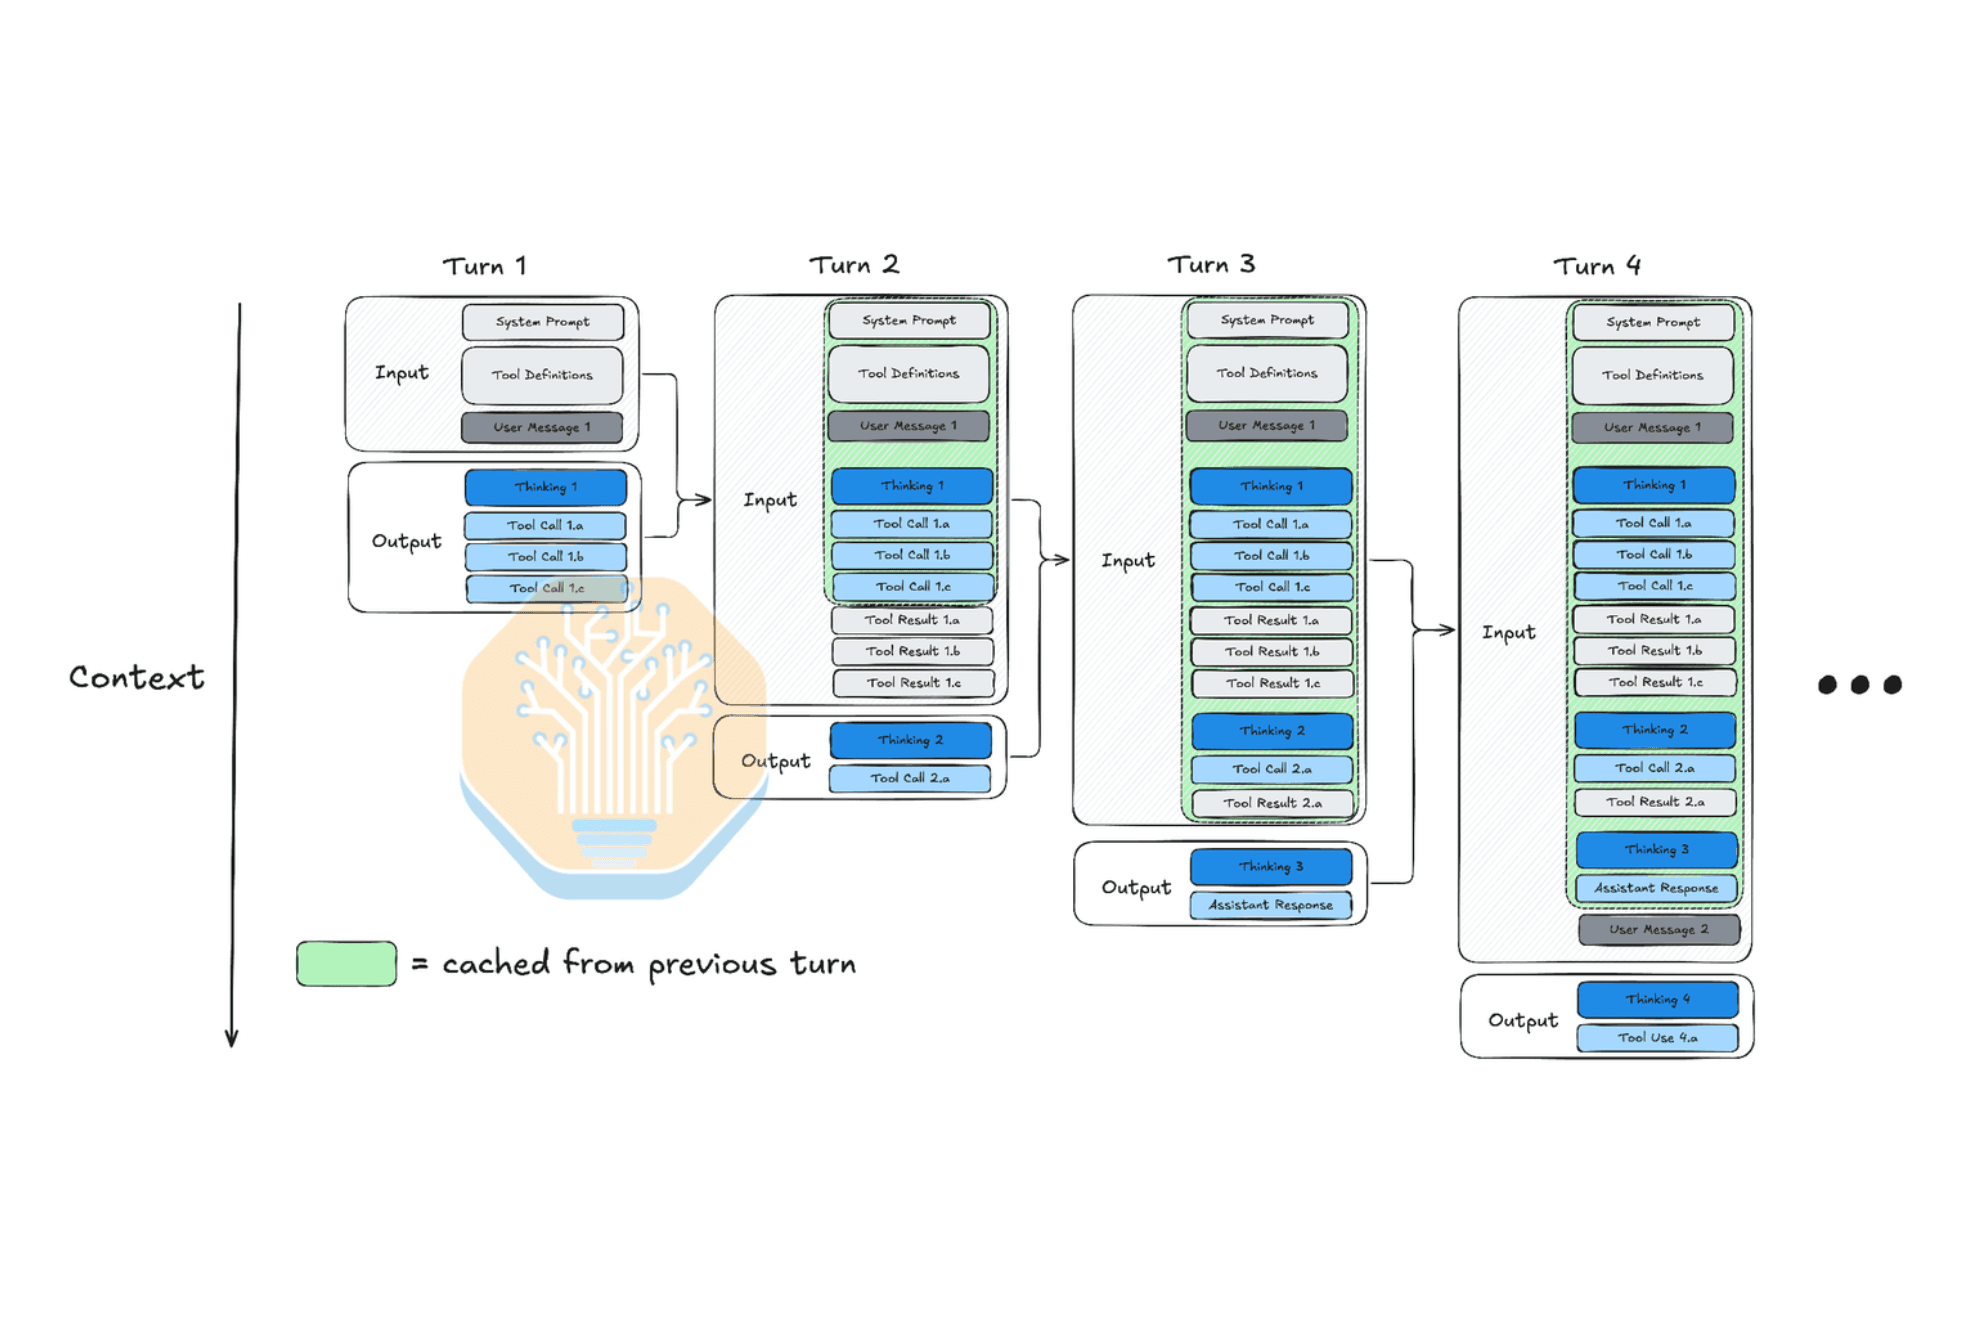
- 高前缀复用:对话通常线性推进,第 n-1 轮输出会拼接到第 n 轮。
- 子智能体突发:一个会话会启动多个使用全新上下文的短时子智能体,产生突发性的 KVCache 访问模式。
TPU 证明了其即将推出的 TorchTPU vLLM 栈能够处理智能体负载。
NVIDIA 的首轮反击提交
NVIDIA 工程师加班推出 FP4 反击提交,decode 性能超过 TPUv7 FP8,但存在一个问题:他们过度优化 decode,牺牲了 prefill,损害了整体端到端性能。因此,在端到端性能上,TPU FP8 目前仍然胜过 GB300 NVL72 FP4。
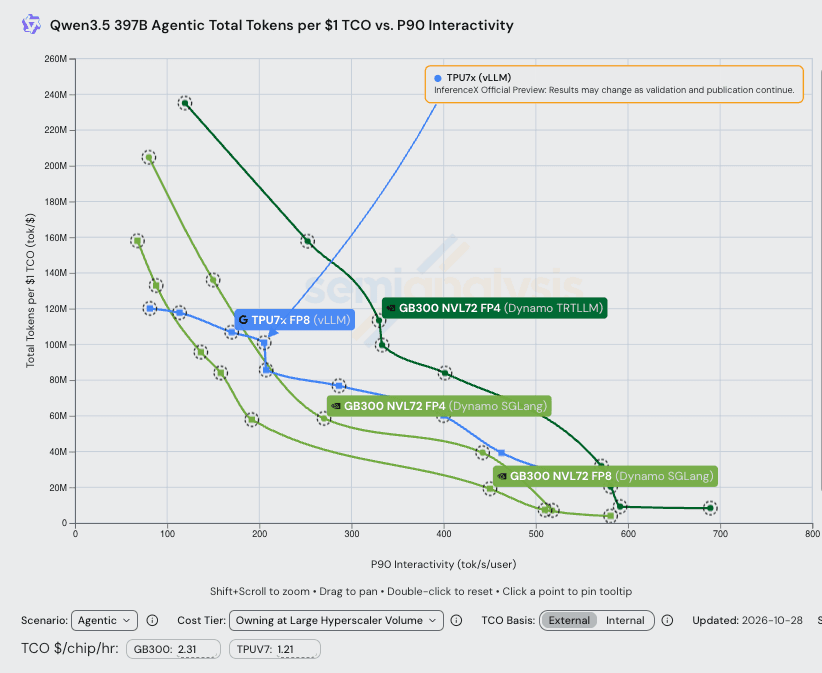
开源 Kubernetes llm-d 让 TPUv7 的 decode 交互速度远超 GB300 FP8
分离式服务把 prefill 和 decode 放在不同主机,避免长 prefill 阻塞生成。llm-d 是协调它们的开源 K8s 路由器,每台主机使用 4 颗 TPUv7,每个结果使用 24-32 颗芯片。
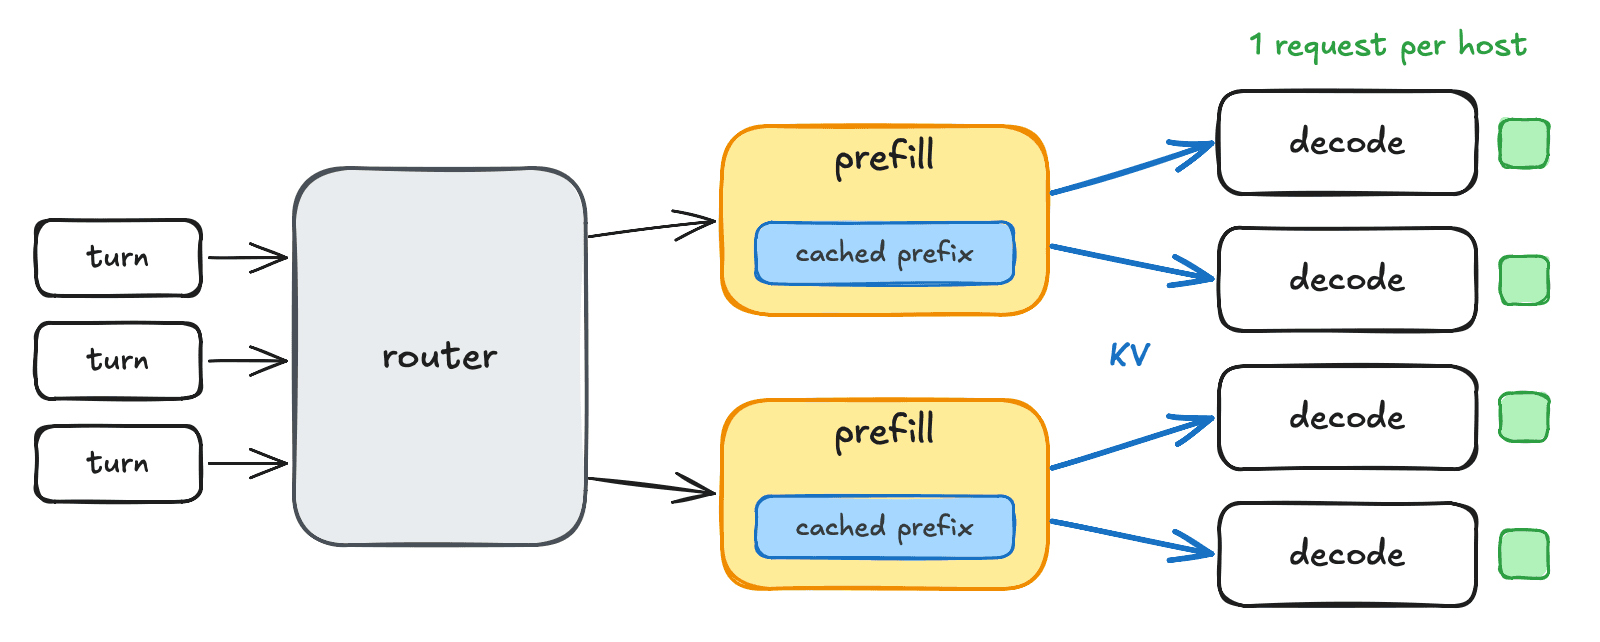
速度来自对每个 decode 主机运行请求数的限制:低延迟端一次运行一个请求,高吞吐端最多 112 个。超出上限的请求等待空闲主机,这会增加 TTFT。即便如此,最快点的 p90 首 token 时间仍为 8.6 秒,而 GB300 FP4 最快点为 11.1 秒。
这里使用的 llm-d 是开源生态中规模最大的生产级推理 Kubernetes 编排系统之一。最近 Kimi K3.1 Pro 发布时,llm-d 已提供 TPUv7 的 Day 0 支持。
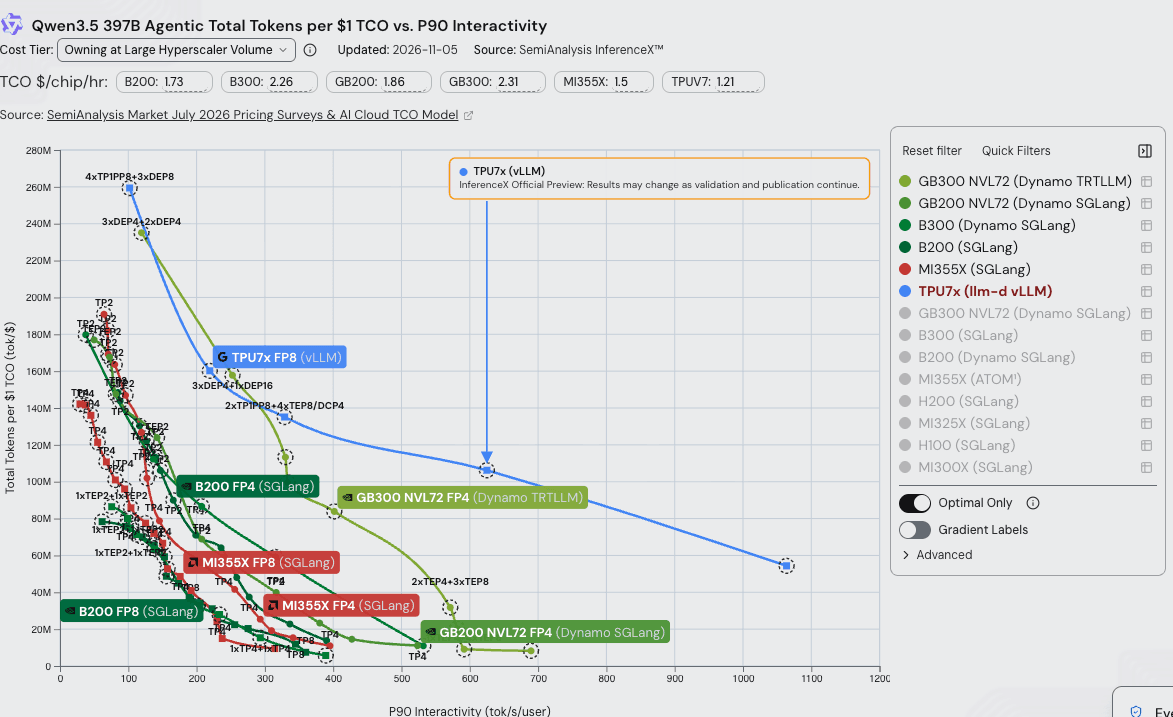
在 FP8 下,使用 llm-d 的 TPUv7 在所有交互速度上都胜过 GB300,从高吞吐端的 >2x,到超高速区域超过 1000 tok/s/user。
不过,使用这种按轮次路由的算法,TPU 的端到端性能会弱于 GB300 TRTLLM FP4。但相比 FP8 和 FP4 GB300 NVL72 SGLang,它仍明显更好。
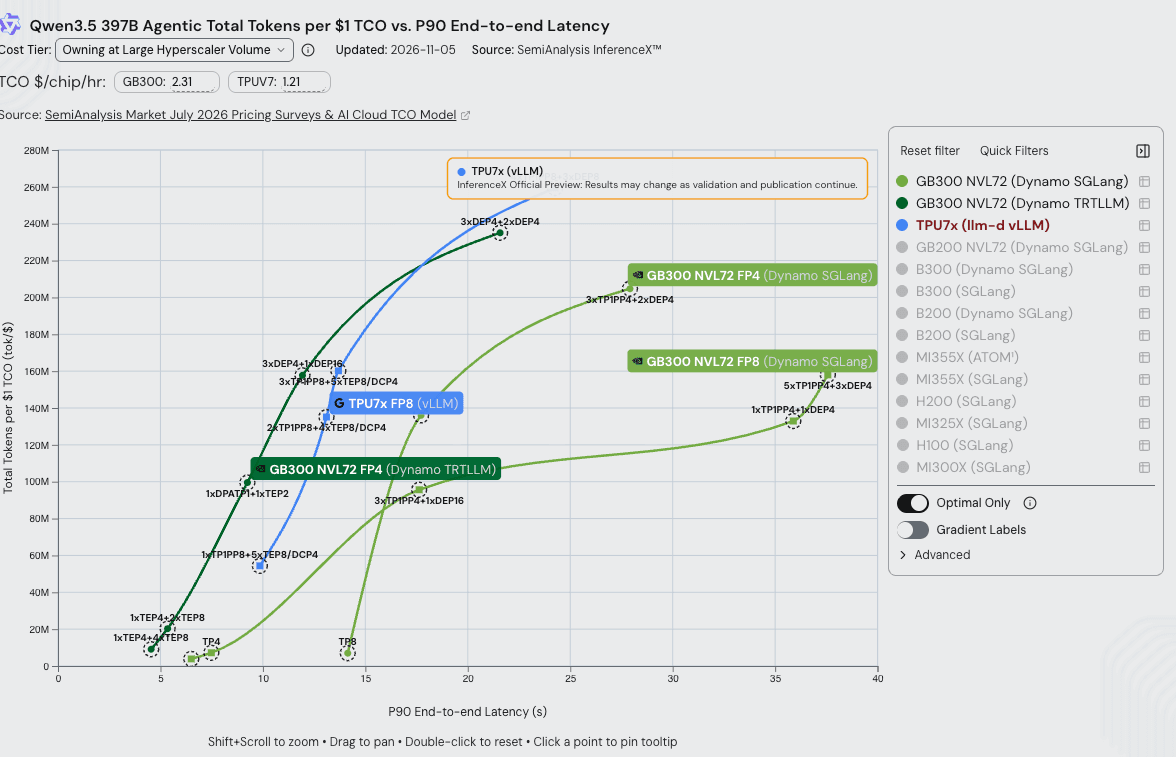
Qwen3.5 TPU 优化
Qwen3.5-397B 混合了 45 个线性注意力层和 15 个完整注意力层,前者为每个请求保留固定大小的状态。Google 介绍了三项主要改动:
- Decode megakernel。 一个 kernel 执行整个 decode 步骤,在当前层计算时预取下一层权重。
- Host DRAM offload。 KV cache 和线性注意力状态通过 Google 新开源的 offload 框架 TPU Sync,转存到主机 DRAM。
- 缓存感知路由。 llm-d 把每轮请求发往持有其前缀的 prefill 主机;只要 decode 主机未满,就让会话继续使用原主机。Google 表示,路由到准确的数据并行 rank 后,decode 缓存命中率从 56% 提高到 76%。
Kimi K3 AgentX
Inferact 的 TPU 团队和 AMD 率先在开源引擎中为前沿 MoE 模型提供 megakernel。 NVIDIA 在一周内迅速跟进,推出自己的 megakernel。
常规 decode 步骤会启动数百至数千个 kernel,芯片在它们之间处于空闲状态。Megakernel 将多个层放进一个长时间运行的 kernel,在计算当前权重时预取下一批权重。AMD 将自己的版本称为 MonoKernel。AMD 报告称,在八颗 MI350X GPU 上运行 GLM-5.2 时,它把一个 decode 步骤的 launch 数从约 2,459 次降至 210 次,并在 batch 1 下实现 2.31x 加速。
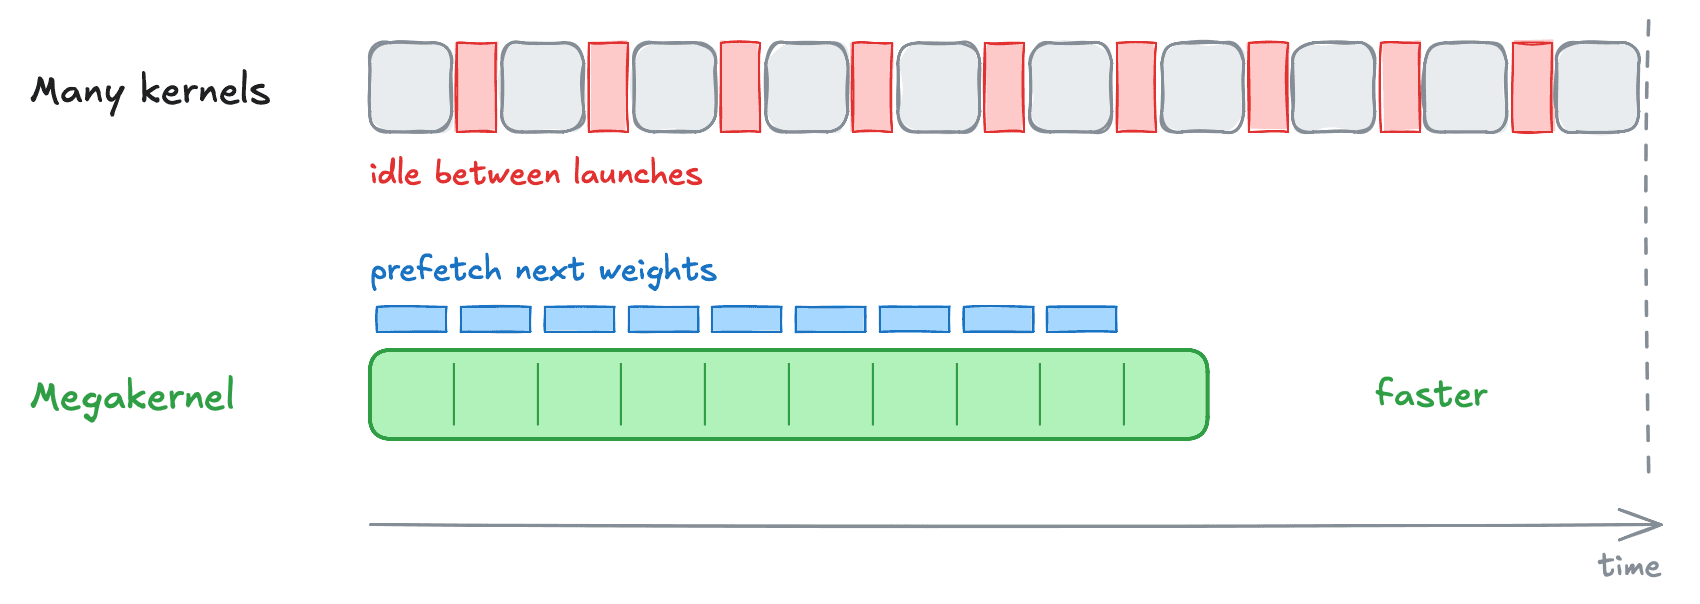
Megakernel 消除 kernel launch 之间的空闲间隙。关于 megakernel 的更多内容,请阅读我们的 TileRT 文章:
NVIDIA GPU 上的超高交互速度?TileRT InferenceX
这套配置在 prefill 中使用 DCP。上下文并行的 prefill 和 decode 两种名称,描述的是各技术通常在哪个阶段获益,而不是它们只能在哪个阶段执行。K3 使用 MLA,将 KV 存成各 head 共享的一份 latent,因此 TP 无法按 head 将其拆开,每个 TP rank 都持有完整副本。DCP 通过给每个 TP rank 分配不同 token 分片解决这个问题。若采用 prefill 上下文并行,就需要降低 TP 并行度,将权重复制到更多芯片上,留给 KV cache 的 HBM 更少,而这里本就缺少 KV 容量。
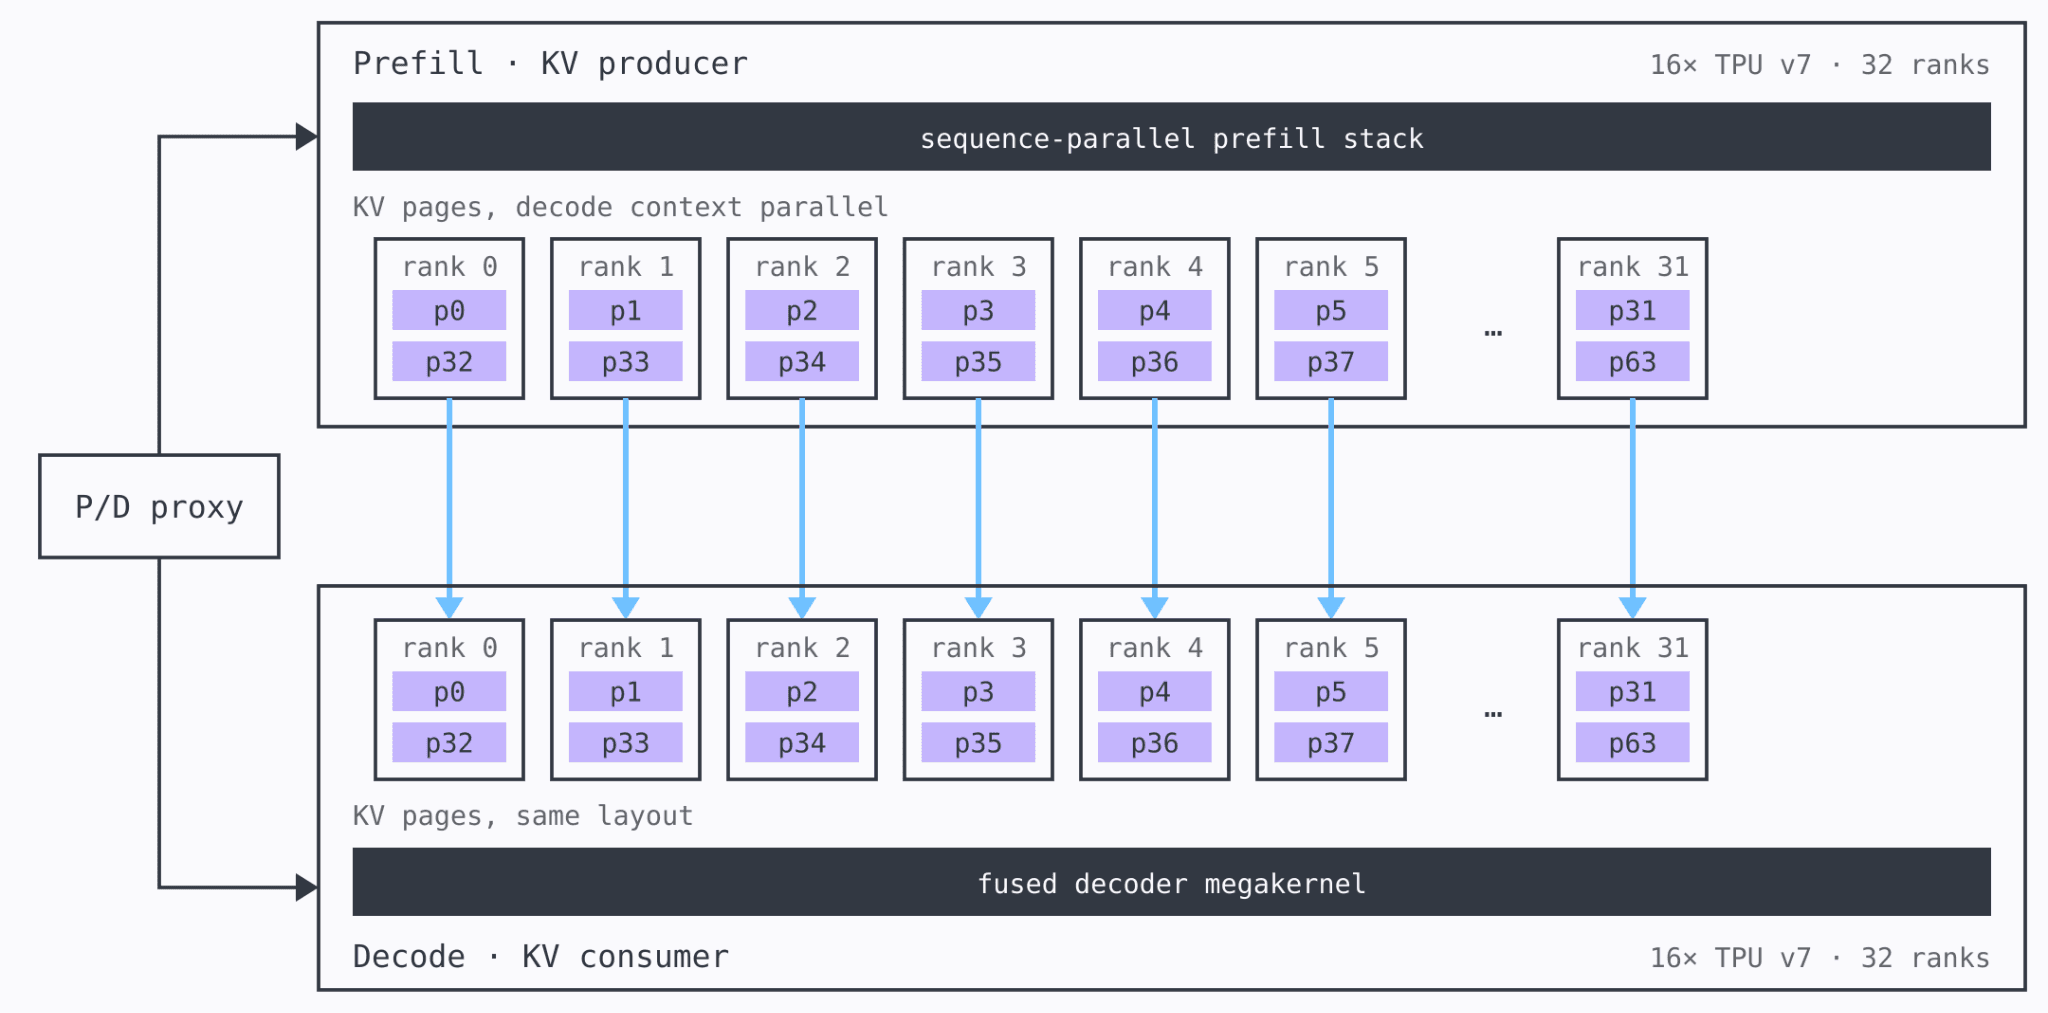
发布时就能与 GB300 FP4 竞争
在 10 月 17 日发布时,TPUv7 在 50 至 200 tok/s/user 范围内的每美元 token 数是 GB300 的 0.77x 至 0.91x,单用户速度则为其 1.6x,即 391 tok/s/user 对 251。采用 Google 内部成本口径时,它在 100 和 200 tok/s/user 都胜过 GB300。
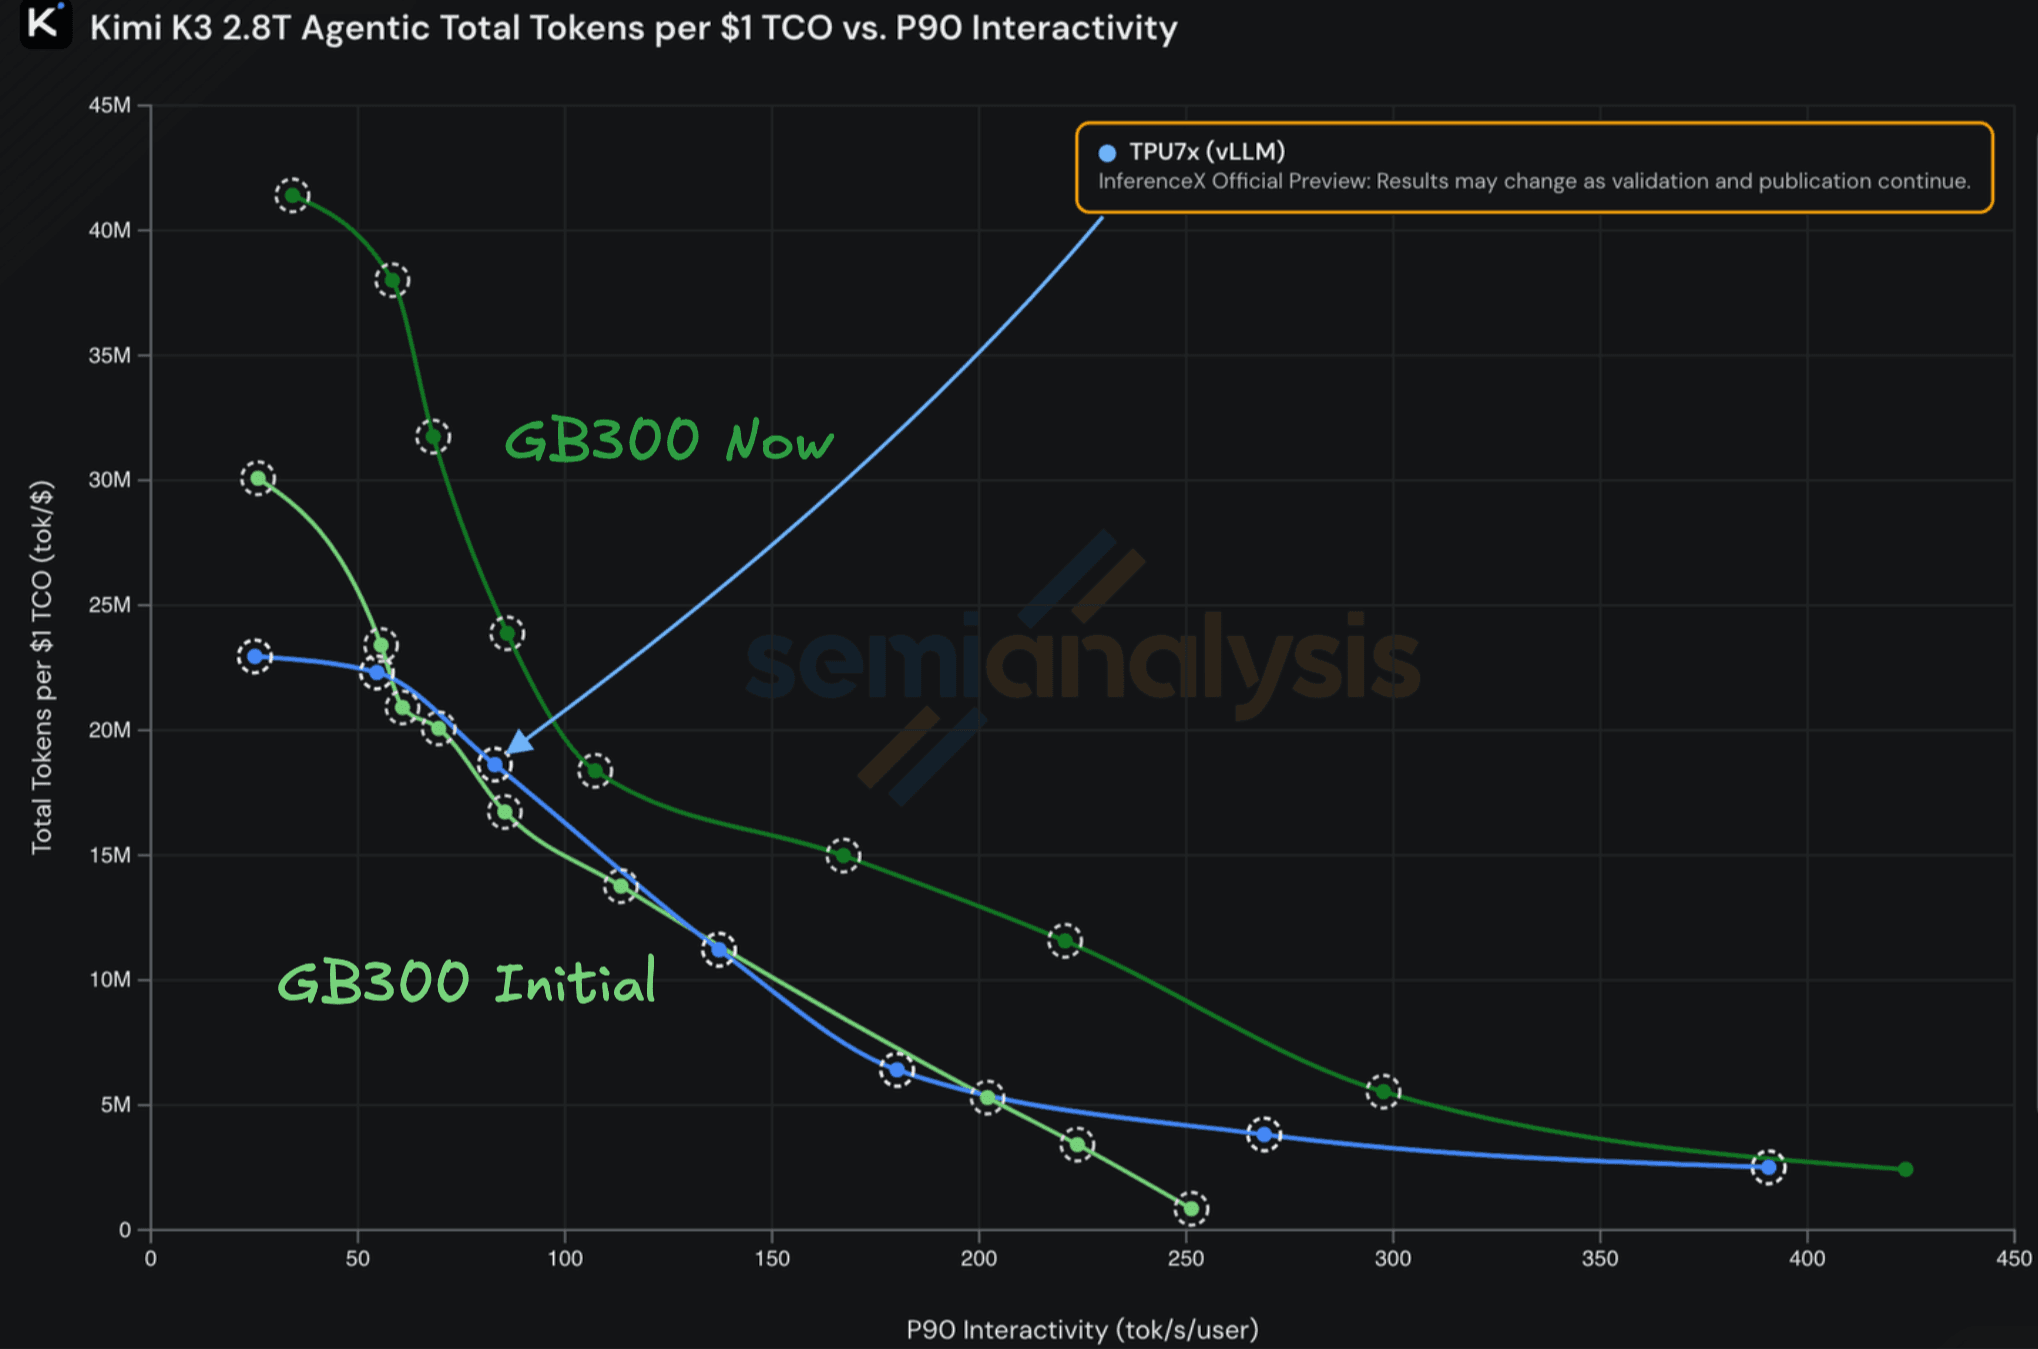
经过 NVIDIA 四轮更新,GB300 FP4 目前领先 1.5x 至 2.6x。TPUv7 的每美元 token 数仍是 GB200、B200 和 B300 的 1.15x 至 2.5x,具有竞争力;VR200 则达到 TPUv7 的 4.3x 至 5.6x。
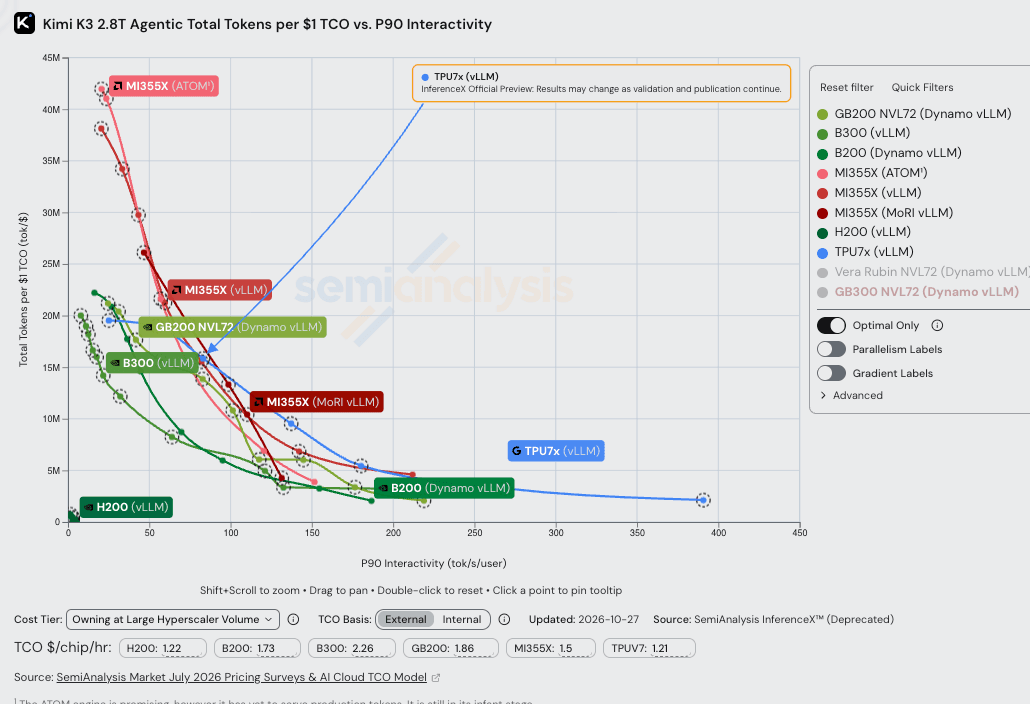
若将 TPUv7 与 Rubin NVL72 做一个并不对等的跨代比较,Rubin 的每美元性能最高可达 6x。但这并不公平,Rubin 应该与 TPUv8i 对比,我们很快就会对后者进行基准测试。
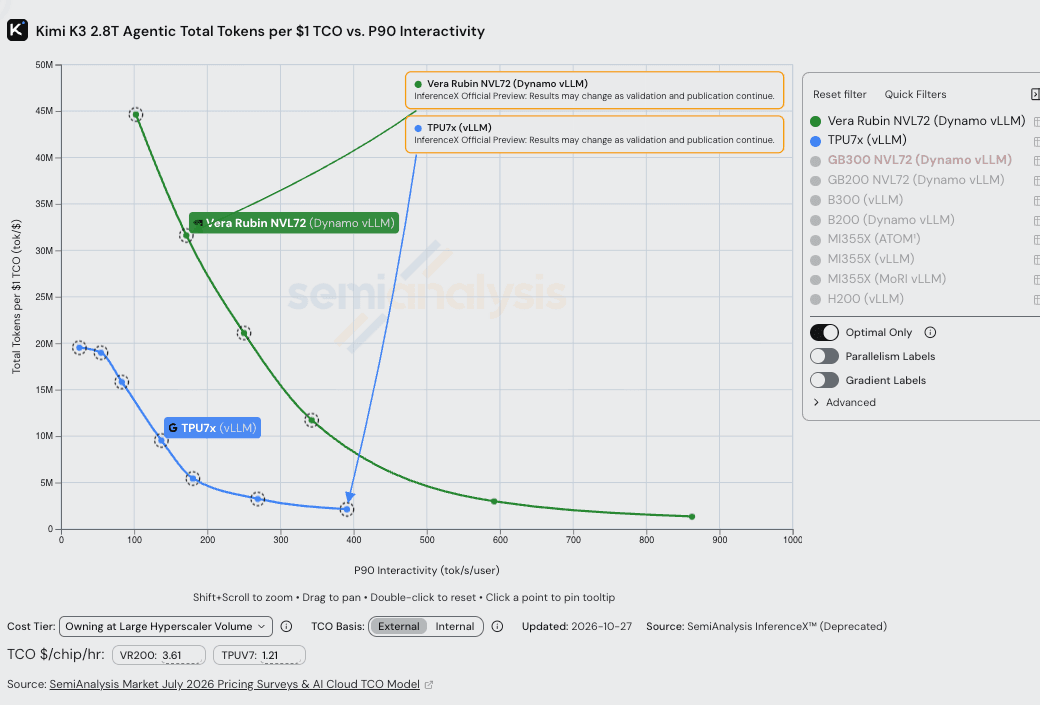
必须注意,Rubin 的结果仍是预览提交。我们期待 NVIDIA 提供 Rubin 的直接访问权限,以便独立复现这些结果,并运行完整的 InferenceX/AgentX 测试套件。
来自生态的成果
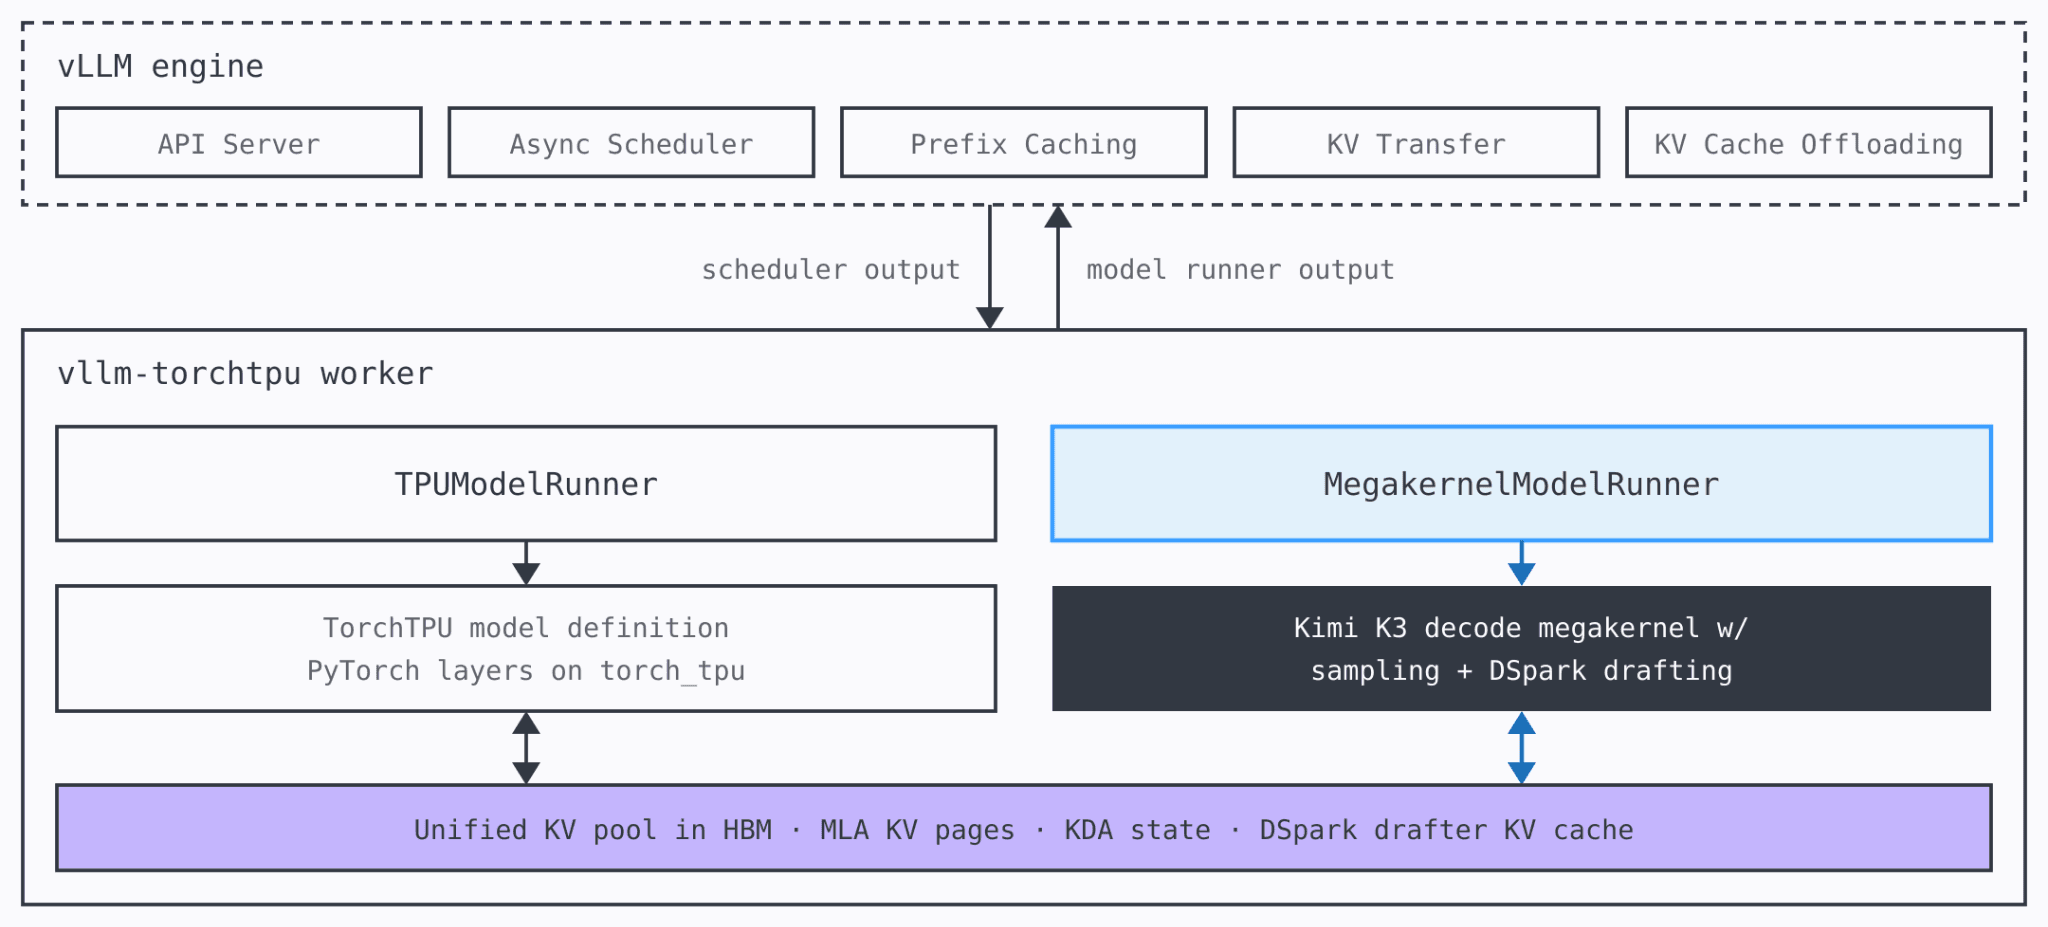
这个结果来自 vLLM 生态,而不只是 Google。由 vLLM 创建者和维护者创办的 Inferact,与 Google 共同开发 K3 megakernel,并联合提交结果。Megakernel 作为 model runner 接入 vLLM,只替换 forward,因此 vLLM 的调度、前缀缓存和 KV 传输保持不变。这套软件栈已在 vLLM TorchTPU 开源,Inferact 的复现指南使用 Docker 镜像运行。过去,这类生态开发大多发生在 CUDA 上。
相关术语
查看 decode megakernel、kernel launch 开销、decode 上下文并行、prefill 上下文并行、注意力 head dimension、HiCache、decode 准入控制 和 KV-cache 亲和性 的定义。
本文由英文原文翻译而来,如有歧义以英文版为准。所有文章版权归 © SemiAnalysis 所有,保留所有权利。覆盖应用源代码的 AGPL-3.0 许可证不适用于文章内容。