预计阅读 39 分钟
TPU 推理外部化全速推进
InferenceX、最高 50% 的每美元性能优势、TPU 软件栈的快速外部化、不断扩大的客户群、Ironwood、TPUv8i,以及正在收窄的 CUDA 护城河
- benchmark
- inference
- tpu
- +7
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
10 篇文章
预计阅读 39 分钟
InferenceX、最高 50% 的每美元性能优势、TPU 软件栈的快速外部化、不断扩大的客户群、Ironwood、TPUv8i,以及正在收窄的 CUDA 护城河
预计阅读 3 分钟
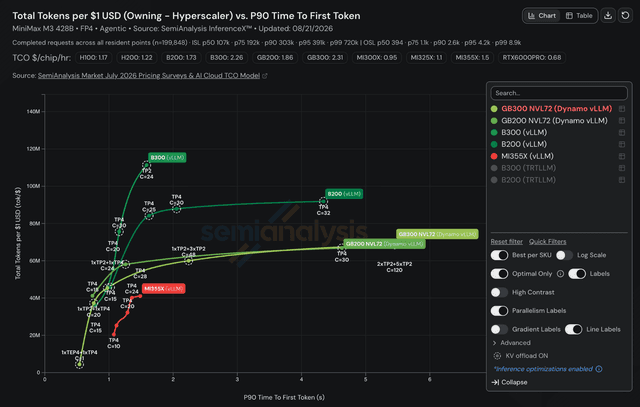
NVIDIA 横扫这个 432B 模型,而缺失的 DP attention 数据点说明了缓存局部性为何变成路由约束
预计阅读 20 分钟
运行在 NVIDIA GPU 上的 TileRT 软件能否与 Cerebras、Groq LPU、SambaNova 竞争?批大小为 1、分离式引擎、高吞吐量预填充引擎、高交互性解码引擎
预计阅读 31 分钟
第0天推理性能、InferenceX、26天内性能提升100倍、每百万 token 成本、Huawei 950DT 推理 Trace 分析

预计阅读 11 分钟
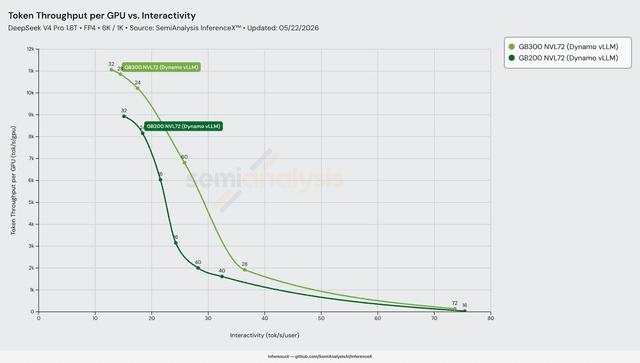
DSv4-Pro FP4 8K/1K,Dynamo+vLLM,两套机架均采用分离式部署。GB300 多出 50% 的 HBM(每 GPU 288 GB vs 192 GB)解锁了 GB200 无法容纳的更宽预填充+解码配方——尽管单 GPU TCO 溢价 20%,曲线中段性价比仍提升 2.31 倍。

预计阅读 13 分钟
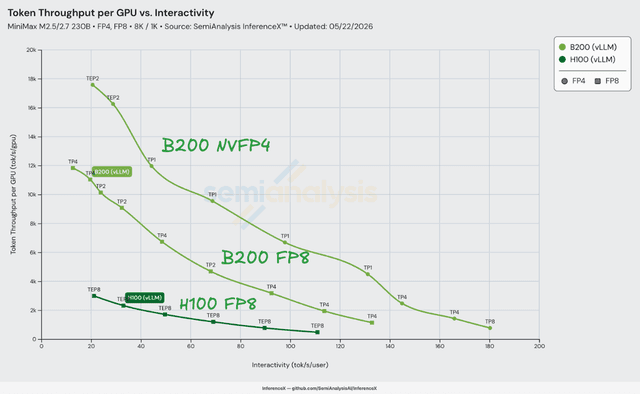
vLLM PR #36307 为 MiniMax 在 B200 上解锁了 trtllm-gen FP8 MoE 模块化内核;结合 NVFP4,在 8K/1K 负载下性能/成本从 22 tok/s/user 时的 4.0 倍扩大到 110 tok/s/user 时的 8.2 倍

预计阅读 12 分钟
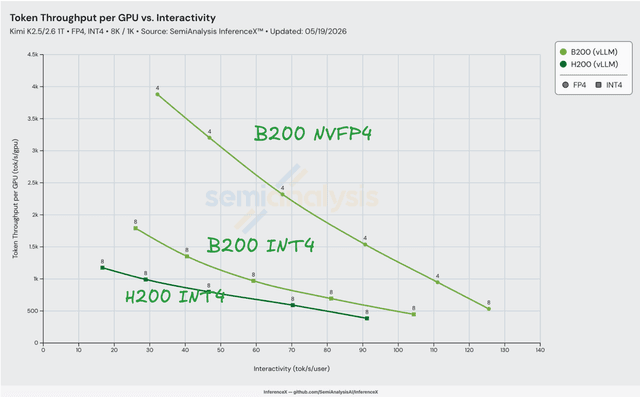
在 vLLM 8K/1K 工作负载下,B200 NVFP4 路径在 30–90 tok/s/user 推理区间内每百万 tokens 成本比 H200 INT4 低 2.71x–2.95x,比同一 B200 硬件上的 INT4 低 2.45x–2.74x。三个因素——B200 的 HBM 带宽、HBM 容量和 NVFP4 张量核心——可清晰分解该优势

预计阅读 7 分钟
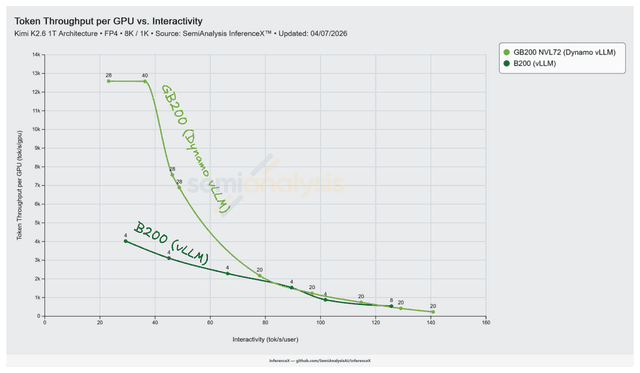
NVL72 的机架级 NVLink 使 Dynamo vLLM 能够以最高 Decode EP 16 运行 Kimi K2.5 宽 EP,在 8k/1k NVFP4 下峰值吞吐量从 4,021 提升至 12,587 tok/s/GPU

预计阅读 7 分钟
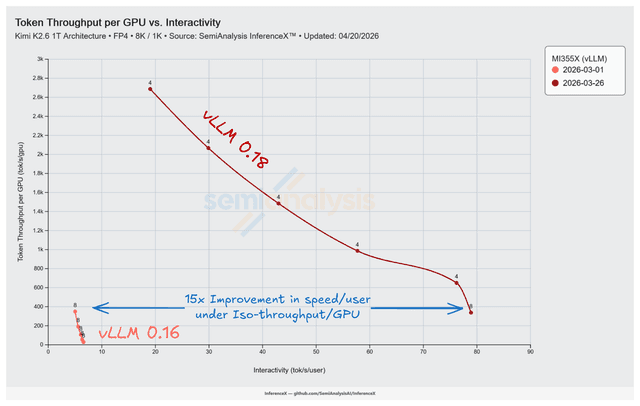
vLLM PR #35850 修复了 MI355X CDNA4 上的 AITER MLA 分发路径,解锁 TP=8 下的 Kimi K2.5 推理性能,随 vLLM 0.18 一同发布