
预计阅读 11 分钟
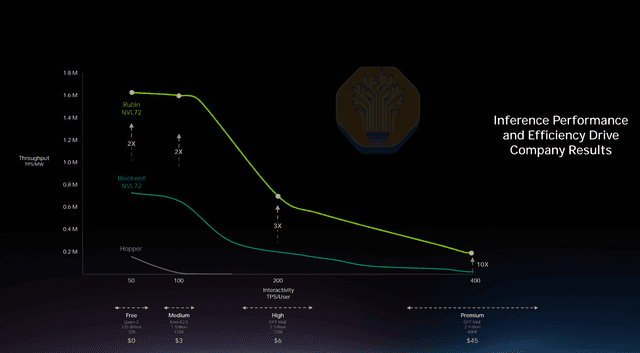
Rubin NVL72 Agentic 推理:每美元性能提升至 67 倍
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
- benchmark
- gpu
- inference
- +7
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
14 篇文章
预计阅读 11 分钟
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
预计阅读 3 分钟
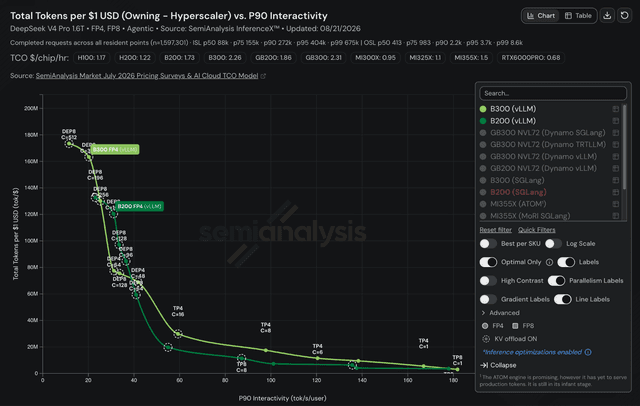
多出 50% 的 HBM 能挤出额外吞吐量,逐点遥测数据说明了它究竟从何而来
预计阅读 3 分钟
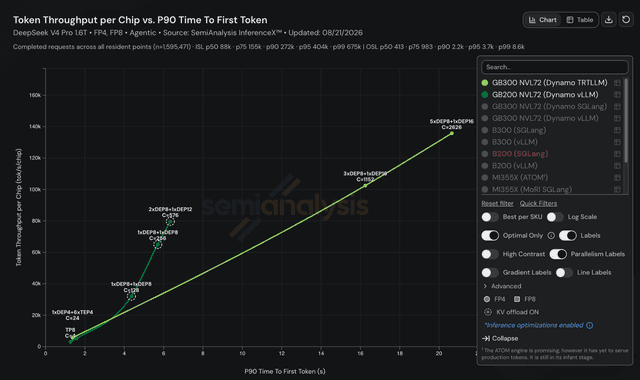
两者都依赖 PD 分离,GB300 额外使用 DEP32 宽专家并行解码,而差距体现在首 token 延迟而非 token 速率上
预计阅读 3 分钟
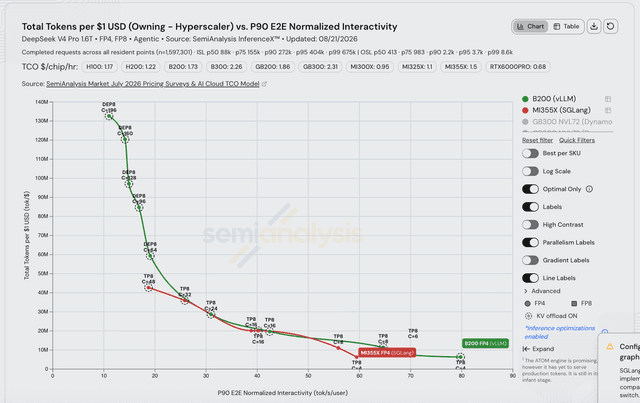
在端到端延迟的每美元性能上,AMD 一度追平 B200 vLLM,随后上游 vLLM 的优化改变了格局
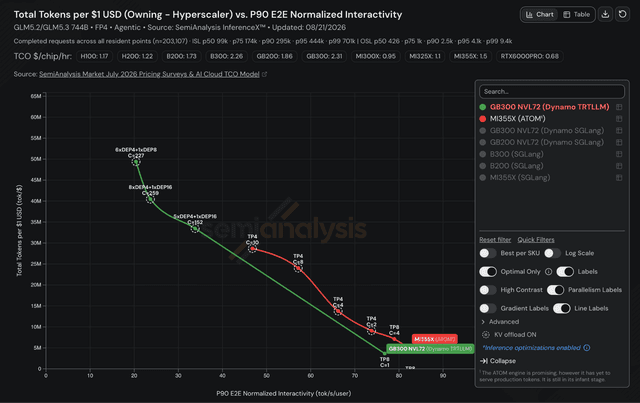
预计阅读 3 分钟
AMD 厂商引擎在每美元性能上胜出的区间,以及端到端归一化交互性究竟衡量什么
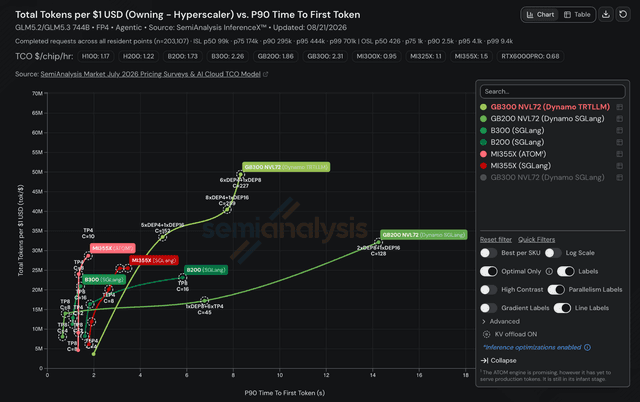
预计阅读 2 分钟
在这个运行点上,即便 AMD 硬件白送也仍然填不平差距
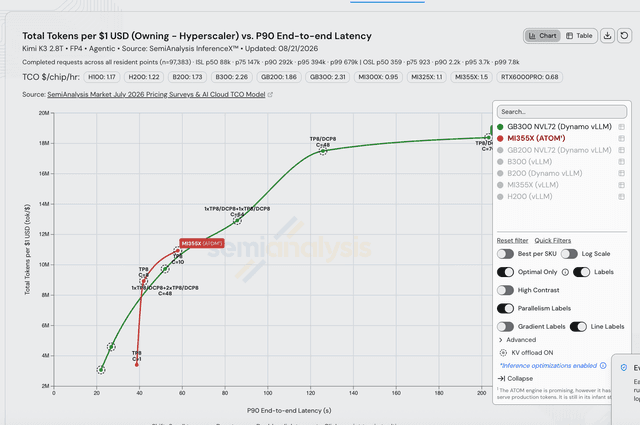
预计阅读 2 分钟
AMD 的厂商引擎在每美元性能前沿上赢下了实打实的一段,而 Hopper 连服务 K3 都很吃力
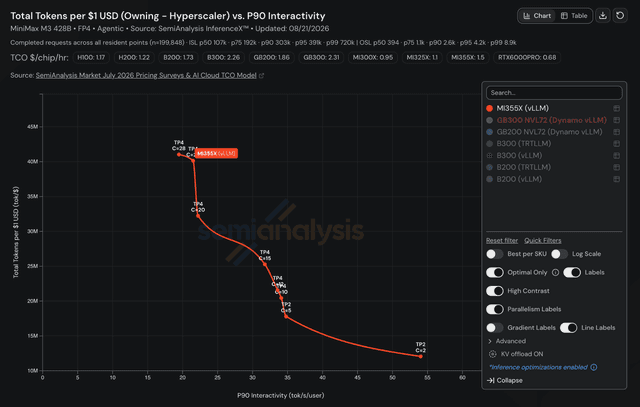
预计阅读 3 分钟
Dynamo router 成为瓶颈,没有提交使用上下文并行,而 AMD 完全没有用上 KV offload
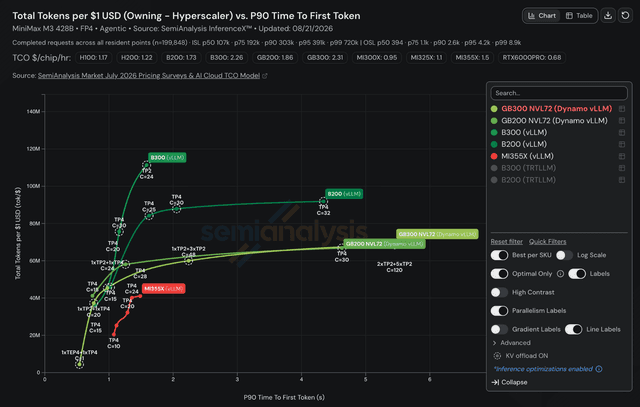
预计阅读 3 分钟
NVIDIA 横扫这个 432B 模型,而缺失的 DP attention 数据点说明了缓存局部性为何变成路由约束
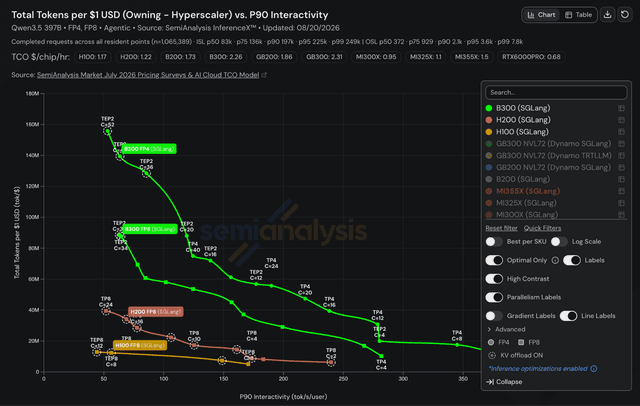
预计阅读 2 分钟
在长上下文 agentic 工作负载上,四年硬件迭代加上 4 位格式能换来什么
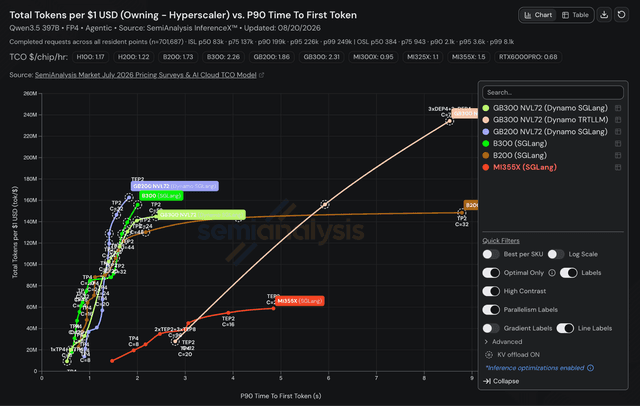
预计阅读 2 分钟
GatedDeltaNet、262k 原生上下文,以及同一引擎上 AMD 完全缺席的竞争
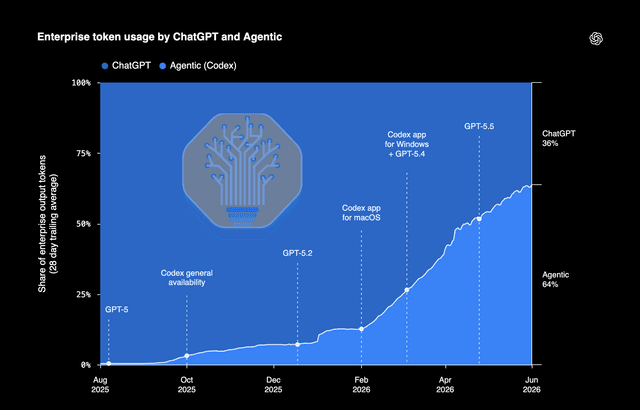
预计阅读 71 分钟
开源价值 300 万美元的数据集、100 万以上上下文长度、多轮、子智能体、95%+ KVCache 命中率、GB300 NVL72、MI355X、B200
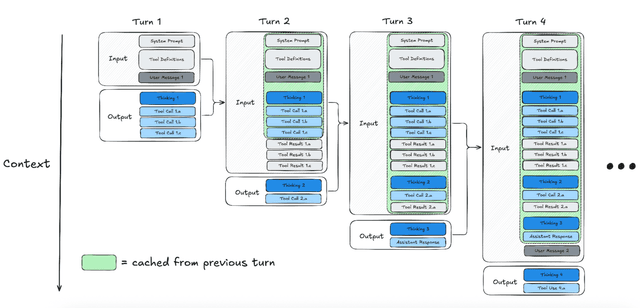
预计阅读 6 分钟
多轮会话、长上下文与近乎完全的 prefix 复用,让 agentic 推理成为一个系统问题,也改变了基准测试需要测量的内容
预计阅读 20 分钟
运行在 NVIDIA GPU 上的 TileRT 软件能否与 Cerebras、Groq LPU、SambaNova 竞争?批大小为 1、分离式引擎、高吞吐量预填充引擎、高交互性解码引擎