本文于 2026 年 9 月 14 日首发于 SemiAnalysis newsletter,作者为 Bryan Shan、Alec Ibarra、Cam Quilici、Wenyao Gao 和 Dylan Patel。
本站转载原文的公开部分。付费订阅者专属的后续内容请见原文。
Rubin 是首个面向 agentic 时代、围绕六款产品协同设计的平台:Rubin GPU、Vera CPU、NVLink 6 Switch、ConnectX-9、BlueField-4 和 Spectrum-6。今天,我们公布首批经过验证的 Rubin agentic 推理结果,测试采用我们的 agentic 推理基准 AgentX。即使软件还处于早期预发布阶段,结果也已经说明了深度协同设计的必要性。
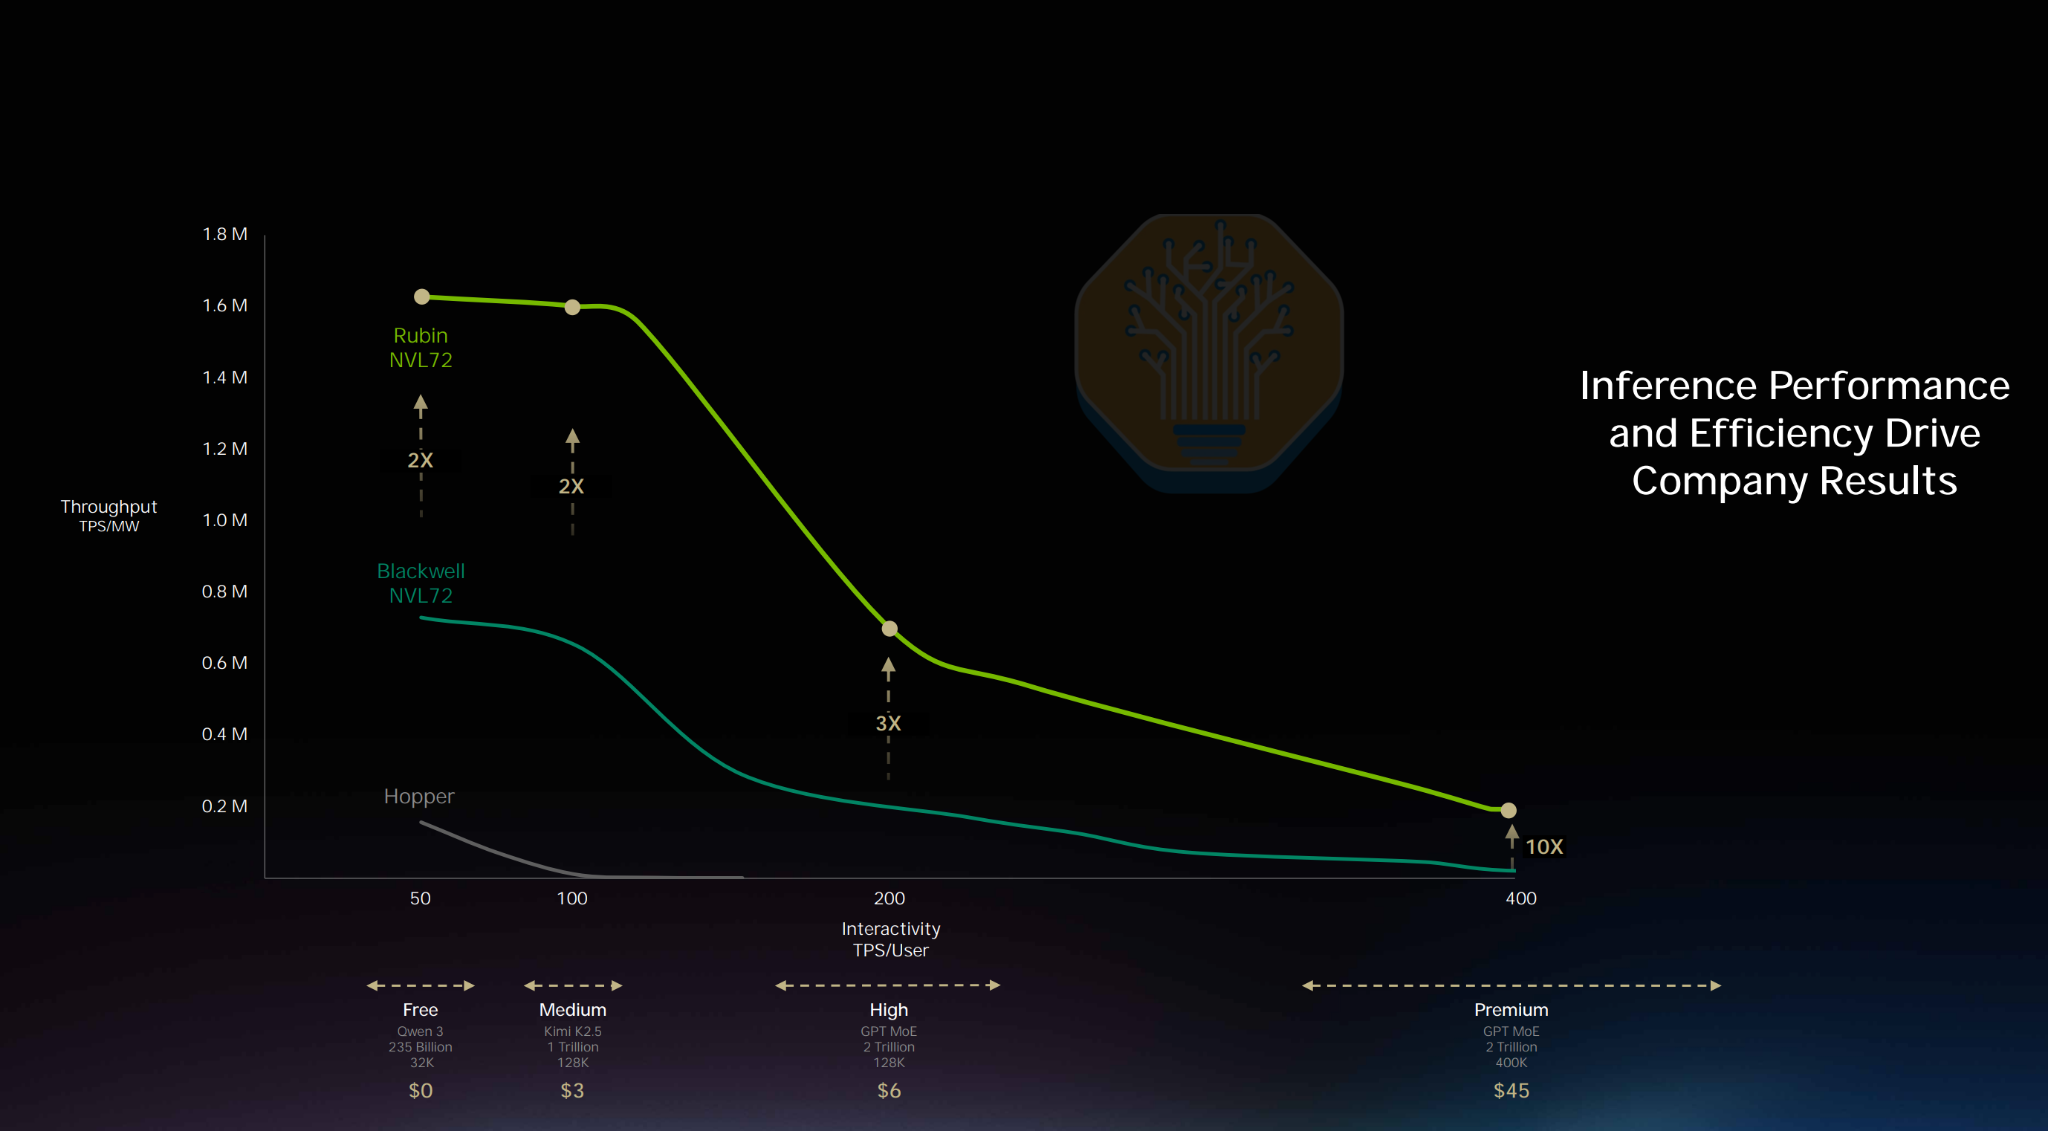
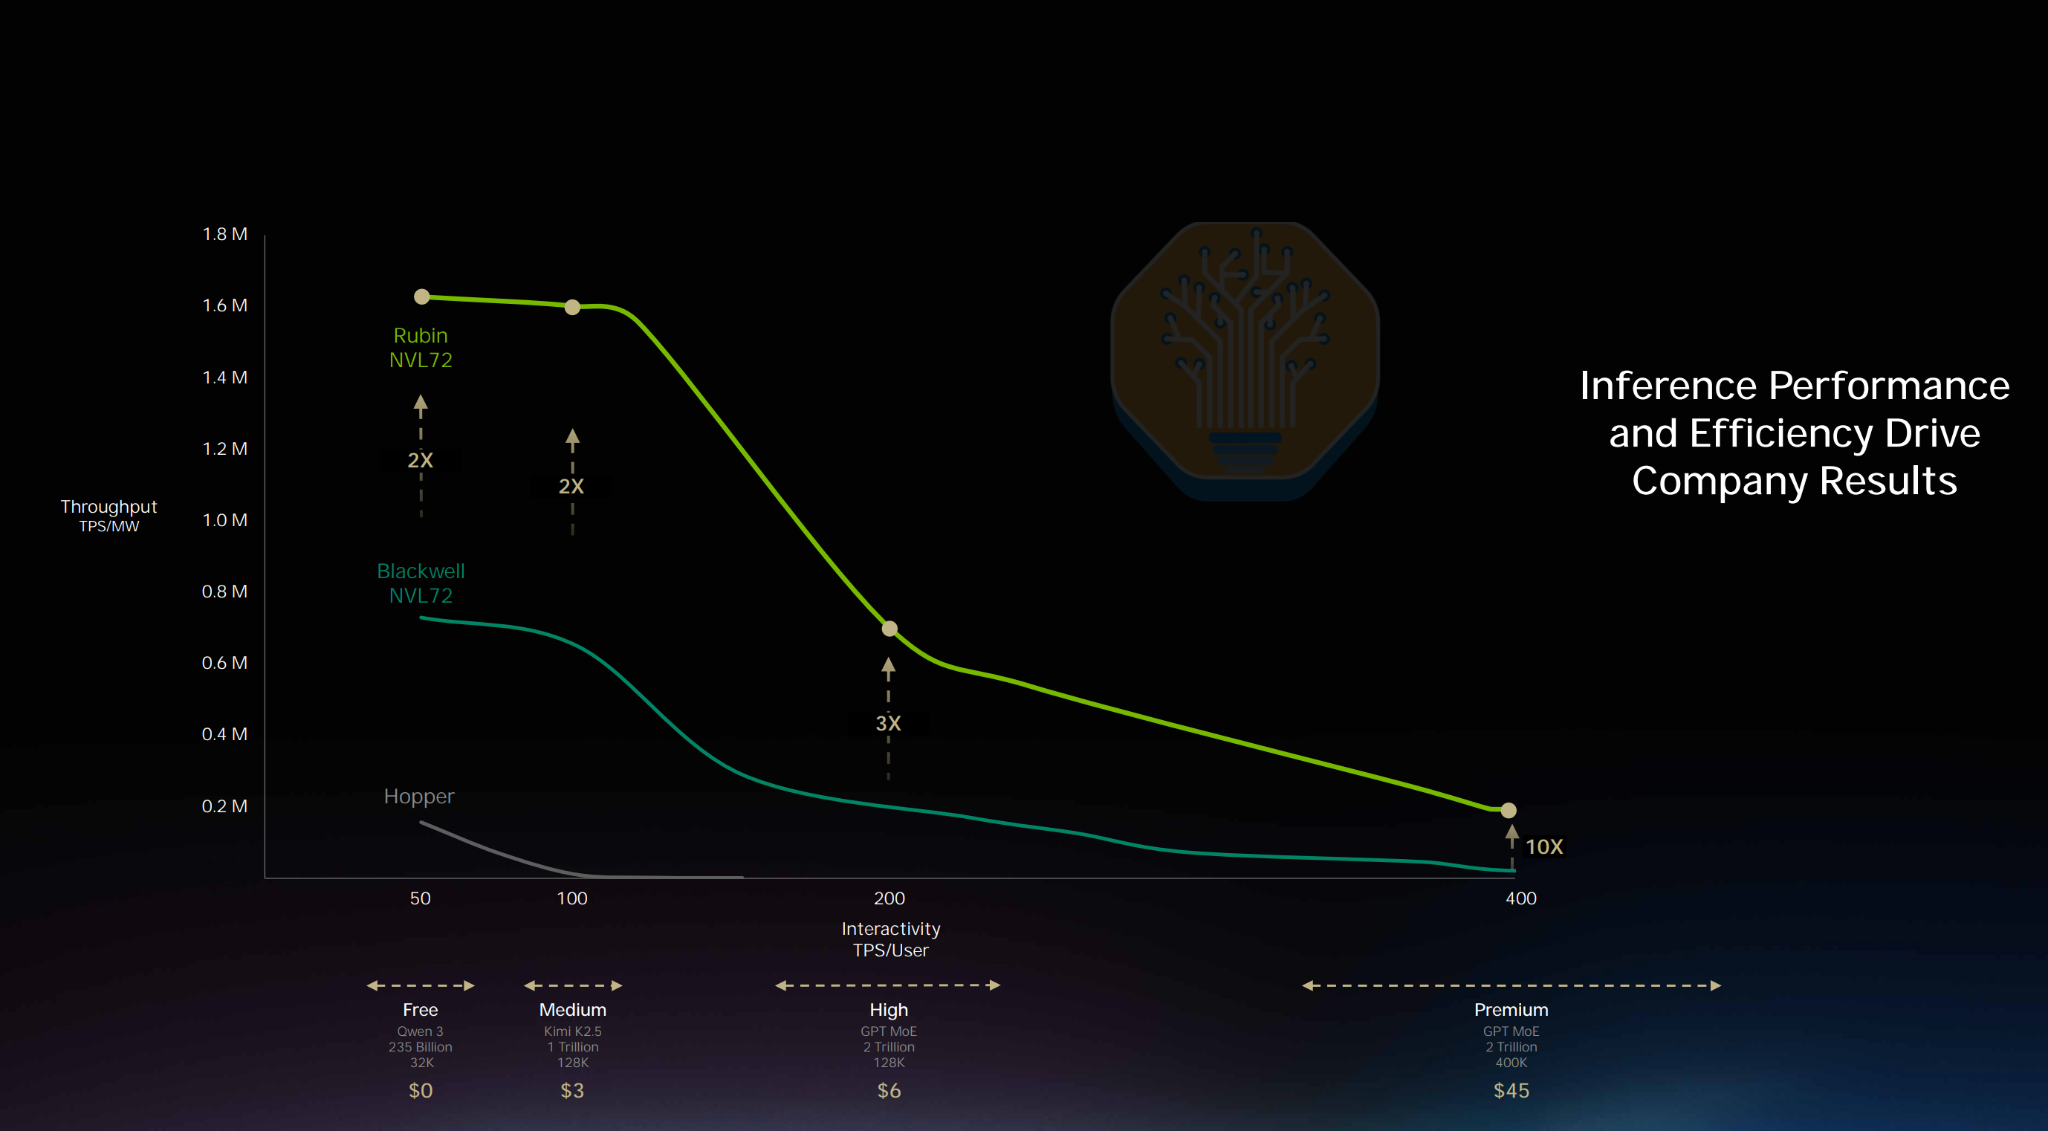
在 GTC 2026 上,Jensen 展示的图表表明,在约 200 TPS、参数量为 O(1-3 Trillion) 的模型上,VR NVL72 的每 MW 性能是 Blackwell 的 3 倍。但我们在预发布软件上测得的 Rubin 实际性能,已经达到每兆瓦 token 吞吐量最高 7 倍的提升。Jensen 该停止在 GTC 上低报性能了。上一次是在 GTC 2024,他声称 GB200 NVL72 的性能将达到 Hopper 的 30 倍,而我们的实测结果是 98 倍。
根据这些性能结果,我们估算,即使使用早期软件版本,Rubin 每吉瓦能赚取的利润也可超过 Blackwell 平台的两倍。随着 Rubin 软件栈和 kernel 库成熟,以及开发者积累优化经验,我们预计差距还会扩大。
我们使用名为 AgentX 的业界标准 agentic 推理基准场景评估性能。它在我们包含数千颗芯片的测试集群上重放真实的 agentic 流量,让推理服务商和超大规模 AI 实验室能据此判断,不同场景下哪些芯片效率更高。
几乎所有主要算力买家都曾复现、验证或支持我们的基准测试,包括 Google Cloud、Microsoft Azure、Oracle、Meta 等。它还获得了 vLLM、LMCache、SGLang、PyTorch、Huggingface 等 ML 社区项目,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等主要实验室的支持。
感谢 Jensen Huang、Ian Buck、Nick Comly、Kedar Potdar、Rohit Nagraj 和中国大陆 TensorRTLLM 团队协助下一代 Rubin 软件 bring-up,并帮助验证我们的 agentic 基准测试结果。
如果这些开源基准测试和数据对你有用,请给 InferenceX GitHub 仓库点个 Star!InferenceX 是全球唯一同时涵盖 TPUv7、NVIDIA 和 AMD,并将很快加入 SambaNova 和 Trainium 的推理基准。由于 AgentX 场景贴近真实的 agentic 推理负载,AMD 也已承诺就 MI455X UALoE72 展开合作。
Agentic 工作负载入门
概括来说,agentic 工作负载有四个特点:
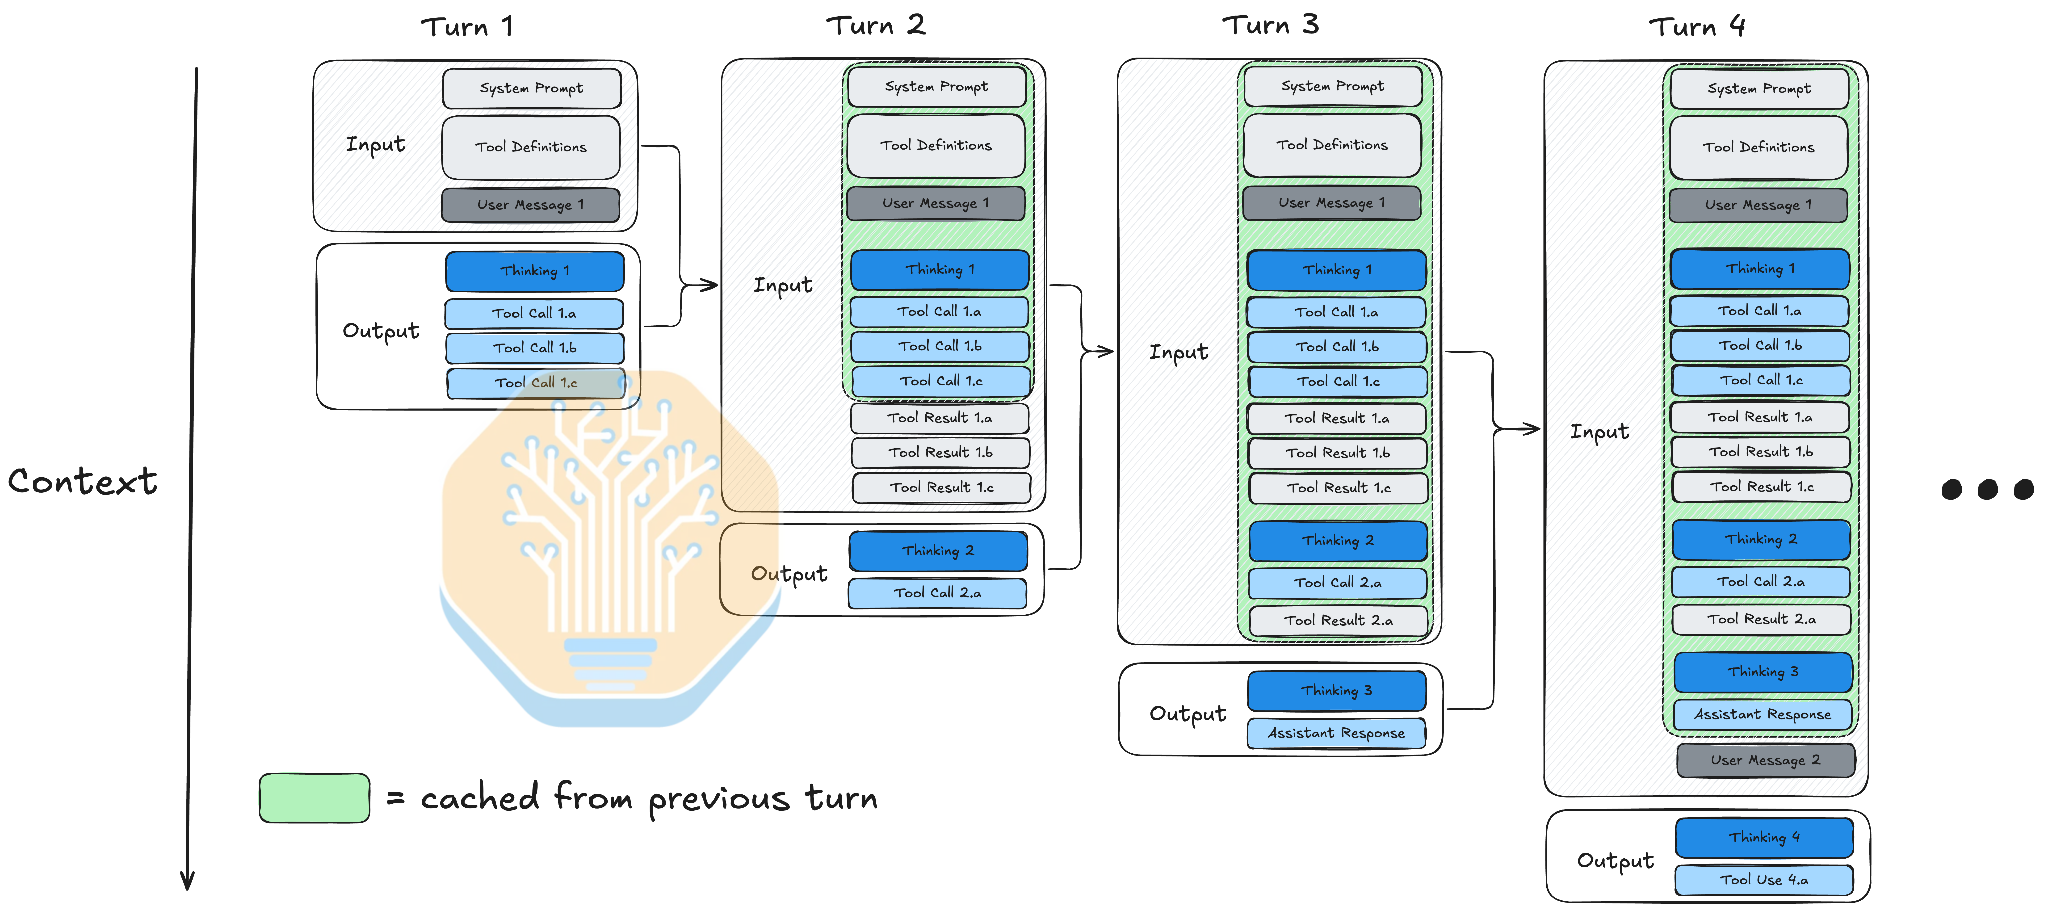
- 多轮交互:一个会话包含用户与助手之间数十次乃至数百次交互,而聊天机器人场景通常只有几次。这类负载同时包含长上下文、大量 prefill 复用、子 agent 的突发执行和频繁的工具调用。
- 长上下文:系统提示词、工具定义和大量交互轮次使上下文迅速累积。
- 高前缀复用率:对话通常线性推进,第 n-1 轮的输出会拼接到第 n 轮,因此大部分上下文可直接从 KV cache 读取,无需重新计算,具体取决于可用于存储 KV tensor 的容量。随着 n 增大,已缓存输入相对未缓存输入的比例通常趋向于 1。
- 子 agent 突发执行:会话会启动多个短生命周期、使用全新上下文的子 agent,形成突发的 KV cache 访问模式。
方法论的更多细节可参阅我们的 AgentX 文章。
AgentX - InferenceXv3:CUDA 护城河在 Agentic 推理中还成立吗?
Rubin 出色的单位 TCO 性能
单位总拥有成本(TCO)性能是评估 AI 加速器的重要维度。下图的 Y 轴表示每 $1 TCO 对应的总 token 数。**实际含义是:推理服务商每花一美元算力成本,能够生成多少 token。**计算方法是将某个场景的总吞吐量除以完整的服务成本,即每芯片每小时成本($/chip/hr)乘以提供服务所用的芯片数量。
InferenceX 为每个 SKU 提供几种不同的 TCO 数值,均来自 SemiAnalysis AI Cloud TCO Model。默认提供以下场景:
- 按大型 hyperscaler 采购规模自持:模型估算拥有和运营硬件的每 GPU 小时成本,包括按假定使用寿命分摊的服务器和网络资本支出、机房托管、电力及资金成本。该场景采用 hyperscaler 的采购和融资条件,包括批量折扣和定制服务器。
- 租赁,3 年合约:根据 SemiAnalysis 租赁价格调研,向云服务商购买三年期预留资源所支付的每 GPU 小时市场价格。
用户也可以在计算器中修改算力成本,填入自己的实际价格。按需租赁市场价格和更短期限的租赁价格等数据可在 AI Cloud TCO Model 中查看。该模型基于我们每月对 100 多家 GPU 客户、GPU neocloud 和 hyperscaler 的市场调研。
**Vera Rubin 的每美元性能显著高于 GB300。**在 170 TPS、同为 TRTLLM NVFP4 Dense 的对等比较中,按自持成本计算,Vera Rubin NVL72 的单位 TCO 总吞吐量约为 GB300 Dynamo TRTLLM 的 67 倍。在大多数服务商实际部署该模型的前沿区间(60-100 TPS),Vera Rubin 的单位 TCO 吞吐量为最新 GB300 TRTLLM 配置的 1.4-3 倍。
我们的机架使用量产 SKU,TDP 为 2300W,每个计算托盘配备 1.5TB CPU LPDDR5X。关于 NVIDIA 为何将 Vera 内存容量减半,我们在加速器与内存模型中有更详细的讨论。本文讨论 Rubin 上的 TRTLLM 性能;后续文章预计也会涵盖 vLLM 和 SGLang 在 Rubin 上运行 agentic 推理负载的表现。
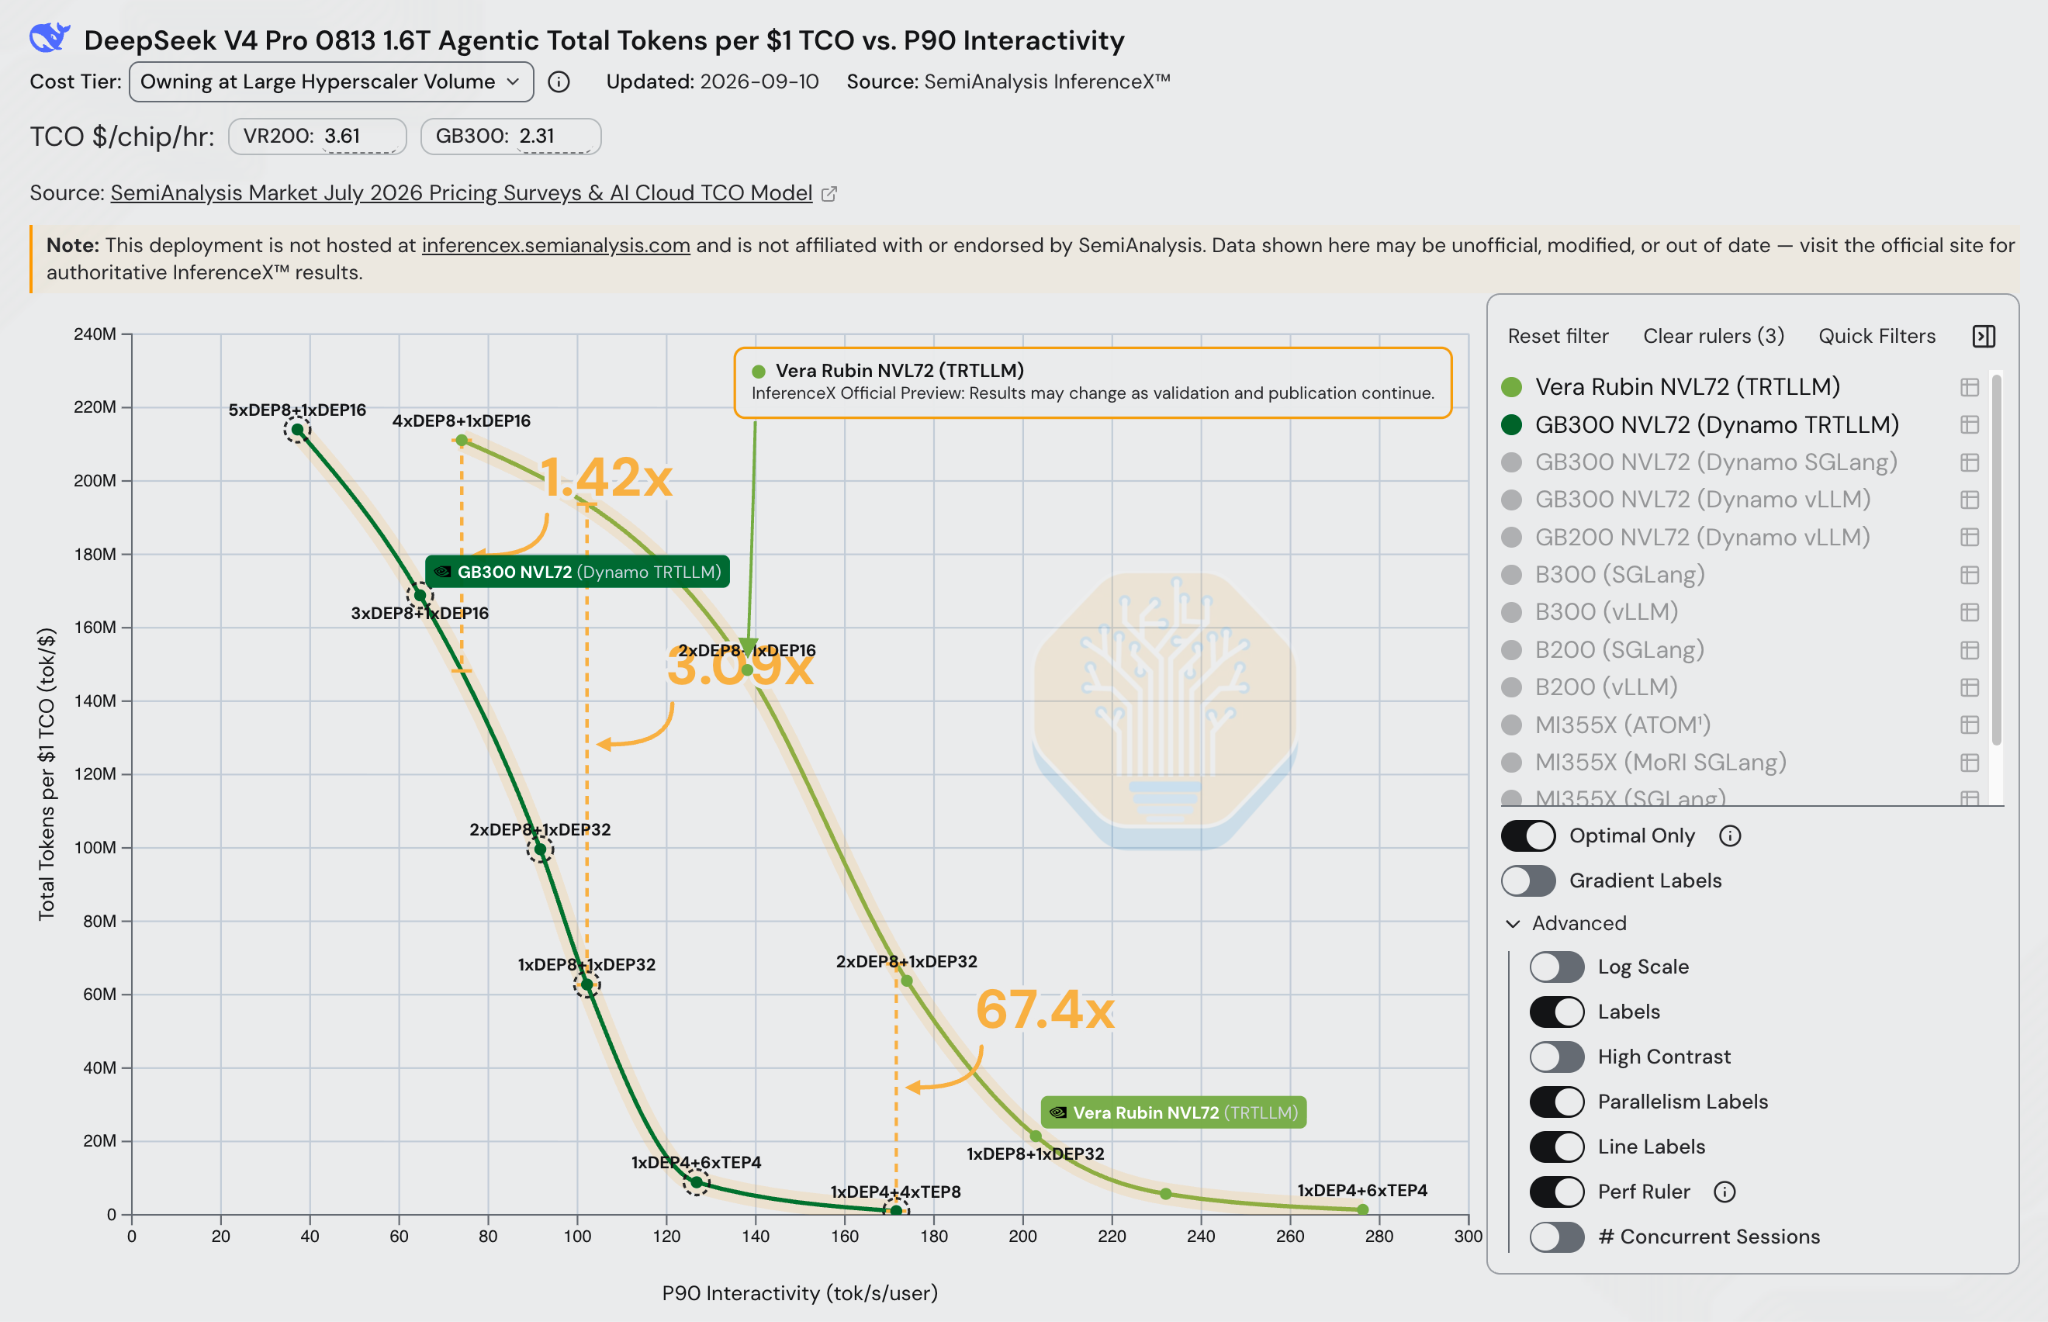
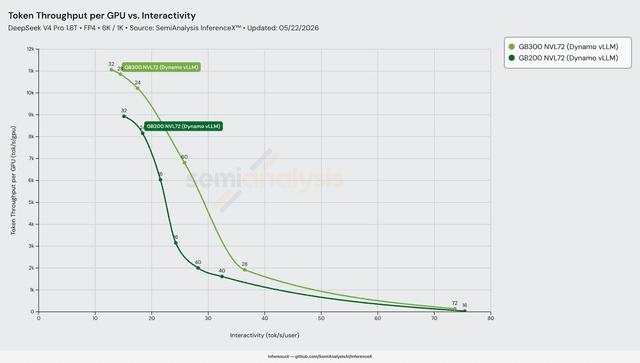
Vera Rubin 的最高 P90 interactivity 比 GB300 Dynamo TRTLLM 高约 61%,分别为 276.24 和 171.53 P90 TPS。不过,使用开源 SGLang 软件栈时,GB300 可达到与 Vera Rubin 相近的 interactivity。
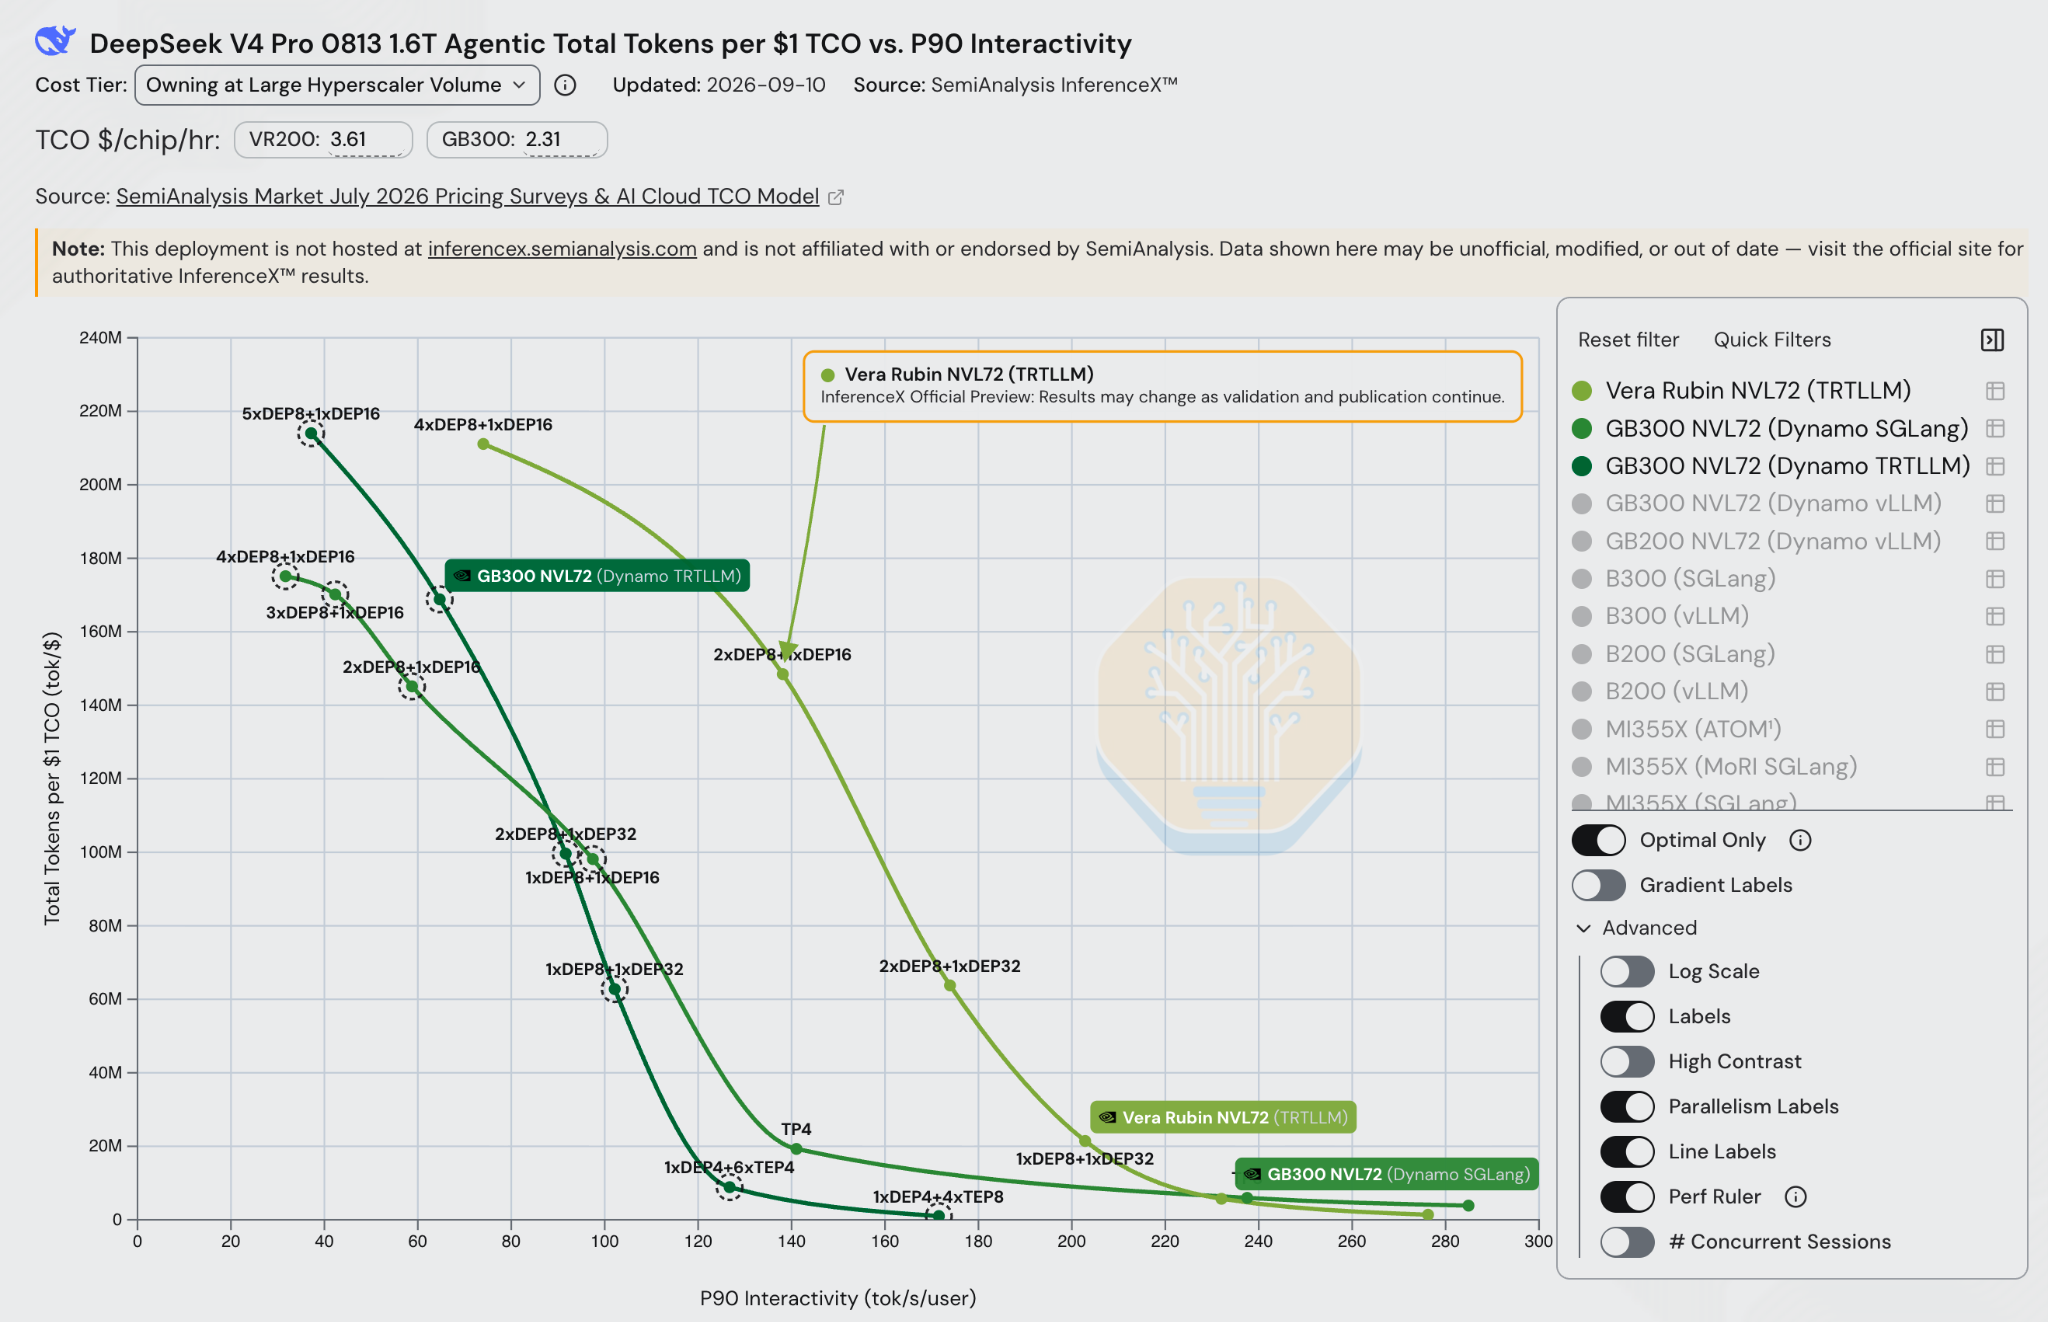
我们清楚,这还是早期预发布版 TRTLLM,性能会继续提升,尤其是在前沿曲线的两端,即超高吞吐量和超低延迟区域。推动性能前沿向前发展,并展示随时间取得的进步,是 InferenceX 的最终目标。此前的 InferenceX 文章有更多讨论:
InferenceX v2:NVIDIA Blackwell、AMD 与 Hopper 对比,原名 InferenceMAX
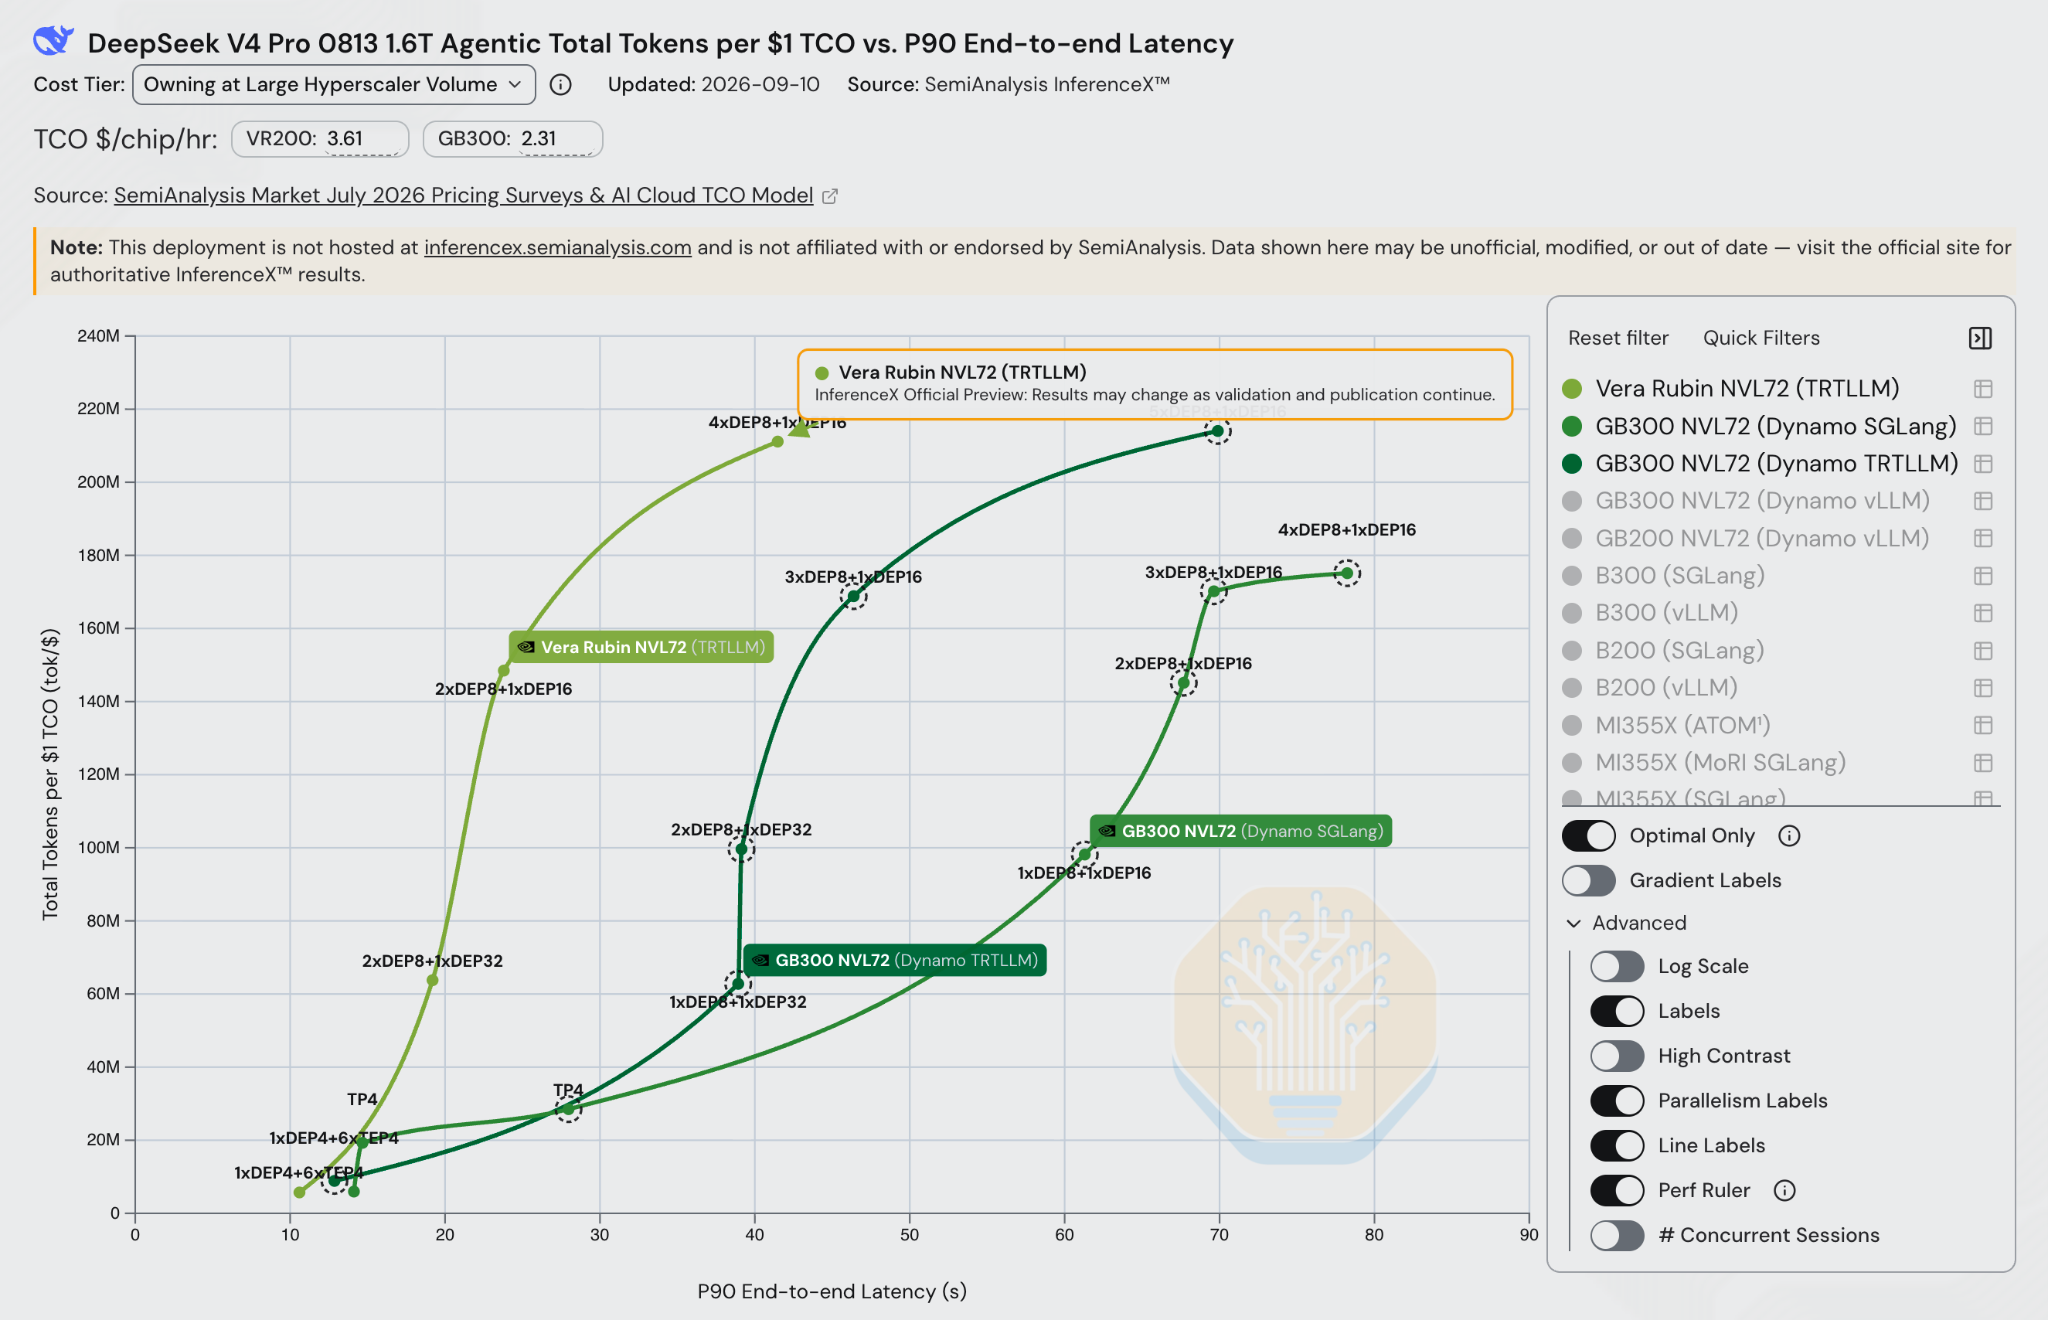
还要注意,在较高吞吐量场景下,Vera Rubin 的 P90 端到端(E2E)延迟明显更低。虽然 interactivity(TPS)经常是性能基准的头条指标,首 token 延迟(TTFT)和 E2E 延迟同样重要,也是生产推理服务事实上的 SLA 标准之一。
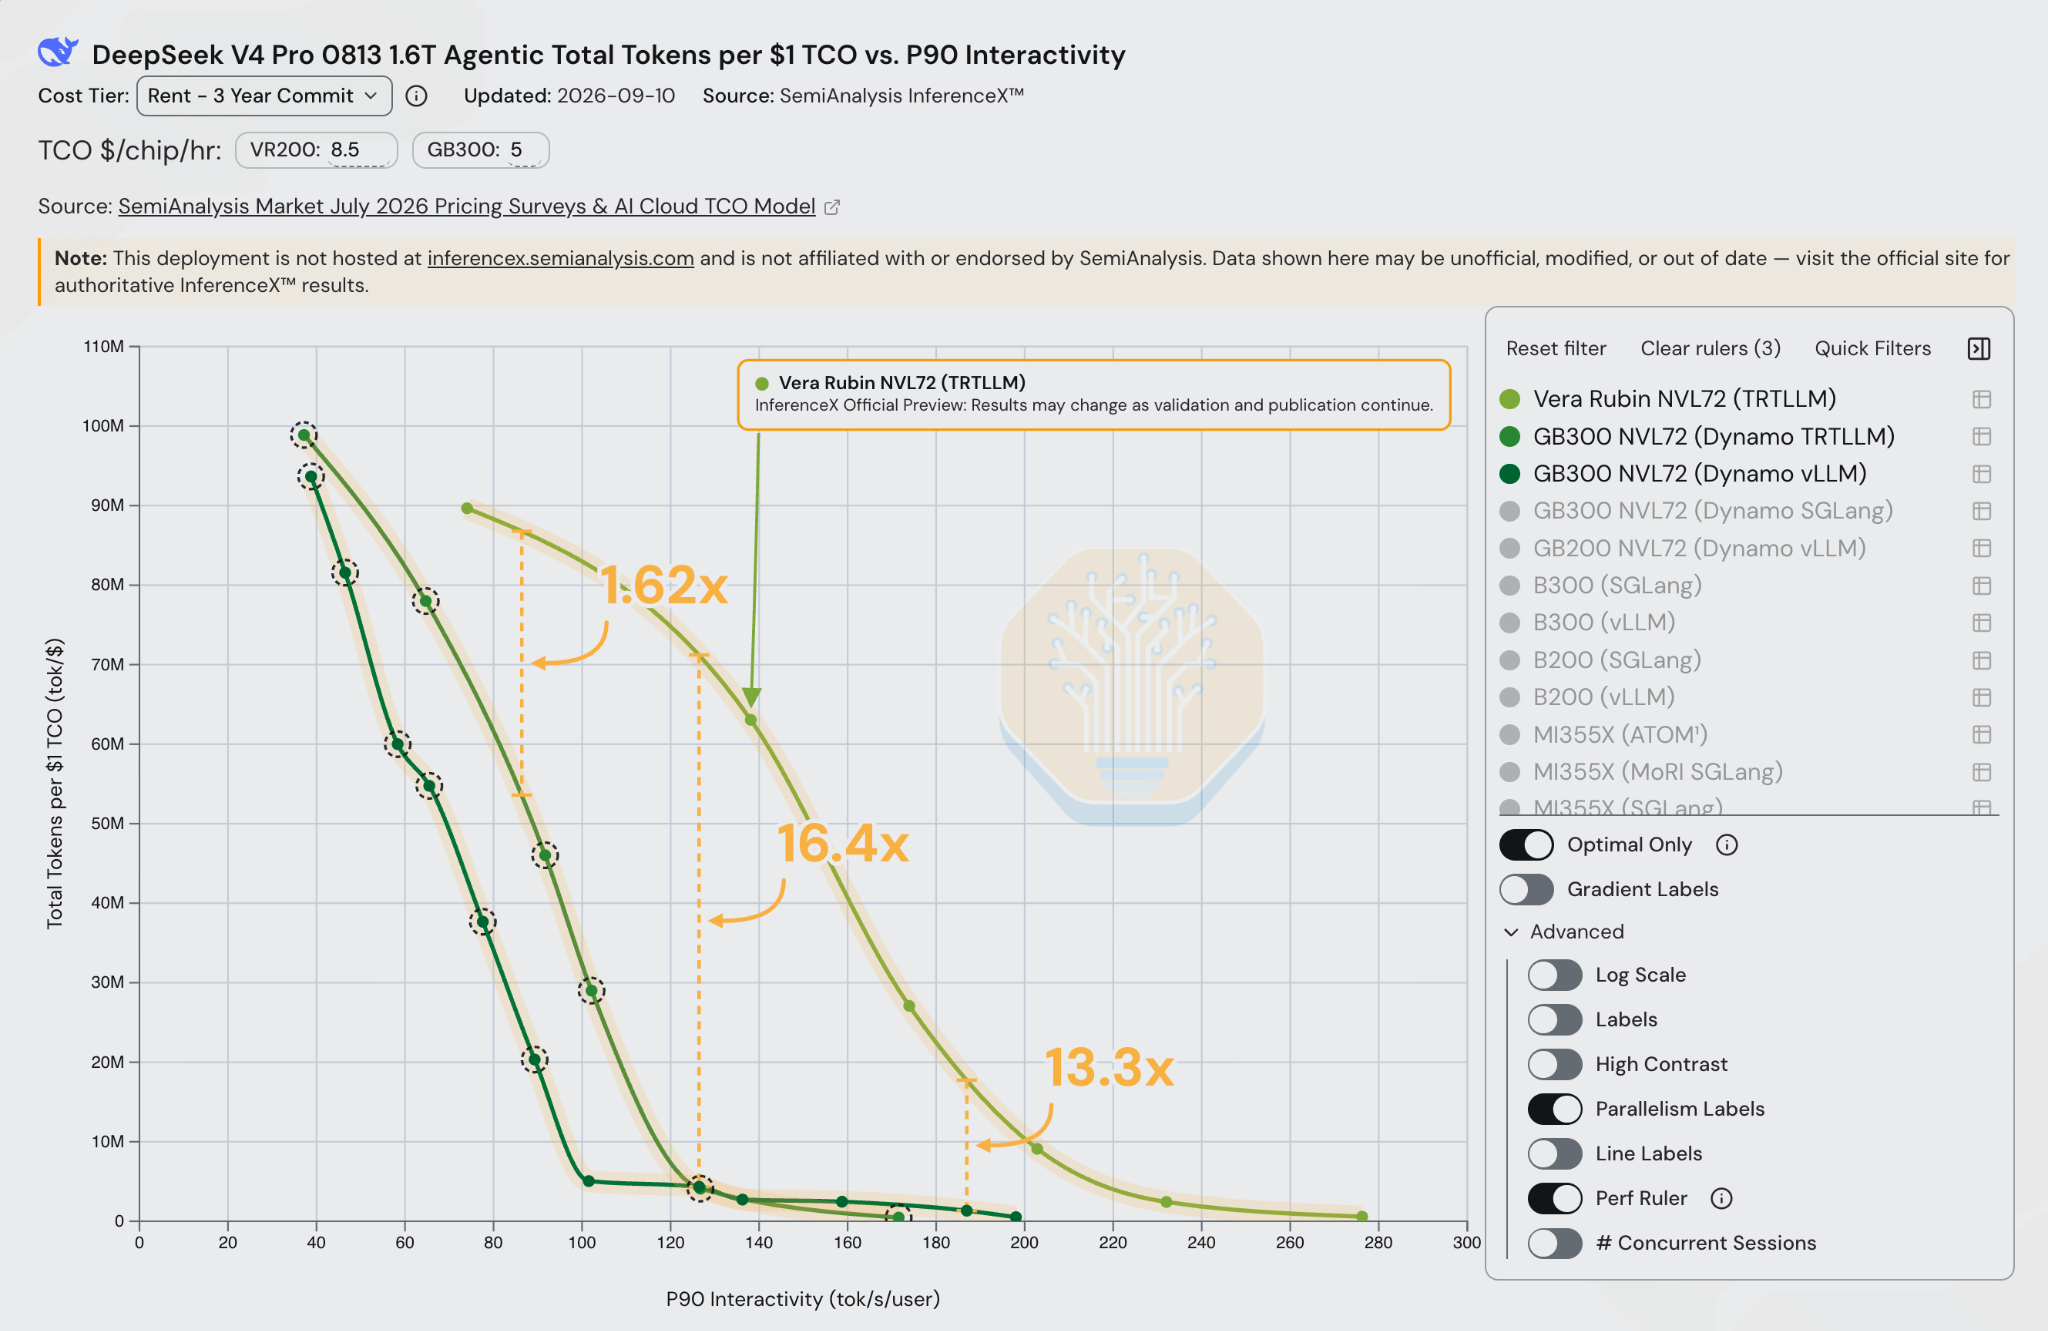
考虑三年租赁成本后,升级仍然值得。2026 年 7 月,Rubin 的三年租赁价格超过每芯片每小时 $8.5,Blackwell Ultra NVL72 为每芯片每小时 $5。在 80 TPS P90 interactivity 下,相同租赁 TCO 可让 Vera Rubin 生成的总 token 数多出 62%。在前沿曲线中 interactivity 更高的区域,Vera Rubin 的单位三年租赁 TCO token 数最高达到 16 倍。
**结论很简单:**如果有资金购买或租用 VR NVL72,就应该这样做。它生成 token 的成本明显低于次优加速器,因此能赚更多钱。用 Jensen 那句广为流传的话说:“买得越多,赚得越多。”
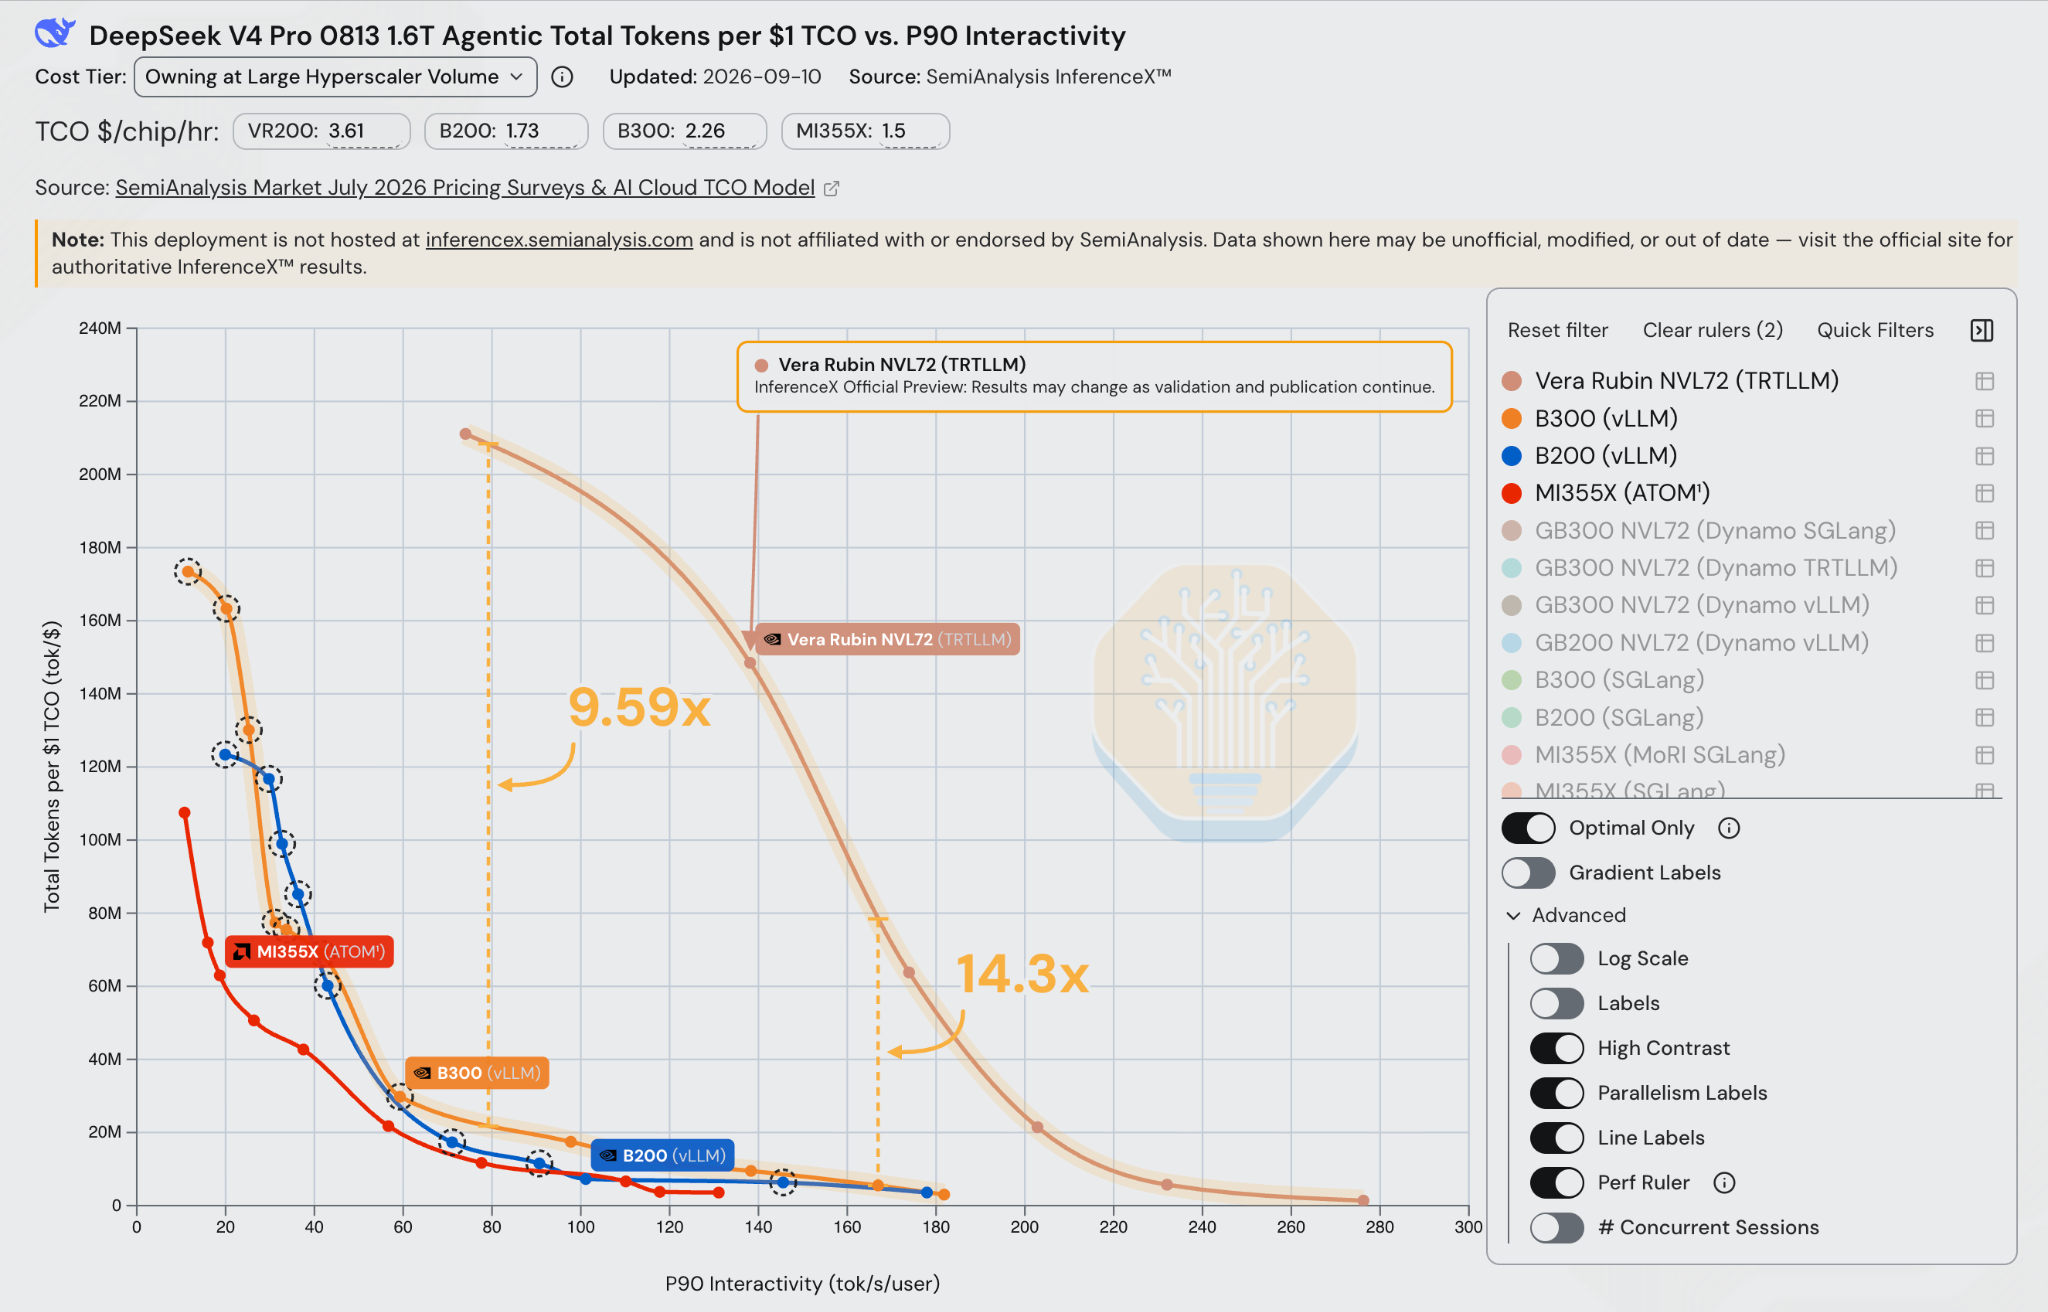
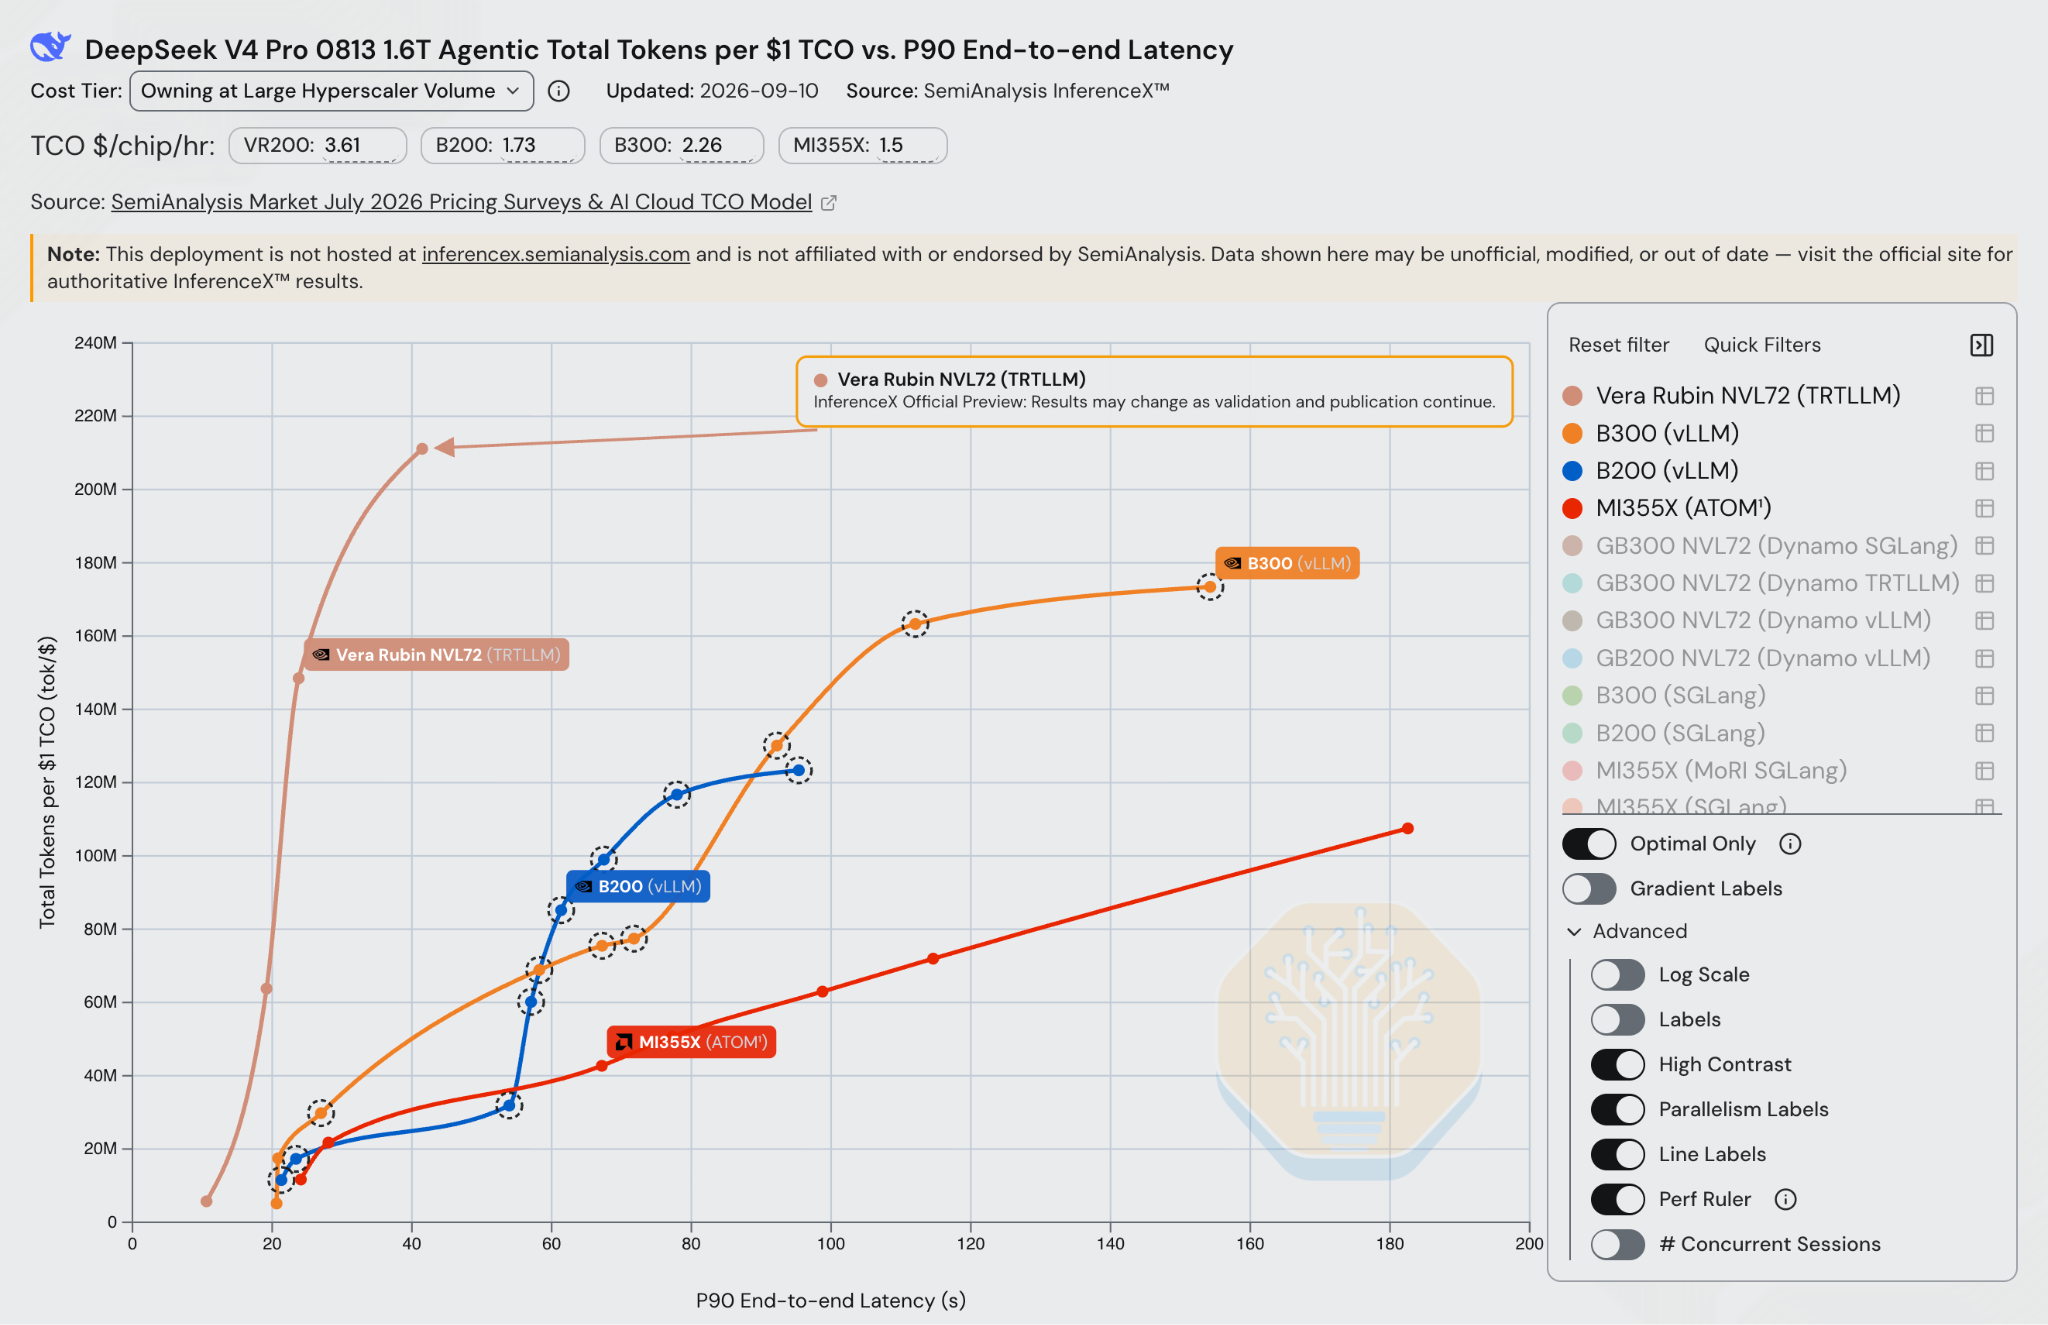
与单节点 Blackwell 和 MI355X 相比,整个曲线上的单位 TCO 性能差距进一步扩大。在 80 TPS P90 SLA 下,这对该模型来说也是很现实的目标,按自持 TCO 计算,推理服务商每美元可提供的 token 数是 B300 的 10 倍。
优势也体现在 P90 端到端延迟上。如下图,在自持成本假设下,每美元 TCO 对应 6000 万 token 时,Vera Rubin 的 P90 端到端延迟约为 20 秒,而运行最新 vLLM 软件栈的 B200/B300 为 60 秒。每美元达到 1.6 亿 token 时,差距扩大到约六倍:Vera Rubin 为 20 秒,对比系统为 120 秒。
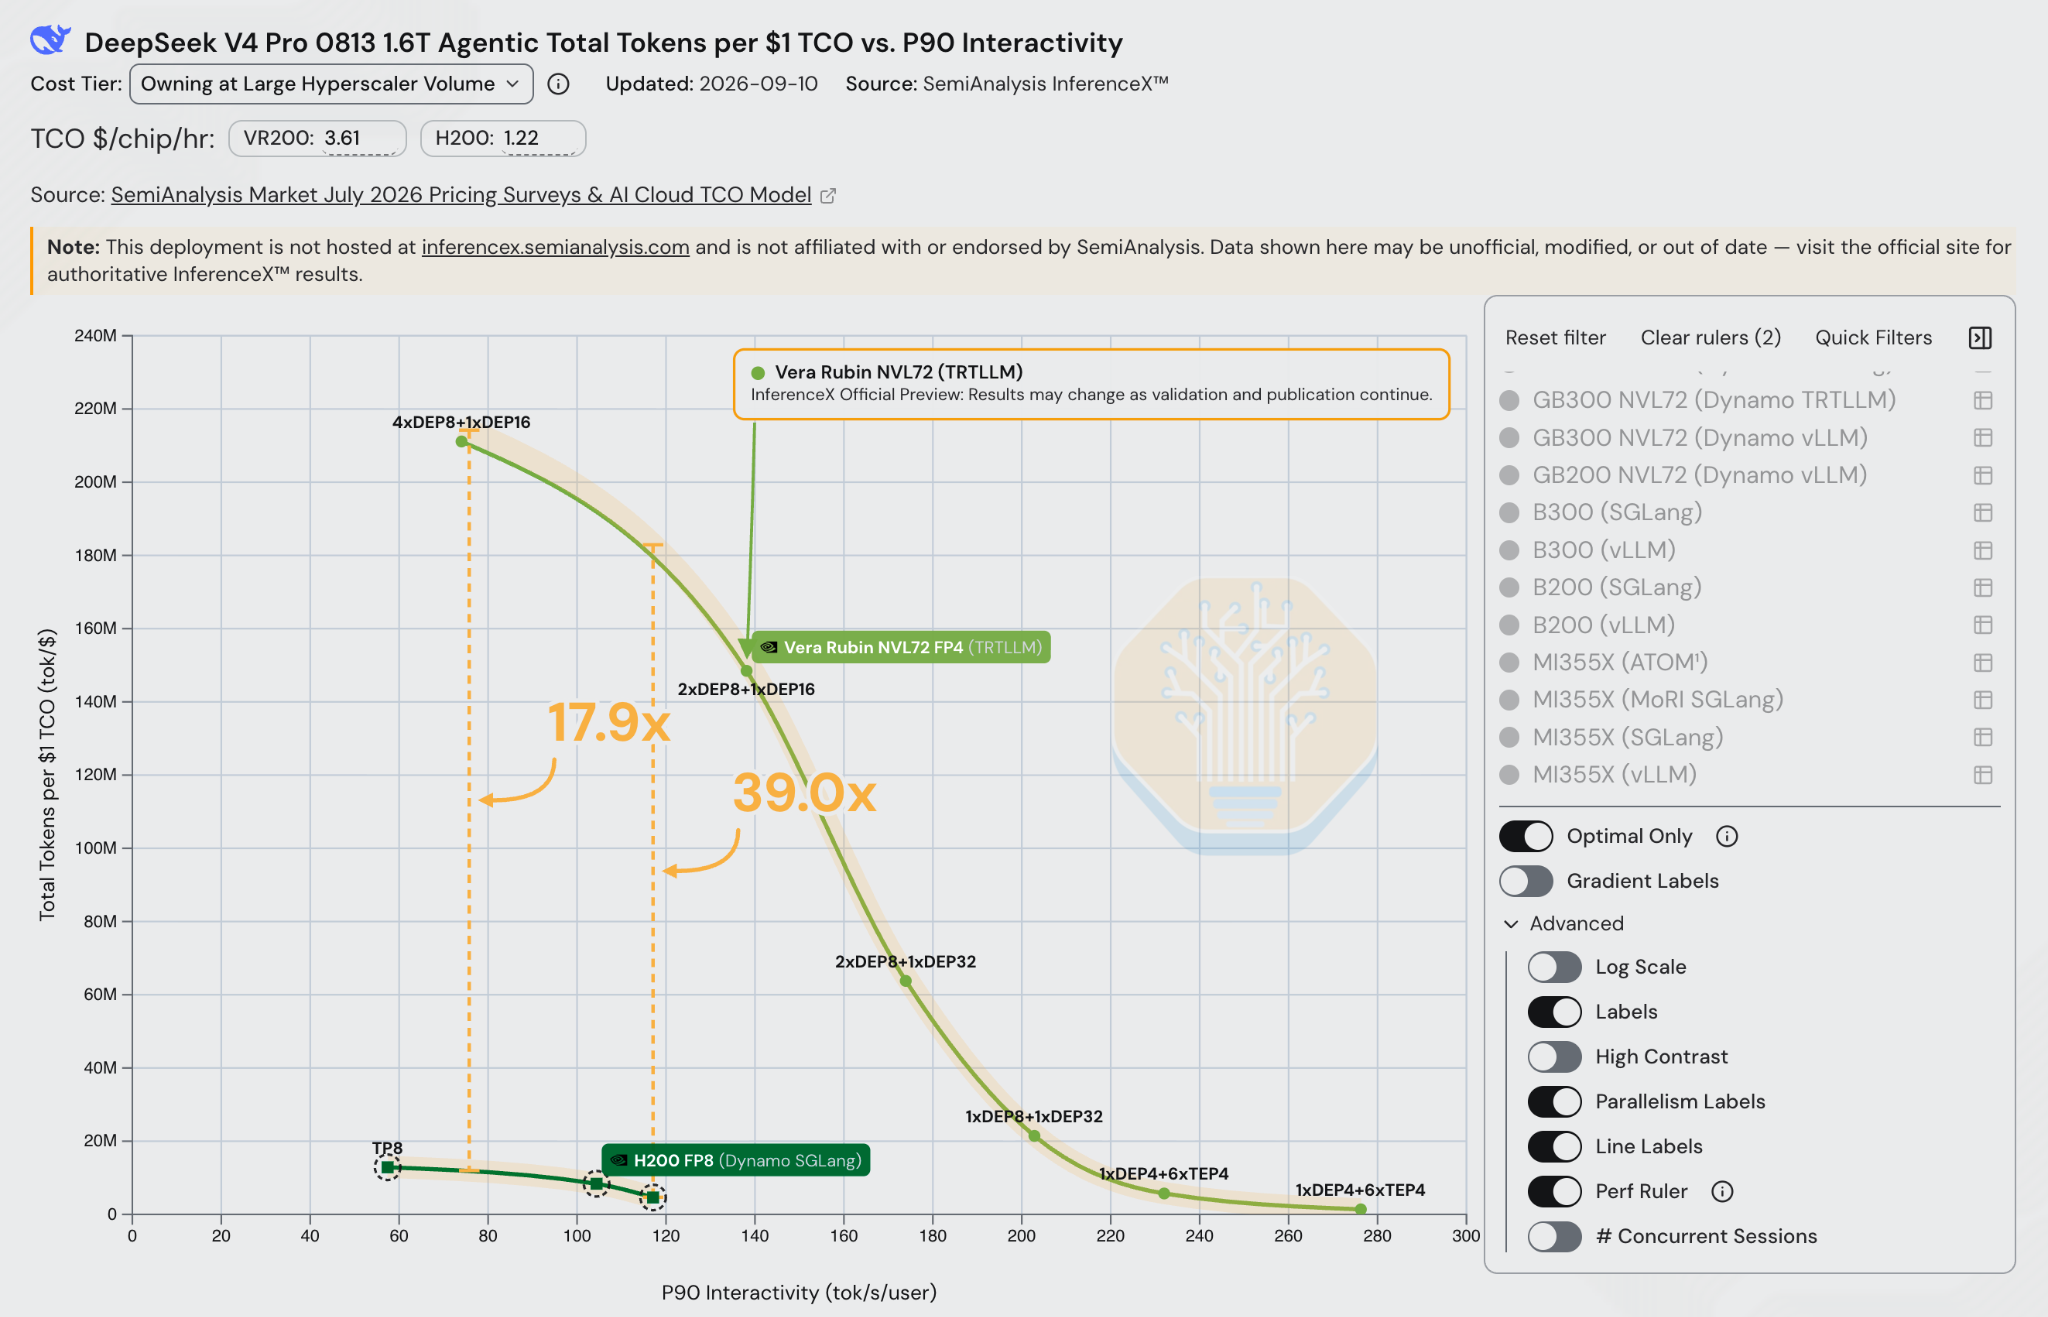
在 agentic 工作负载上,与 Vera Rubin 相比,H200 的竞争力看起来就像一台 TI-84 计算器。以 80 TPS 的 P90 interactivity 为目标,Rubin 每美元可提供的 token 数是 H200 的 18 倍;目标提高到 120 P90 TPS,优势扩大到 39 倍。Rubin 在离线批量推理中的优势较小,在训练中的优势更大,而我们看到大型实验室正逐渐把 Hopper 转用于这些负载。
Rubin 每瓦性能:Jensen 又低报了性能
能获得多少已通电的数据中心容量,往往限制着可部署的芯片数量,因此能效非常重要。每吉瓦生成的 token 越多,每吉瓦能获得的收入和利润就越高。
SemiAnalysis Datacenter Industry Model
在 GTC 2026 上,Jensen 展示了 Rubin 与 Blackwell 在大型 2T MoE 模型上的对比图,称 VR NVL72 在约 200 TPS 的万亿参数模型上,每 MW 性能是 Blackwell 的 3 倍。但 Rubin 在预发布软件上的实际性能,已经达到每兆瓦 token 吞吐量最高 7 倍的提升。Jensen 该停止在 GTC 上低报性能了。GTC 2024 发布 GB200 NVL72 时也发生过同样的事:他说它将比 Hopper 快 30 倍,而我们的实测性能是 Hopper 的 98 倍。
P90 interactivity 描述单个响应的流式输出速度,计算方式为完整响应的 P90 token 间延迟的倒数。在相同 interactivity 目标下,曲线越高,意味着相同电力预算下可承载的总流量越大。首 token 等待时间和整体响应时间仍是独立的考量,前面的延迟分析已分别讨论。
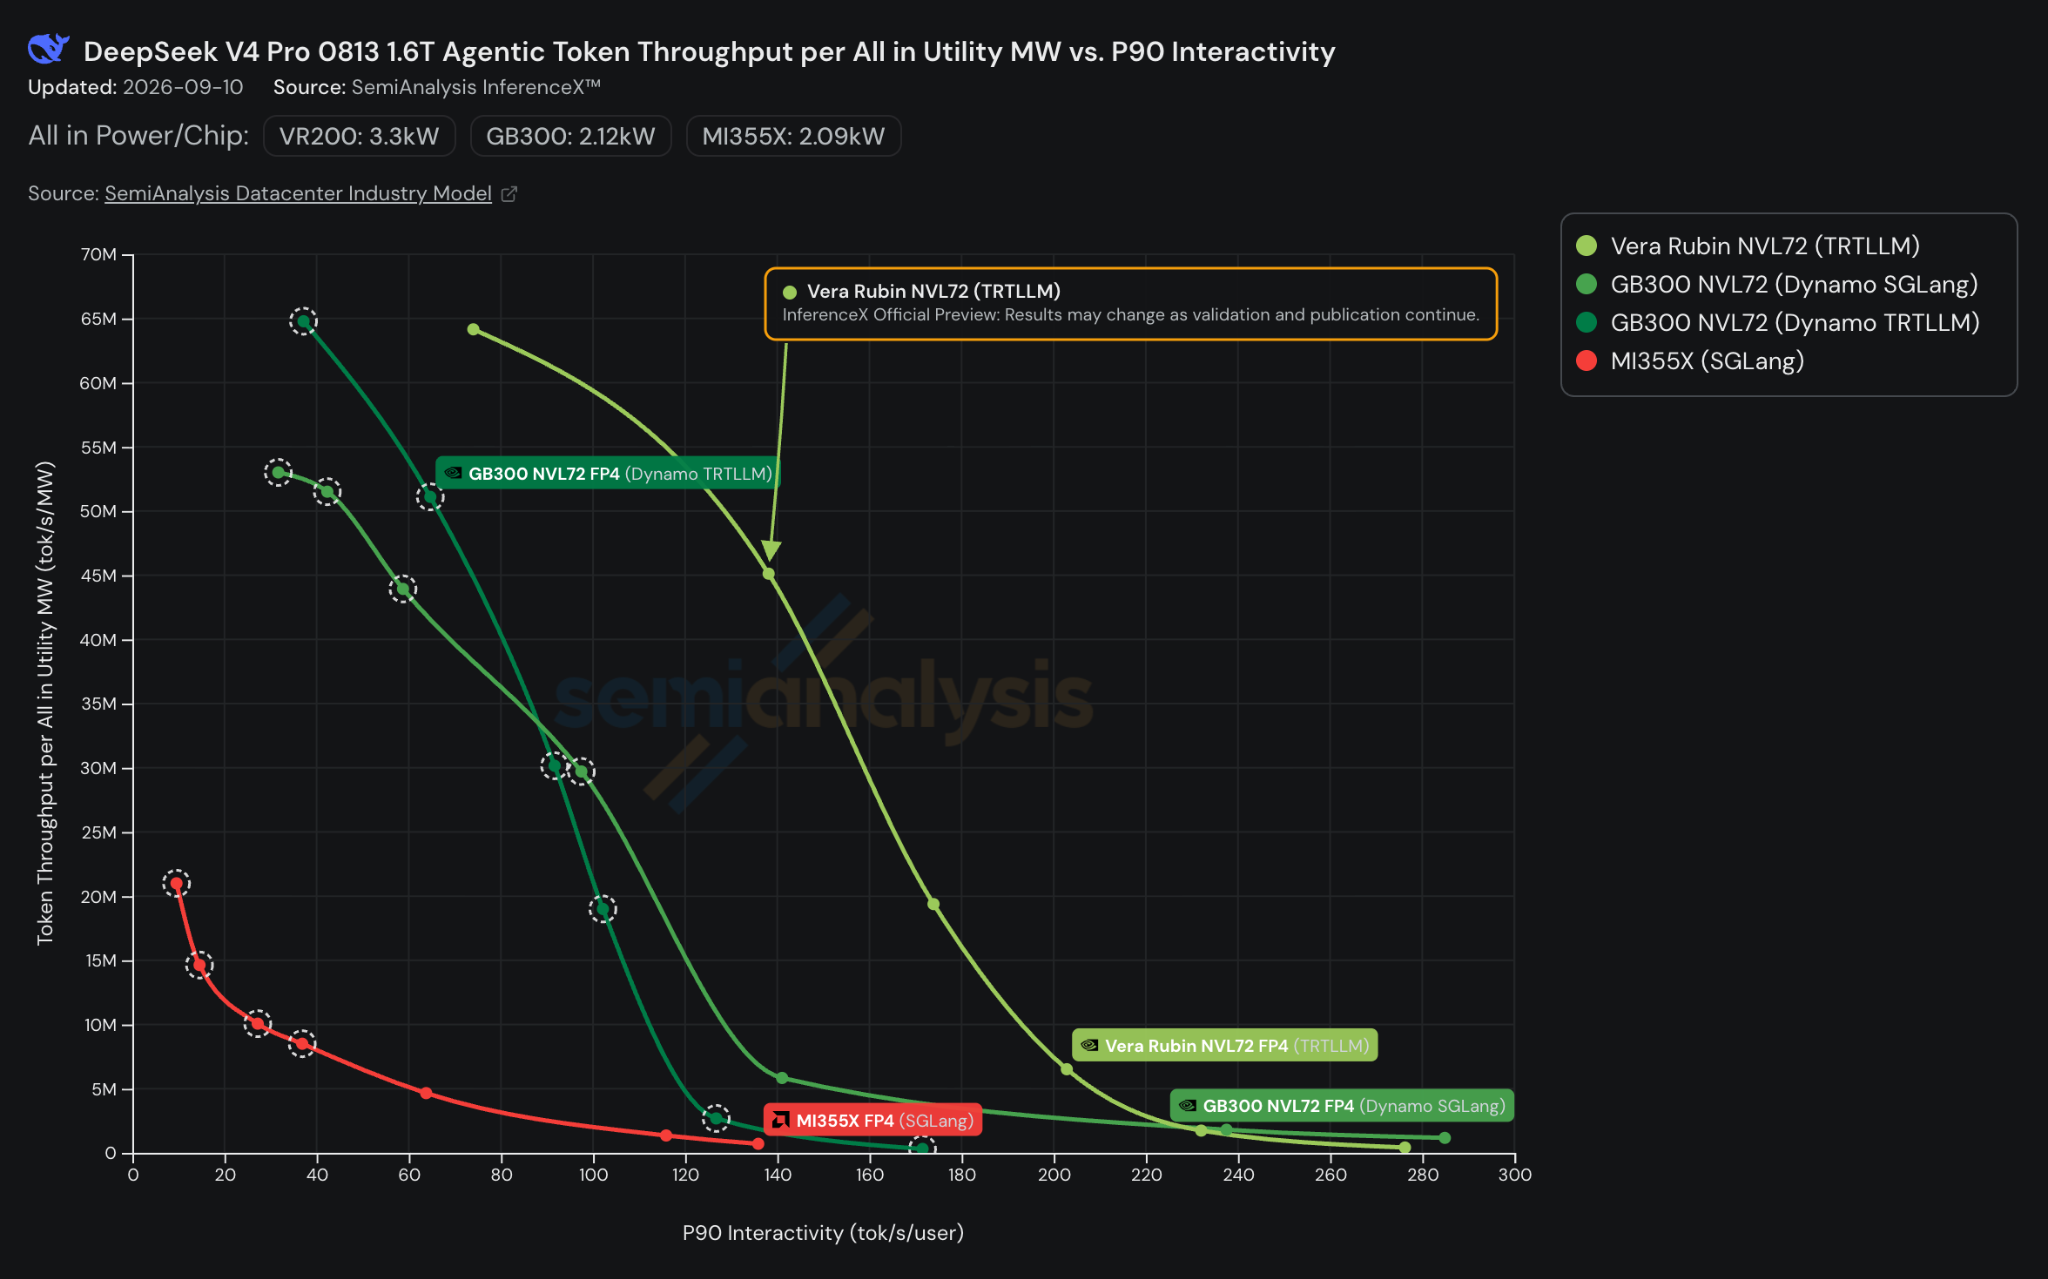
对于 DeepSeek V4 Pro agentic 工作负载,在下面对齐的目标点上,Vera Rubin 的每兆瓦总 token 吞吐量明显高于 GB300 和 MI355X。优势大小取决于 interactivity 目标和用于对比的推理引擎。
在 100 TPS 时,Rubin 约为 5940 万 total tok/s/MW,GB300 Dynamo SGLang 为 2850 万,GB300 Dynamo TRTLLM 为 2110 万。相对于该目标下更强的 GB300 引擎,Rubin 的优势为 2.09 倍。MI355X SGLang 达到 201 万 tok/s/MW,因此在这个特定负载和测试快照中,Rubin 领先 29.5 倍。SGLang 是该目标下实测 MI355X 引擎中表现最强的。
将硬件范围扩大,在 100 TPS 时,B200 SGLang 为 695 万、B300 vLLM 为 556 万、H200 Dynamo SGLang 为 226 万 tok/s/MW。H200 使用 FP8,其他对比配置使用 FP4。这些比较针对实际测量的软硬件组合,也包含各自的缓存和并行策略。
表格展示了优势如何随曲线位置变化,吞吐量单位为百万 total tok/s per utility MW。数值经过插值,即在实测点之间估算,以便在相同速度目标下比较不同引擎。N/A 表示该目标超出对应引擎的实测范围。
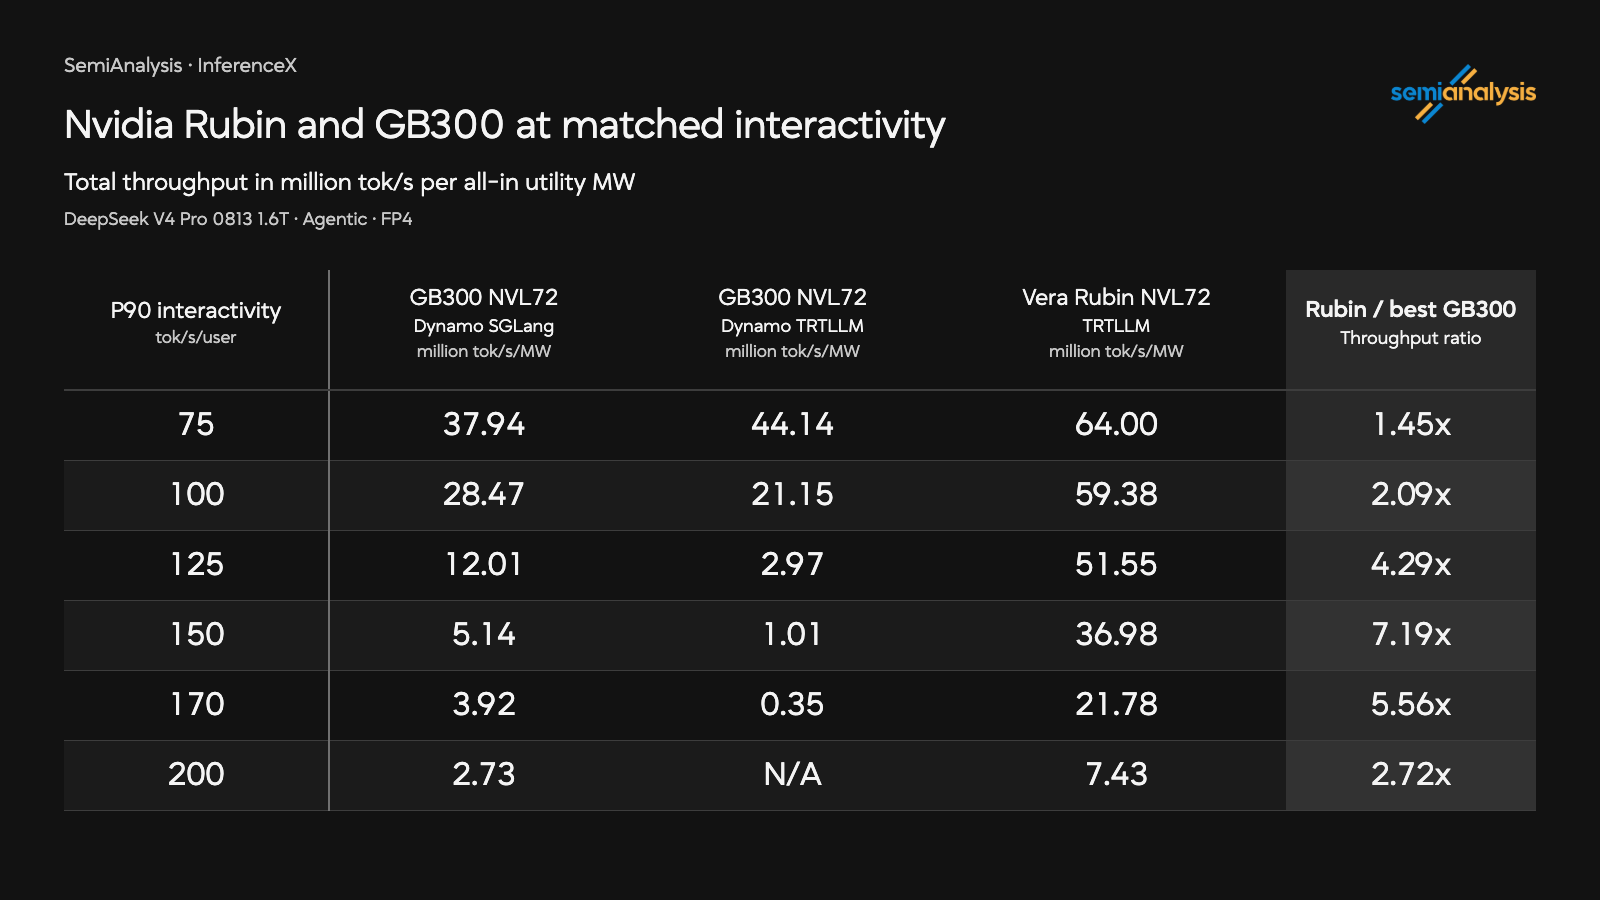
在 150 TPS 时,Rubin 仍能达到接近 3700 万 tok/s/MW,约为 GB300 SGLang 的 7.2 倍。随着速度要求进一步提高,优势随后收窄,到 200 TPS 时为 2.72 倍。最强的 GB300 引擎也随目标变化:75 TPS 时 TRTLLM 领先,而在这里展示的更高目标下,SGLang 领先。
在前面讨论的运行点附近,这个区别尤其重要。恰好在 170 TPS 时,Rubin 的每 MW 总吞吐量是 GB300 TRTLLM 的 62.9 倍,后者已接近其最快的实测端点。若在同一目标下与 GB300 SGLang 对比,倍数则为 5.56。因此,引用高 interactivity 下的提升时,必须写清楚引擎。
Rubin 的另一项特性是原生集成了名为 “DSX MaxLPS” 的动态功率调配。GPU 集群运营者不再只是按完整最大 TDP 加 10-20% 超配系数规划,而是测量当前推理负载及未来负载代理场景的实际功耗,据此在同一数据中心电力容量内放入更多 GPU。原因是推理期间,尤其在中高速输出时,GPU 并不会用满功率上限,因此可以通过数据中心范围内的智能功率调度提高 GPU 部署数量。我们即将把 PowerX 集成到 InferenceX 中,以更细粒度地测量每吉瓦吞吐量。
每吉瓦年收入与利润:买得越多,赚得越多
撰文时,DeepSeek V4 Pro 1.6T 已被 DeepSeek V4.1 Flash 取代。不过,其规模使它仍可作为 O(1-3T) 参数 LLM 的参考。DeepSeek V4 Pro 采用 MIT 许可证,因此没有模型许可费。
在固定电力预算下,Rubin 的优势不仅是处理更多 token,还让运营者无需获得额外的 utility power,就能用更多容量满足付费需求。在 75 TPS interactivity、60% 利用率、无模型许可费的条件下,按完整 utility GW 口径,Vera Rubin 每年可产生 1595 亿美元收入和 1499 亿美元模型估算利润。此次年收入比较中最强的 GB300 配置 Dynamo SGLang 分别为 1149 亿美元和 1053 亿美元。因此,同样的电力配置下,Rubin 的收入约高 39%,模型估算利润约高 42%。
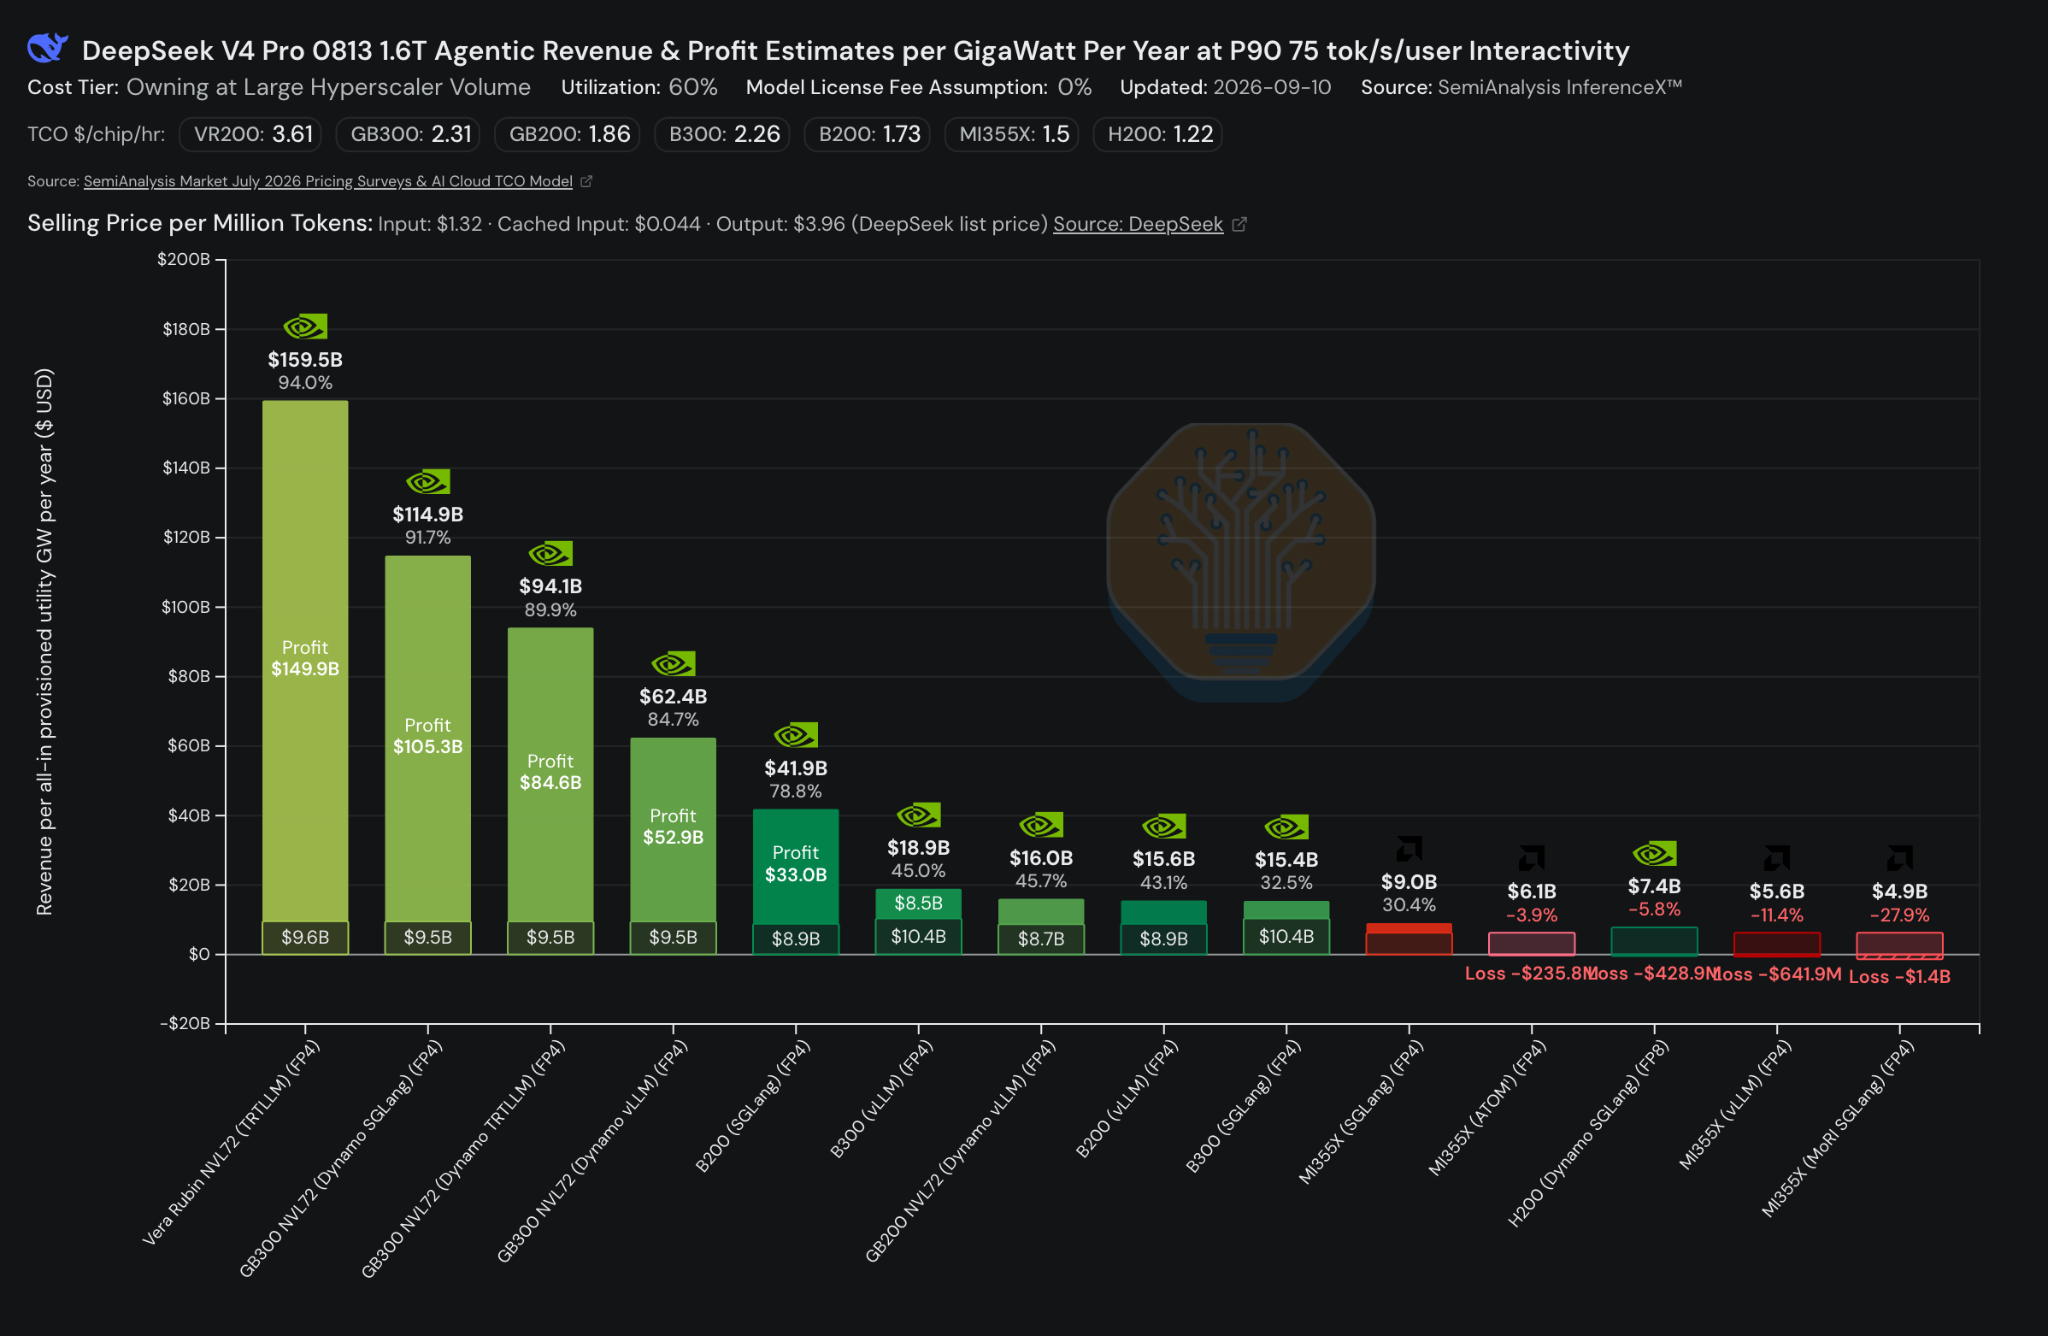
绝对差额约为每 GW 每年新增 446 亿美元模型估算利润;按线性缩放,10 MW 规模下约为 4.46 亿美元。由于这两种配置展示的每 GW 年成本相近,新增收入大部分都会计入模型中的利润。
同样的优势也带来了降价空间。在工作负载构成、吞吐量和可计费利用率不变的情况下,Rubin 可以将已缓存输入、未缓存输入和输出 token 的价格都降低约 28%,同时维持 GB300 Dynamo SGLang 按图示价格取得的每 GW 收入。运营者因此可以把效率提升保留为额外利润,或者用于价格竞争,具体取决于模型需求的价格弹性。
下面,我们将讨论每一代 NVIDIA 芯片的集群在整个生命周期内能够产生的总收入。
在 SemiAnalysis 继续阅读订阅者专属的集群生命周期分析。
本文由英文原文翻译而来,如有歧义以英文版为准。所有文章版权归 © SemiAnalysis 所有,保留所有权利。覆盖应用源代码的 AGPL-3.0 许可证不适用于文章内容。