预计阅读 9 分钟
Engram 与 embedding:面向高效 DRAM/SSD offload 的协同设计
新模型架构对 DRAM/NVMe 市场的影响,DeepSeek V4.1 Flash、AgentX、InferenceX 与 NVMe 实验
- inference
- agentx
- deepseek
- +3
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
11 篇文章
预计阅读 9 分钟
新模型架构对 DRAM/NVMe 市场的影响,DeepSeek V4.1 Flash、AgentX、InferenceX 与 NVMe 实验
预计阅读 11 分钟
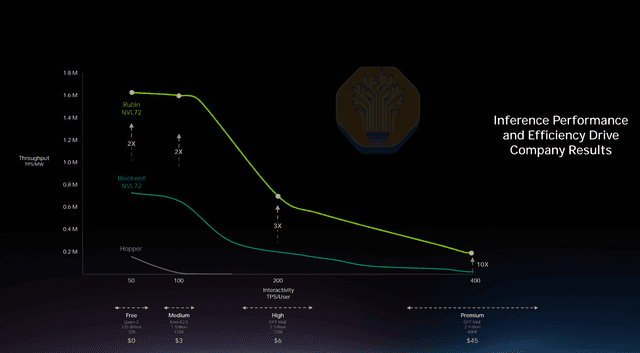
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
预计阅读 3 分钟
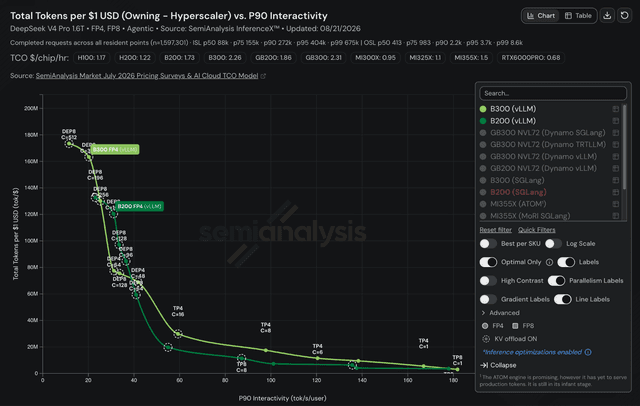
多出 50% 的 HBM 能挤出额外吞吐量,逐点遥测数据说明了它究竟从何而来
预计阅读 3 分钟
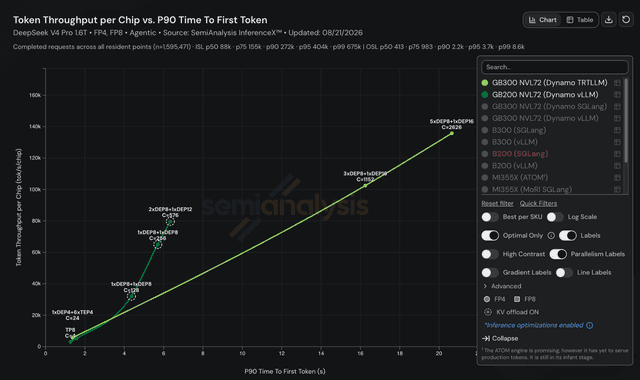
两者都依赖 PD 分离,GB300 额外使用 DEP32 宽专家并行解码,而差距体现在首 token 延迟而非 token 速率上
预计阅读 3 分钟
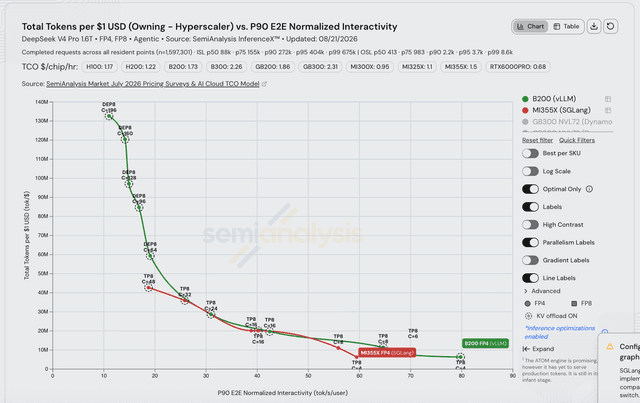
在端到端延迟的每美元性能上,AMD 一度追平 B200 vLLM,随后上游 vLLM 的优化改变了格局
预计阅读 21 分钟
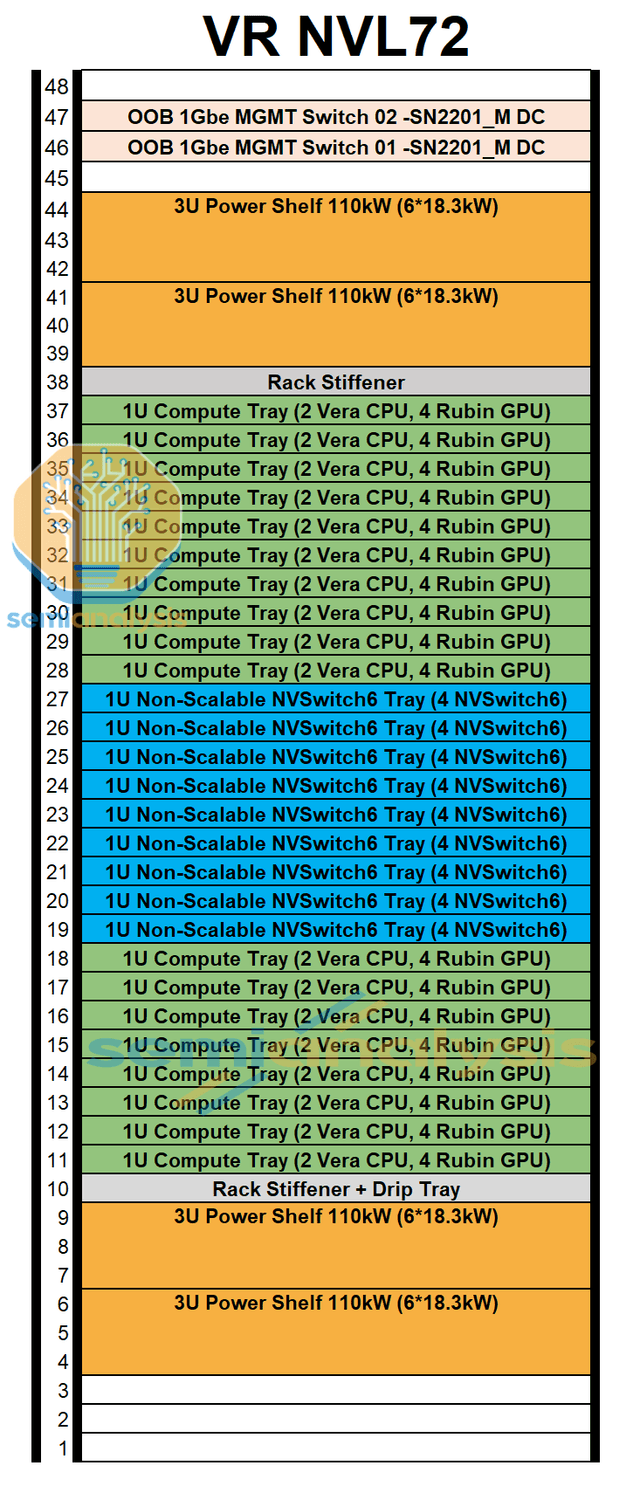
Rubin 基于 LUT 的 Tensor Core、Feynman、机架级架构、每兆瓦性能、每美元性能、软件改进、Rubin 公开软件栈、PyTorch、vLLM、OpenAI Triton
预计阅读 31 分钟
第0天推理性能、InferenceX、26天内性能提升100倍、每百万 token 成本、Huawei 950DT 推理 Trace 分析

预计阅读 11 分钟
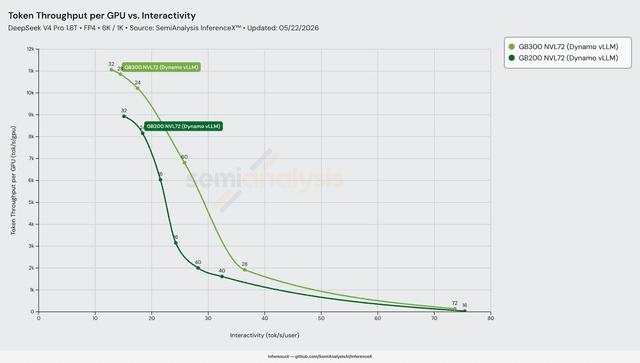
DSv4-Pro FP4 8K/1K,Dynamo+vLLM,两套机架均采用分离式部署。GB300 多出 50% 的 HBM(每 GPU 288 GB vs 192 GB)解锁了 GB200 无法容纳的更宽预填充+解码配方——尽管单 GPU TCO 溢价 20%,曲线中段性价比仍提升 2.31 倍。

预计阅读 14 分钟
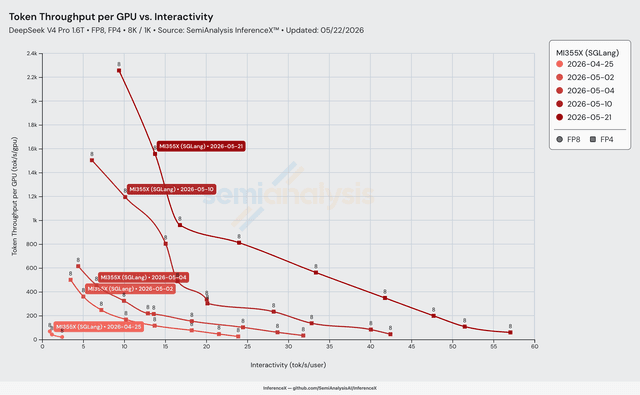
amd/deepseek_v4 分支合入了 TileLang 注意力索引器、Triton 稀疏 MLA、融合 RoPE/Hadamard、FlyDSL MoE 以及 FP4 权重,历经 31 个性能优化 PR——将首次点亮时 20 tok/s/GPU、2.4 tok/s/user 的水平提升至 8K/1K 负载下 2,256 tok/s/GPU、9.4 tok/s/user,吞吐量与交互性同步攀升

预计阅读 9 分钟
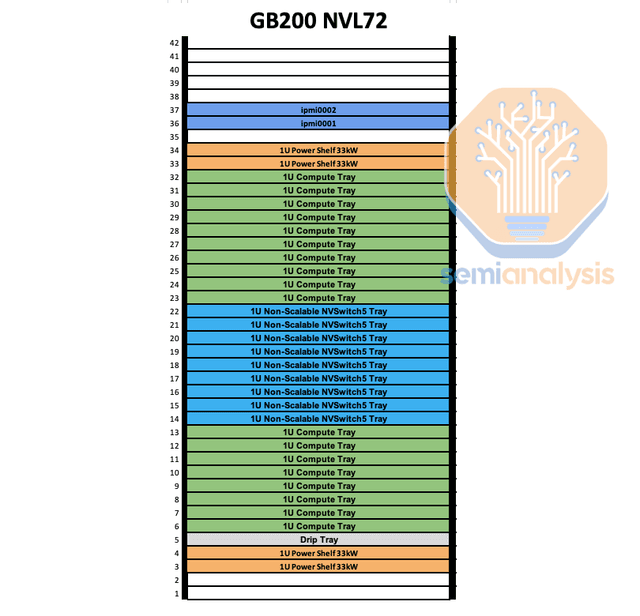
DeepSeek R1 FP4 1k/1k。NVL72 的 72-GPU NVLink 扩展域允许解码使用最高 EP=32 的宽专家并行,而 B200 的 8-GPU NVLink 岛通过 RoCEv2 上限为 EP=8

预计阅读 5 分钟
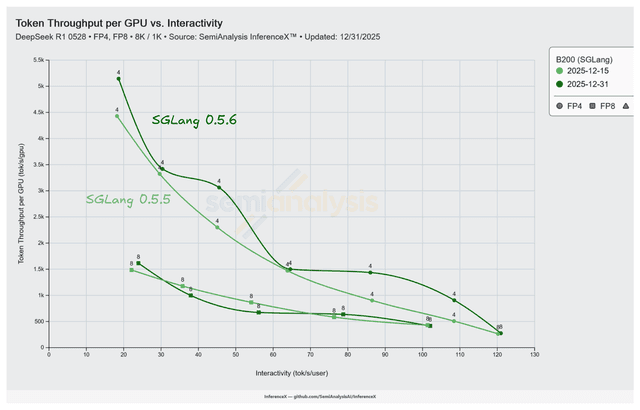
针对 DeepSeek V3 的分段 CUDA graph、统一事件循环和 JIT 内核将 8k/1k 吞吐量从 508 提升至 907 tok/s/GPU,使用相同的 16 GPU B200 资源池