本文最初于 2026-03-31 发表于 SemiAnalysis newsletter,作者为 Kimbo Chen、Dylan Patel。
本次转载保留原文公开可读的部分。测试结果、软件可用性、预测及相关限定均属于原文发表时的陈述,不是新一轮测试,也不是当前的兼容性清单。订阅者专享的后续内容仍在原文。
Nvidia 数据中心 Blackwell GPU(SM100)带来了这一代最显著的 GPU 微架构变化之一,却没有详细白皮书。截至本文发表时,还没有公开研究从 AI 工作负载出发,对数据中心 Blackwell 的 UMMA、TMA 等 PTX 和 SASS 指令进行架构级微基准测试。
继深入分析 Nvidia Tensor Core 从 Volta 到 Blackwell 的演进之后,SemiAnalysis 投入了数月工程时间,研究 Blackwell 架构并测量原始 PTX 指令性能,以确定实际可达的性能上限,再与理论峰值对照。我们希望找到硬件单元和指令层面的吞吐及延迟限制,为 ML 系统和 kernel 开发提供参考。测试侧重深度学习工作负载中的配置,例如 FlashInfer 等常用库采用的异步内存 copy 方式。
我们的 Blackwell 微架构基准测试仓库已在这里开源。如果觉得有帮助,欢迎点一个 star。
致谢
感谢 Nebius 和 Verda 提供用于微基准测试的 B200 节点。这些节点启用了所需硬件计数器,可以使用 NCU 进行 profiling。如果所在云平台未启用 NCU,可以参考 GPU Mode 的 Mark Saroufim 提出的替代办法。我们也感谢 Dissecting the NVIDIA Hopper Architecture through Microbenchmarking and Multiple Level Analysis 与 tcgen05 for dummies 的作者,我们的代码基于他们的工作。
最后,感谢所有审阅者和外部合作者:
- Kilian Haefeli,Cohere
- Benjamin Spector,Flappy Airplanes 和 Stanford
- Neil Movva,Sail Research
- Orian Leitersdorf,Decart AI
- Hardik Bishnoi,Arcee AI
- 以及许多匿名审阅者
后续工作
本文是探索 AI 加速器底层汇编与 kernel 代码系列的第一篇。后续将测试更多 Blackwell 和 Blackwell Ultra PTX 指令,包括 EXP2 和 TensorMap 更新延迟。我们也已计划测试 TPU Pallas kernel、Trainium NKI kernel 及 AMD CDNA4 汇编。尤其是 AMD CDNA4,许多指令已有详细文档,短期内就可以开展测试。
如果希望参与底层基准测试、ClusterMAX、推理模拟器或其他技术工作,欢迎加入我们。请将简历发至 letsgo@semianalysis.com,并用 5 条要点展示突出的工程能力,附上 GitHub 仓库、YouTube 演示、网站或博客等材料。
Blackwell 特性
从 Hopper 到 Blackwell,NVIDIA 对架构进行了若干渐进改进,并改变了 MMA 相关指令的 PTX 抽象。我们在 NVIDIA Tensor Core 演进一文中讨论过其中大部分内容,主要变化包括:
- 引入 tensor memory(TMEM)存放 MMA 累加器。线程不再隐式拥有 MMA 结果,而由软件在 MMA 作用域内显式管理 TMEM。
tcgen05操作改由单个线程代表整个 CTA 发起,不再像之前几代那样以 warp 或 warpgroup 为作用域。CuTe MMA atom 也体现了这一变化:Blackwell 使用ThrID = Layout<_1>,而 Hopper 的 warpgroup 级 MMA 使用ThrID = Layout<_128>。- 支持 TPC 作用域的 TMA 和 MMA,由一对协调执行的 CTA 共同工作,在 PTX 中表现为
cta_group::2,在 SASS 中表现为2CTA。组成一个 TPC 的两个 SM 可以对共享操作数执行tcgen05.mma,降低每个 CTA 对 SMEM 带宽的需求,支持更高运算强度的 MMA 指令。后文会说明,要充分使用可用 MMA 吞吐,这种操作数共享是必要的。 - 原生支持带 micro-scaling 的亚字节数据类型。
- Cluster Launch Control(CLC) 为 persistent-CTA kernel 中的动态工作调度提供硬件支持,后续文章会讨论。
- Hopper 引入的 Programmatic dependent launch(PDL) 用于隐藏连续 kernel 的 launch 和准备延迟,后续文章会讨论。
Cluster、GPC 与 floorsweeping
从 Hopper 开始,Nvidia 数据中心 GPU 支持一项可选功能,常见名称包括 thread block cluster、CTA cluster 和 cooperative grid array(CGA),指的都是同一功能。Cluster 是 CTA 的逻辑分组,其形状和大小可以针对每个 kernel 静态或动态指定。编程模型可以利用这一层分组,例如向同一 cluster 中的多个 CTA 执行 multicast load;后面讨论 TMA multicast 时会进一步说明。
重要的是,同一 cluster 内的 CTA 保证在同一个 GPC 上共同调度。这对每个 SM 只有一个 CTA 的 persistent-CTA Blackwell kernel 有直接影响:如果 cluster 大小不能整除 GPC 中的 SM 数,一部分 SM 就会闲置。不了解文档中很少介绍的 GPC 的开发者,可能在启用 cluster 后仍按 SM 总数 launch 同样多的 persistent CTA,结果部分 CTA 被迫串行执行。
每个 GPC 中可用的 SM 数并不固定,同一芯片内不同 GPC 之间可能不同,同一封装的两个裸片之间也未必对称。半导体制造中的缺陷可能出现在芯片各处,因此 Nvidia 必须设计一种机制,将通过测试的单元以相对统一的方式暴露给软件。
我们让 Claude 编写了一个工具,通过 launch 不同大小的 cluster,并用 PTX %%smid 记录哪些 SM 出现在同一 GPC 中,反推 SM 与 GPC 的映射。得到的是 TPC 到 GPC 的逻辑分组列表。列表长度超过 Hopper/Blackwell 实际拥有的 8 个 GPC,因为部分 TPC 看起来独占一个逻辑 GPC,从未与其他 TPC 共同调度。
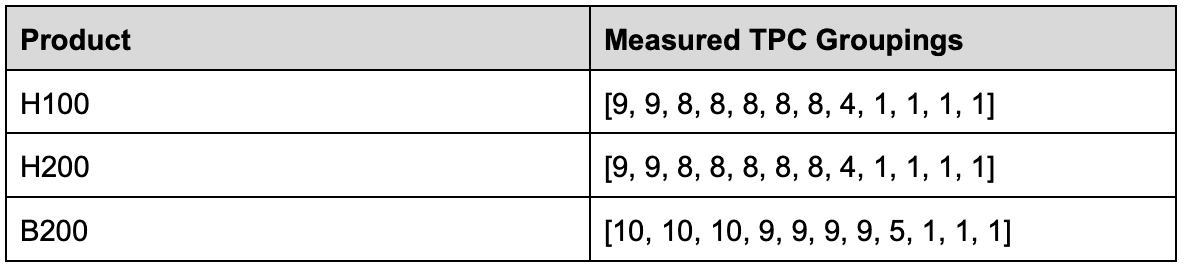
从 SM100 开始,NVIDIA 为这种分配粒度问题提供了解法:kernel 可以同时指定首选 cluster 大小和回退 cluster 大小,既获得较大 cluster 的好处,又利用所有可用 SM。通常,要用满 GPU,回退 cluster 大小应设为 2 或 1。
参考资料:
- Cluster API
- Cooperative groups API
CU_LAUNCH_ATTRIBUTE_PREFERRED_CLUSTER_DIMENSION- CUTLASS Example 73
逻辑 GPC 与物理 GPC
前面展示的 TPC 到 GPC 分组是逻辑分组,表示软件看到的 GPC,并不说明每个 GPC 的 20 个物理 SM 中哪些被启用,也不说明各物理 GPC 在两个裸片上的位置。实际中,逻辑配置相同的 B200,各 GPC 中通过测试的物理 SM 也未必相同。对软件而言看似一样的 GPU,性能可能因此有所差异。此外,逻辑 SM/GPC 分组无法告诉我们某个 GPC 位于 B200 封装内的哪个裸片。
为了进一步了解 SM 的物理布局,我们让每个 SM 遍历一个填满 L2 cache 的指针链,并测量每次 load 的延迟。针对每个地址,将一个 SM 的延迟与所有其他 SM 比较,形成 SM<->SM 距离矩阵,横纵坐标均为 SM ID。
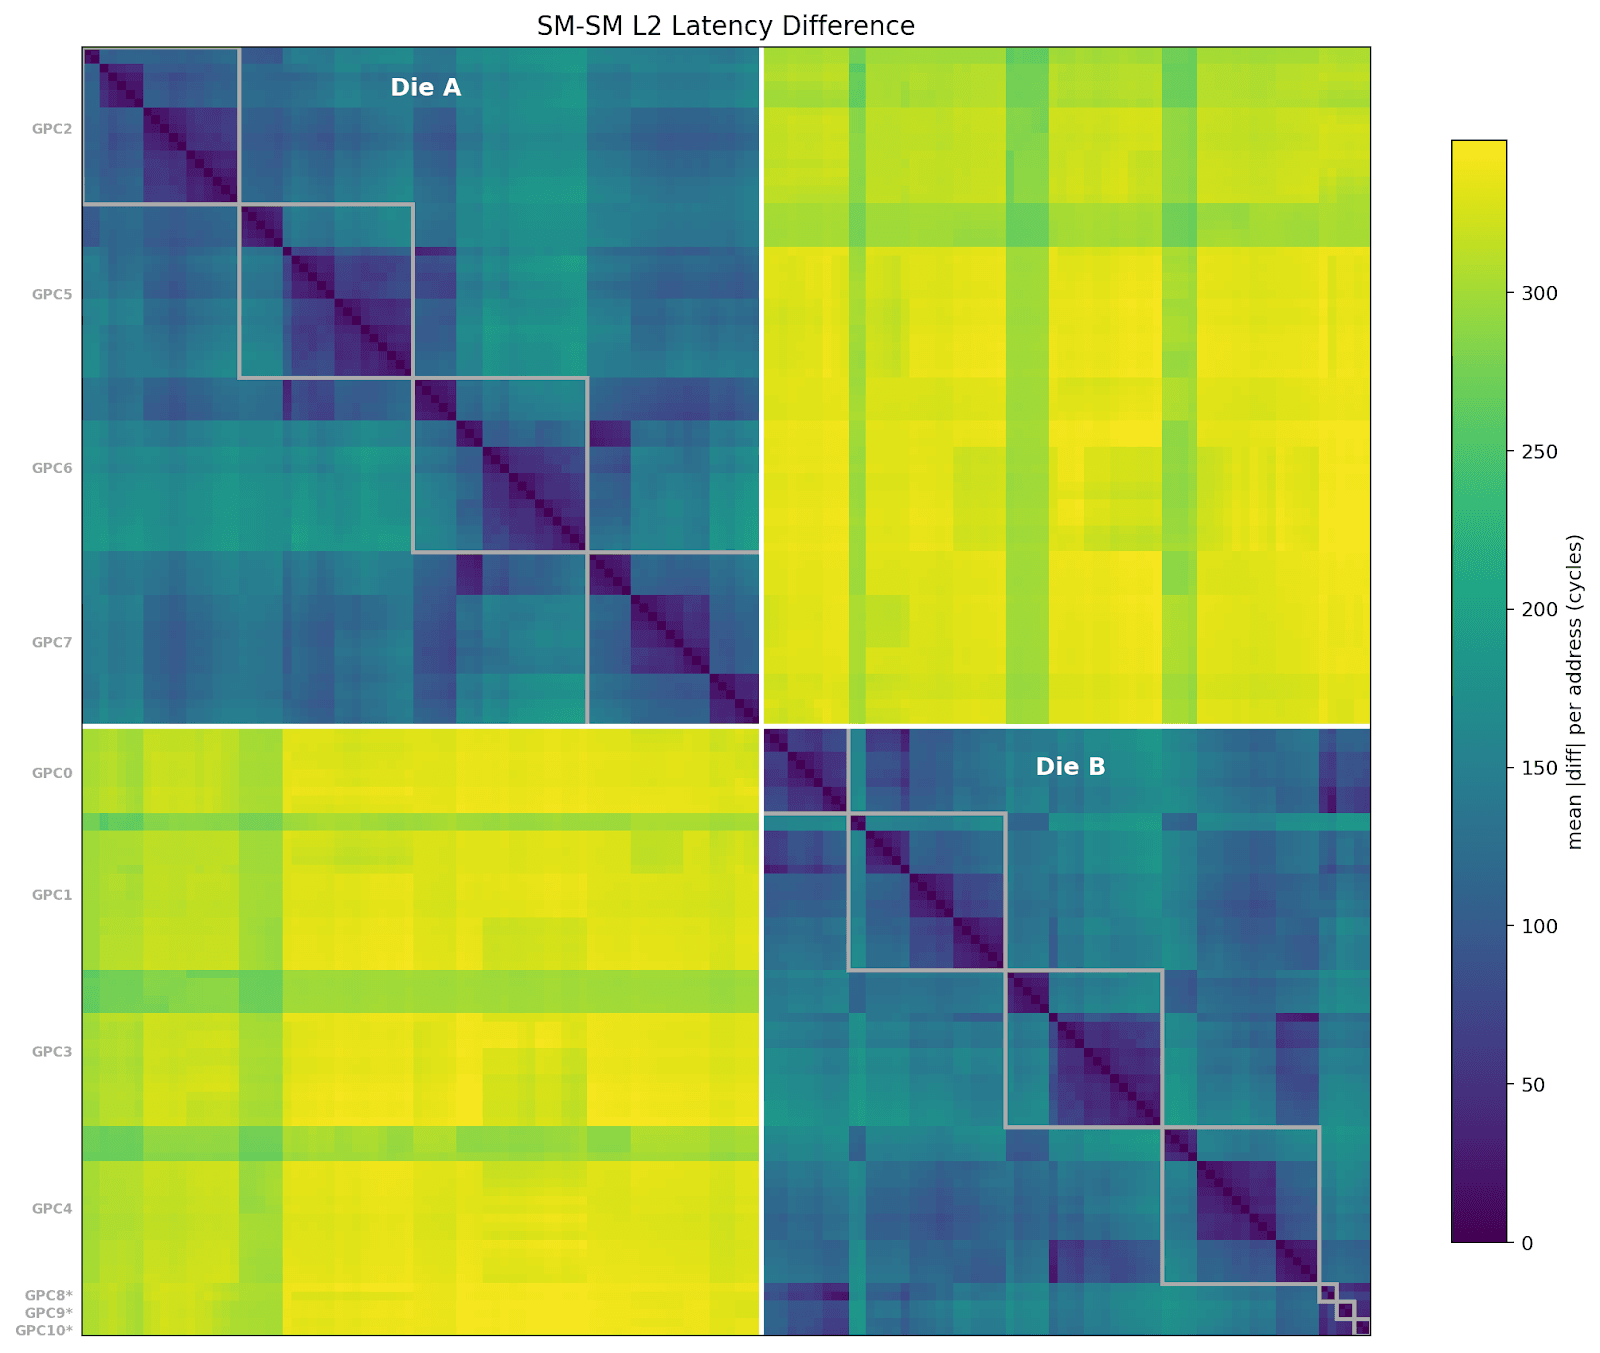
可以看到两个明显的 SM 集合,其访问 L2 的平均距离相差超过 300 cycles,这必然涉及跨裸片访问。我们还标注了上一节识别出的逻辑 GPC 分组。有意思的是,那些独立的 TPC 相互靠近,在本测试中与 GPC0 的相关性较高,因此可以猜测它们物理上属于 GPC0。
根据这些信息,可以进一步整理每个 GPC 中可用 TPC 的列表,但其中的 5+3 仍然只是猜测。
Die A:[10, 10, 10, 9]
Die B:[9, 9, 9, 5+3]
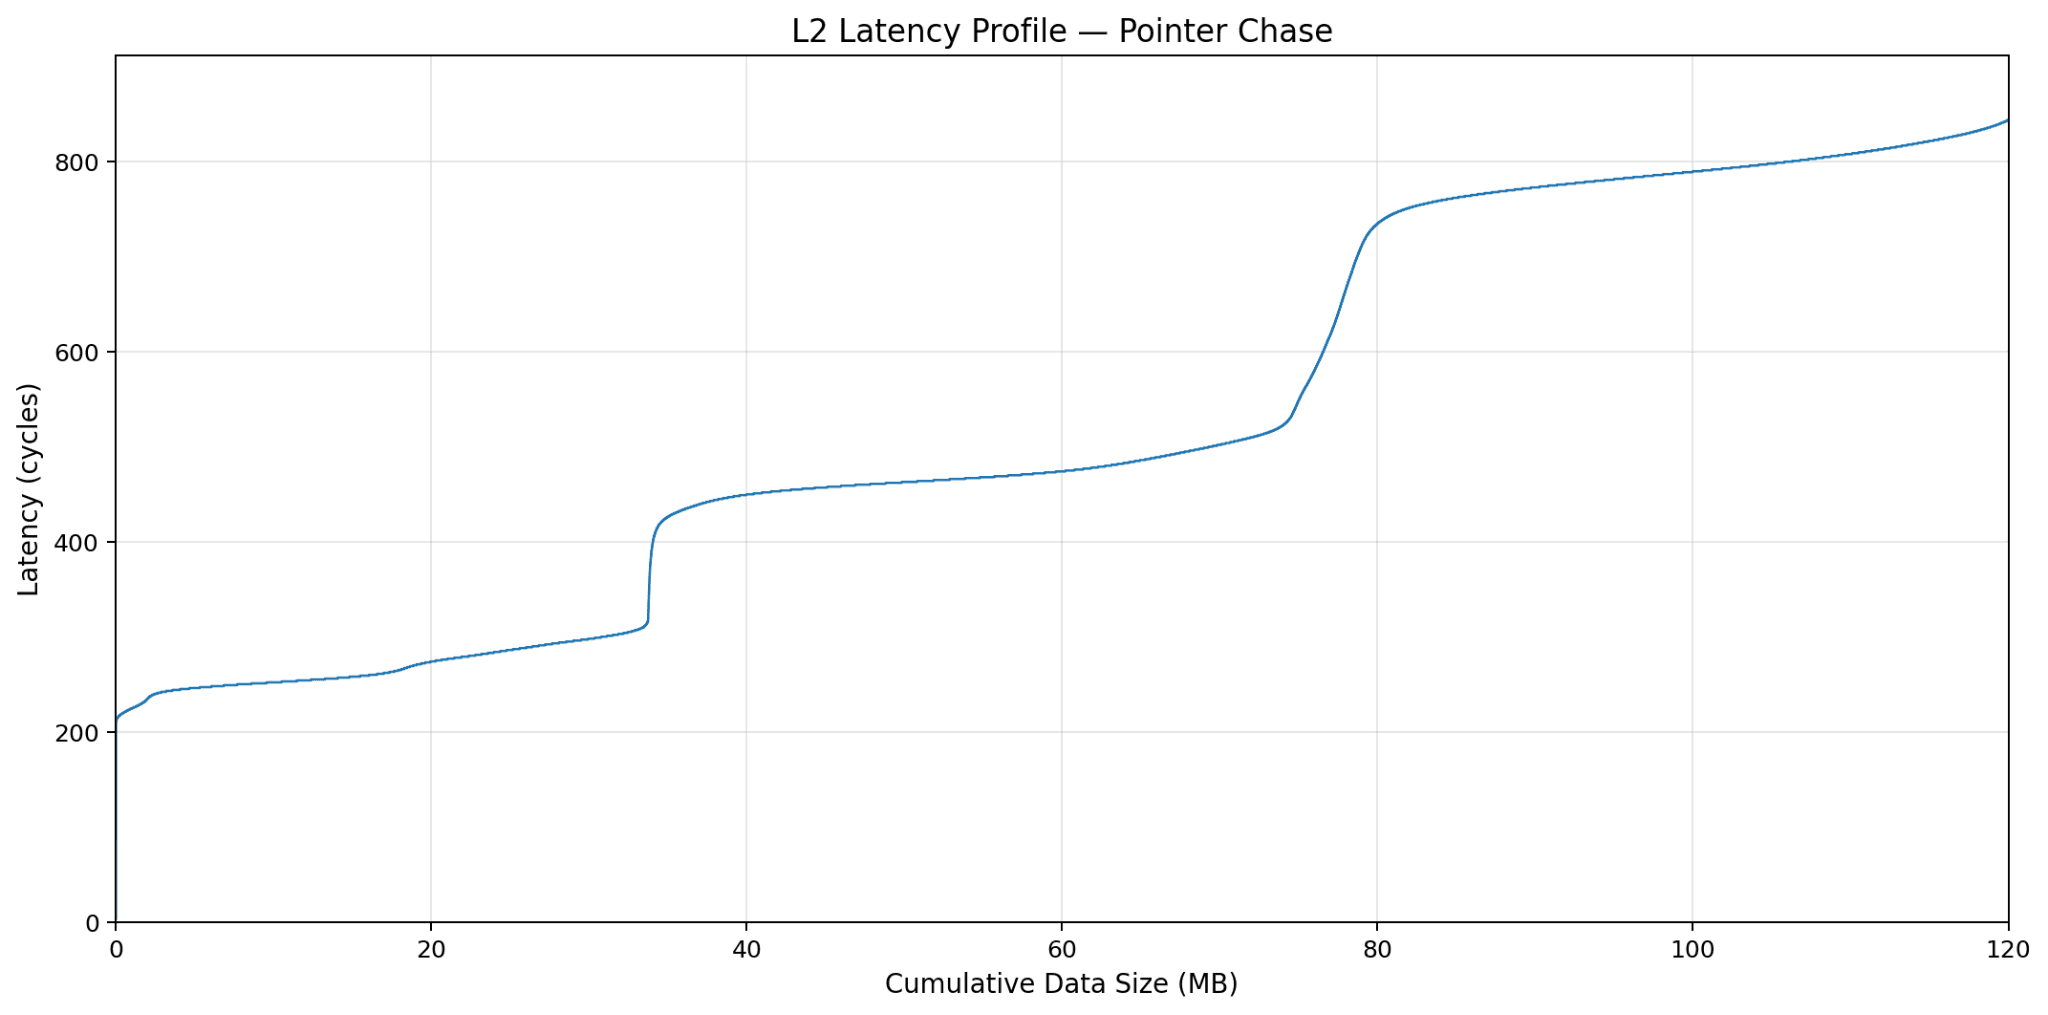
此外,通过这种间接方法,可以推断跨裸片的延迟代价约为 300 cycles。单个 SM 的延迟曲线也能看到这一点,不过其中还包含较多 L2 拥塞影响。
感谢 Decart AI 的 Orian 提供这一测试思路。
内存子系统
本节讨论内存子系统,也就是在计算单元之间搬运数据的硬件。内存 copy 指令利用这些单元工作,较新架构还支持异步 copy,异步机制的演进可见上一篇文章。这里重点研究两种异步 copy 指令:LDGSTS 和 TMA(Tensor Memory Accelerator)。
异步 copy
Async copy 在 Ampere 引入,PTX 为 cp.async,SASS 为 LDGSTS,用于异步将数据从 global memory 搬到 shared memory。它不会阻塞,因此可让 memory load 与计算重叠。数据直接写入 shared memory,不经过寄存器,也降低了寄存器压力。
参考 FlashInfer 的多头注意力(MHA)kernel,我们测试了以下配置:
- 每个 SM 的 CTA 数:1、2、3、4
- Stage 数:1、2、4
- 每个 CTA 的线程数:64、128、256
- Load 大小:4B、8B、16B
我们以每个 SM 的 bytes in flight 为横坐标绘制吞吐。它表示并发 memory load 指令正在加载的总字节数。
虽然相同 bytes in flight 下,不同 load 大小的吞吐趋于接近,我们仍更倾向于 16-byte load。它在相近 bytes in flight 下吞吐略高,且占用的执行资源更少。例如,32 KiB in flight 时,8B load 需要 4 个 stage,16B load 只需 2 个,可以少用两个 memory barrier 对象的空间,也降低指令发射压力。
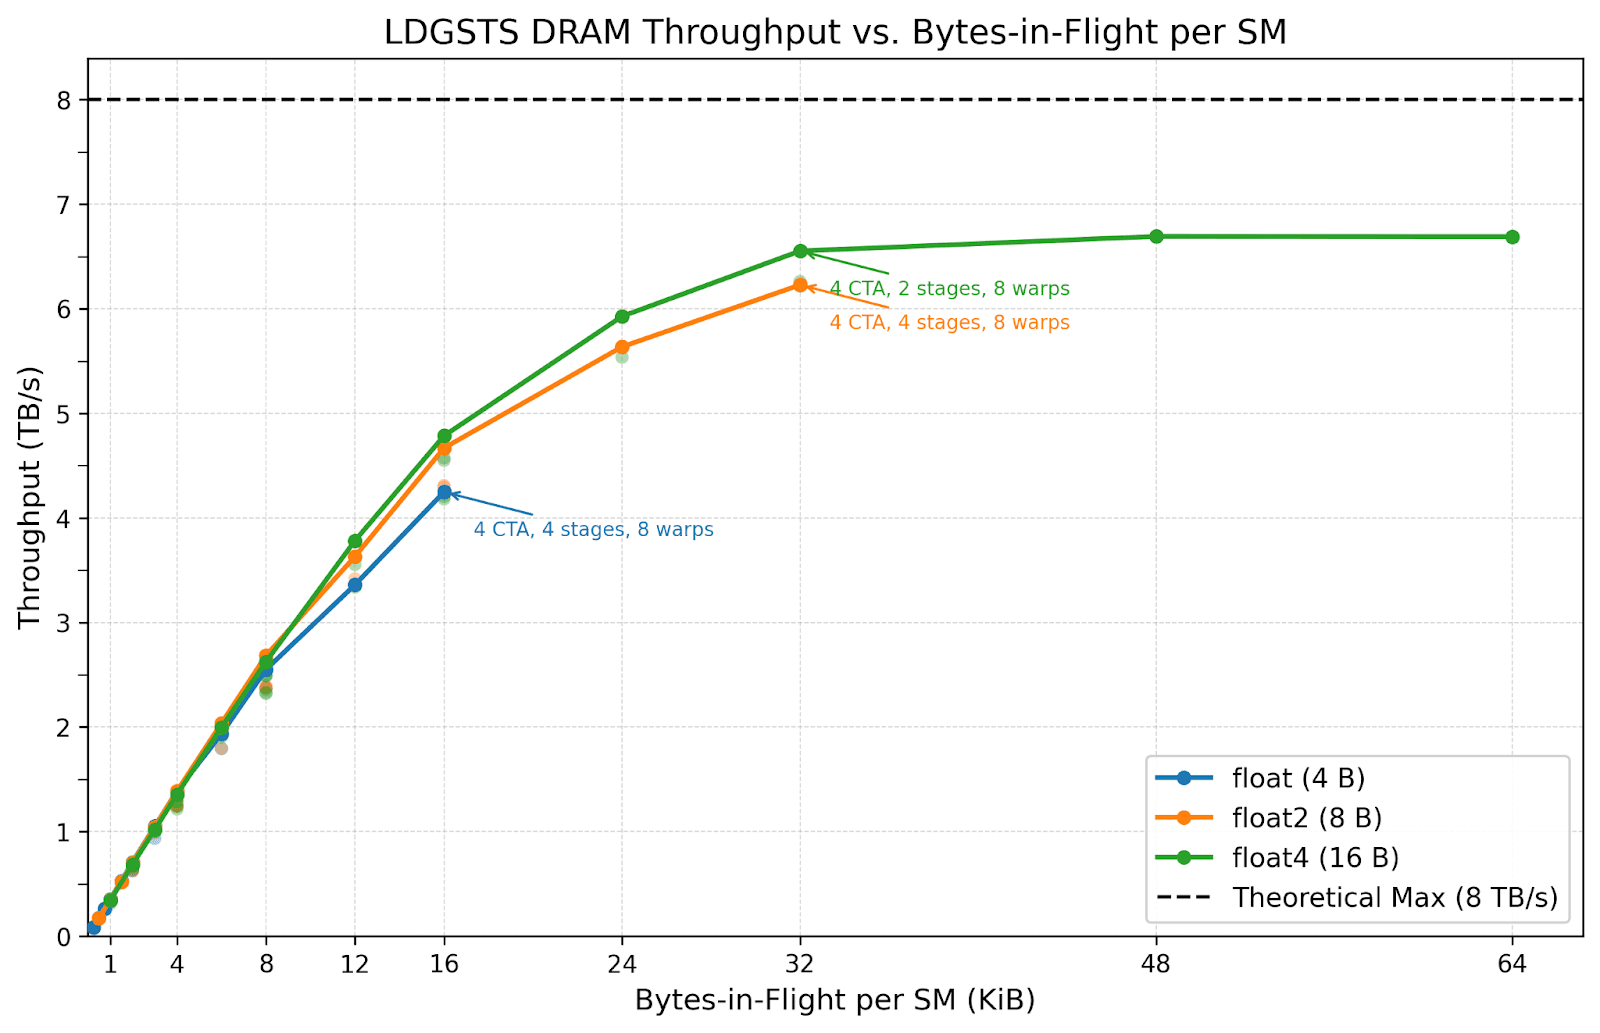
总体来看,LDGSTS 在 32 KiB in flight 左右达到约 6.6 TB/s 的带宽上限。
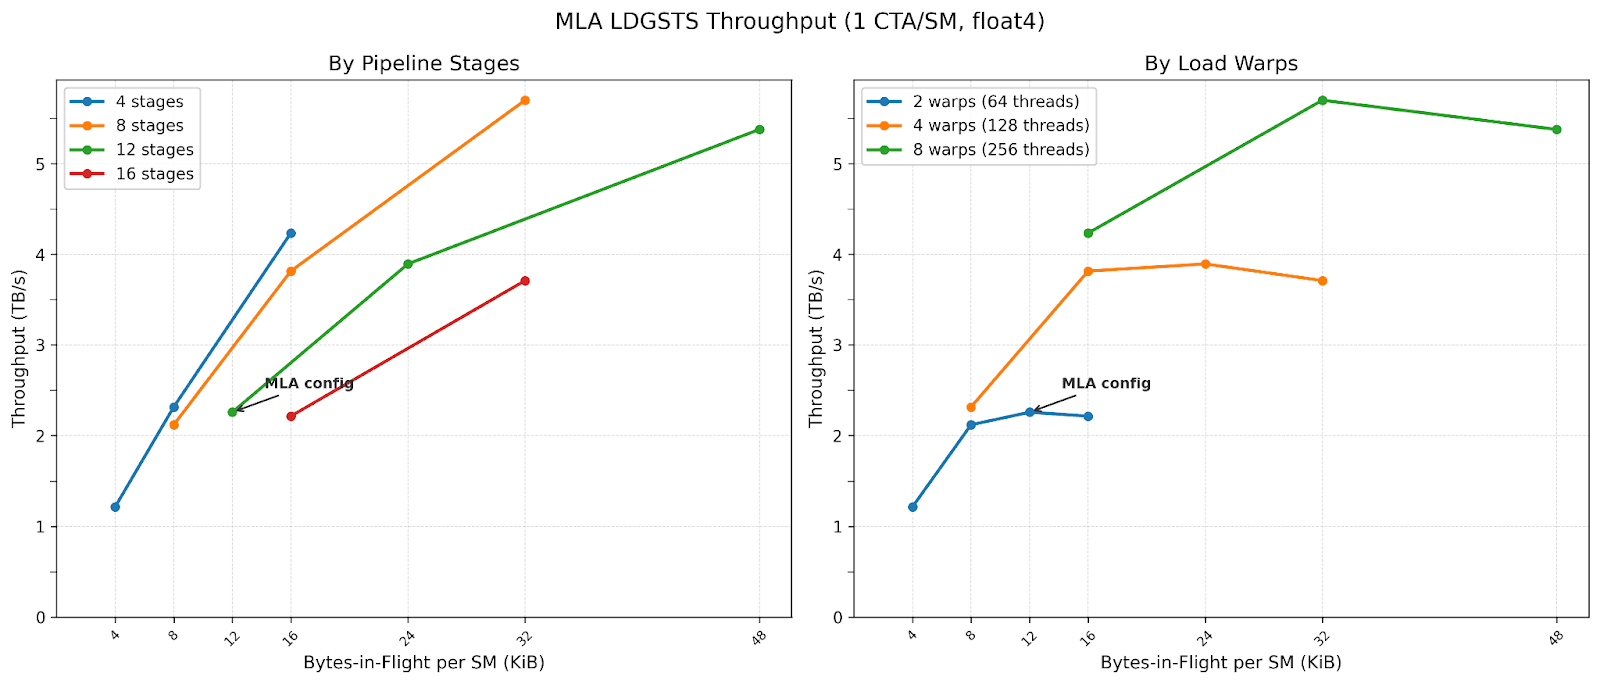
我们也测试了 multi-latent attention(MLA)kernel 使用的配置空间:
- 每个 SM 一个 CTA
- 16B load
- 每个 CTA 的线程数:64、128、256
- Stage 数:4、8、12、16
实验表明,增加 stage 数可以在更高 bytes in flight 下获得更高吞吐;在所有测试配置中,增加每个 CTA 的线程数都会提高性能。值得注意的是,MLA 使用 2 个 warp 和 12 个 stage,吞吐约为 2.2 TB/s。我们认为,这是因为 softmax warp 需要最多的寄存器,而增加 warp 数会降低每个线程可分配的寄存器数量。
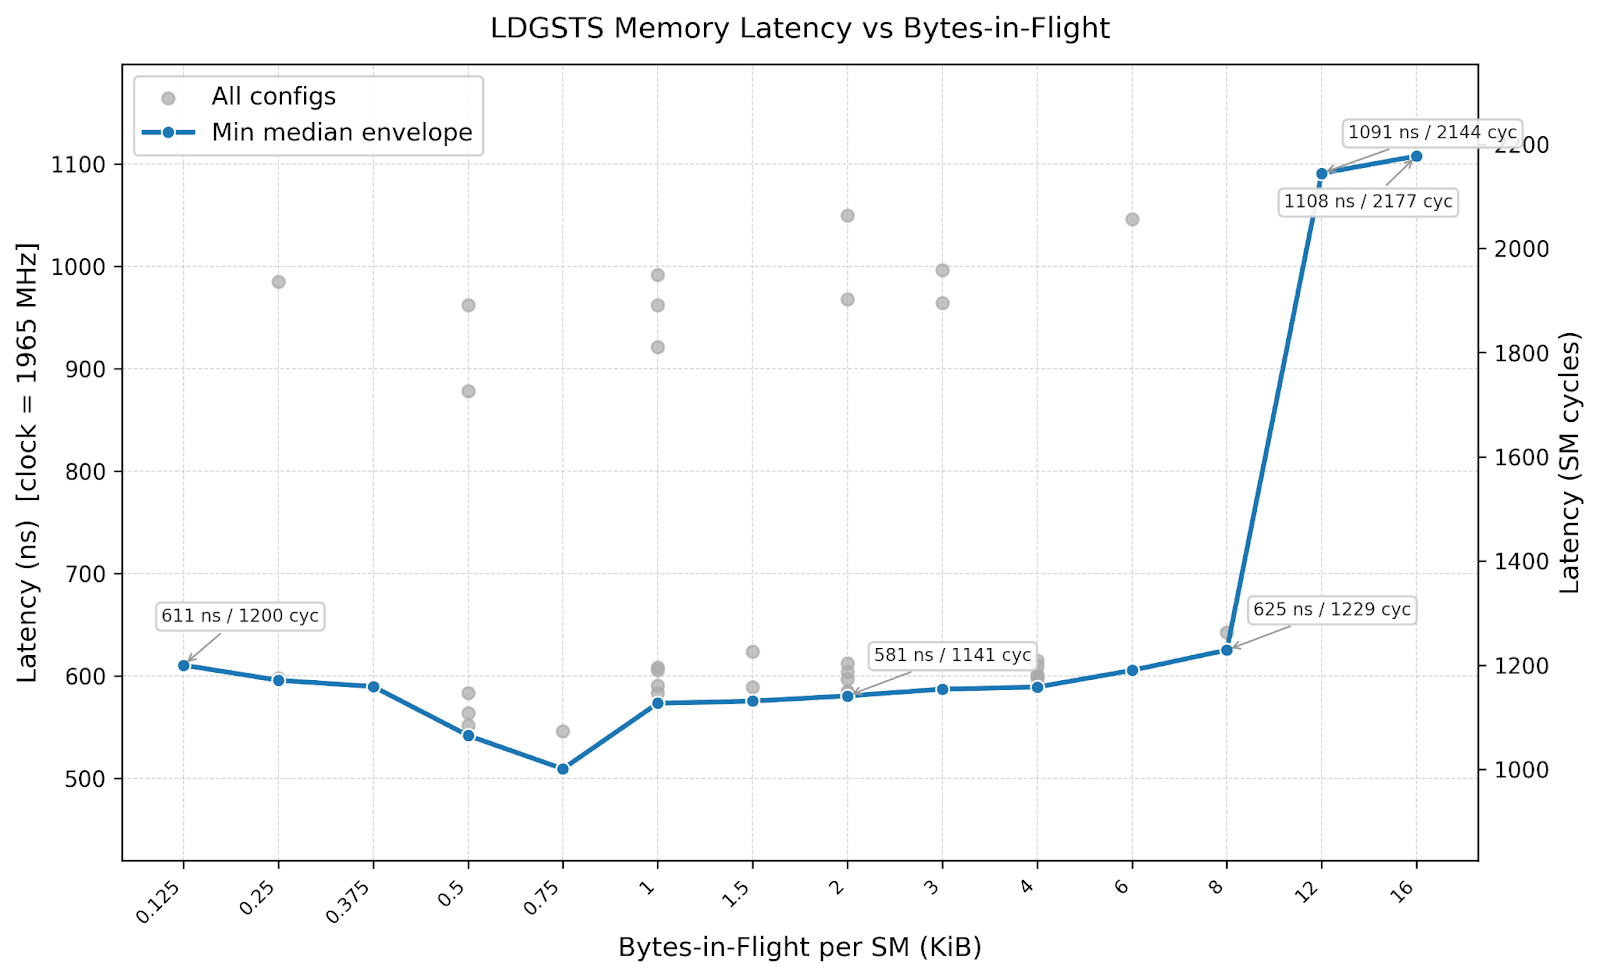
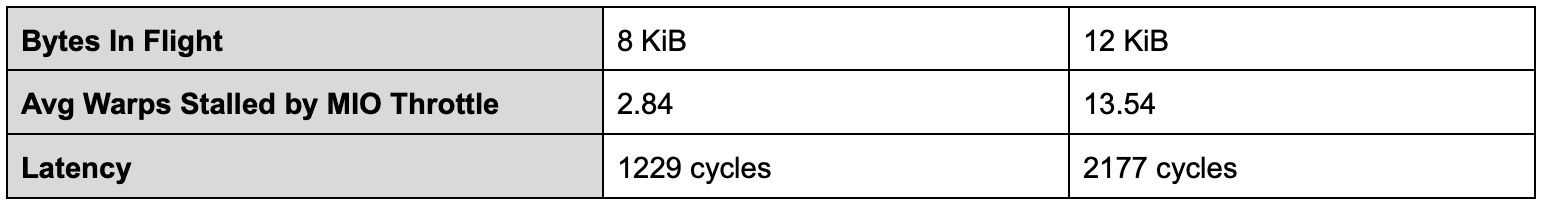
我们还测量了同一组配置的延迟。LDGSTS 的基线延迟约为 600 ns,超过 8 KiB in flight 后几乎翻倍。这是因为要让 LDGSTS 达到较高 bytes in flight,需要大量线程,结果许多 warp 因 MIO(memory input output)throttle 而停顿。
Tensor Memory Accelerator(TMA)
TMA 在 Hopper 引入,PTX 为 cp.async.bulk.tensor,SASS 为 UTMALDG。它是一种异步数据 copy 引擎,专门处理从 global memory 到 shared memory 的大批量数据搬运。单个线程即可发起 TMA,由它完成地址生成、memory swizzling 和越界处理,其他线程则可执行独立工作。这里测试二维 tensor 版本 cp.async.bulk.tensor.2d,以代表典型 TMA 用法。
参考 FlashInfer 注意力 kernel,我们为每个 SM 分配一个 CTA,并在每个 CTA 的 1 至 4 个 warp 中各用一个线程发起不同 box 大小的 TMA 指令。下图展示各 bytes in flight 下的最佳吞吐。
TMA 测试配置如下:
- 每个 SM 的 CTA 数:1
- 每个 CTA 的线程数:128,即 4 个 warp
- TMA box 维度:从 32x8 到 128x128 的二维形状
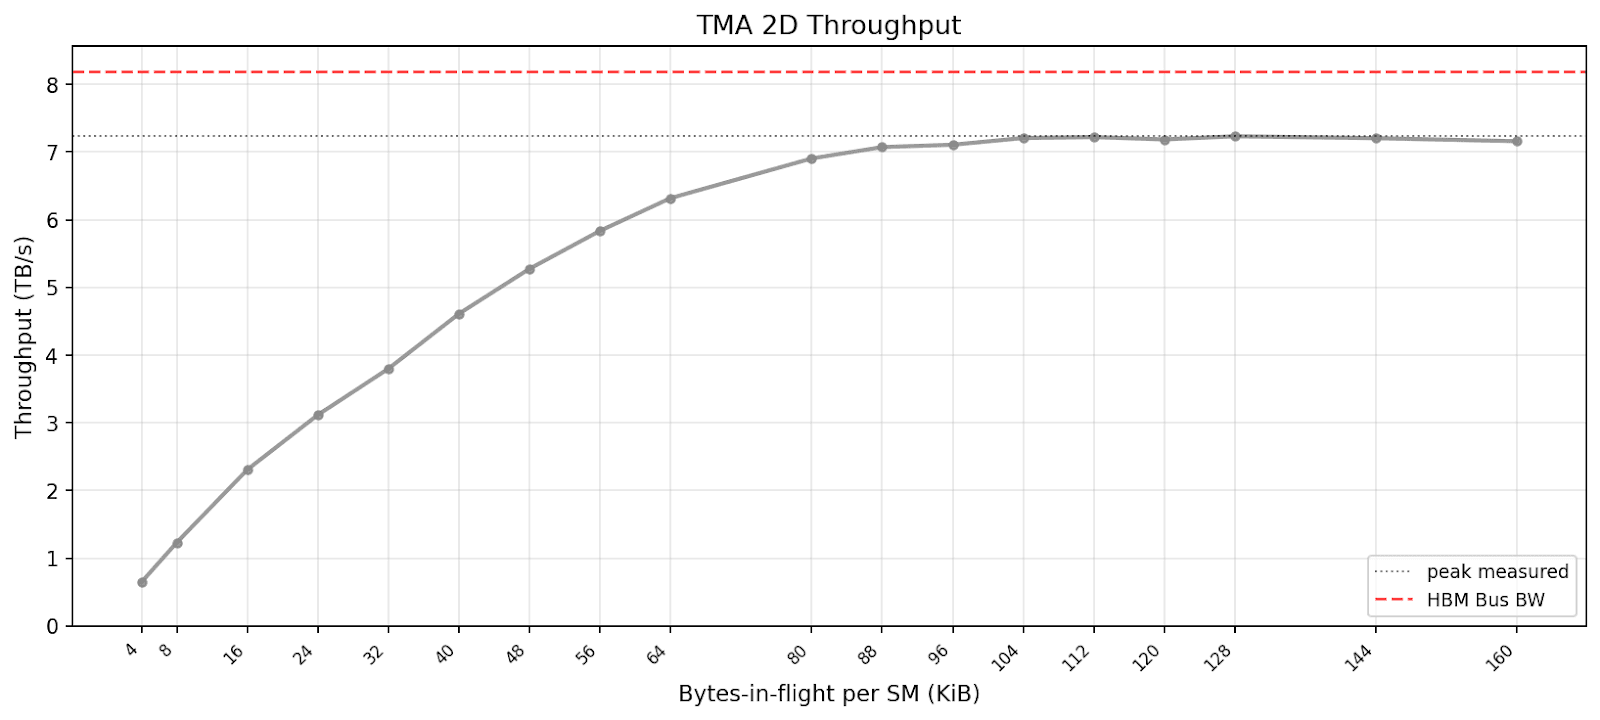
相比 LDGSTS,TMA 要到更高的 bytes in flight 才达到峰值吞吐。
Async copy 与 TMA 对比
FlashInfer 等深度学习 kernel 库同时使用 TMA 和 async copy 加载数据。两者性能特征不同:TMA 适合访问规则的大批量 load,但延迟较高;async copy 可以处理不规则访问,却受到大小限制。我们希望说明各自在什么条件下更合适,因此测试了 FlashInfer 的 MHA 和 MLA kernel 所用配置。
从吞吐看,在少于 32 bytes in flight 时,async copy 略好于 TMA;超过之后 TMA 追上,并能继续扩展到 128 KiB。从延迟看,在 12 KiB in flight 之前,async copy 略低于 TMA,之后 TMA 延迟明显增加。
转载编者注:上段保留了原文的“32 bytes”,但对应吞吐图的横轴单位是 KiB。下方 multicast 图注中的“64 bytes”同样与图中 KiB 单位不一致。不要把这些原文单位当作已经核验的精确阈值。
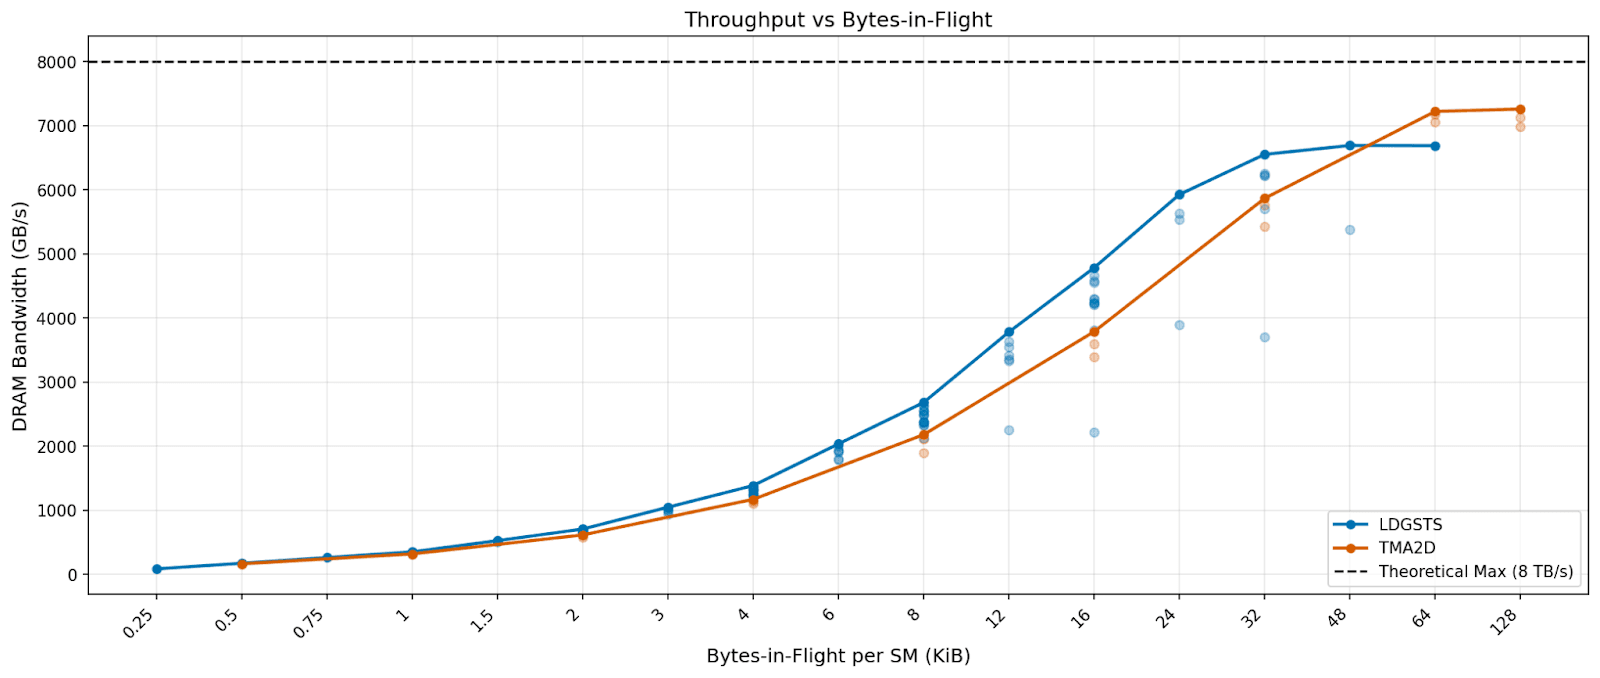
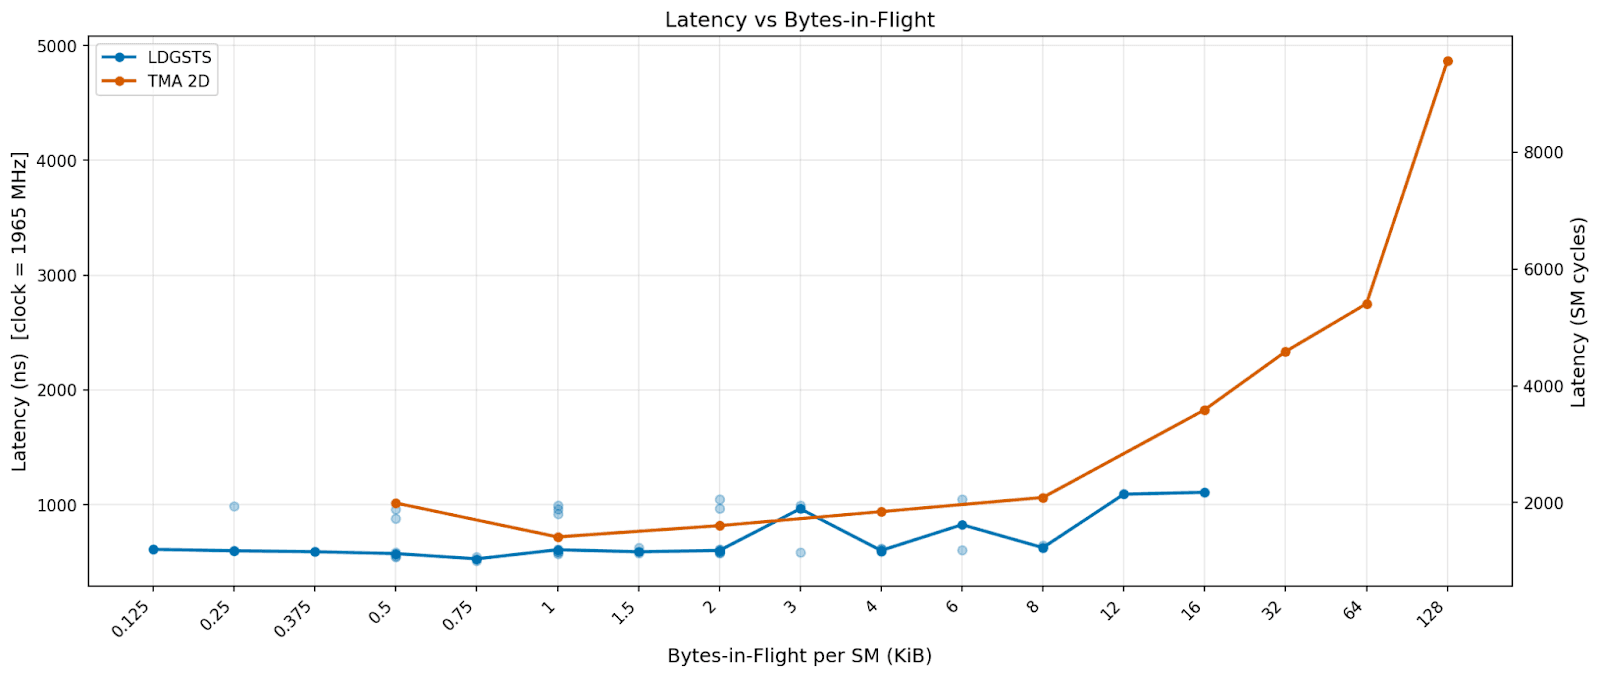
实际中,Blackwell MLA kernel 使用 async copy 动态加载 page,而 MHA kernel 只使用 TMA。FlashInfer 的大部分 Blackwell MHA kernel 来自 TRT-LLM,因此我们只能通过分析二进制推测实现。我们发现,与 Hopper 类似,所有 Blackwell TRT-LLM kernel 都使用 TMA。对于动态 page 加载,我们猜测它们沿用 Hopper 的做法,使用 4D TMA,将 page index 作为最后一维,并在需要时索引 TensorMap 对象。为了明确这些 kernel 的实现机制,我们呼吁 NVIDIA 开源 FlashInfer TRT-LLM kernel,让社区受益。
TMA multicast
TMA 支持 multicast:一次 load 将数据复制到多个 SM 的 shared memory,通过 CTA mask 指定目标。GEMM 类计算经常使用它,让处理不同输出 tile 的 SM 共享输入 tile。例如,SwiGLU 激活函数采用两个 GEMM 共享同一个输入矩阵的模式,适合 multicast。主要收益是减少 HBM load,降低有效带宽需求;同时,多个 CTA 对共享数据的请求被合并为一次,也显著减少 L2 流量。
根据 NCU 文档,处理 TMA multicast 请求的单元称为 L2 Request Coalescer(LRC):
L2 Request Coalescer(LRC)处理发往 L2 的请求,并尝试在转发到 L2 cache 前合并读取请求。它还处理来自 SM 的程序显式 multicast 请求,并支持写入压缩。
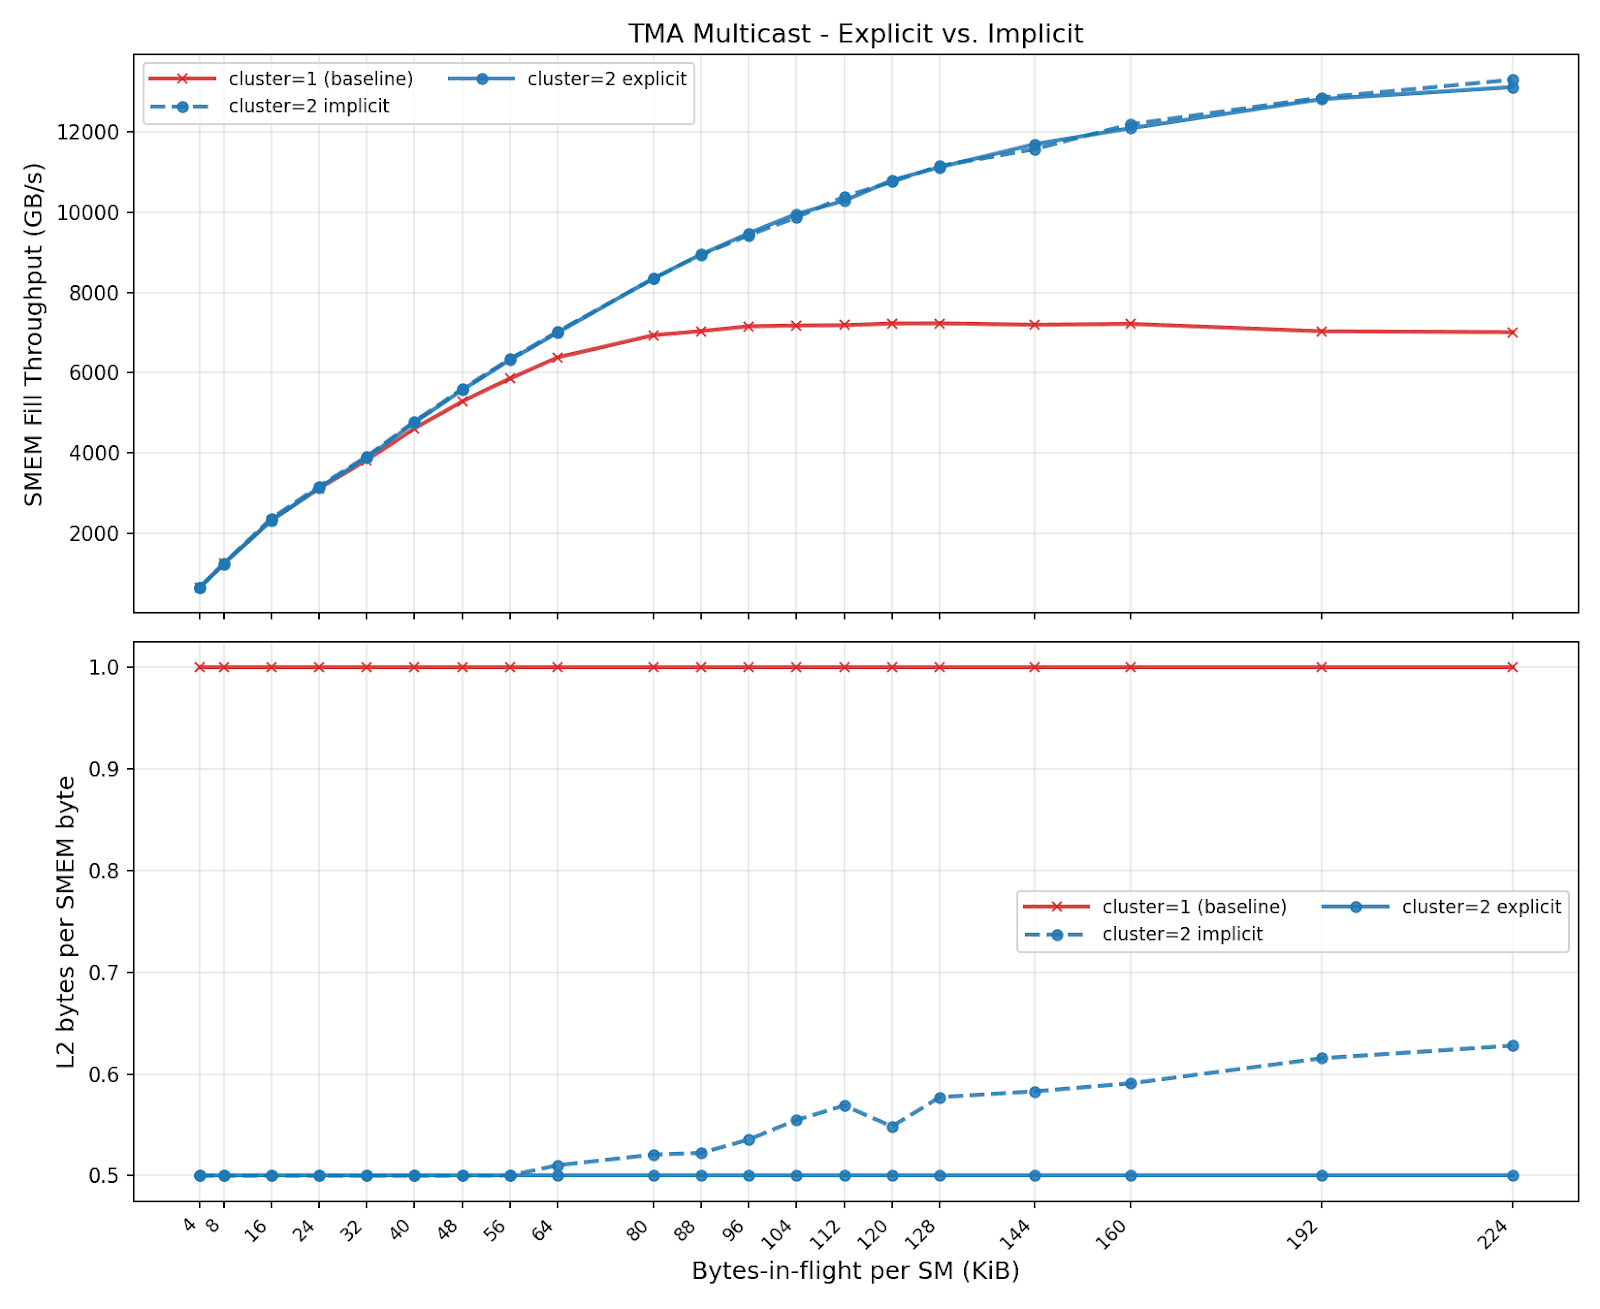
这似乎意味着,即使程序未显式要求,硬件也可能提供某种 multicast 行为,类似 miss status holding register。为验证这一点,我们运行相同的 TMA multicast 测试,但不再由一个 CTA 发起 multicast load,而是让所有 CTA 分别向相同数据发起独立 TMA load。
我们比较三种情况:
- 每个 SM 加载不同数据,作为基线。
- 显式 TMA multicast:每个 cluster 中一个 CTA 向该 cluster 的所有 CTA 发起 multicast load。
- 隐式 TMA multicast:每个 cluster 的所有 CTA 各自向同一数据发起普通 TMA load。
即使数据尚未驻留 L2,TMA multicast 也能大幅提高填充 SMEM buffer 的 load 带宽。对于已知流量模式,显式 TMA multicast 指令完全消除了重复 L2 流量,达到理想的“每个 SMEM 字节对应 1 / cluster_size 个 L2 字节”。在这个简单测试中,显式和隐式方式几乎达到相同的 SMEM 填充吞吐。不过 LRC 并不完美:隐式方式给 L2 带来的流量略多,且总数据量越大,这一点越明显。
DSMEM 与 SMEM
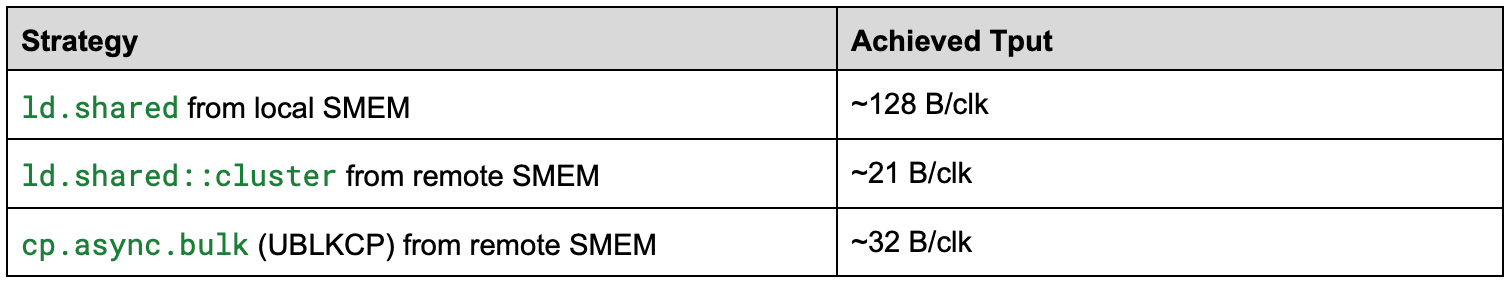
NVIDIA 在 Hopper 中引入 distributed shared memory(DSMEM),允许同一 cluster 内的 CTA 访问彼此的 shared memory,可用于跨 CTA reduction 等模式。通过 DSMEM 读取其他 CTA 的内存,吞吐明显低于本地 SMEM 的每时钟周期 128 bytes。
我们测试了几种访问 DSMEM 的 PTX 模式。一个重要区别是,DSMEM load 与 global load 类似,按 packet 传输。因此,最优访问方式不像本地 SMEM 为避免 bank conflict 而采用的交错访问,更像 GMEM 中对连续位置的合并访问。此外,要让本地 SMEM 达到完整的 128 B/cycle,必须使用不带 ::cluster 的 ld.shared。我们一开始用 ld.shared::cluster 同时访问本地和远端 SMEM,因而踩到了这个坑:ld.shared 会生成 LDS,而 ld.shared::cluster 生成通用的 LD,后者似乎无法达到本地 SMEM 的峰值吞吐。使用 ld.shared::cluster 时,我们也难以进一步提高性能;直到改用 cp.async.bulk(PTX)/ UBLKCP(SASS),让每条指令搬运更多数据,才把 DSMEM 吞吐略微提高。
下图是各 PTX 模式达到的峰值吞吐,以每时钟周期字节数(B/clk)表示,便于与本地 SMEM 的已知最大吞吐比较。
第五代 Tensor Core MMA
MMA 是执行矩阵乘法的核心指令。从 Hopper 到 Blackwell,MMA 性能越来越依赖形状。我们遍历不同形状与数据类型,量化这些差异。
Blackwell 引入了 2SM MMA,即 .cta_group::2,由一对 CTA 在两个 SM 上合作完成一次 MMA。具体而言,输入矩阵 A 被复制,矩阵 B 和 D 则分布在两个 SM 上,两个 CTA 可以访问彼此的 shared memory。这支持更大的 MMA 形状。我们将检验 2SM MMA 是否具有弱扩展、强扩展,或同时具有两者。
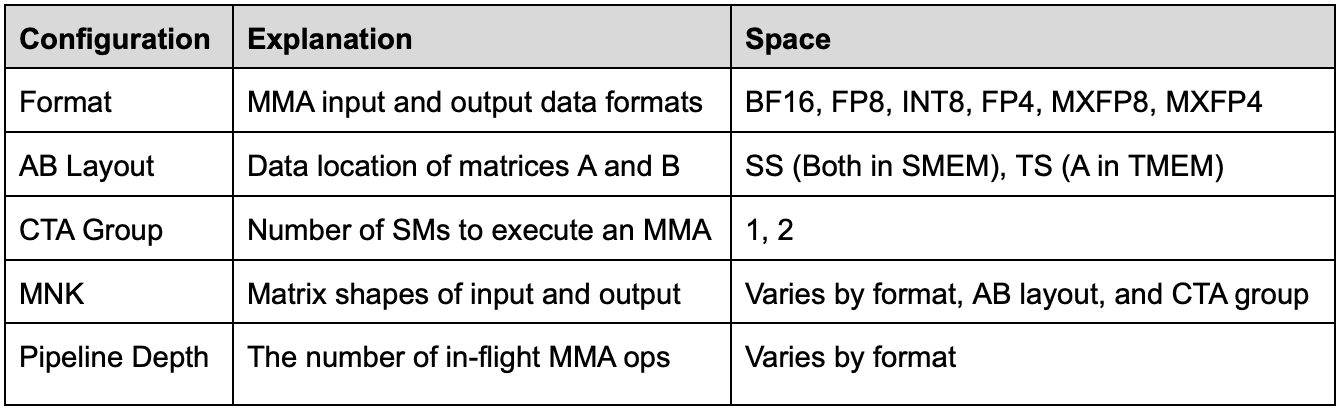
MMA 基准测试配置空间如下:
吞吐
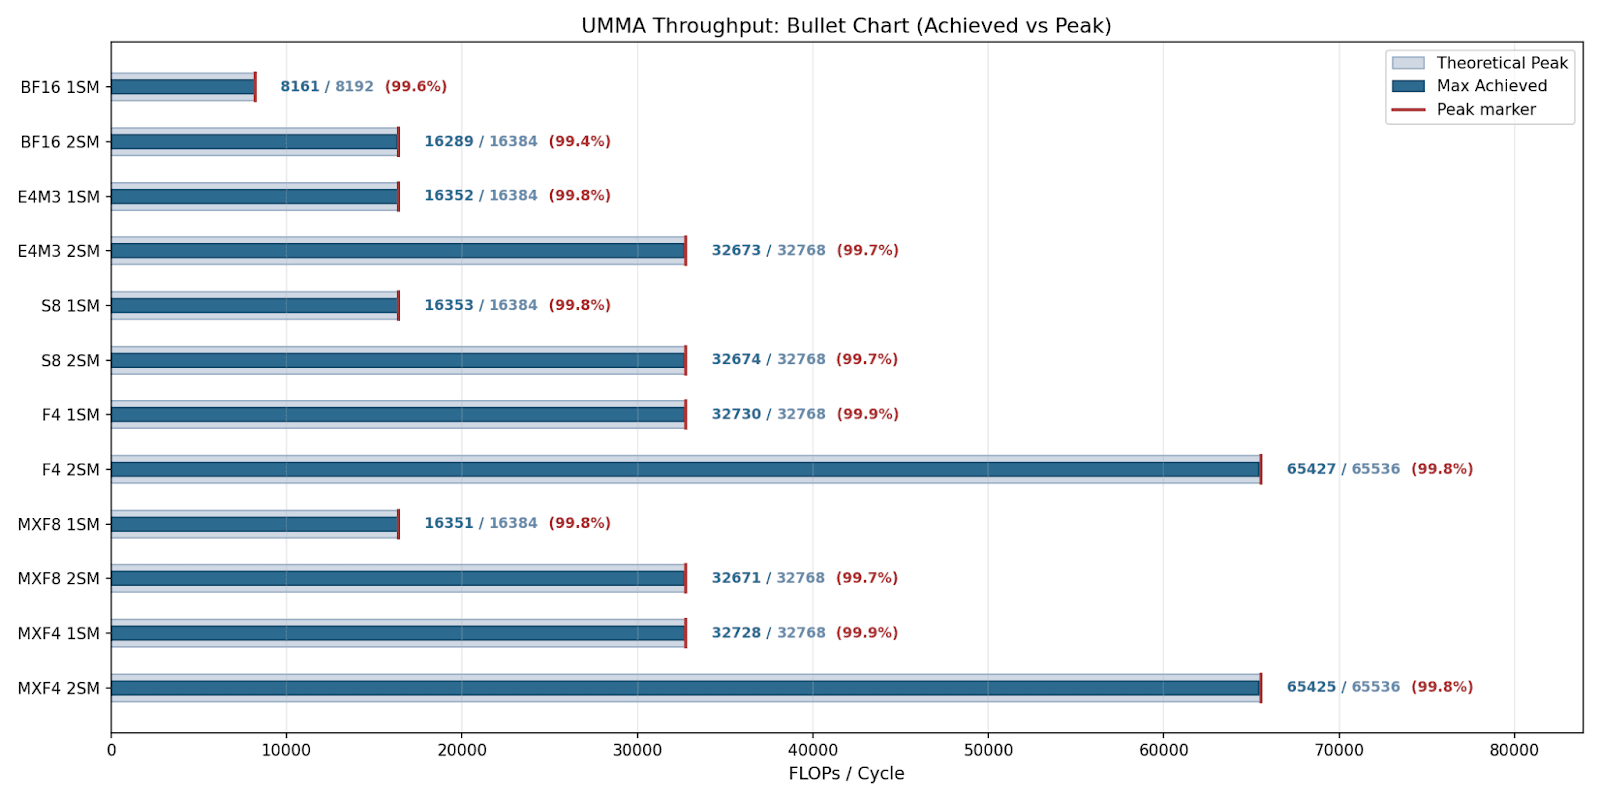
NVIDIA 对不同输入类型给出了吞吐指标。这里将各“数据格式 + CTA group”组合的宣称值与实际可达最大吞吐比较。结果表明,所有格式及 CTA group 的 UMMA 都能接近峰值,包括可能存在协调开销的 2SM 版本。
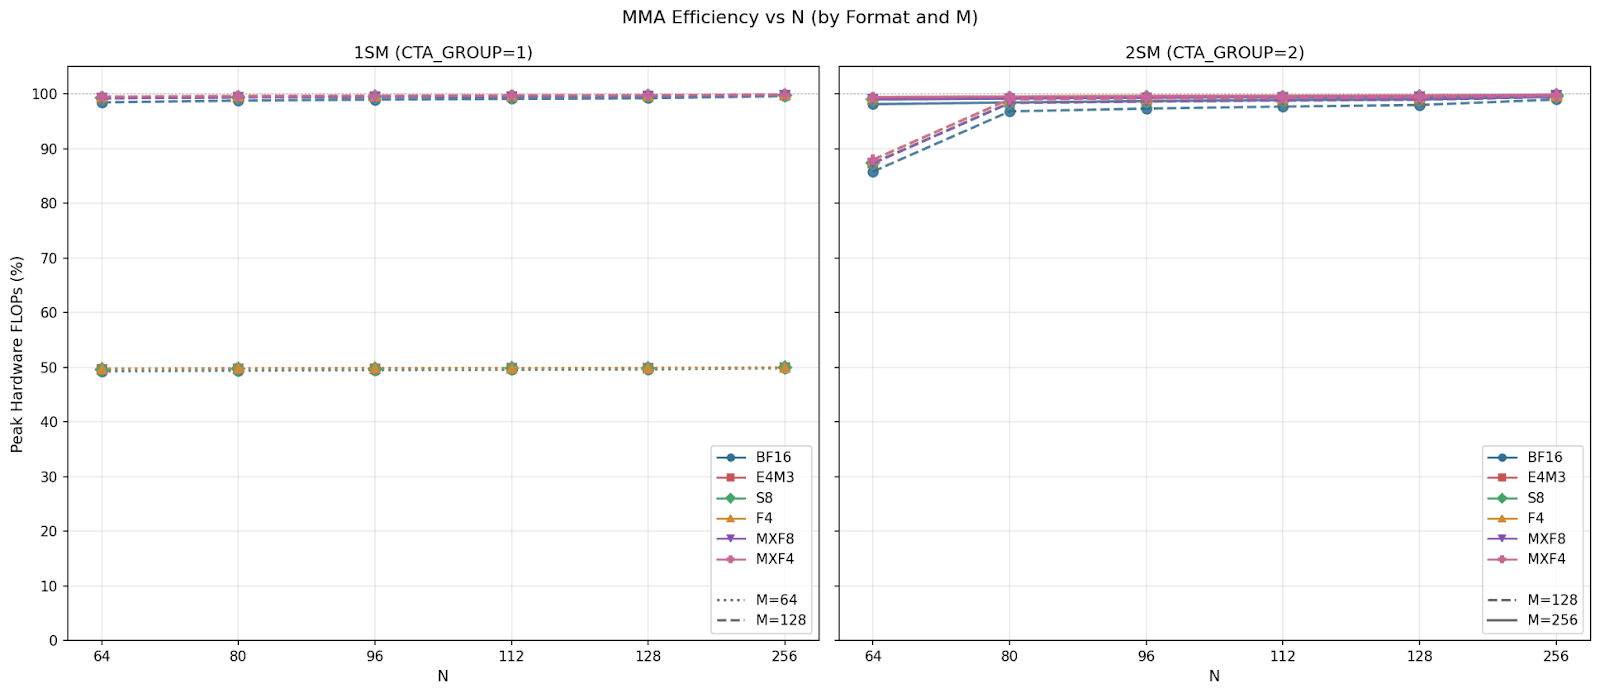
对于 1SM MMA,在所有 N 大小下,较小的 M=64 最多达到理论峰值的 50%,较大的 M=128 则接近 100%,证实 M=64 只使用了一半数据通路。对于 2SM MMA,M=128 在 N=64 时从峰值的 90% 起步,其他 N 大小接近 100%。M128N64 必然受到 TMEM、L2、SMEM 等其他硬件单元限制。M=256 则在所有配置中维持接近 100%,因为它相当于每个 SM 的 M=128,能够用满数据通路。相同位宽的数据格式吞吐一致,micro-scaling 类型几乎没有额外开销。
MMA 支持两种 AB 布局:A、B 都在 SMEM 中的 SS,以及 A 在 TMEM、B 在 SMEM 中的 TS。M=128 时,TS 布局接近峰值,而 SS 在较小 N 下较慢,到 N=128 才追上。
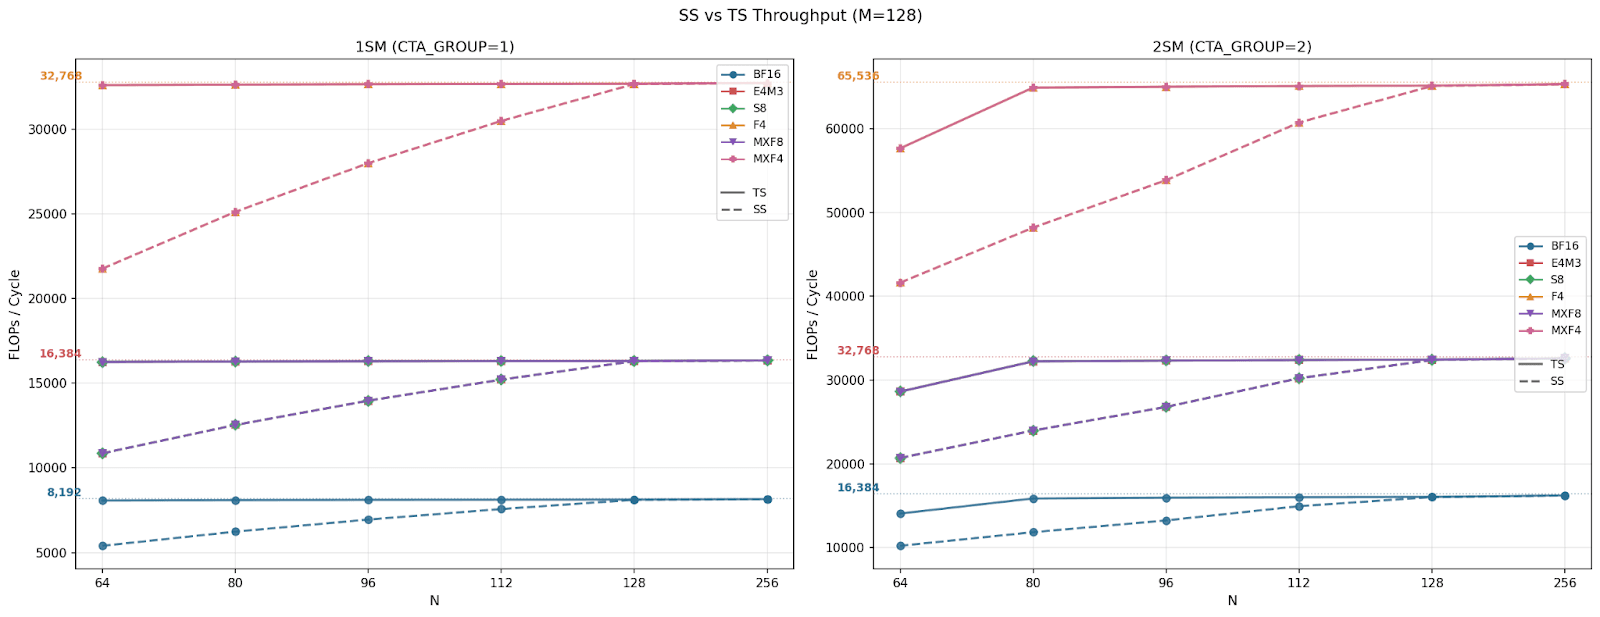
可以证明,这是因为 SS 模式下 N<128 时,指令本身受 SMEM 带宽限制。以 FP16 为例,已知硬件每个 SM 每周期可执行 8192 MMA FLOPs,SMEM 带宽为每个 SM 128 B/cycle。对于 M=128、N=64、K=16:
A_bytes = 2*M*K = 4096; B_bytes = 2*N*K = 2048;
FLOPs = 2*M*N*K = 262144
SMEM Cycles = (A_bytes + B_bytes) / (128 B/clk) = 48 cycles
Math Cycles = FLOPs / (16384 FLOPs/clk) = 32 cycles
转载编者注:原文上段给出 8192 FLOPs/clk,但公式分母写成 16384,同时仍给出 32 cycles。262144 除以 16384 等于 16;使用 8192 才得到 32。这里保留原文数字,并明确指出不一致,不能将该公式视为经过验证的重新计算。
继续增大 N,可以发现从 N=128 开始,指令才受计算限制。
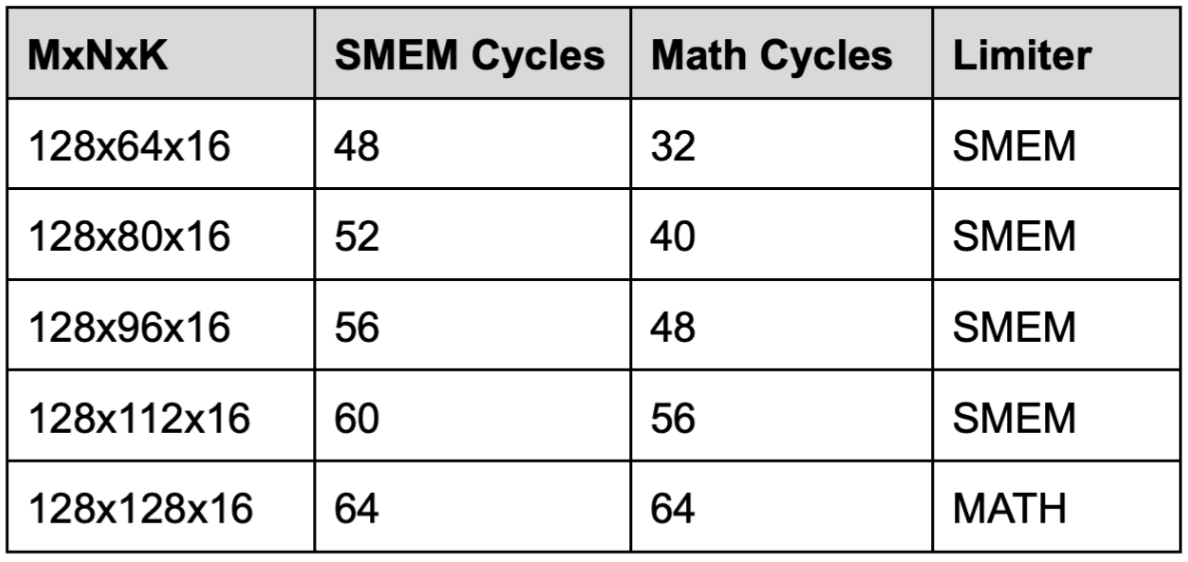
其他数据类型也类似:两项操作数都在 SMEM 中时,N<128 的 MMA 指令受 SMEM 限制。
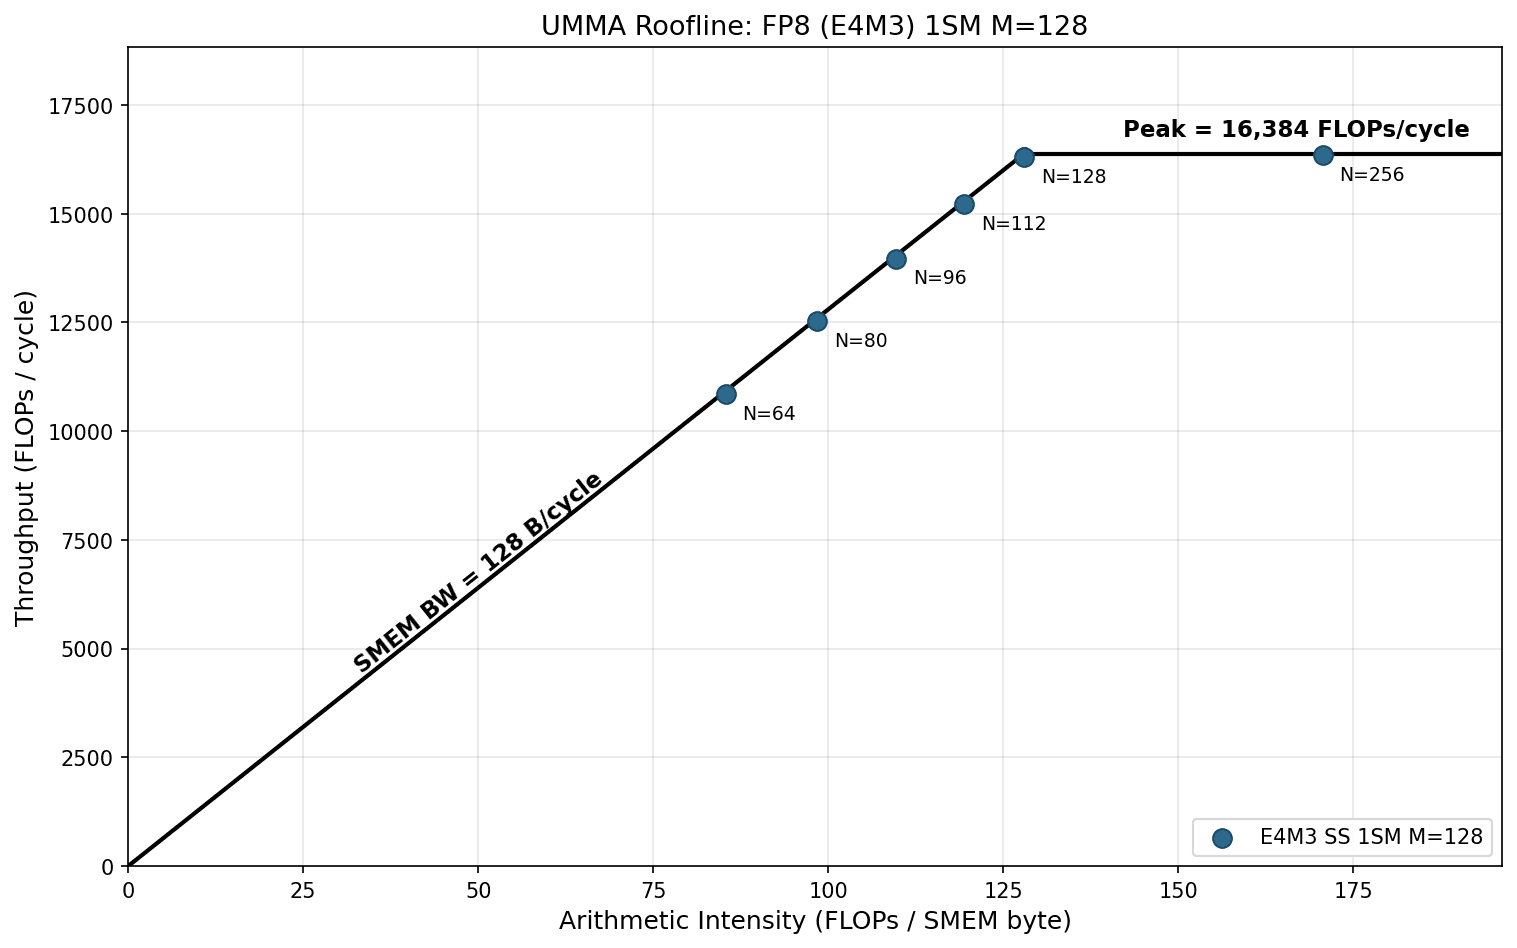
为了进一步说明,我们绘制了所有 FP8 1SM MMA 形状的 roofline。可以清楚看到,N<256 处于内存受限区域,斜率约为 128 bytes/cycle,也就是 SMEM 带宽。
2SM MMA 在所有格式和形状上实现了理想弱扩展:使用 1SM MMA 两倍的计算资源,达到 2x 加速。在 SS 布局的较小形状下,甚至超过 2x,因为 N<128 时受 SMEM 限制,而 2SM 版本将操作数 B 拆分到两个 SM 上。
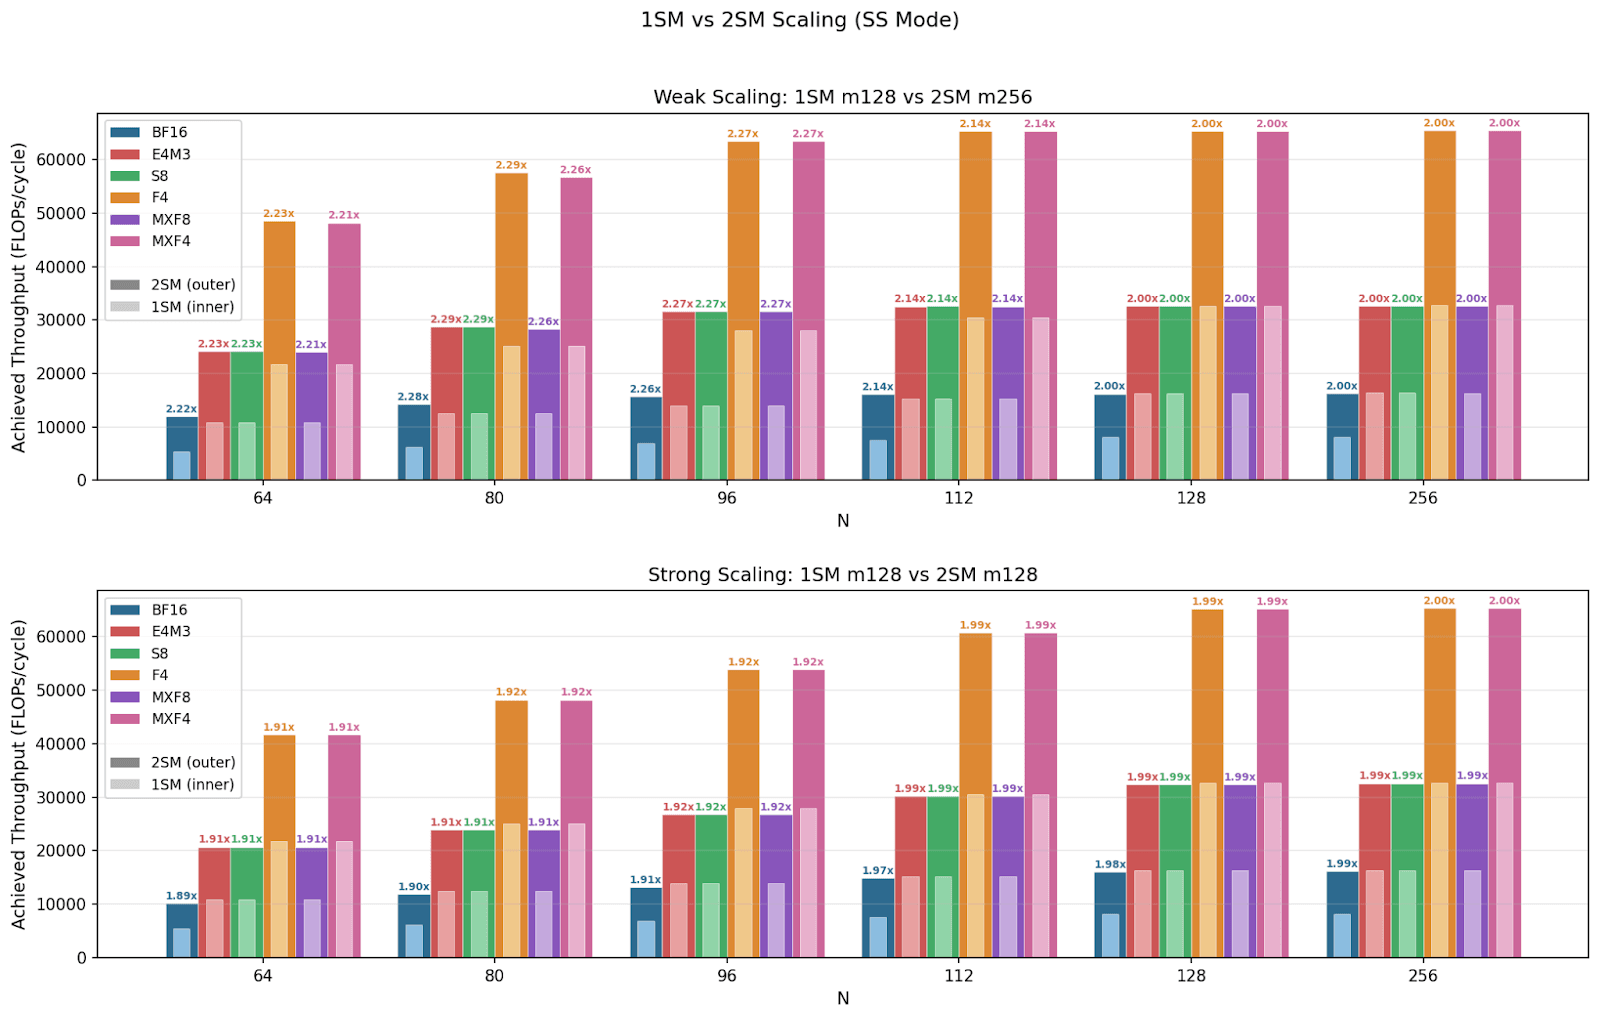
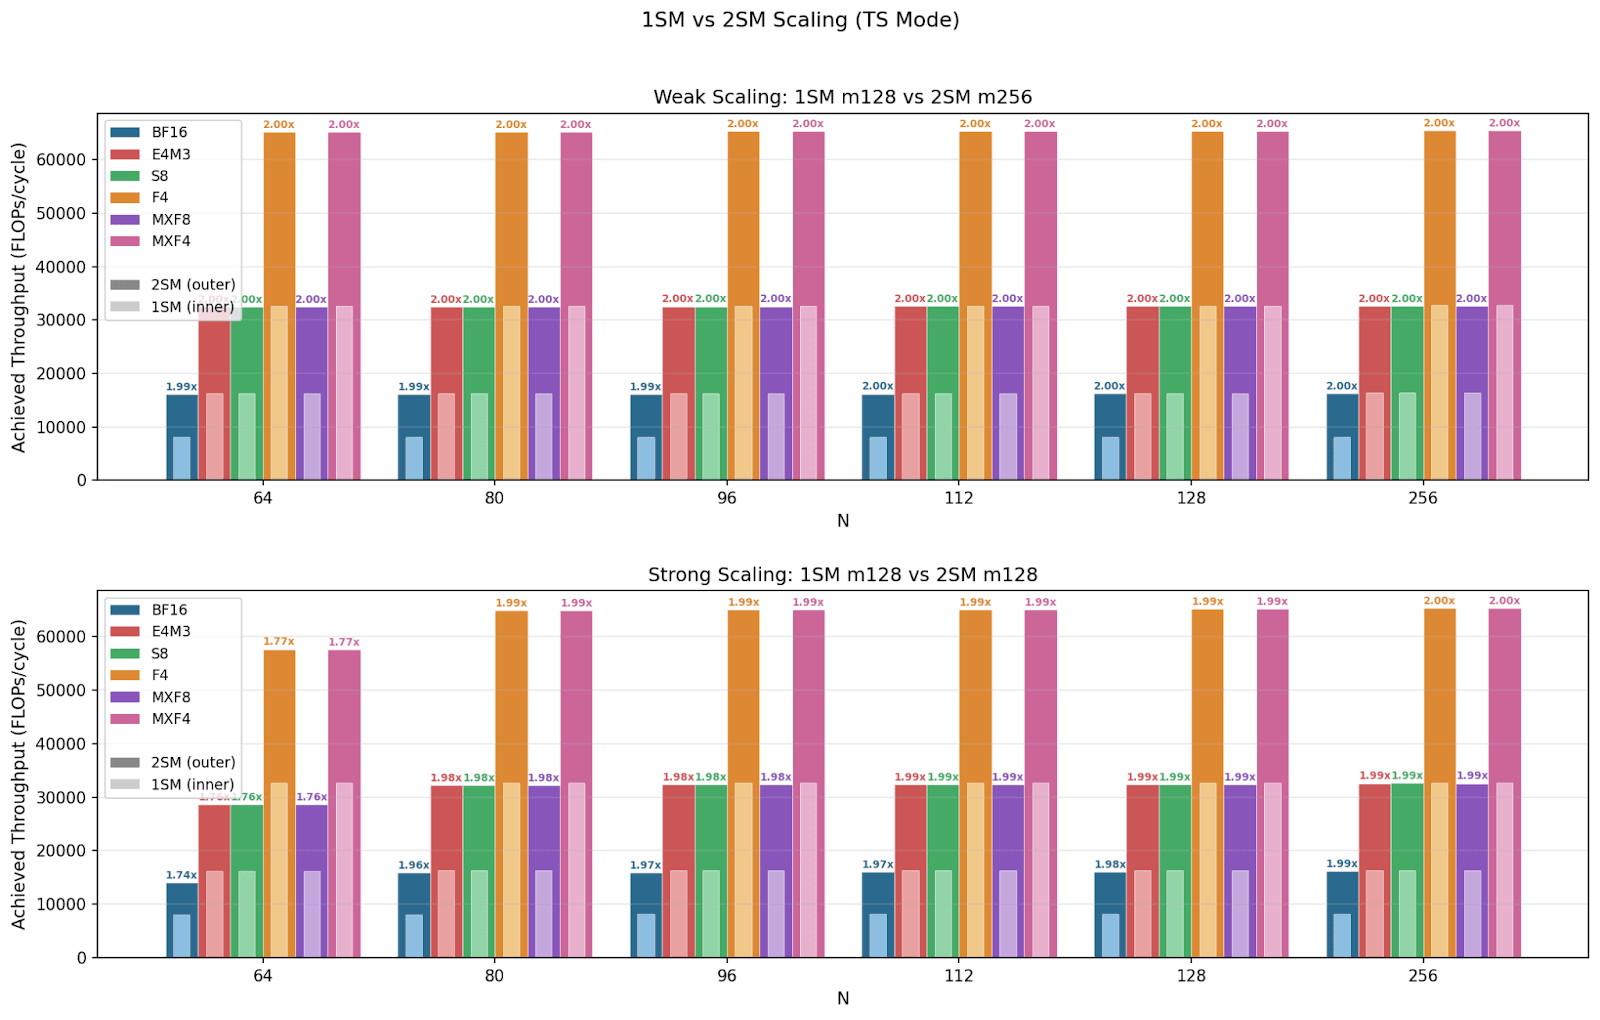
这些实验表明,对于给定的 SMEM tile 大小,要获得最大吞吐,应使用可用的最大指令形状。
延迟
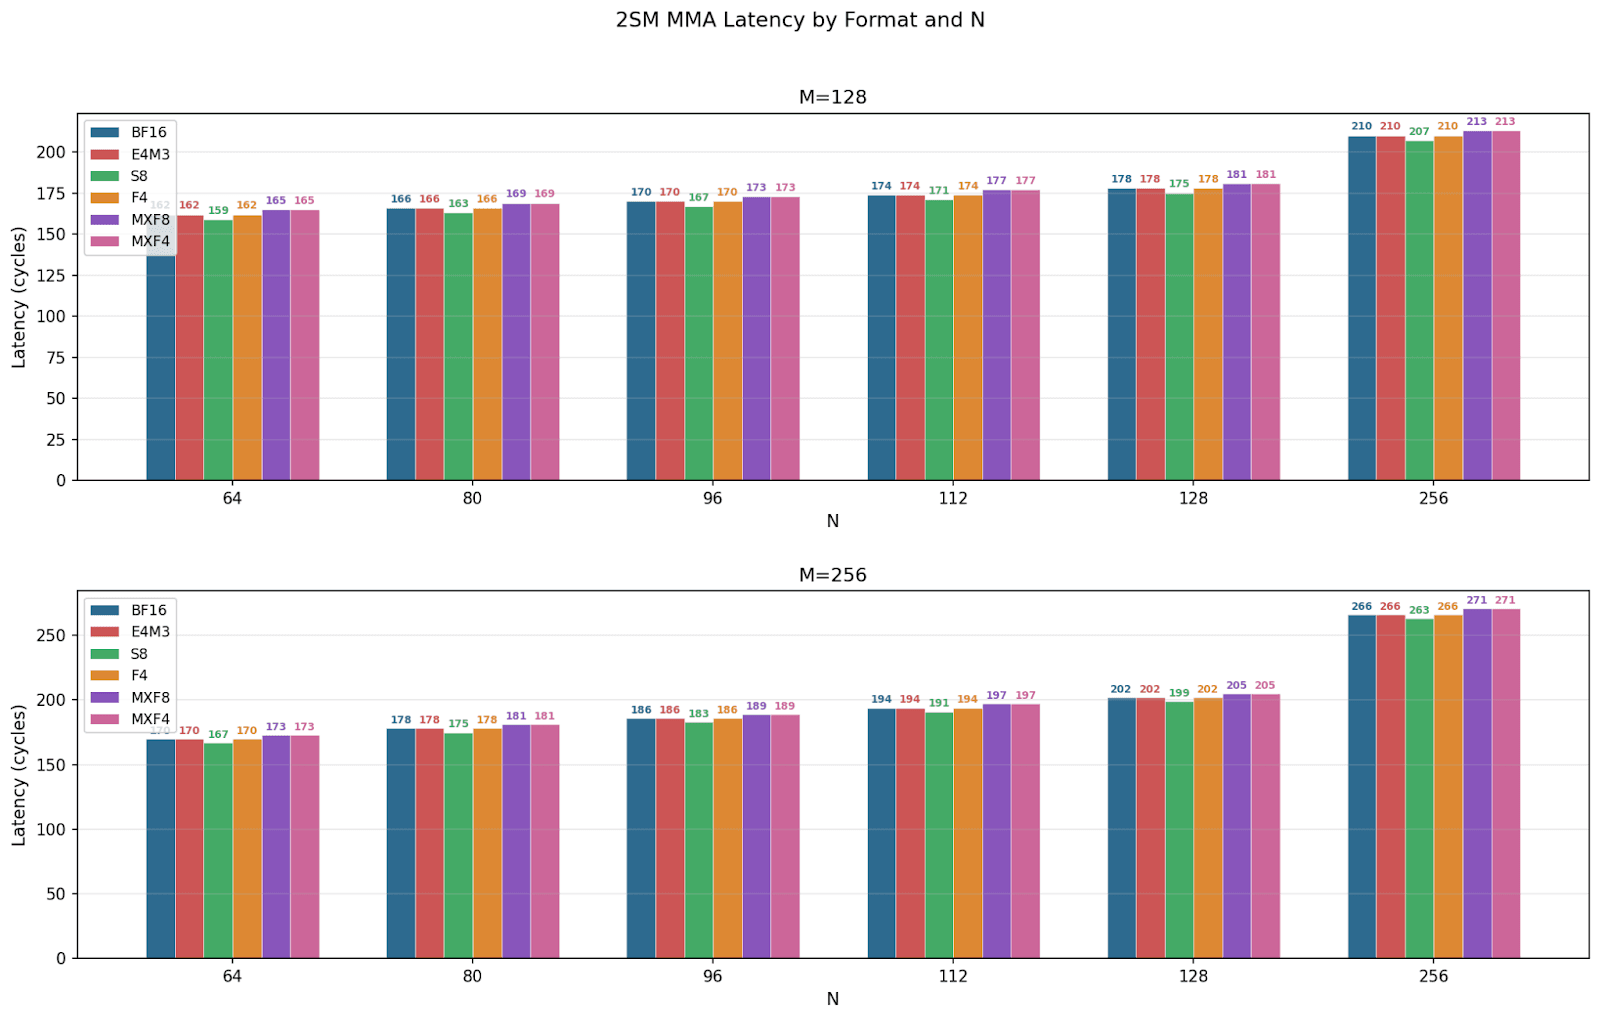
我们测量了单条 MMA 指令的延迟,结果如下。所有配置中,延迟从 N=64 到 N=128 线性增长,N=256 的跃升很可能来自 N 从 128 翻倍到 256。分别看不同 CTA group,1SM MMA 的 M=64 与 M=128 在各 N 大小下延迟接近;2SM MMA 中,M=256 延迟增长略快于 M=128,与理论估算一致。不同数据类型在 1SM 上差别很小,在 2SM 上则明显分开。
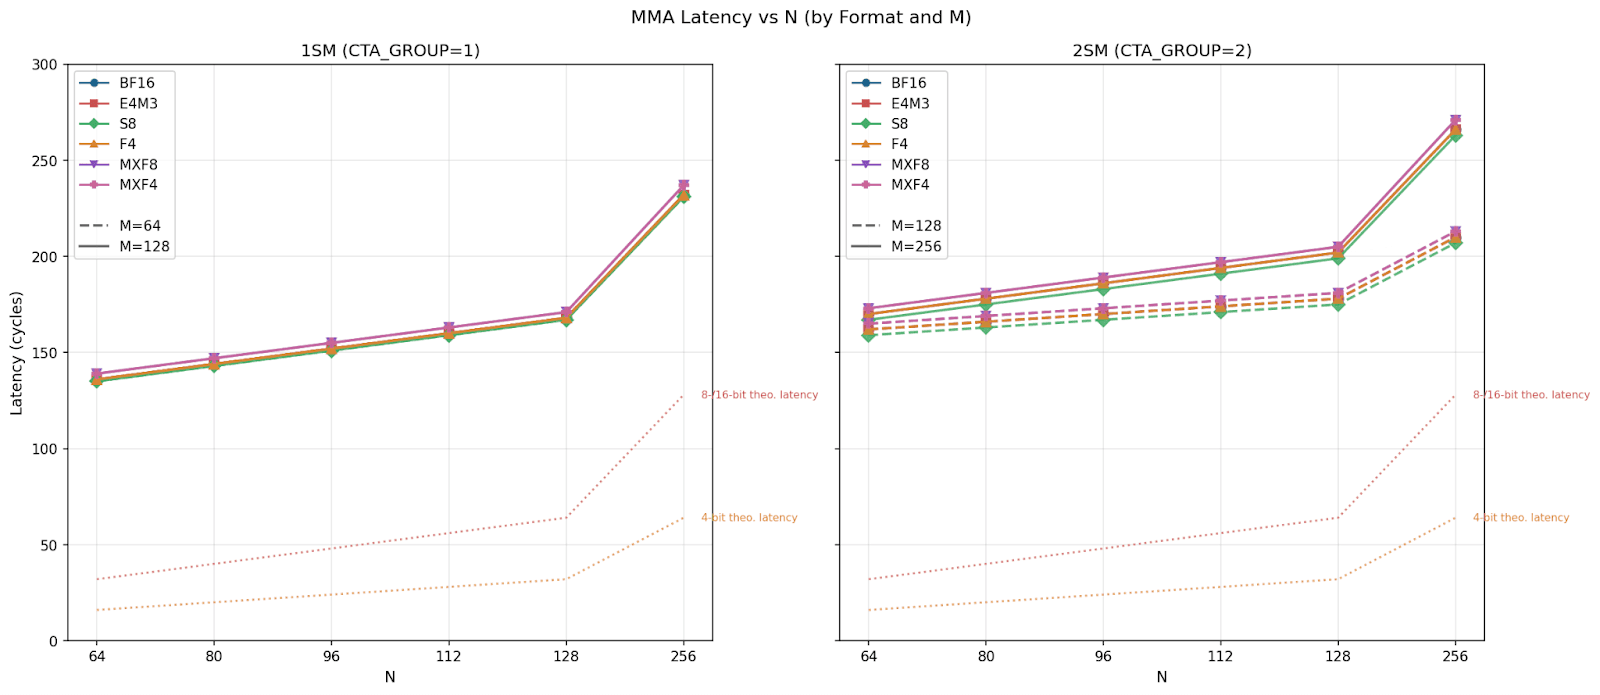
我们观察到一个幅度不大但稳定的延迟排序:
S8 < BF16 = E4M3 = F4 < MXF8 = MXF4
我们认为,整数运算能效较高使 S8 最快,而 scale factor 计算为 MXF8、MXF4 带来了少量额外开销。
不同在途指令数下的吞吐
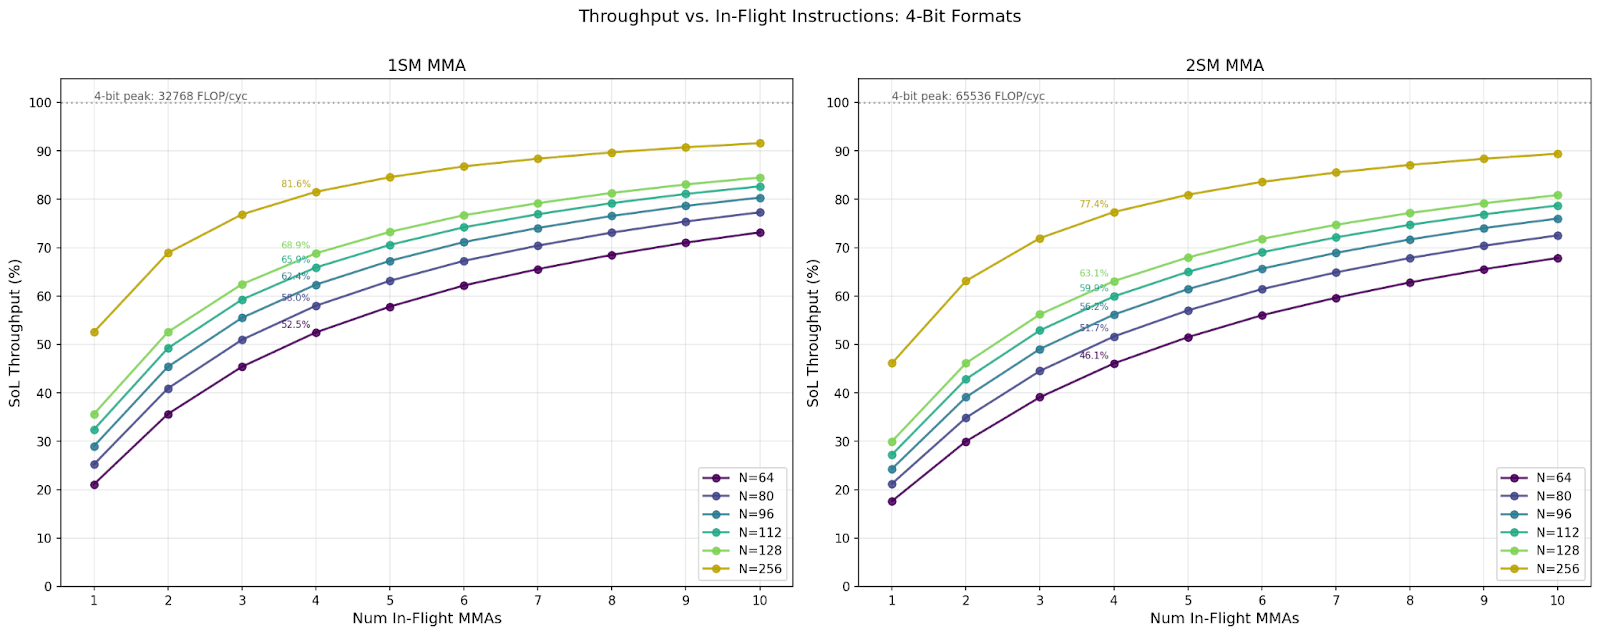
前面的吞吐测试使用了 256 至 1024 条在途指令,以摊薄指令发射和 commit 等待开销。但实际 kernel 通常只有 1 至 4 条在途 MMA。因此,我们又测试了 1 至 10 条在途指令时的吞吐变化。
所有配置中,相同 N 和在途 MMA 数达到的 Speed-of-Light(SoL)比例接近。只有最大的 N 能达到 90% SoL,最小的 N 约为 70%。比较 1SM 与 2SM MMA,1SM 达到的 SoL 比例约高 5%。在相同数据格式和 CTA group 下,N 越大,吞吐始终越高。最后,4 条在途 MMA 的 SoL 比例上限为 78%-80%。
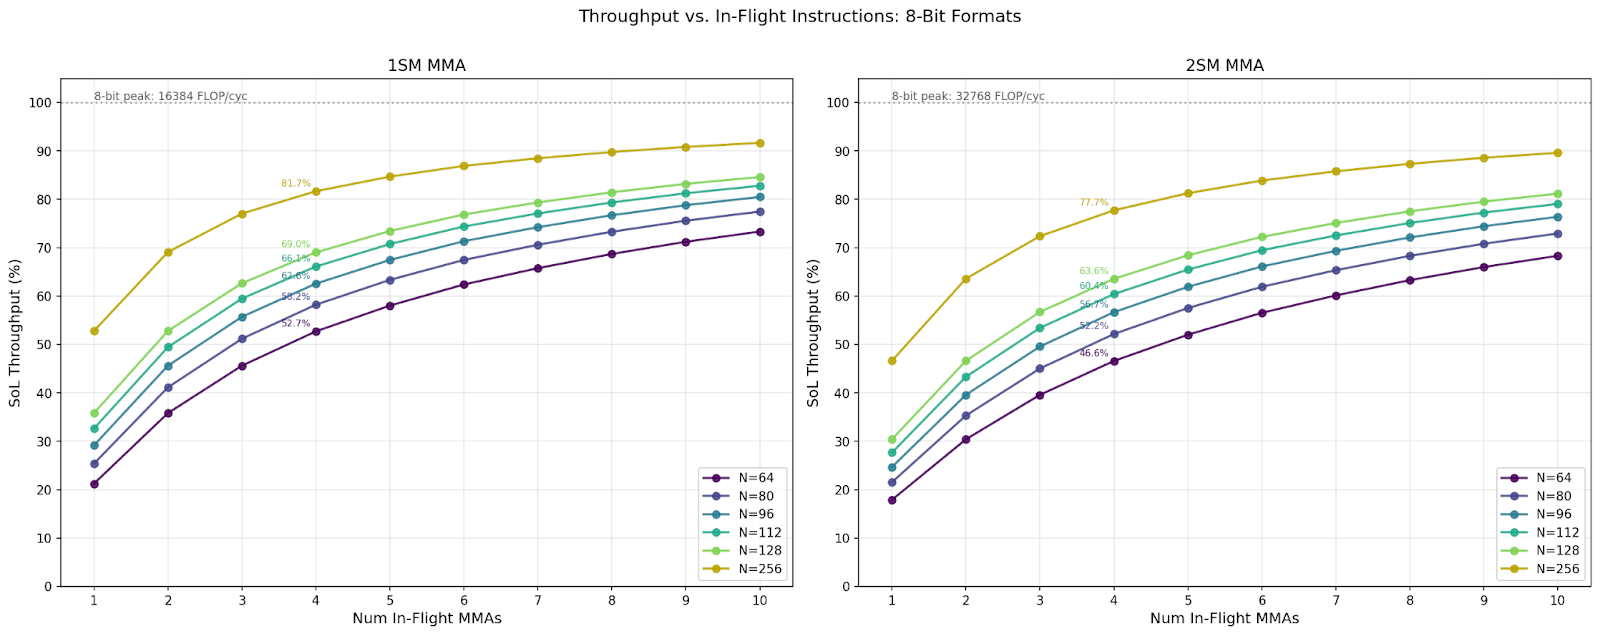
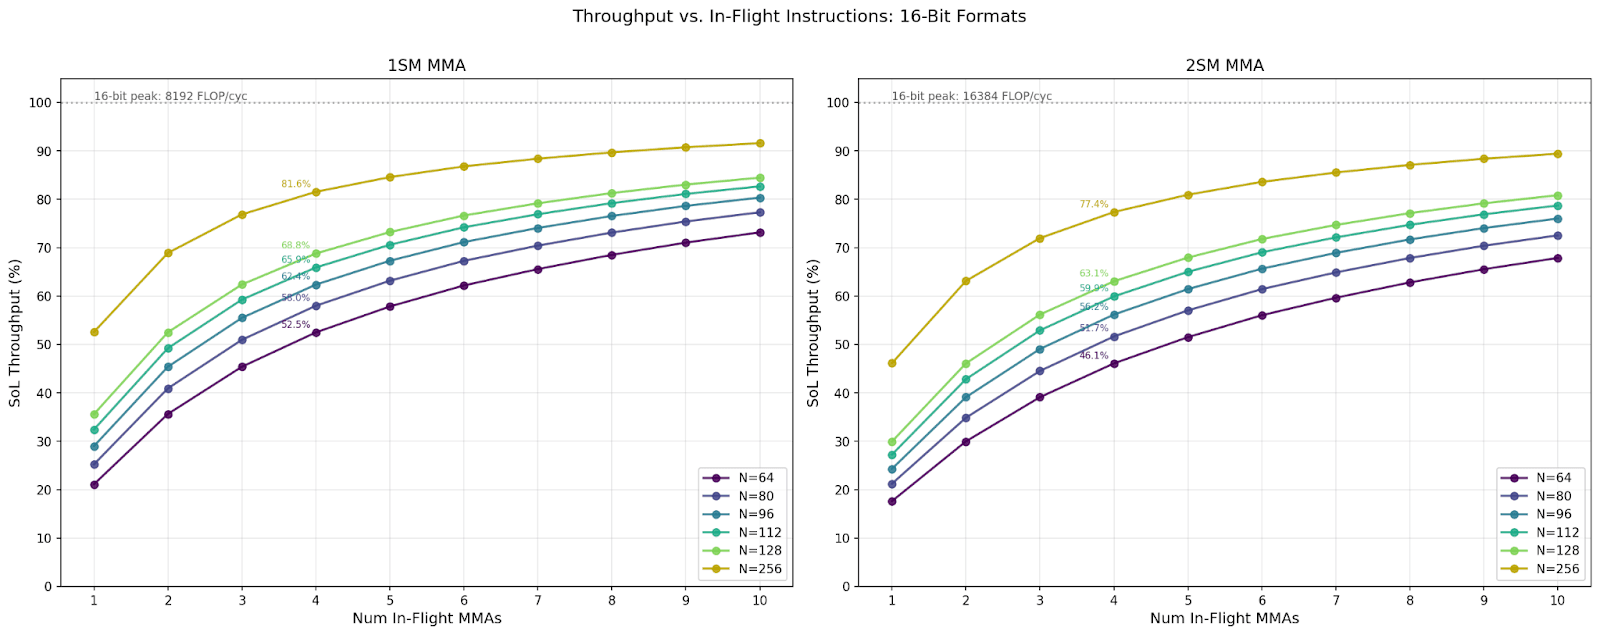
下文将讨论使用 CUTLASS kernel 库的实际场景,以及吞吐、multicast 和 floorplan。
公开部分到此结束。上段提到的讨论位于原文的订阅者专享后续内容中。
相关术语
本文涉及的硬件概念包括 floorsweeping、流式多处理器、thread block cluster、GPC、分布式 shared memory 和 tensor memory。指令与传输概念包括 PTX、SASS、异步 copy、TMA、TMA multicast、MMA 和双 SM MMA。
理解测量结果可参考 Speed-of-Light 吞吐量、在途字节数、warp 占用率、roofline、运算强度、内存带宽及内存受限与计算受限。库与 kernel 背景见 GEMM、CUTLASS 和 FlashInfer,数值格式见分块缩放。
本文由英文原文翻译而来,如有歧义以英文版为准。所有文章版权归 © SemiAnalysis 所有,保留所有权利。覆盖应用源代码的 AGPL-3.0 许可证不适用于文章内容。