预计阅读 11 分钟
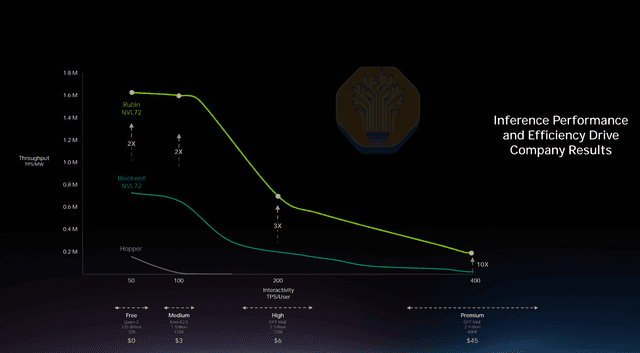
Rubin NVL72 Agentic 推理:每美元性能提升至 67 倍
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
- benchmark
- gpu
- inference
- +7
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
33 篇文章
预计阅读 11 分钟
Jensen 再次低估性能,每吉瓦年利润超过两倍,买得越多赚得越多,AgentX、InferenceX 与深度协同设计
预计阅读 39 分钟
InferenceX、最高 50% 的每美元性能优势、TPU 软件栈的快速外部化、不断扩大的客户群、Ironwood、TPUv8i,以及正在收窄的 CUDA 护城河
预计阅读 3 分钟
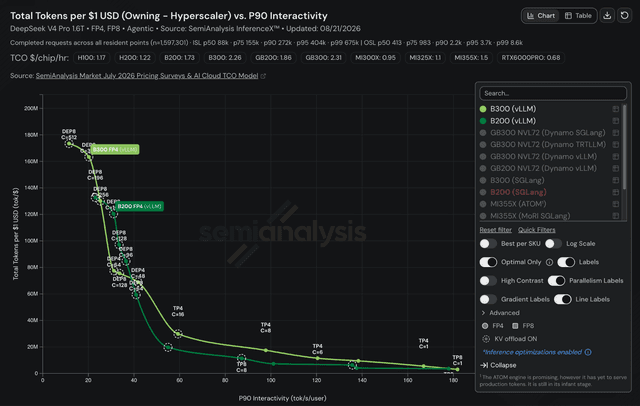
多出 50% 的 HBM 能挤出额外吞吐量,逐点遥测数据说明了它究竟从何而来
预计阅读 3 分钟
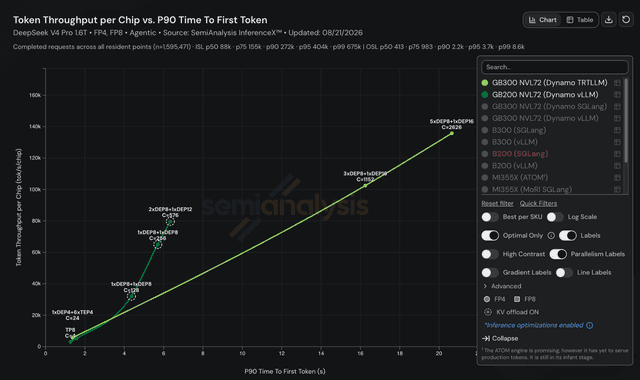
两者都依赖 PD 分离,GB300 额外使用 DEP32 宽专家并行解码,而差距体现在首 token 延迟而非 token 速率上
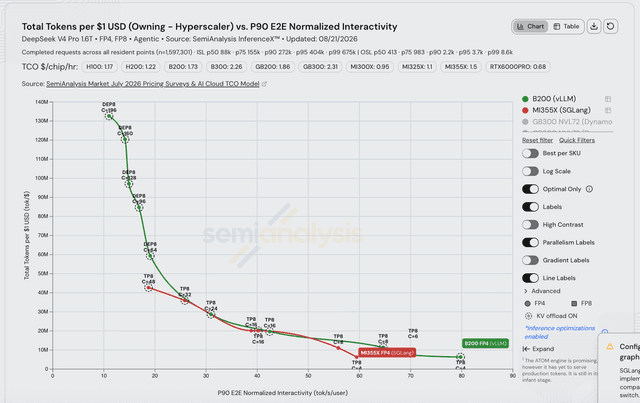
预计阅读 3 分钟
在端到端延迟的每美元性能上,AMD 一度追平 B200 vLLM,随后上游 vLLM 的优化改变了格局
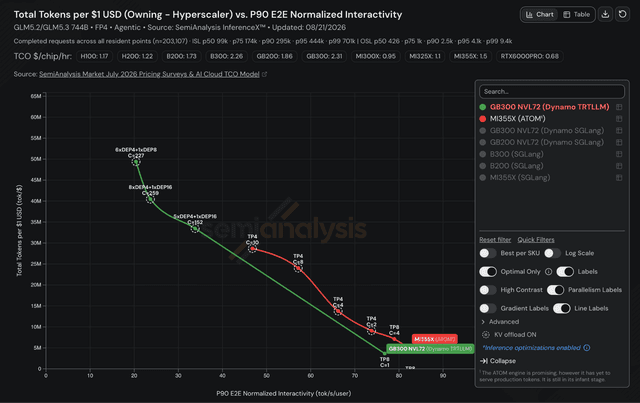
预计阅读 3 分钟
AMD 厂商引擎在每美元性能上胜出的区间,以及端到端归一化交互性究竟衡量什么
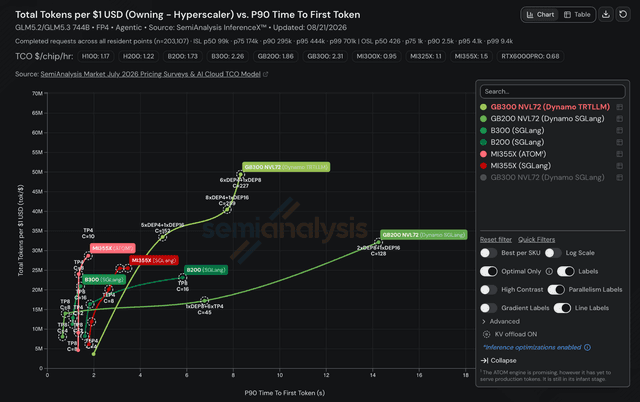
预计阅读 2 分钟
在这个运行点上,即便 AMD 硬件白送也仍然填不平差距
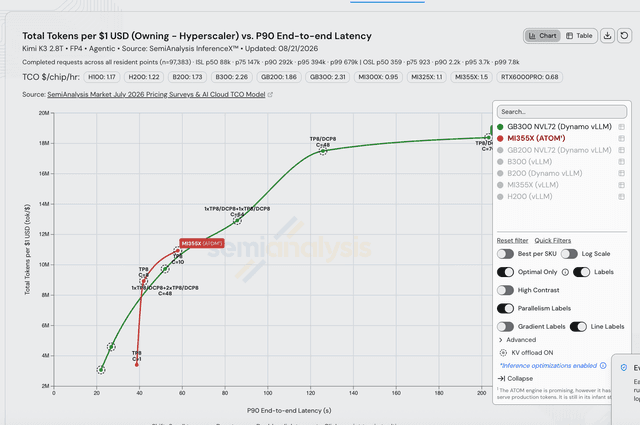
预计阅读 2 分钟
AMD 的厂商引擎在每美元性能前沿上赢下了实打实的一段,而 Hopper 连服务 K3 都很吃力
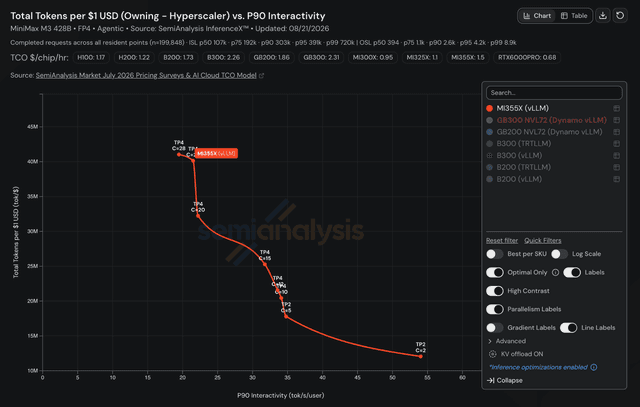
预计阅读 3 分钟
Dynamo router 成为瓶颈,没有提交使用上下文并行,而 AMD 完全没有用上 KV offload
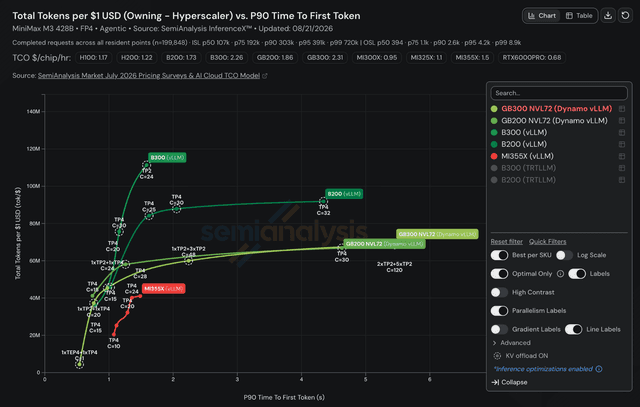
预计阅读 3 分钟
NVIDIA 横扫这个 432B 模型,而缺失的 DP attention 数据点说明了缓存局部性为何变成路由约束
预计阅读 25 分钟
OpenAI 自研 ASIC 对比 Rubin:Jalapeño 的 TCO、每兆瓦吞吐量,以及那些够辣的细节
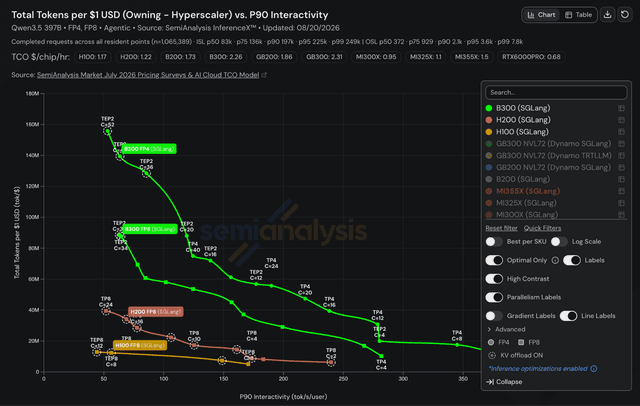
预计阅读 2 分钟
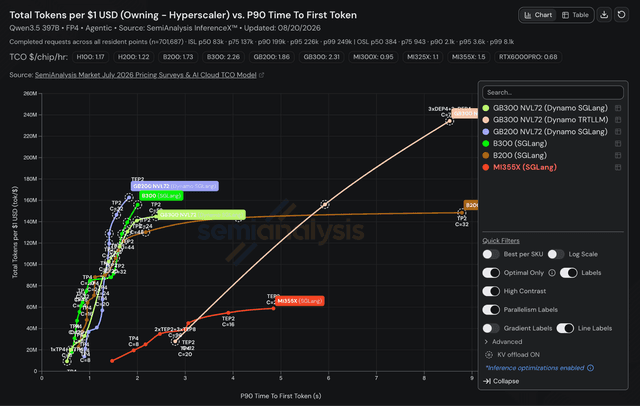
在长上下文 agentic 工作负载上,四年硬件迭代加上 4 位格式能换来什么
预计阅读 2 分钟
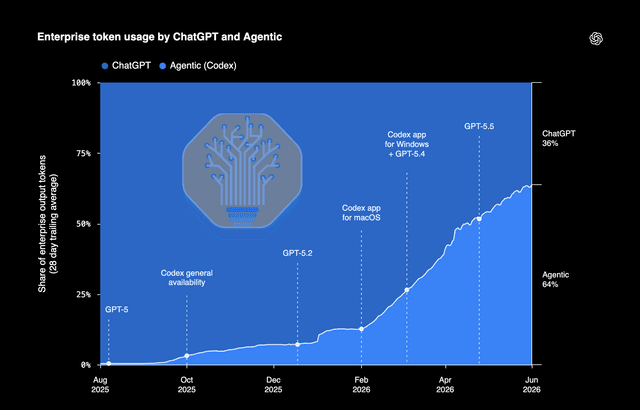
GatedDeltaNet、262k 原生上下文,以及同一引擎上 AMD 完全缺席的竞争
预计阅读 71 分钟
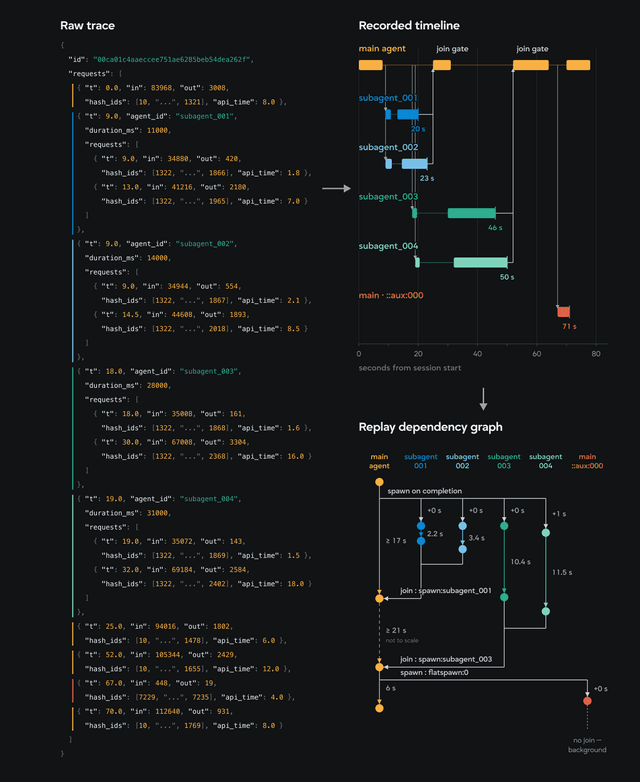
开源价值 300 万美元的数据集、100 万以上上下文长度、多轮、子智能体、95%+ KVCache 命中率、GB300 NVL72、MI355X、B200
预计阅读 12 分钟
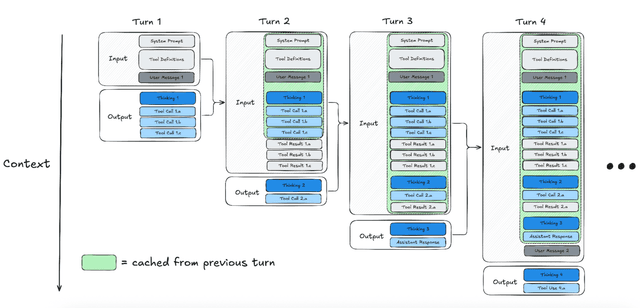
Agent Benchmark 如何回放长上下文、多轮工作负载,并测量延迟、吞吐量、cache 行为与推理服务成本
预计阅读 6 分钟
多轮会话、长上下文与近乎完全的 prefix 复用,让 agentic 推理成为一个系统问题,也改变了基准测试需要测量的内容
预计阅读 20 分钟
运行在 NVIDIA GPU 上的 TileRT 软件能否与 Cerebras、Groq LPU、SambaNova 竞争?批大小为 1、分离式引擎、高吞吐量预填充引擎、高交互性解码引擎
预计阅读 21 分钟
Rubin 基于 LUT 的 Tensor Core、Feynman、机架级架构、每兆瓦性能、每美元性能、软件改进、Rubin 公开软件栈、PyTorch、vLLM、OpenAI Triton
预计阅读 31 分钟
第0天推理性能、InferenceX、26天内性能提升100倍、每百万 token 成本、Huawei 950DT 推理 Trace 分析

预计阅读 11 分钟
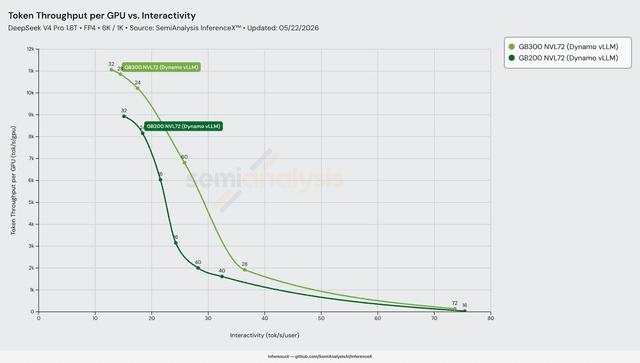
DSv4-Pro FP4 8K/1K,Dynamo+vLLM,两套机架均采用分离式部署。GB300 多出 50% 的 HBM(每 GPU 288 GB vs 192 GB)解锁了 GB200 无法容纳的更宽预填充+解码配方——尽管单 GPU TCO 溢价 20%,曲线中段性价比仍提升 2.31 倍。

预计阅读 11 分钟
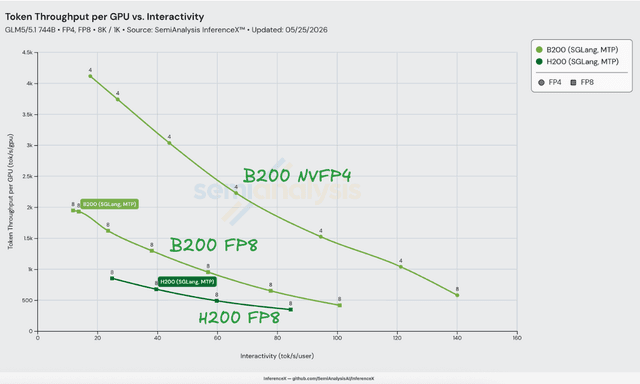
两款 GPU 均运行 SGLang EAGLE MTP;Blackwell 世代在峰值处带来约 1.2 倍的性价比提升,NVIDIA GLM-5-NVFP4 检查点搭配 FlashInfer TRT-LLM 稀疏 MLA 在 8K/1K 场景下再叠加约 2.4–3.0 倍优势

预计阅读 13 分钟
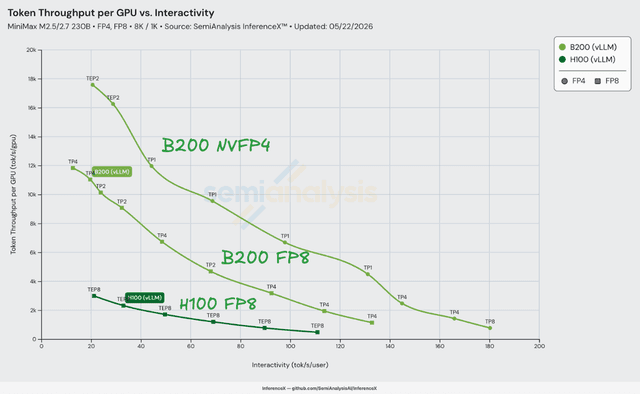
vLLM PR #36307 为 MiniMax 在 B200 上解锁了 trtllm-gen FP8 MoE 模块化内核;结合 NVFP4,在 8K/1K 负载下性能/成本从 22 tok/s/user 时的 4.0 倍扩大到 110 tok/s/user 时的 8.2 倍

预计阅读 12 分钟
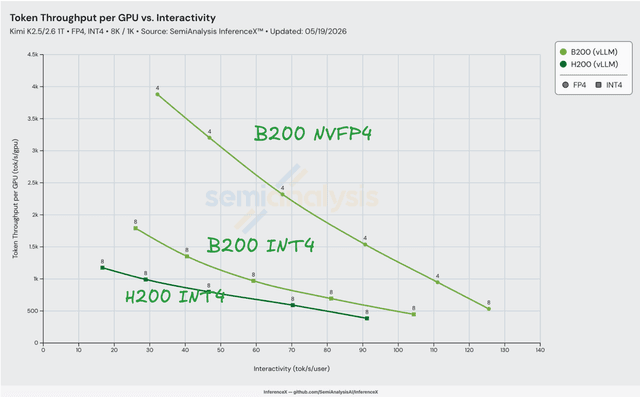
在 vLLM 8K/1K 工作负载下,B200 NVFP4 路径在 30–90 tok/s/user 推理区间内每百万 tokens 成本比 H200 INT4 低 2.71x–2.95x,比同一 B200 硬件上的 INT4 低 2.45x–2.74x。三个因素——B200 的 HBM 带宽、HBM 容量和 NVFP4 张量核心——可清晰分解该优势

预计阅读 14 分钟
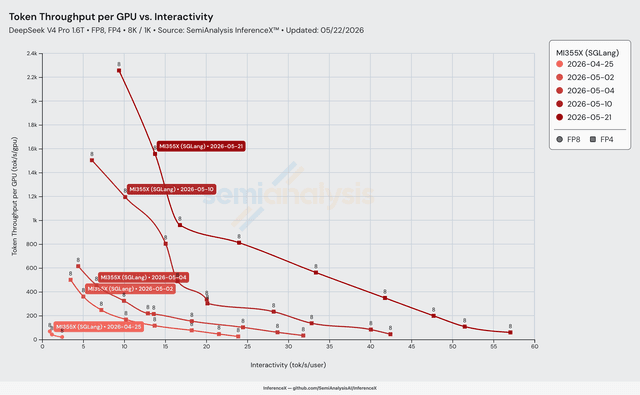
amd/deepseek_v4 分支合入了 TileLang 注意力索引器、Triton 稀疏 MLA、融合 RoPE/Hadamard、FlyDSL MoE 以及 FP4 权重,历经 31 个性能优化 PR——将首次点亮时 20 tok/s/GPU、2.4 tok/s/user 的水平提升至 8K/1K 负载下 2,256 tok/s/GPU、9.4 tok/s/user,吞吐量与交互性同步攀升

预计阅读 7 分钟
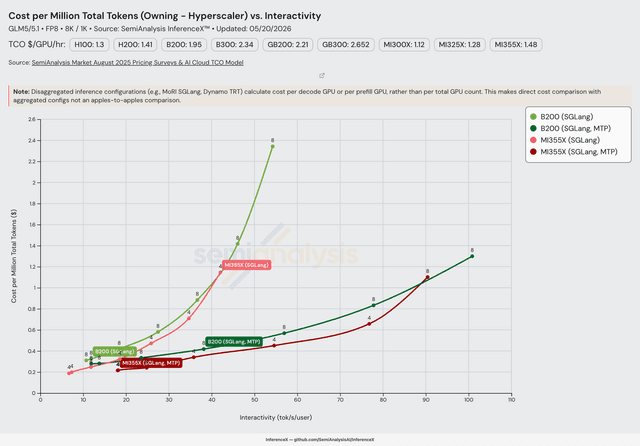
GLM-5 发布 14 周后,AMD 在 MI355X 上同时实现了 SGLang FP8 的 MTP 和非 MTP 方案 — 通过 TileLang 实现的融合 MLA + FP8 KV 缓存在大部分性能 Pareto 前沿上将单节点 FP8 成本曲线翻转为 AMD 占优

预计阅读 7 分钟
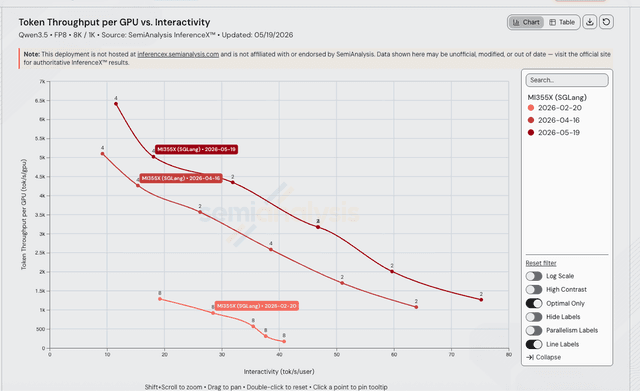
从 v0.5.8(2 月)→ v0.5.10rc0(4 月)→ v0.5.12(5 月),三次 AITER 内核合入 MI355X 加上从 TP=8 到 TP=2/TP=4 的重新调优,将 Qwen3.5 8k/1k 峰值从 1.3k 推高至 6.4k tok/s/GPU,并将曲线延伸至 75 tok/s/user

预计阅读 9 分钟
DeepSeek R1 FP4 1k/1k。NVL72 的 72-GPU NVLink 扩展域允许解码使用最高 EP=32 的宽专家并行,而 B200 的 8-GPU NVLink 岛通过 RoCEv2 上限为 EP=8

预计阅读 5 分钟
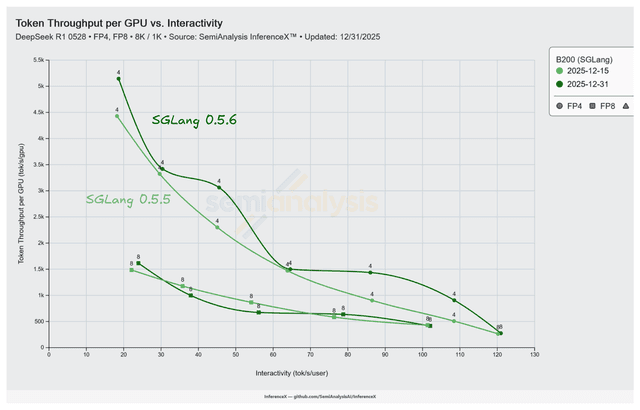
针对 DeepSeek V3 的分段 CUDA graph、统一事件循环和 JIT 内核将 8k/1k 吞吐量从 508 提升至 907 tok/s/GPU,使用相同的 16 GPU B200 资源池

预计阅读 7 分钟
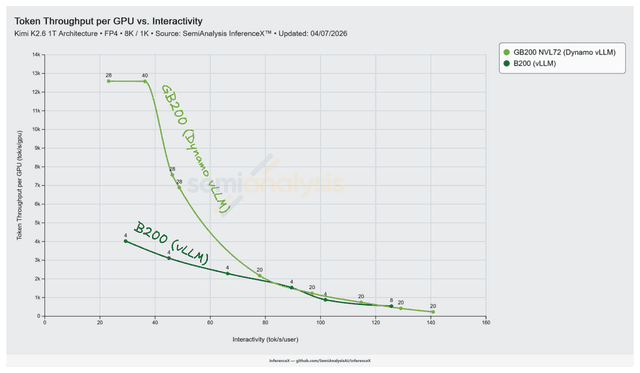
NVL72 的机架级 NVLink 使 Dynamo vLLM 能够以最高 Decode EP 16 运行 Kimi K2.5 宽 EP,在 8k/1k NVFP4 下峰值吞吐量从 4,021 提升至 12,587 tok/s/GPU

预计阅读 7 分钟
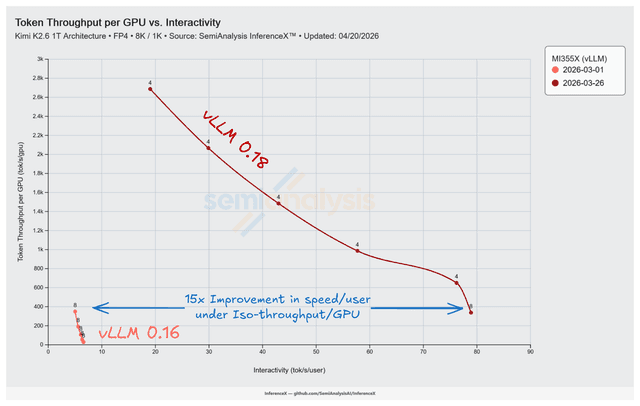
vLLM PR #35850 修复了 MI355X CDNA4 上的 AITER MLA 分发路径,解锁 TP=8 下的 Kimi K2.5 推理性能,随 vLLM 0.18 一同发布
预计阅读 50 分钟
GB300 NVL72、MI355X、B200、H100、分离式推理、宽专家并行、大规模混合专家、SGLang、vLLM、TRTLLM
预计阅读 40 分钟
NVIDIA GB200 NVL72、AMD MI355X、每 GPU 吞吐量 Token、延迟 Tok/s/user、性价比、每百万 Token 成本、每配置兆瓦 Token 数、DeepSeek R1 670B、GPTOSS 120B、Llama3 70B