本文最初于 2026-10-21 发表于 SemiAnalysis newsletter,作者为 Bryan Shan、Dylan Patel。
本次转载保留原文公开可读的部分。测试结果、软件可用性、预测及相关限定均属于原文发表时的陈述,不是新一轮测试,也不是当前的兼容性清单。订阅者专享的后续内容仍在原文。
转载编者注:原文有关 CANN 和 HDK 的段落混用了不同撰稿时间的表述,转载保留其原貌。原文中格式有误的 DeepEP-Ascend 文档链接已修复为文中引用过的项目仓库。
就在中国国庆假期前,DeepSeek 为 TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect 发布了 Ascend 支持。
双方都无法独自完成这件事。Huawei 虽然有盘古,却没有前沿模型实验室来证明其芯片能够训练或运行这类模型;DeepSeek 有模型,却买不到所需的算力。双方恰好各有所长:Huawei 提供硬件及原生软件栈,DeepSeek 提供工作负载,并投入工程资源,让这些硬件真正适合自己的模型。9 月 30 日,DeepSeek 仓库加入 Ascend 支持,正是这种合作的具体成果,而 kernel 编程语言是双方协作的接口。
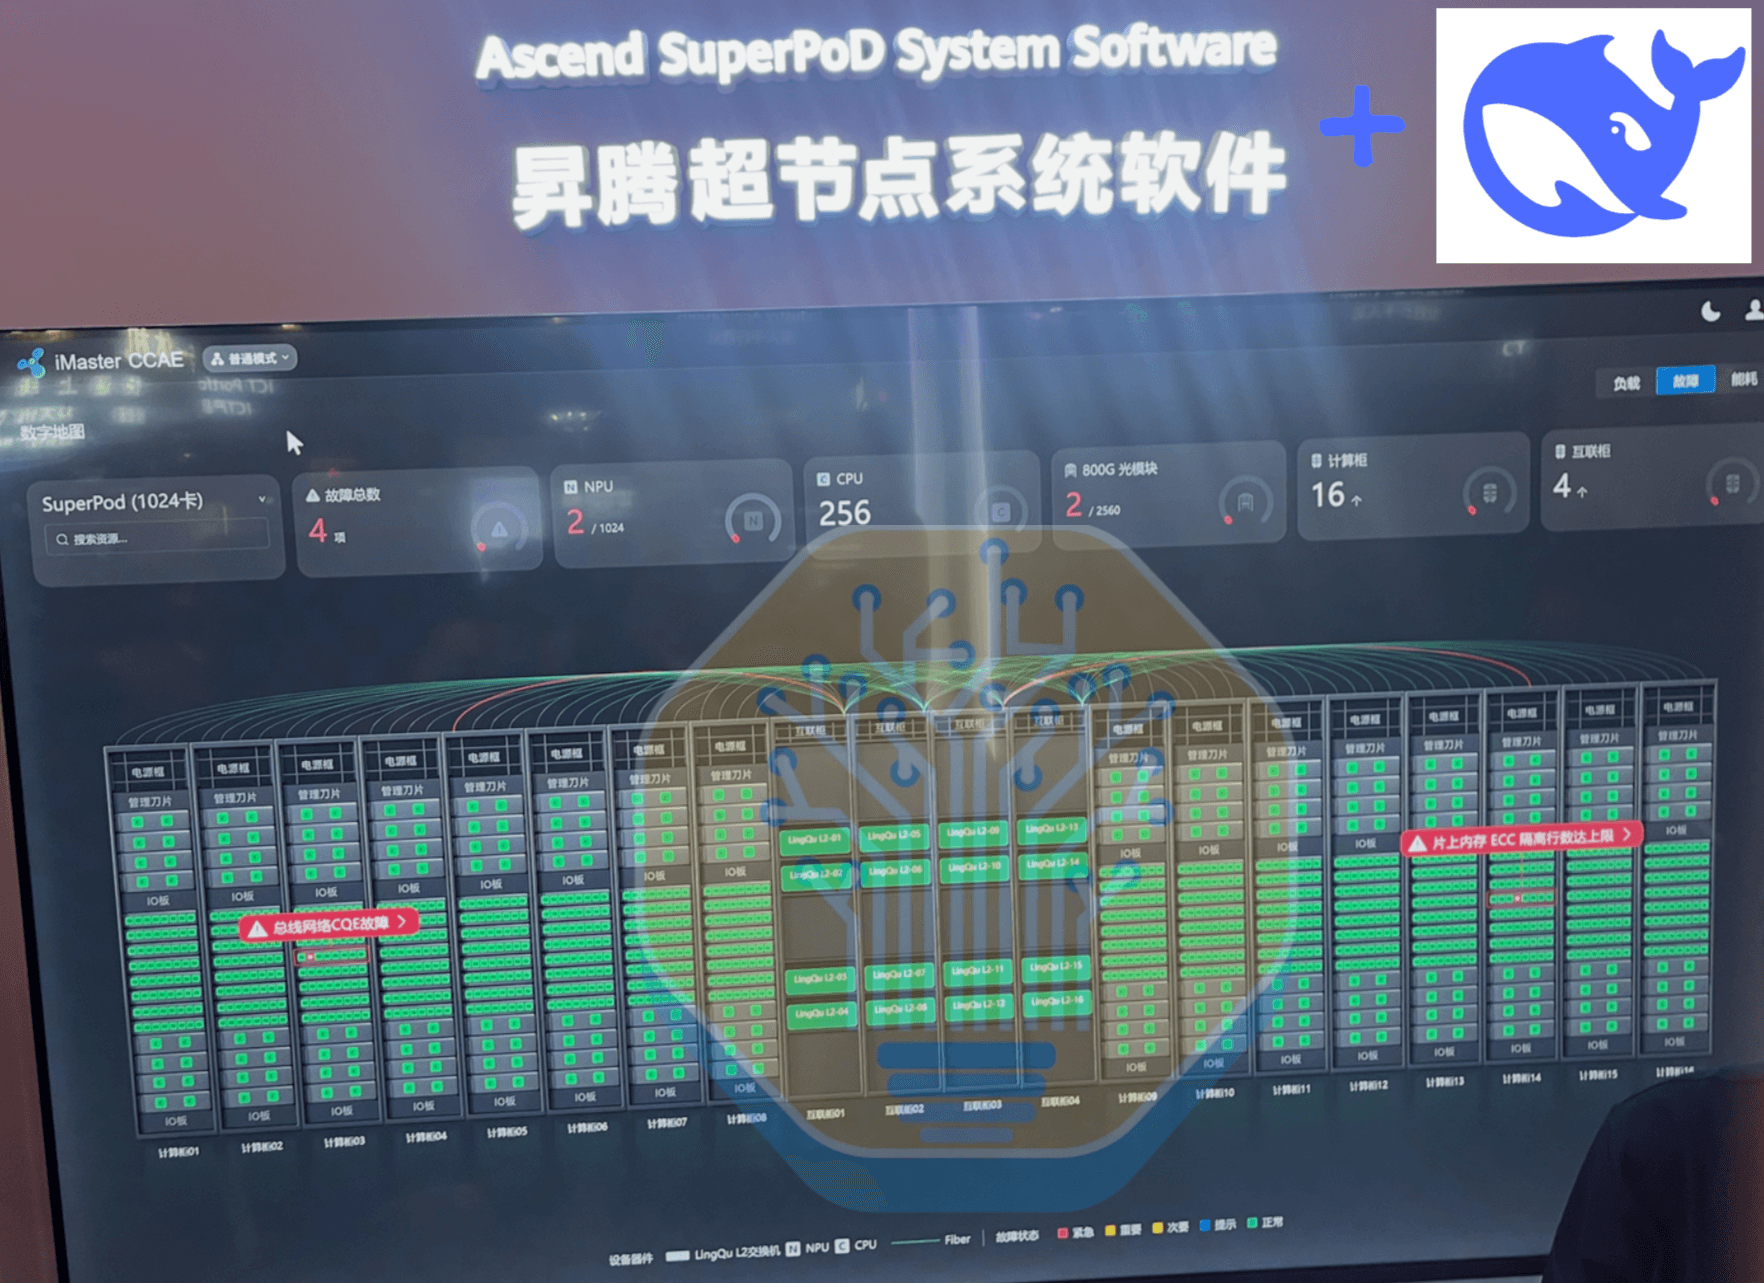
到 2028 年,甚至 2027 年,DeepSeek 很可能主要使用 Huawei 的软件栈,尤其是在内外部都要求建立完整中国本土生态的压力下。正如本文及后续文章将展示的,Huawei 生态已经相当成熟,既有 Ascend 团队打下的基础,也有 DeepSeek 工程师继续完善。
本文先分析 Ascend 950PR 的架构,并测试其计算和内存性能,再讨论 DeepSeek 发布的软件,从 TileLang 编译器能力到硬件专属 kernel 优化和机架级通信,最后分析 DeepSeek-V4.1-Flash 的执行 profile。
Ascend 950
我们曾在 DeepSeek V4 Pro 文章中深入讨论 CANN 和 Ascend 950 架构。此后又出现了一些值得关注的新细节。
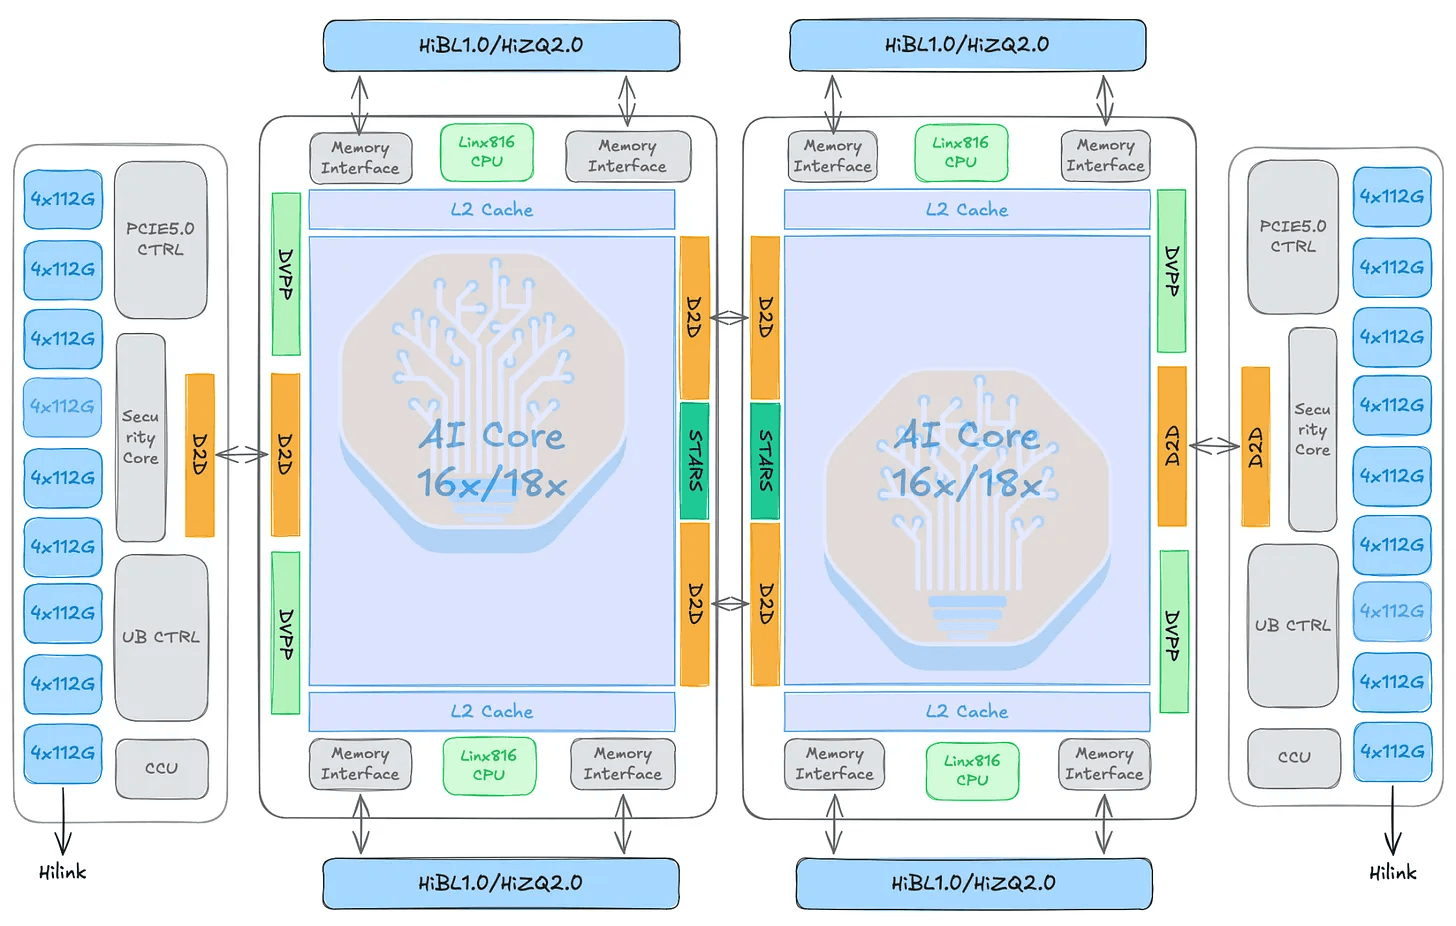
先看芯片。目前出现了多种 950PR/DT 配置,核心数、HBM 堆叠高度和 cache 容量各不相同,其中一些可能是虚拟或模拟配置,也可能仅用于测试。由于制造缺陷以及功耗、性能等参数不达标,只有部分裸片和 HBM 堆栈能够满足目标规格。因此,Huawei 同时对计算和内存进行分档,形成多个 SKU,并将较弱的内存与较弱的计算配置搭配,而不是像 Nvidia 那样只对计算部分分档。
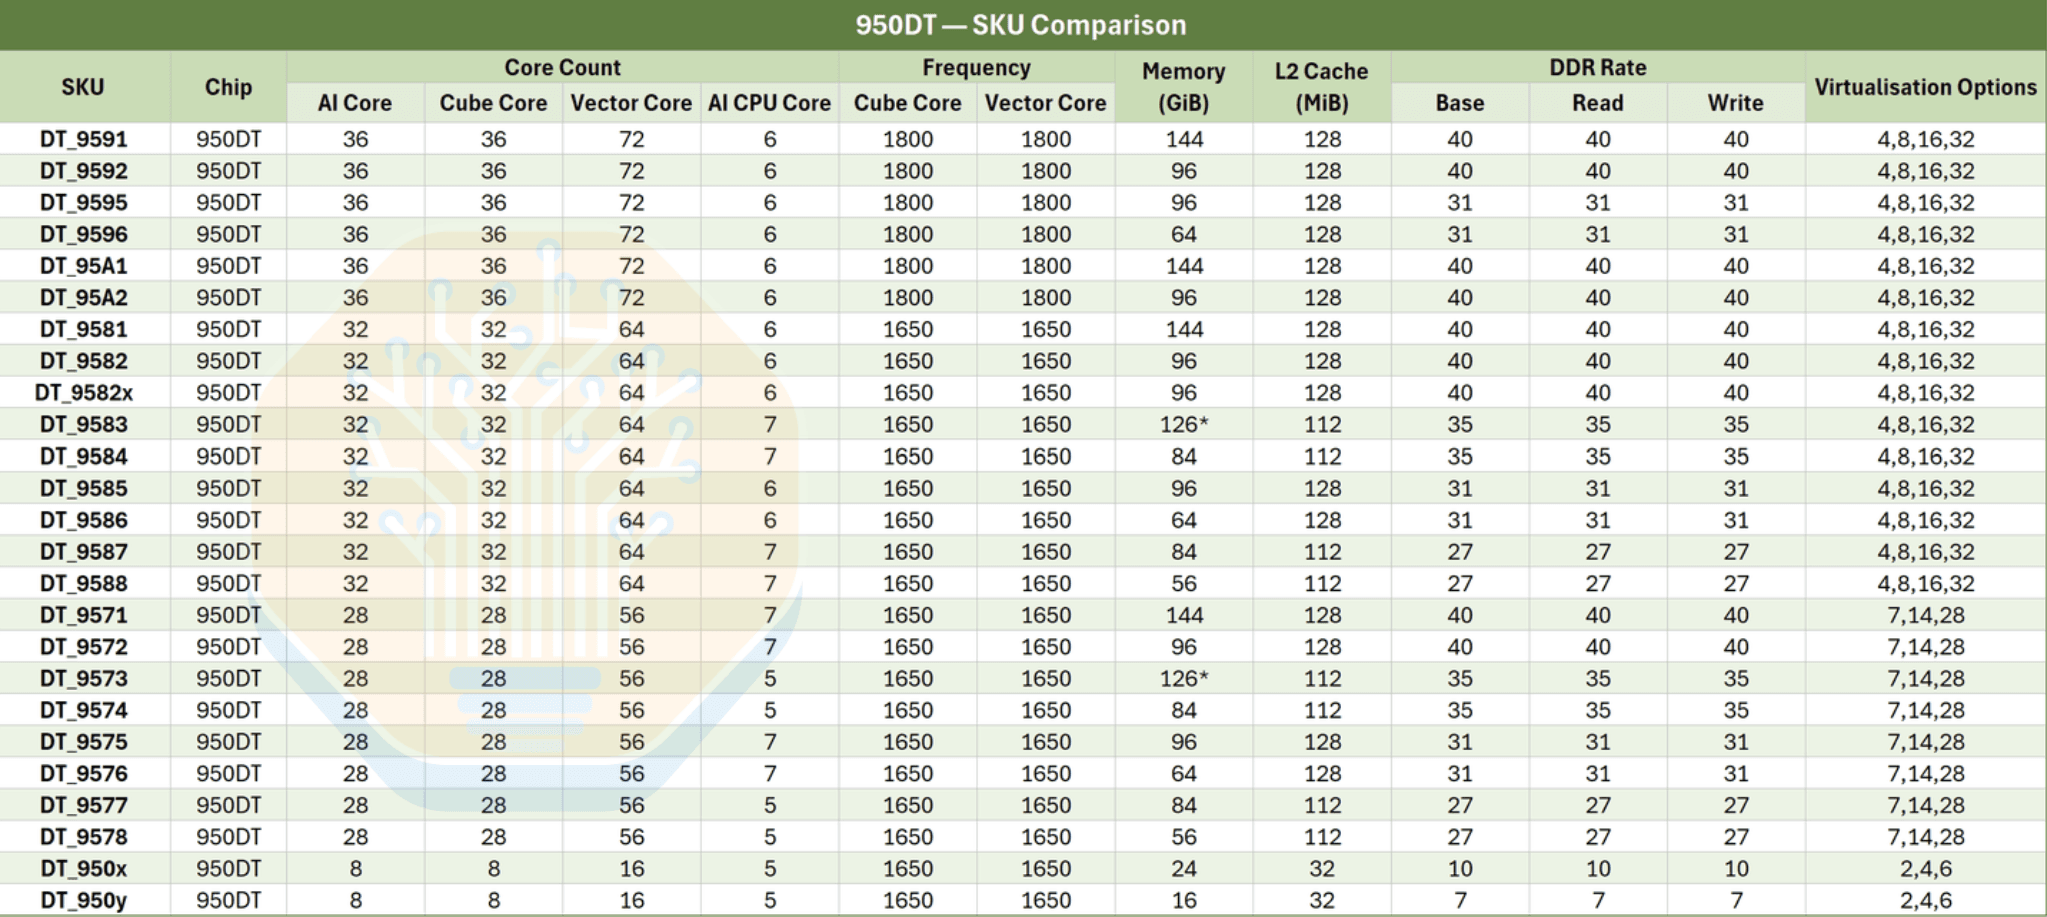
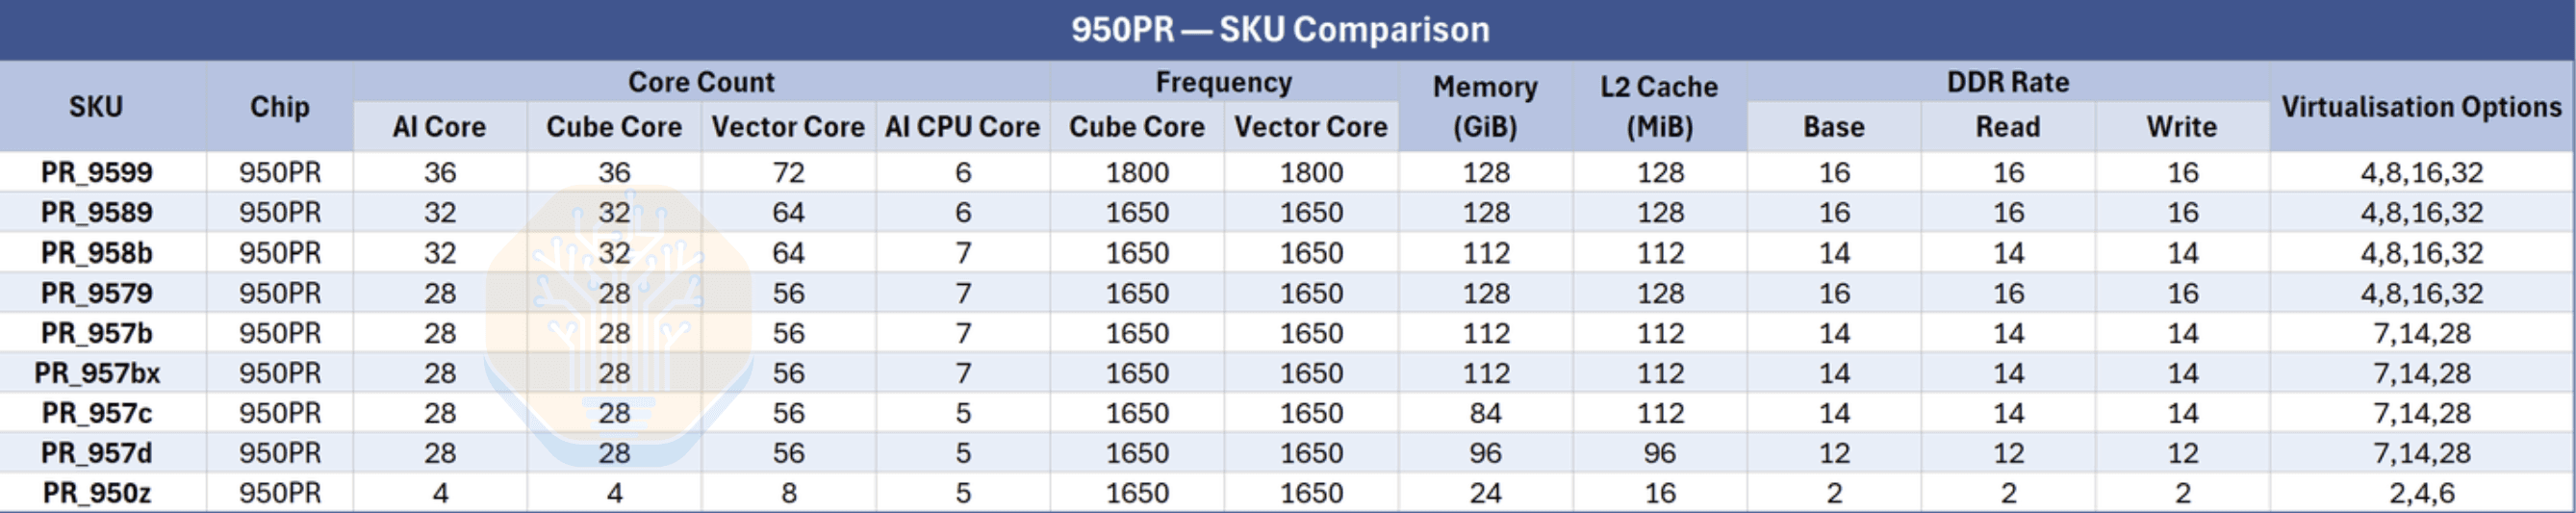
这并不是新做法,910B 也有 910B1、910B2、910B3、910B4 等版本。下面的微基准测试使用 Ascend 950PR_9579,配备 28 个 Cube 核心和 128 GiB HBM。
root@cb3bb851f93f:/workspace# npu-smi info
+-------------------------------------------------------------------------------------------------+
| npu-smi 25.7.rc1.6                               Version: 25.7.rc1.6                            |
+--------+------------------+---------------+-----------------------------------------------------+
| NPU ID | Name             | Health        | Power(W)    Temp(C)           Hugepages-Usage(page) |
|        |                  | Bus-Id        | NPU Util(%) Memory-Usage(MB)  HBM-Usage(MB)         |
+========+==================+===============+=====================================================+
| 0      | Ascend950PR      | OK            | 203.3       56                0     / 0             |
|        |                  | 0000:12:00.0  | 0           0    / 0          5242  / 131072        |
+========+==================+===============+=====================================================+
+---------------------------+---------------+-----------------------------------------------------+
| NPU ID                    | Process id    | Process name             | Process memory(MB)       |
+===========================+===============+=====================================================+
| No running processes found in NPU 0                                                             |
+===========================+===============+=====================================================+
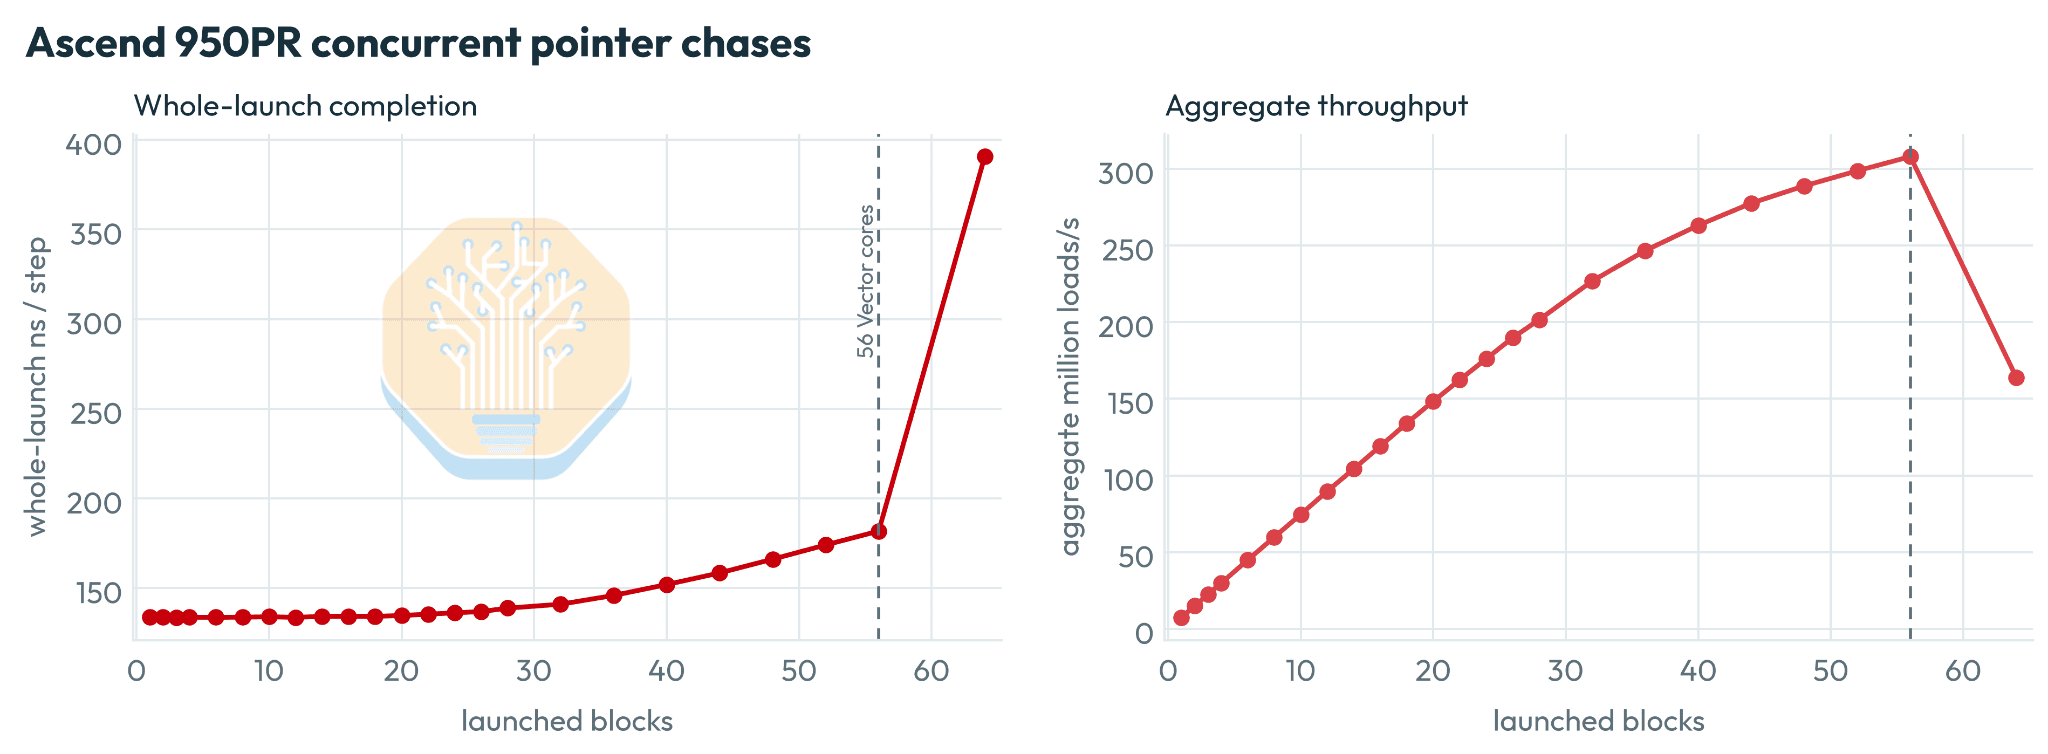
每次 launch 读取 16 KiB 整数数据的指针追踪测试中,延迟在 18 个 block 以内保持在约 134 ns,到 56 个 block 时上升至 182 ns,到 64 个时跳至 391 ns。这与超过 56 个 Vector 核心后需要第二轮执行的情况相符。
接着,我们分别在每个 Cube 和 Vector 核心上运行标量指针追踪探针,记录遍历 128 MiB 链时相同地址的 load 延迟,得到下图。每个单元格的颜色表示两个核心地址延迟曲线的平均绝对差,结果形成两组,与解码得到的两个裸片对应。
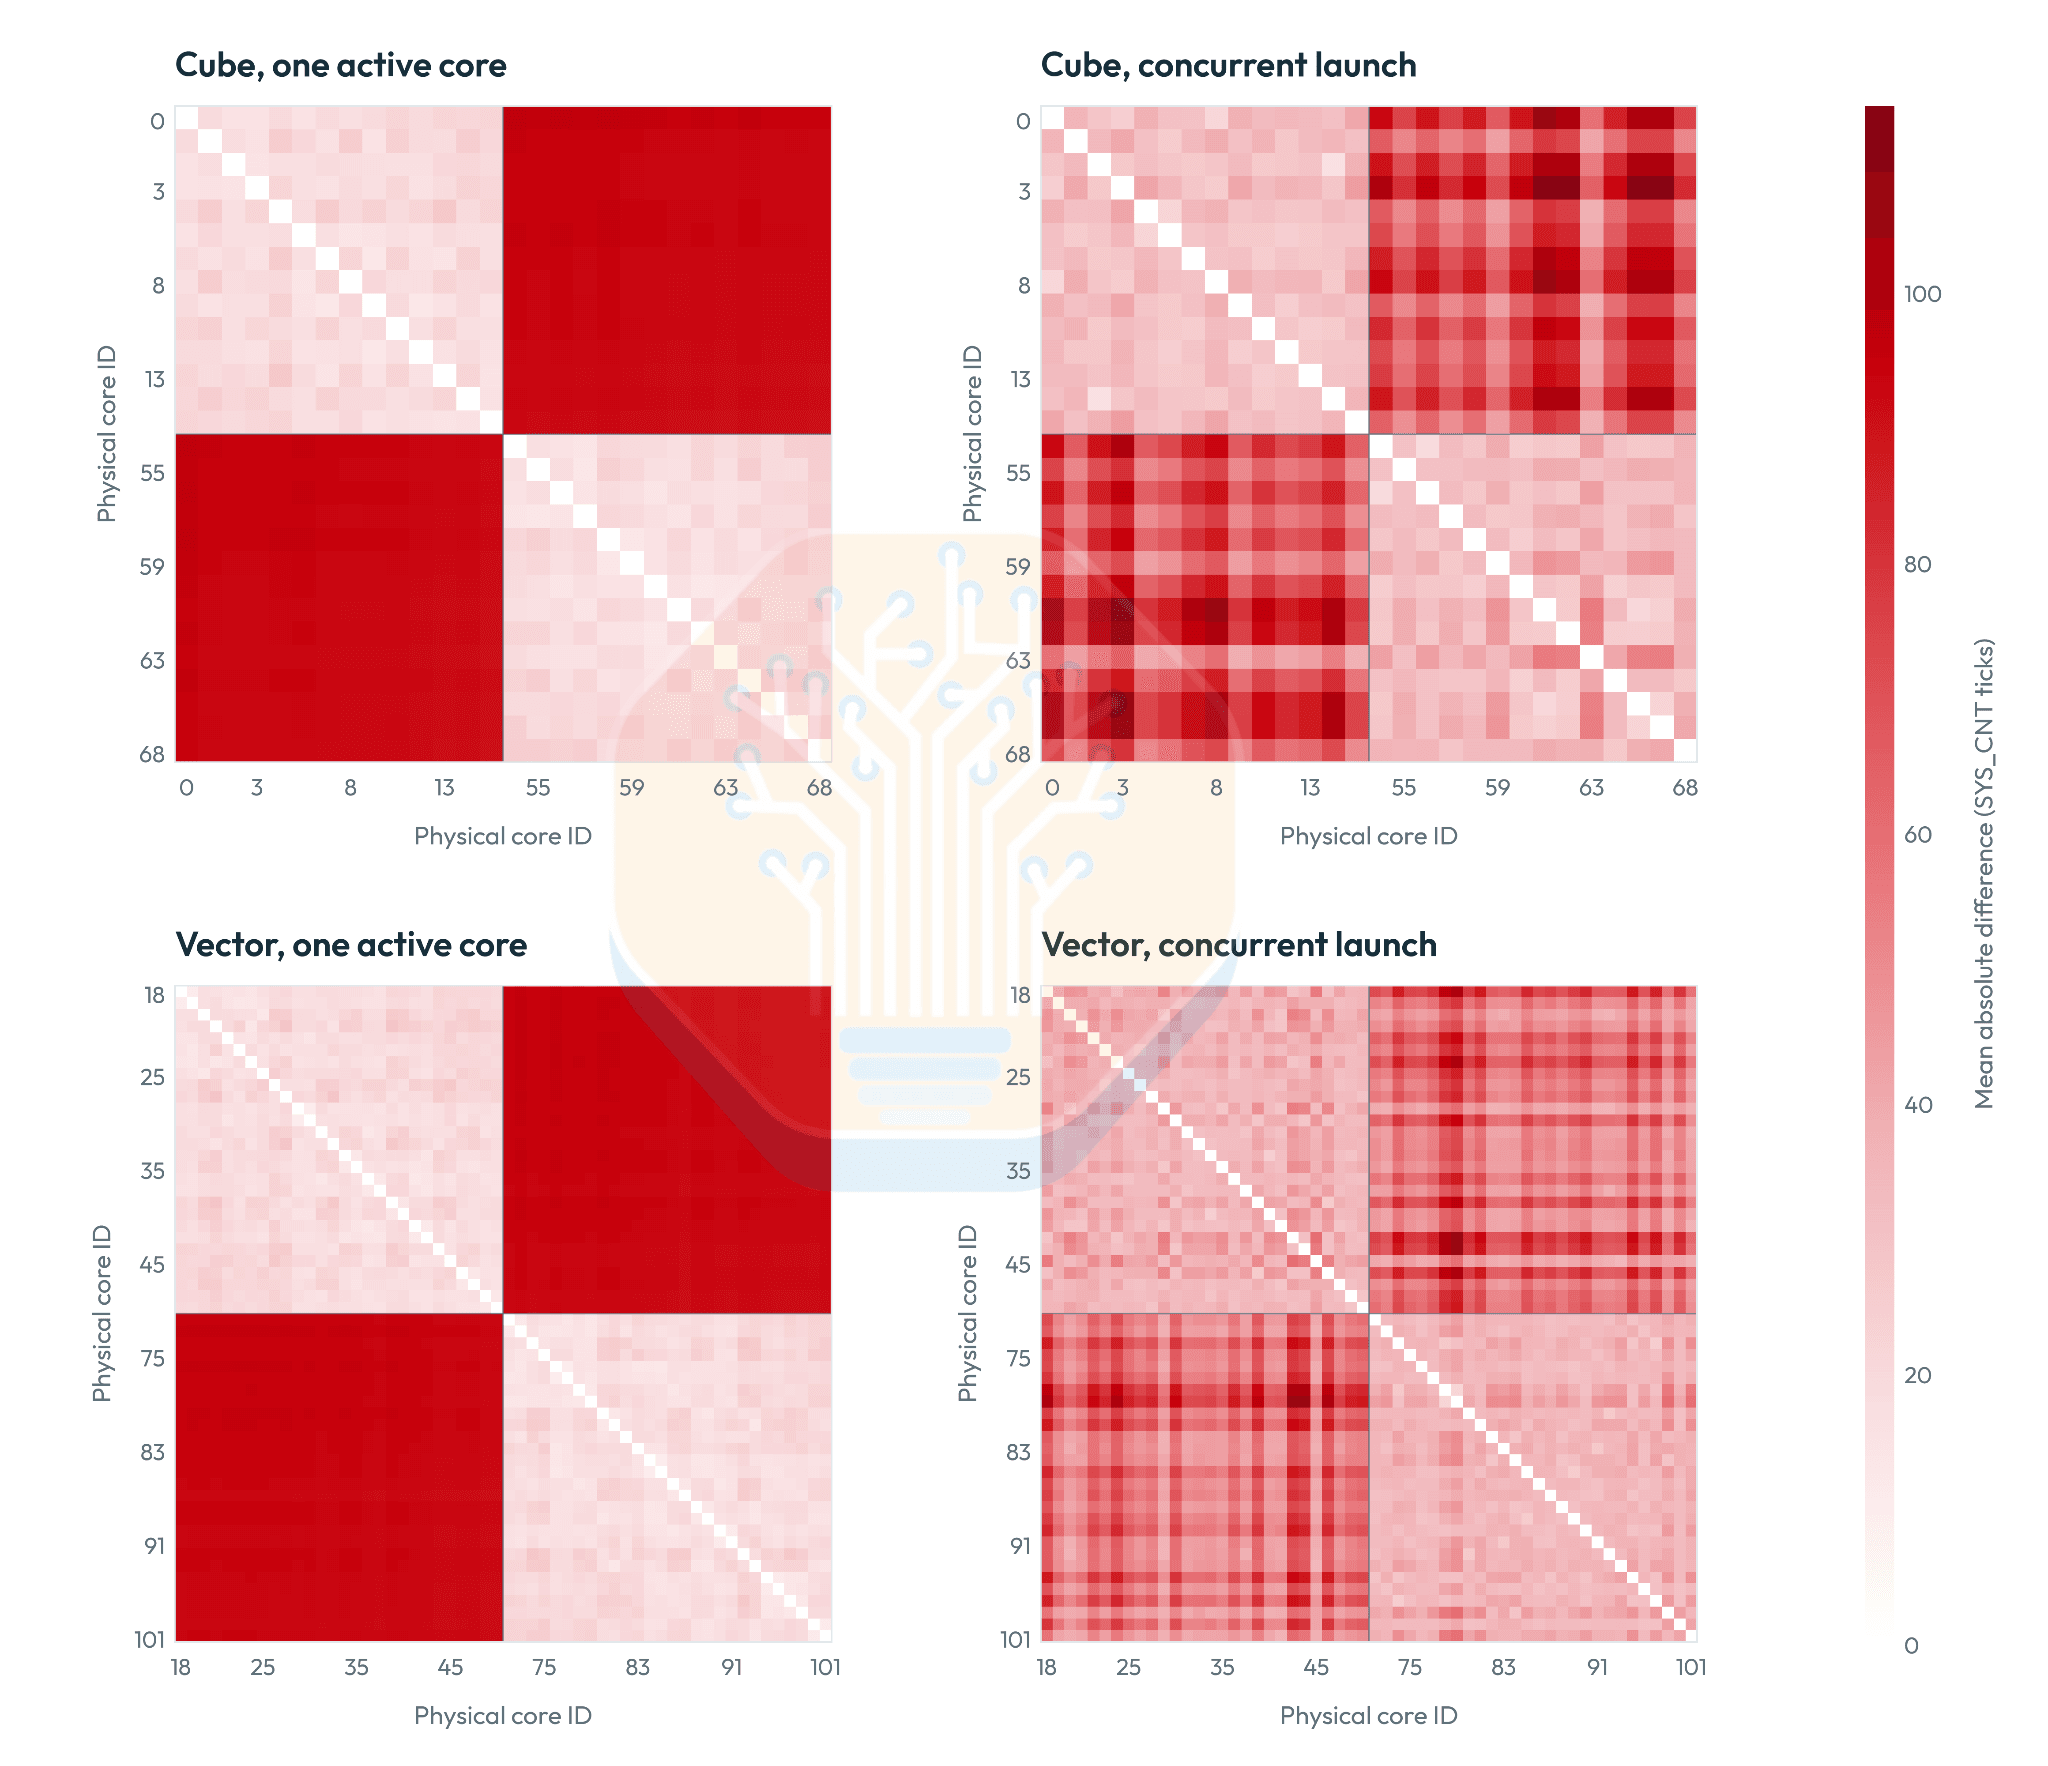
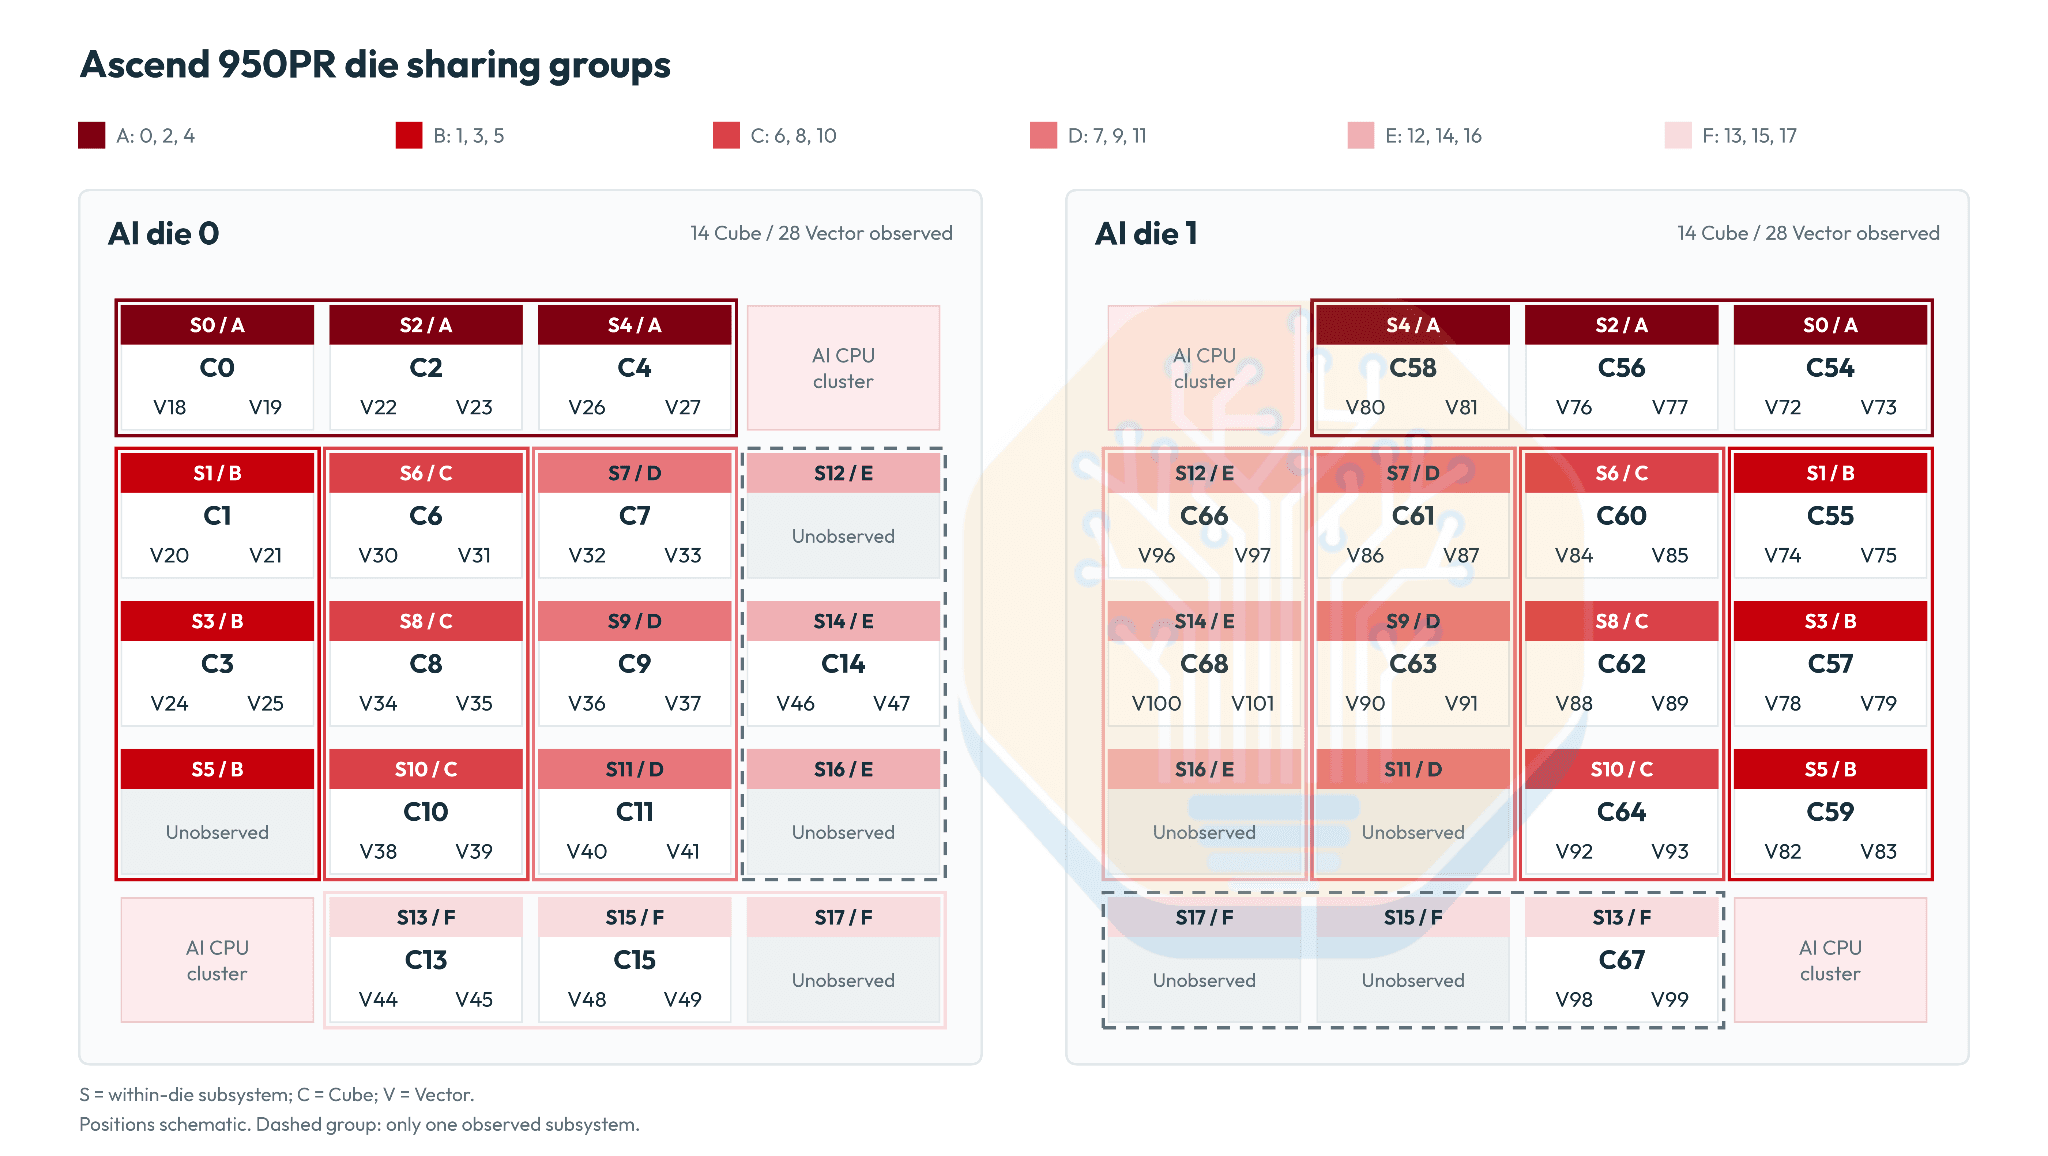
再进一步,我们让一个 Vector 核心执行指针追踪,同时让另一个核心产生内存流量或只做寄存器运算。额外的减速能够揭示哪些子系统共享资源,支持 {0,2,4} 和 {1,3,5} 这样的分组。混合 Cube/Vector launch 则可识别各子系统中的一个 Cube 和两个 Vector。图中把它们画在相应组内,但物理位置仍只是示意。
NPU 内的 CPU
每个 950PR 都带有数量不等的 Linx816 AArch64 ELF AICPU。MIDR 编号表明,这些核心很可能与 Kirin 9000S/9010 的中核相同。AICPU 支持以下指令集:
fp asimd evtstrm aes pmull sha1 sha2 crc32 atomics fphp asimdhp cpuid
asimdrdm jscvt fcma lrcpc dcpop sha3 sm3 sm4 asimddp sha512 sve
asimdfhm dit uscat ilrcpc flagm ssbs sb paca pacg dcpodp flagm2
frint svei8mm svebf16 i8mm bf16 dgh rng ecv
该 SKU 配置了 7 个 AICPU 核心,其中 6 个可见、5 个执行任务。除设备控制外,AICPU 还可承担 KV 元数据等 CPU 算子工作。对耗时很短、D2H 开销占主要部分的操作,AICPU 能够发挥作用。
在 DSA 中,一个小型调度步骤读取当前序列长度,再把 indexer 工作分配给加速器核心。Cube/Vector 核心随后计算 INT8 indexer 分数,并选出前 2,048 个索引。vLLM-Ascend 实现中的这些规划、索引选择和 gather 步骤在 AICPU 上运行,我们将其性能与在主机 CPU 上执行的情况进行比较。
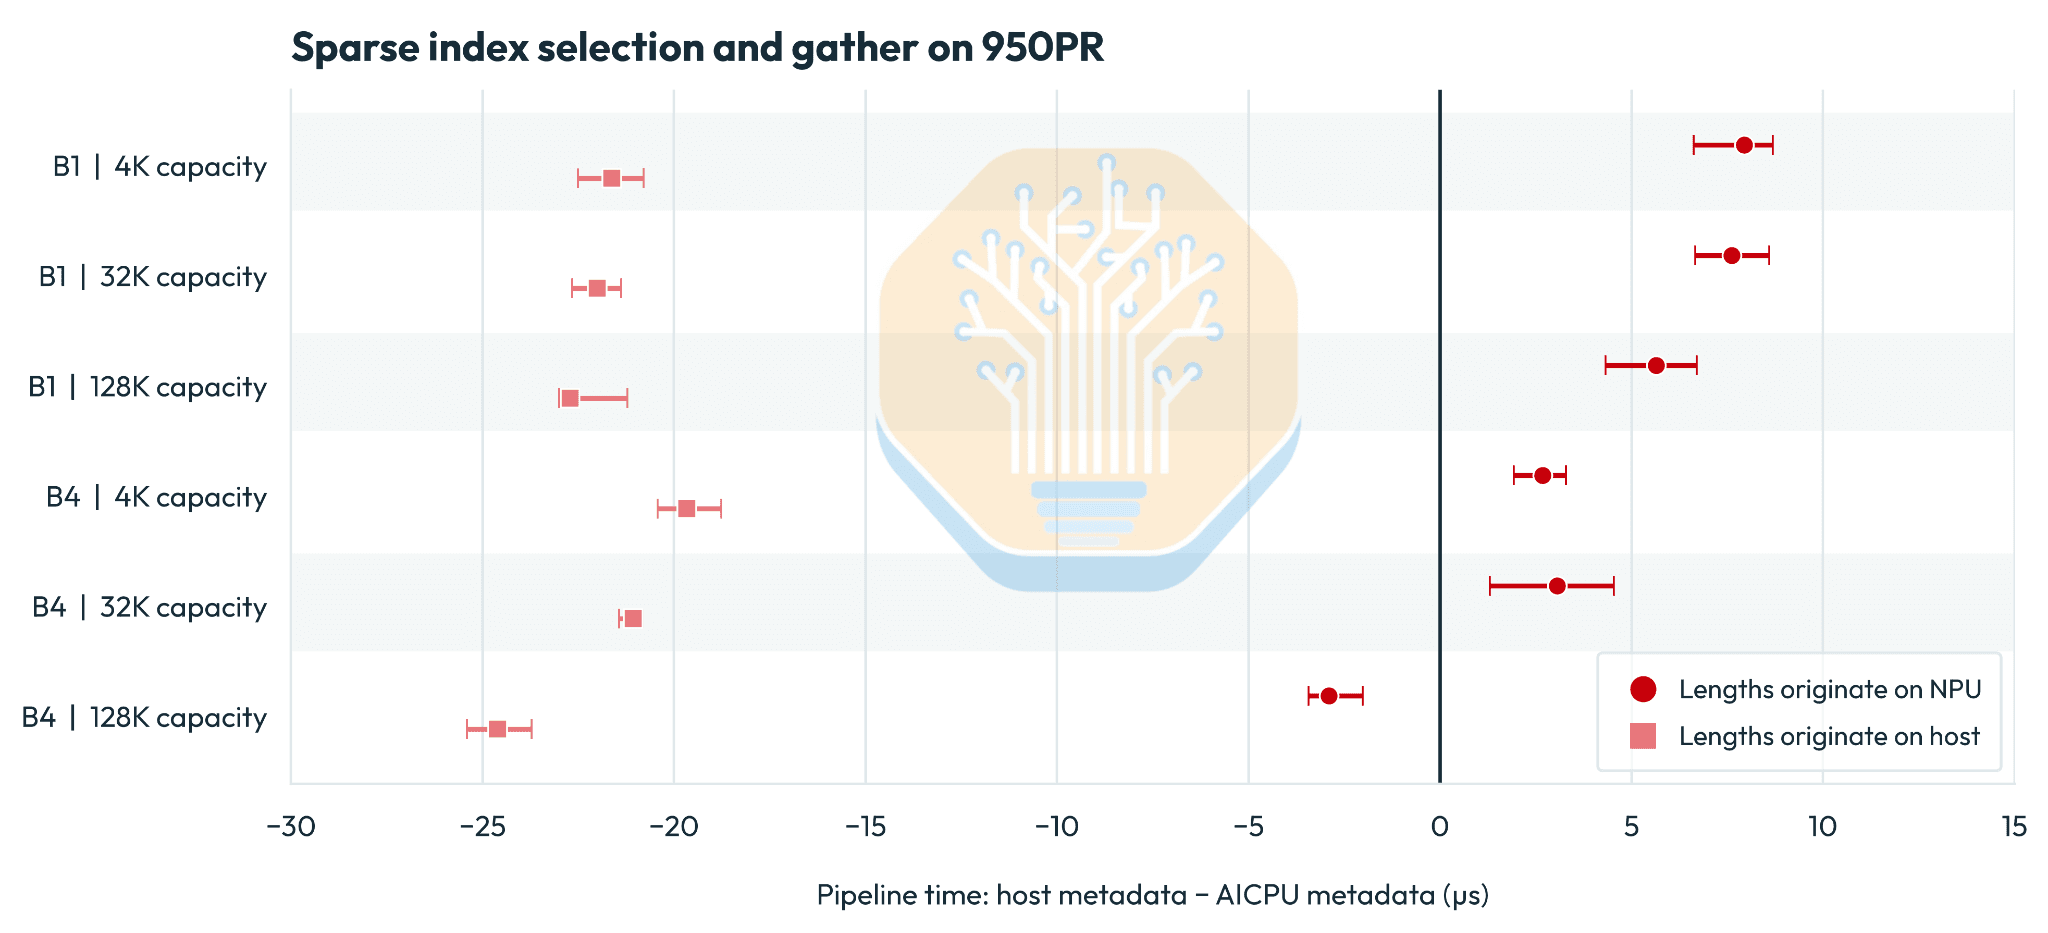
由于计算能力有限,AICPU 适合开销主导的短任务,以及数据本来就在 NPU 上、结果也在 NPU 上消费的工作。
微基准测试
Ascend 950PR 面向 prefill 和推荐工作负载,其内存带宽和核心数低于定位更高的 950DT。
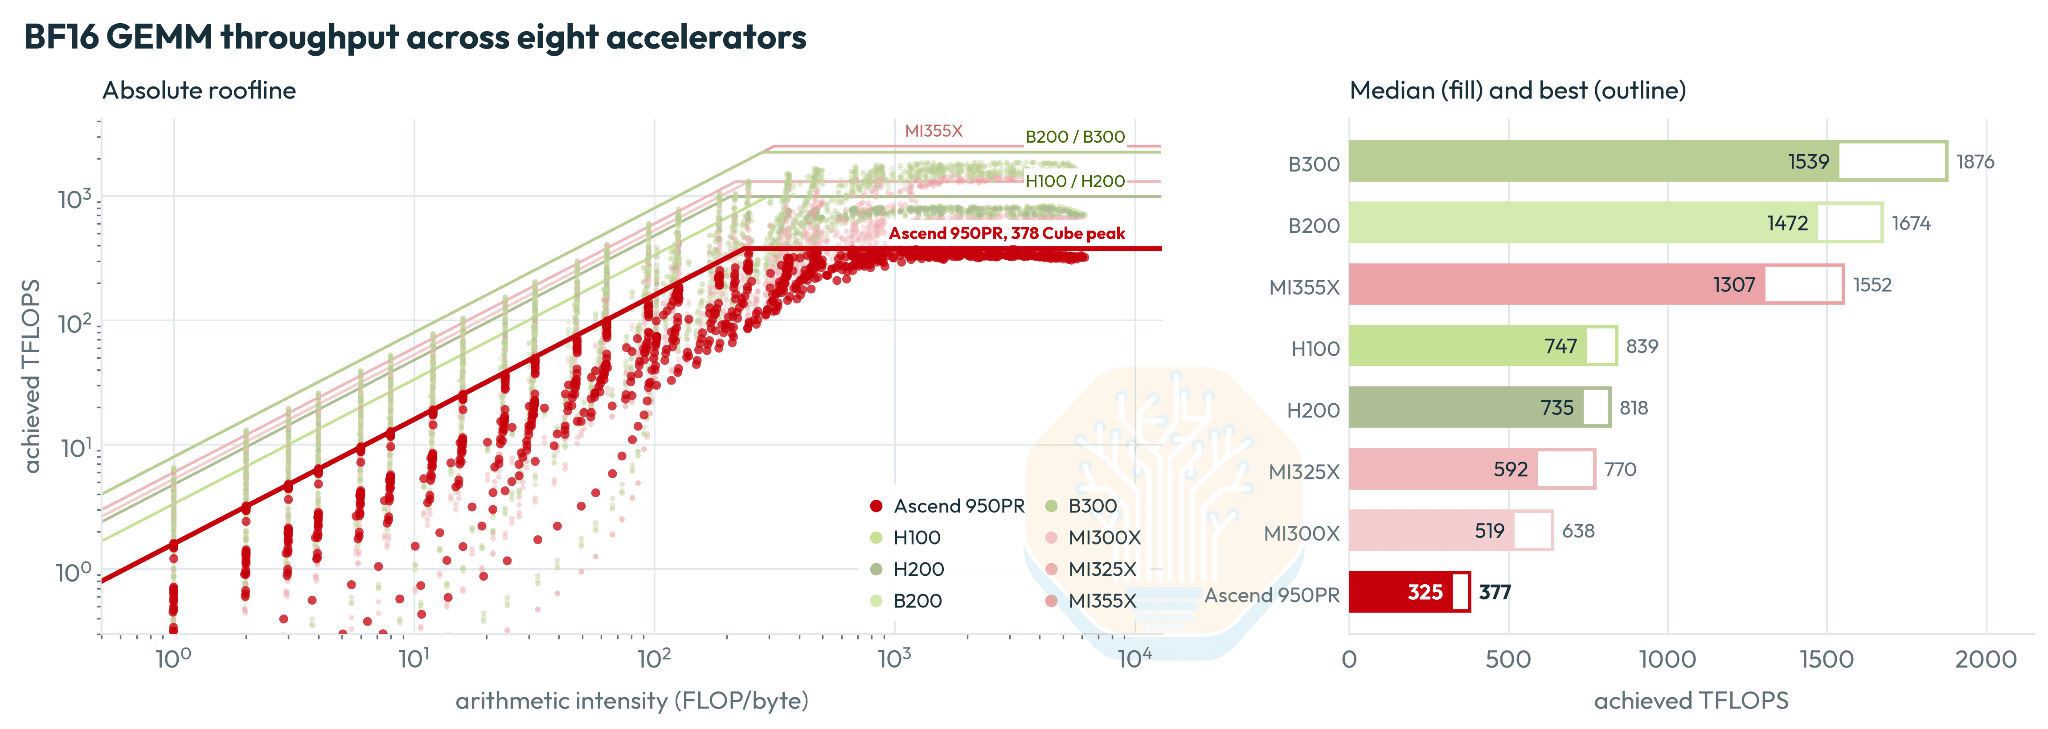
下面的结果并非来自 DeepSeek 的贡献,而是 Ascend 上原生 torch.matmul 调用 aclnnMatmul_MatMulV3Common_MatMulV3 得到的。我们比较了多个开源模型中的 1,055 种 BF16 GEMM 形状。Huawei 最好的 kernel 达到性能上限的 99.7%,说明 DeepSeek 的 DeepGEMM 所实现的 99+% 并非逼近上限的唯一途径,Huawei 工程师同样做得很好。
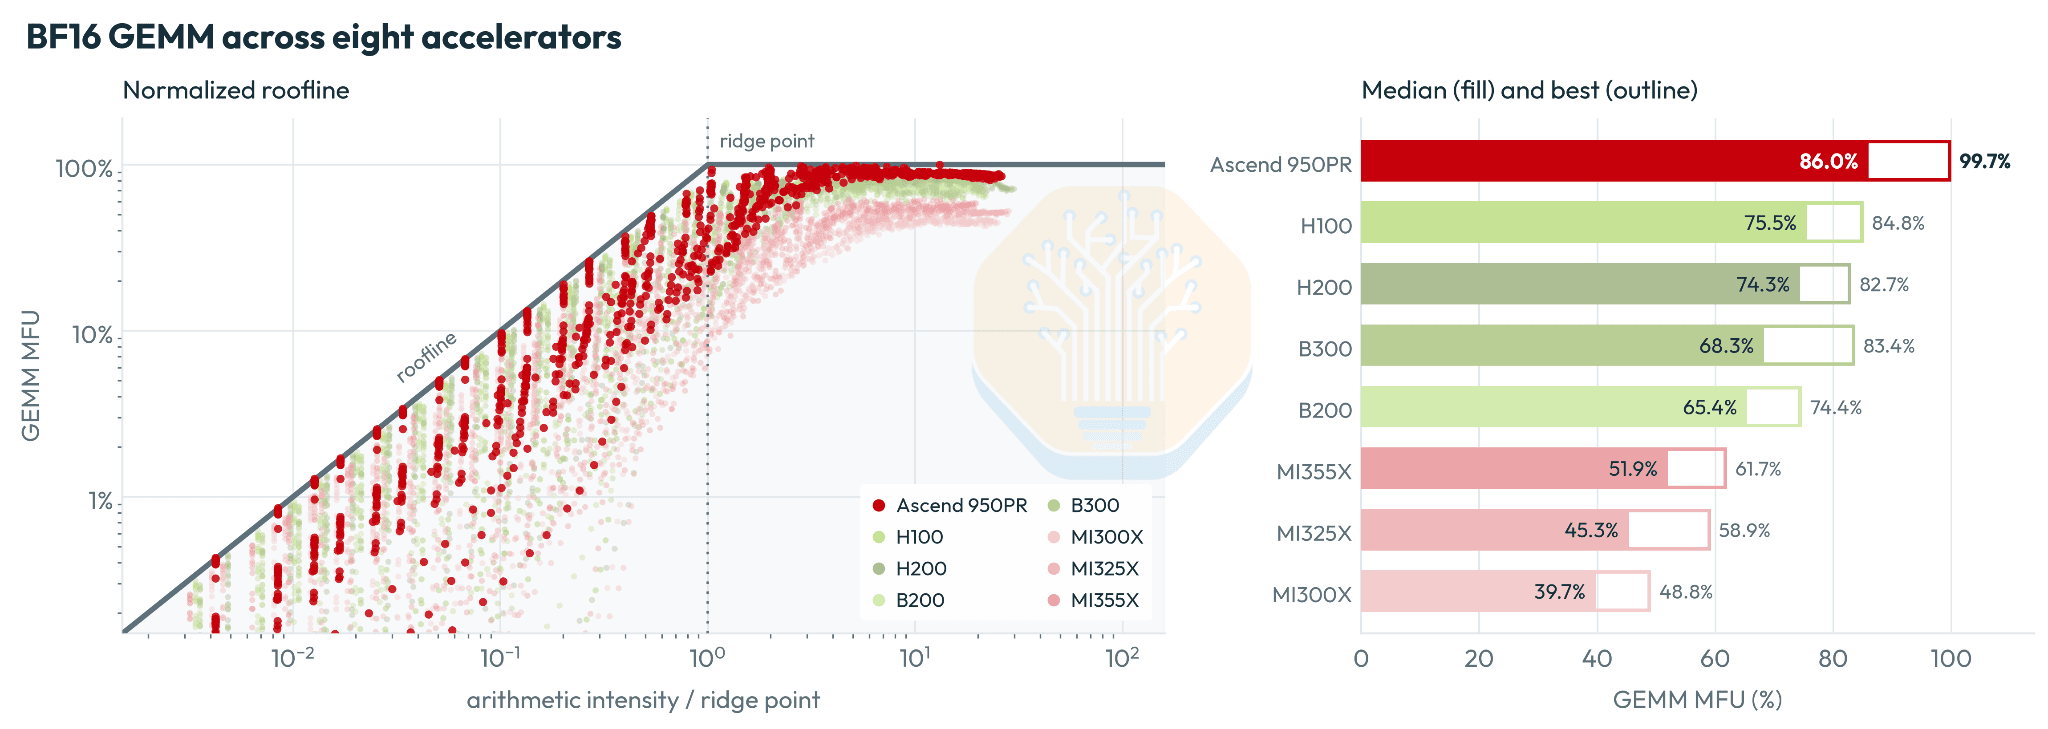
优势主要集中在计算受限的工作上。对于 Ascend ridge point 以下的形状,其“实际达到性能 / 可达性能”的中位数为 41.5%,H100 为 46.8%。Nvidia 的部分结果受功耗限制,SM 时钟未达到最高值:功耗中位数约为 690-698 W,接近 700 W 上限;采样 SM 时钟中位数为 1335-1470 MHz,低于最高 1830 MHz。Huawei 约为 599-600 W,频率为 1500-1550 MHz,参考频率为 1650 MHz。
Ascend 的 MXU 设计可能有助于实现较高利用率。它将矩阵操作数暂存于专用 L0A/L0B buffer,将累加器放在 L0C,并让数据移动、计算和结果处理重叠。Huawei 将扩大的 L0C 与更灵活的 tiling 和复用联系起来。
不过,在绝对性能上,950PR 仍然落后,处于 A100 与 MI300X 之间。
内存带宽
Ascend 950PR 的峰值内存带宽为 1.6384 TB/s:8 个 HiBL 堆栈 × 256 bits × 每引脚 6.4 Gbps。
HBM 带宽测试中,在每个 buffer 的消息较小时,950PR 的有效带宽和带宽利用率都超过 H100;消息较大时,其带宽利用率也接近 H100。
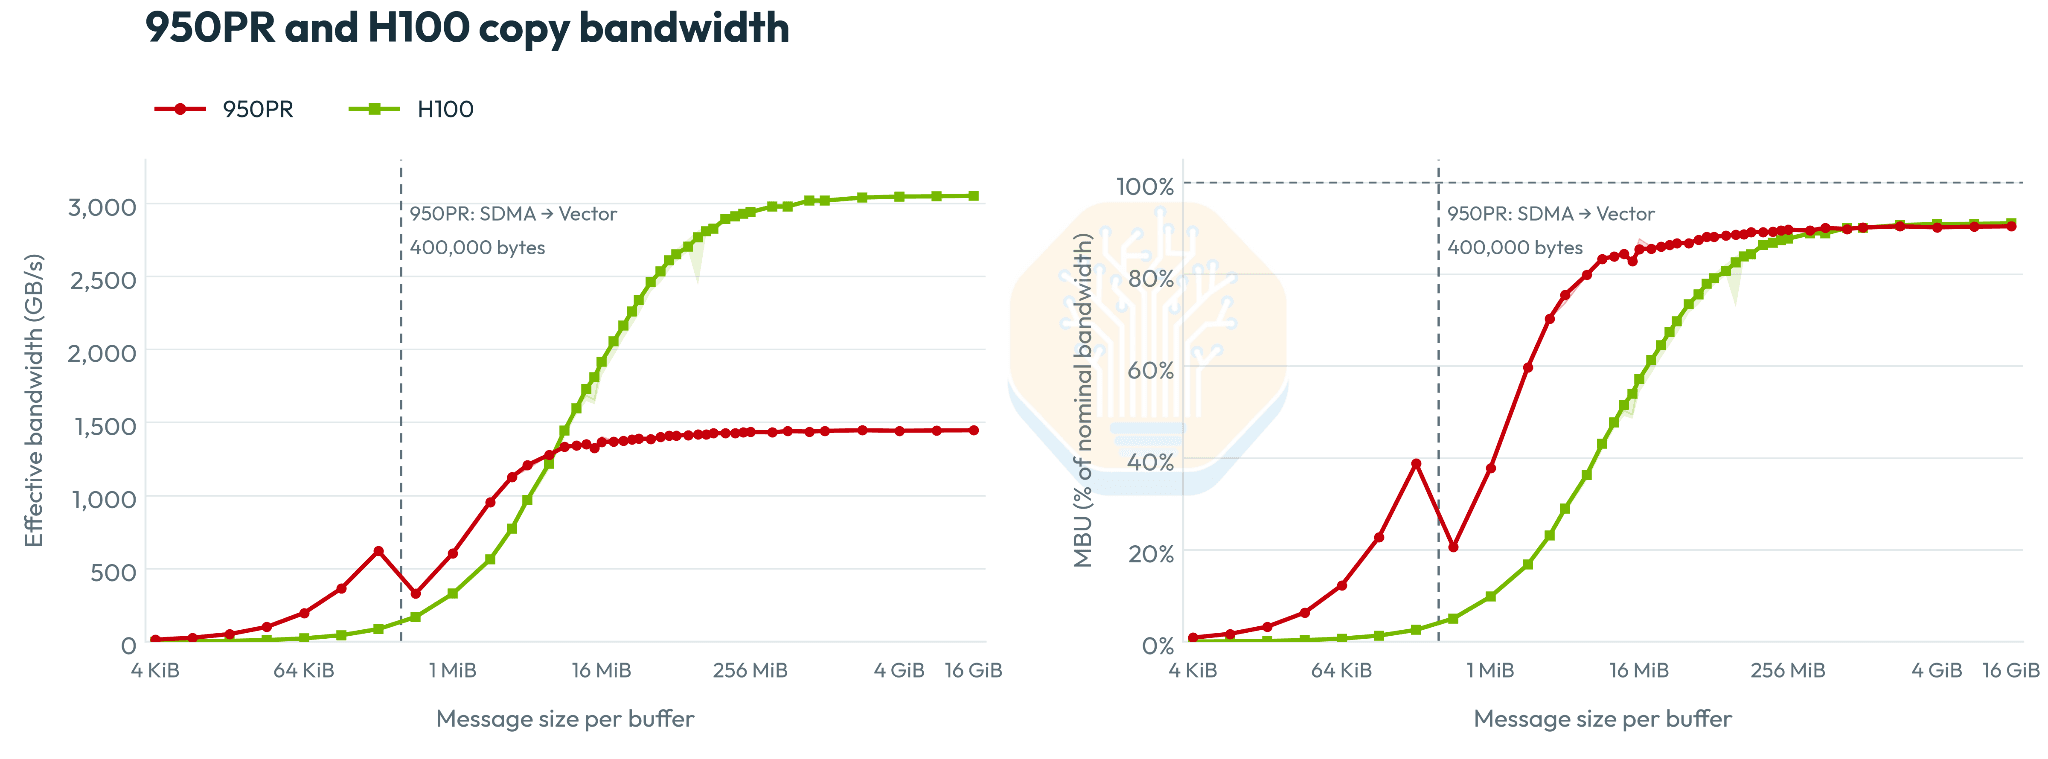
曲线中的下凹来自 Ascend 切换 copy 实现:切换后的 Vector 核心 TensorMove kernel 启动开销更大,因此稍大的 copy 反而突然更慢。对于非常大的 copy,这项额外开销占比下降,带宽又会回升。
需要注意,高 FLOPs 利用率和带宽利用率不一定意味着高 MFU/MBU。训练,尤其是采用 FSDP 的训练,还需要集合通信、checkpoint 和数据搬运,这些工作不一定容易重叠。
正如我们在 Jalapeño 文章中所说,基准测试里的“一颗芯片”只是人为划定的边界:多个裸片可以拼成一颗更大的“芯片”。因此,每瓦性能或 TCO 更适合比较。不过,在中国,电力便宜得多。我们将在后续文章中分析 Ascend 的单位 TCO 性能。
OpenAI Jalapeño:比 Nvidia Blackwell 更强
硬件决定上限,软件决定能否接近上限。Huawei 硬件或许落后约 5 年以上,接近 A100 的水平,但软件已经处在前沿。
DeepSeek 开源软件
获得 Ascend 支持的 6 个仓库是 TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect。截至撰稿时,只有 TileLang 可以使用,CANN 9.2.0 尚未发布。DeepSeek 要求 CANN 9.2.0,该版本在撰稿后发布;同时还需要 C++20 编译器,而 CANN 9.2.0-beta.2 并未提供。HDK 将于 10 月 15 日发布。此前,DeepSeek 在 2025 年的开源周发布了部分仓库,当时只支持 Nvidia。
前面的结果表明,Huawei 已经能够高效执行单个操作。双方合作的意义,是让应用的其他部分以及支持它所需的工程工作更加高效、更容易复用。
工程影响是双向的
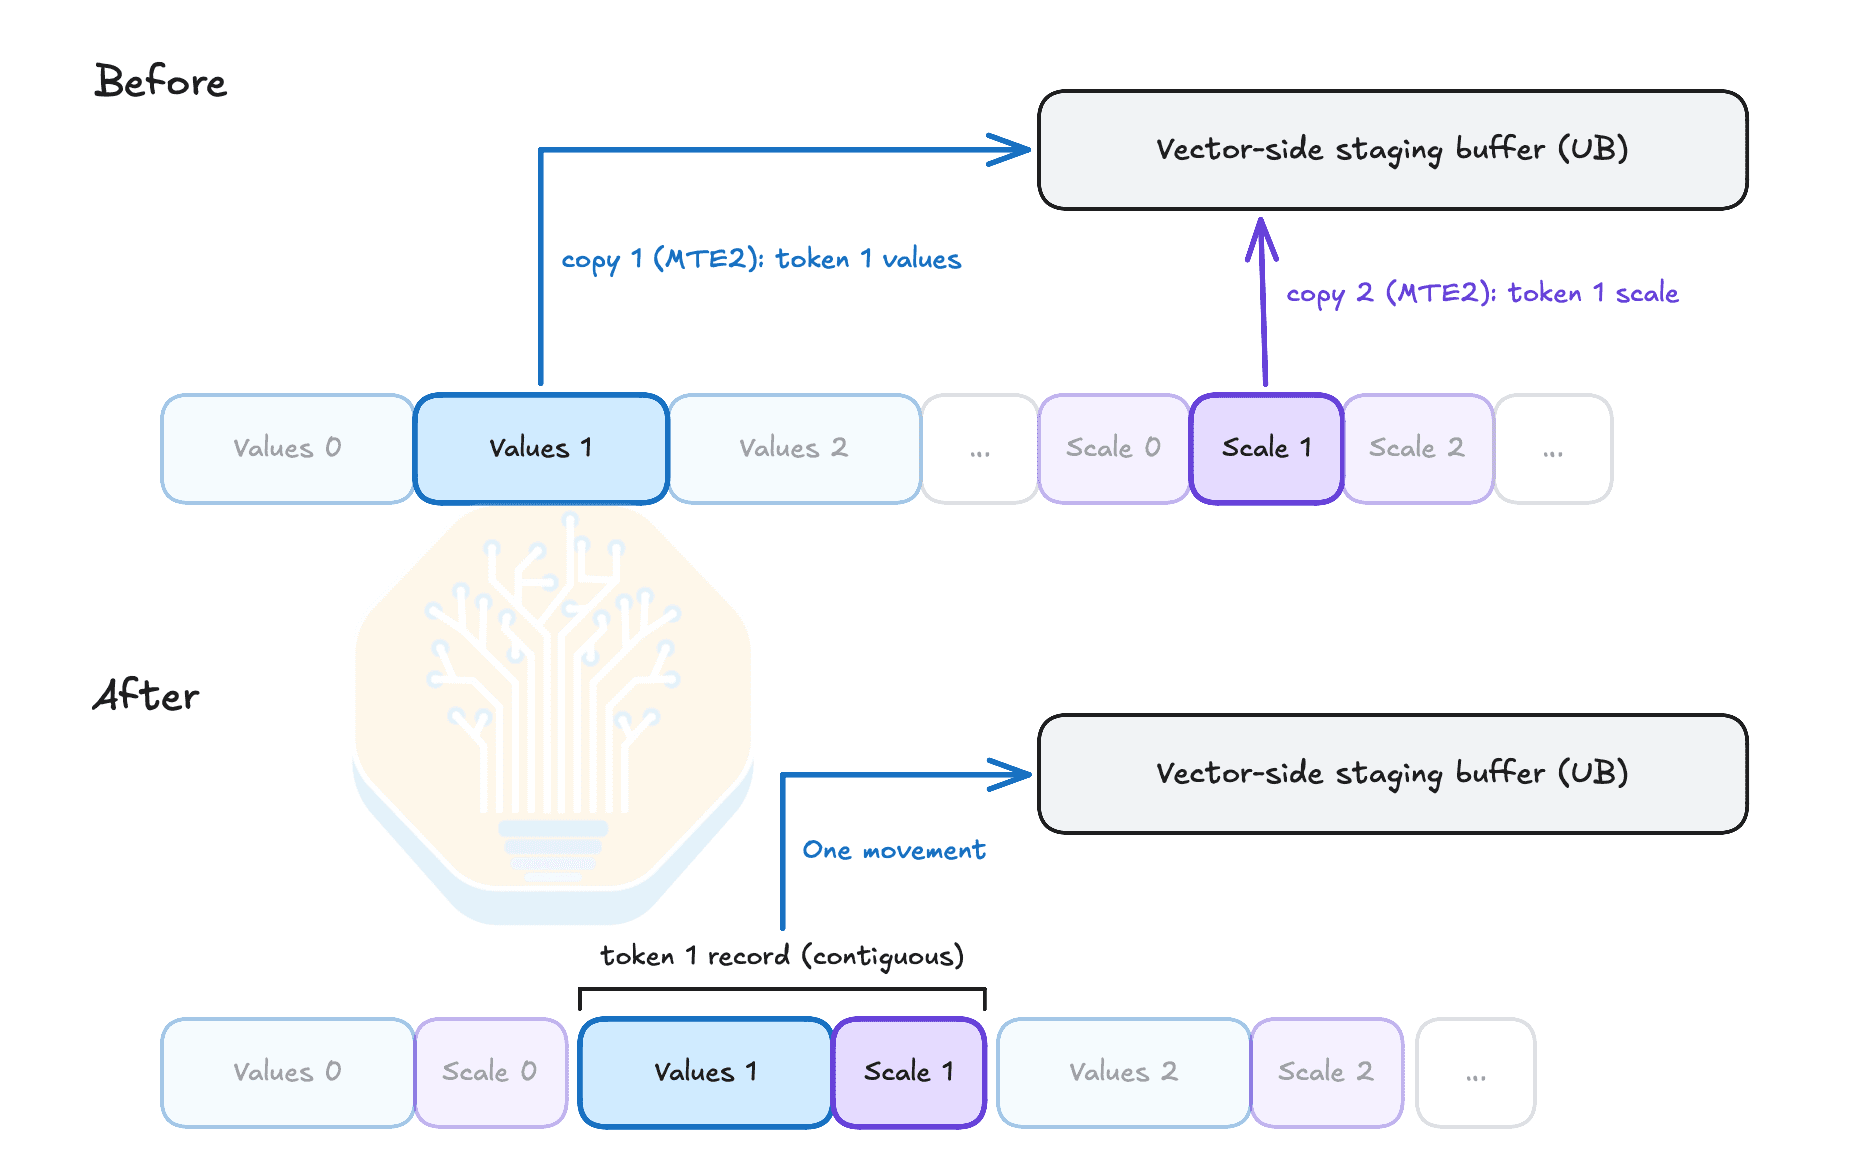
Huawei 架构已经开始影响 DeepSeek 软件的数据组织方式。早期 FlashMLA KV-cache 布局将量化值与 scaling factor 存在不同区域。在 Ascend 上,取一个 token 因而需要分别搬运数据值和 scale。新实现把两者放在一起,减少 memory transfer engine(MTE)的传输请求数。
从高性能 kernel 到可复用的 kernel 工程
Ascend 950 backend 已合入 TileLang 主仓库,不再只存在于独立的 Huawei 适配层中。它针对 Ascend 执行模型加入了原生编译、调度、同步和运行时集成。
TileLang 降低了编写 Ascend kernel 的难度,但开发者仍须考虑硬件特性,选择计算方式、tile 大小和数据存放位置。编译器负责协调 Cube、Vector 核心和数据传输中的大量细节。
深入比较其实现与 CANN、Triton-Ascend 的性能,可以看到它在部分场景中持平或超过 CANN,最佳实现随数据规模变化。这里采用的是 warm-cache 条件下的简单、朴素测试。
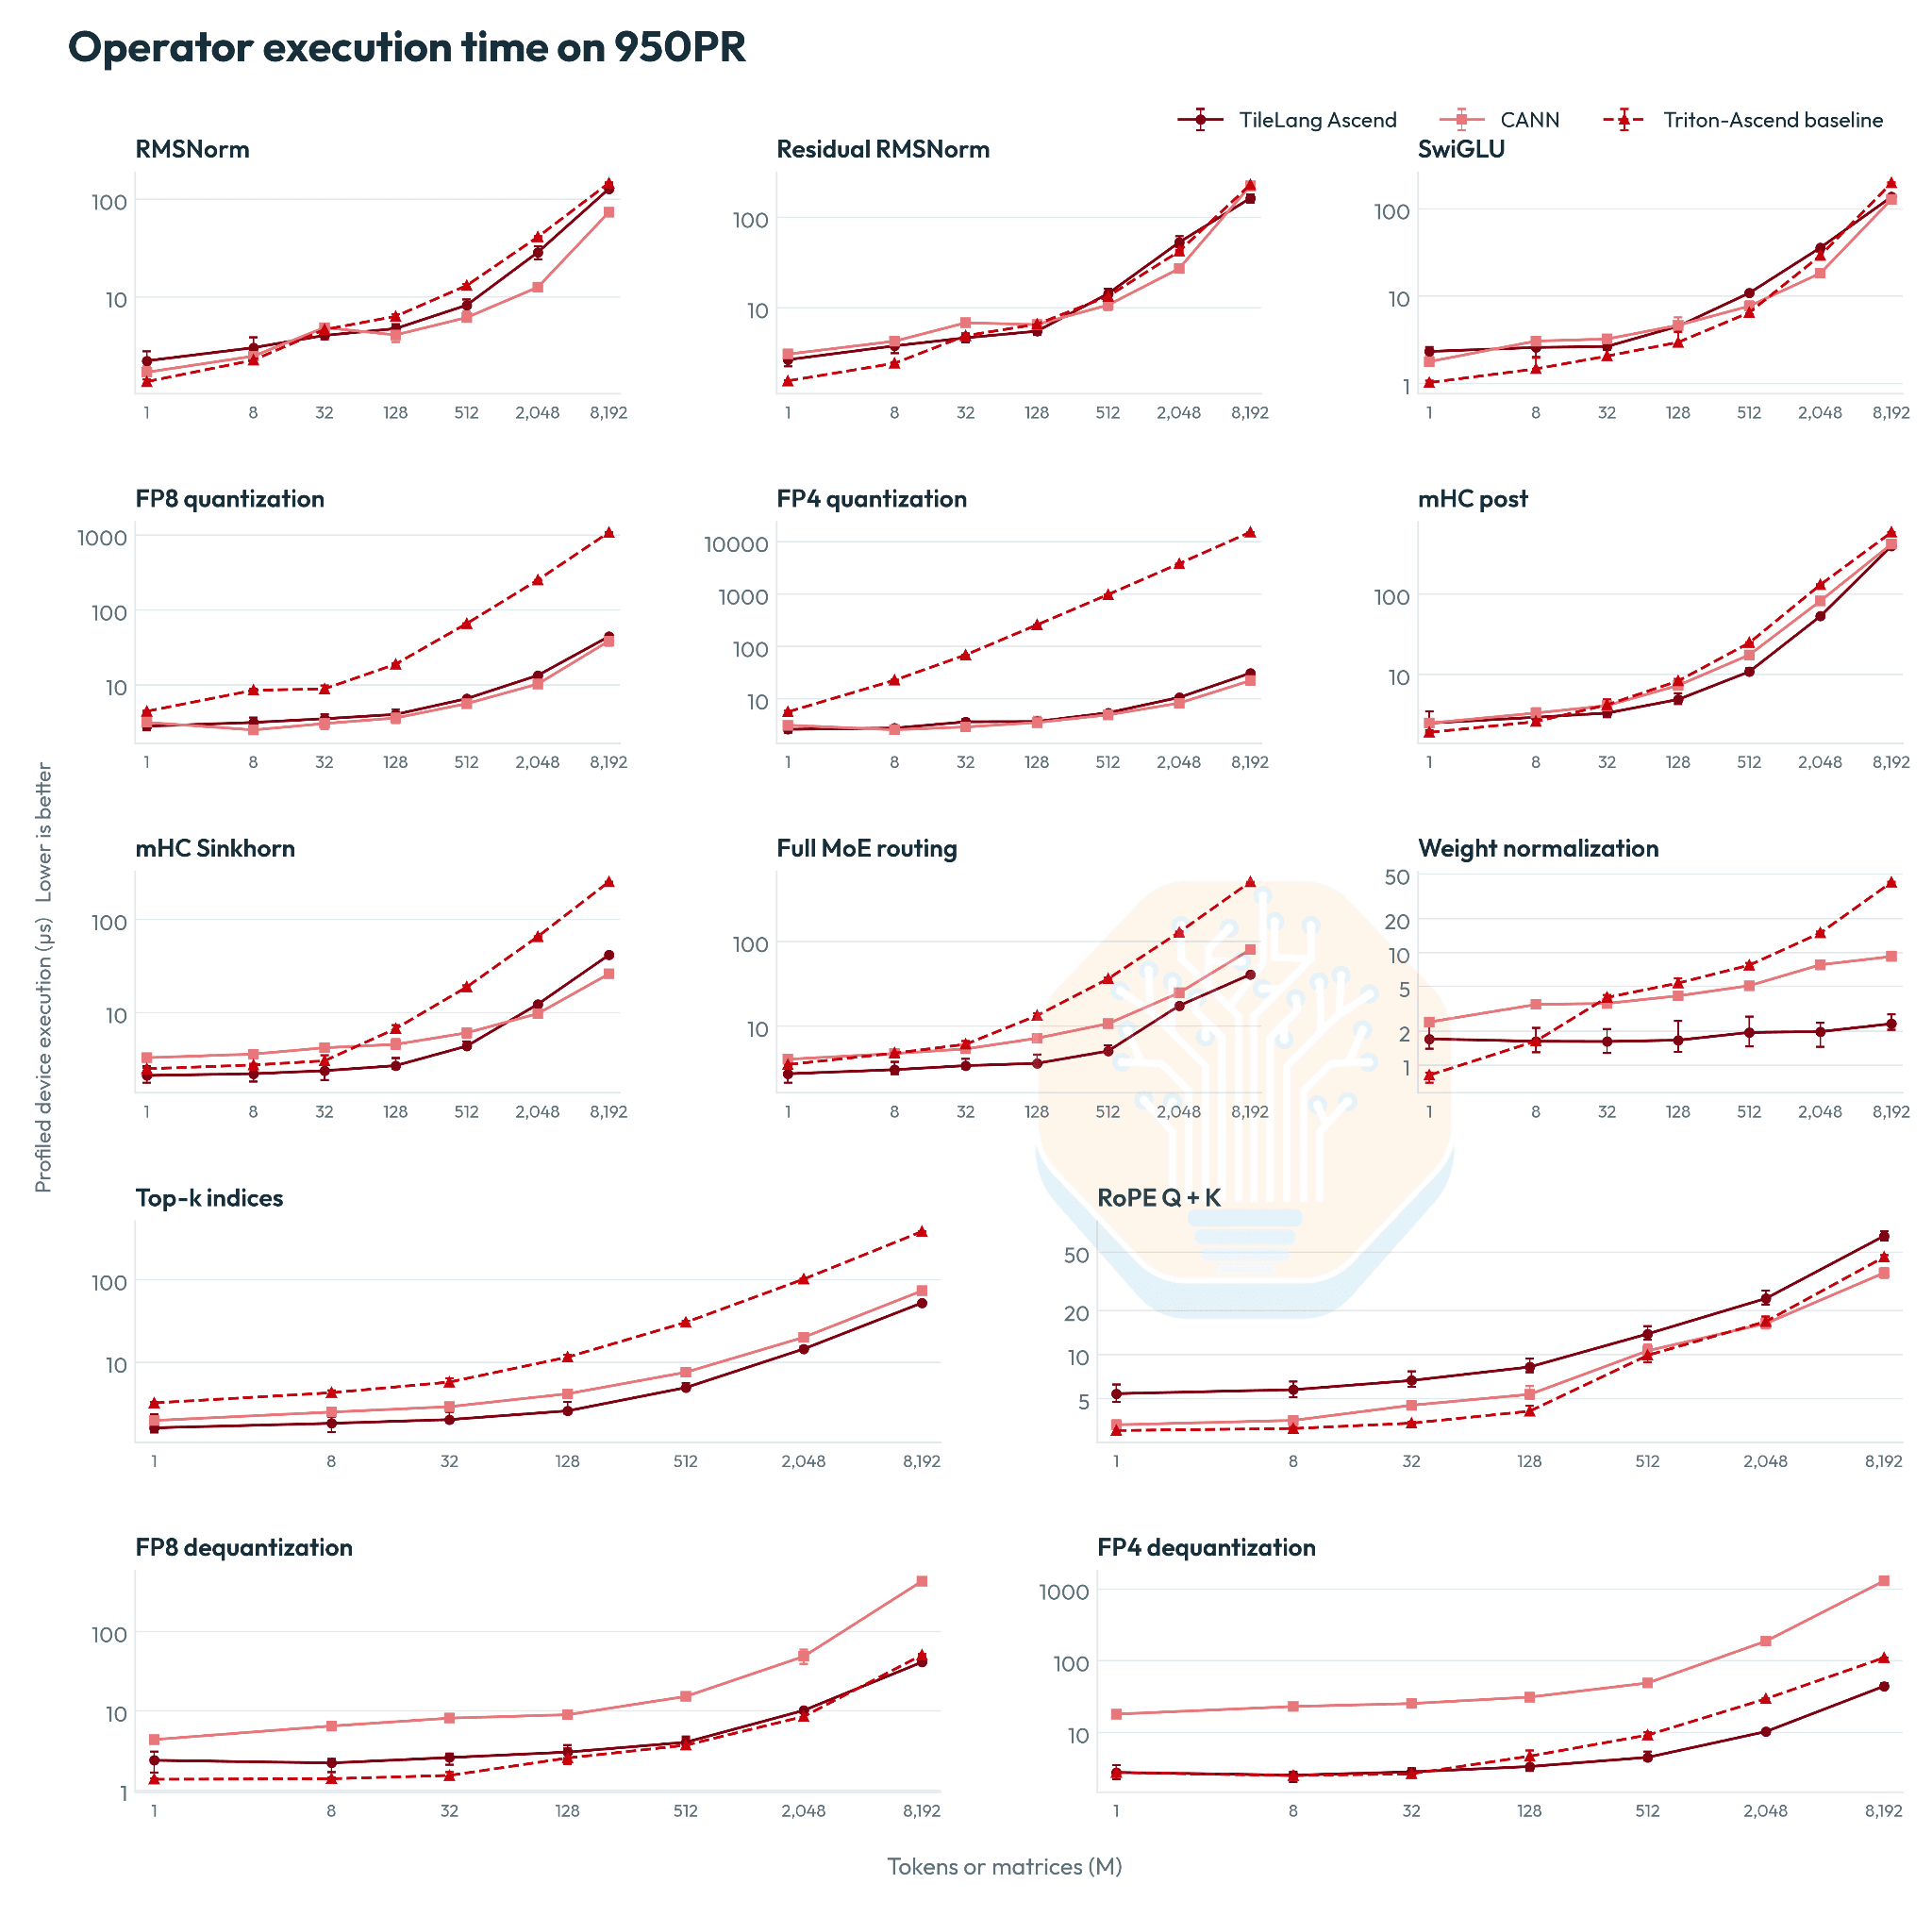
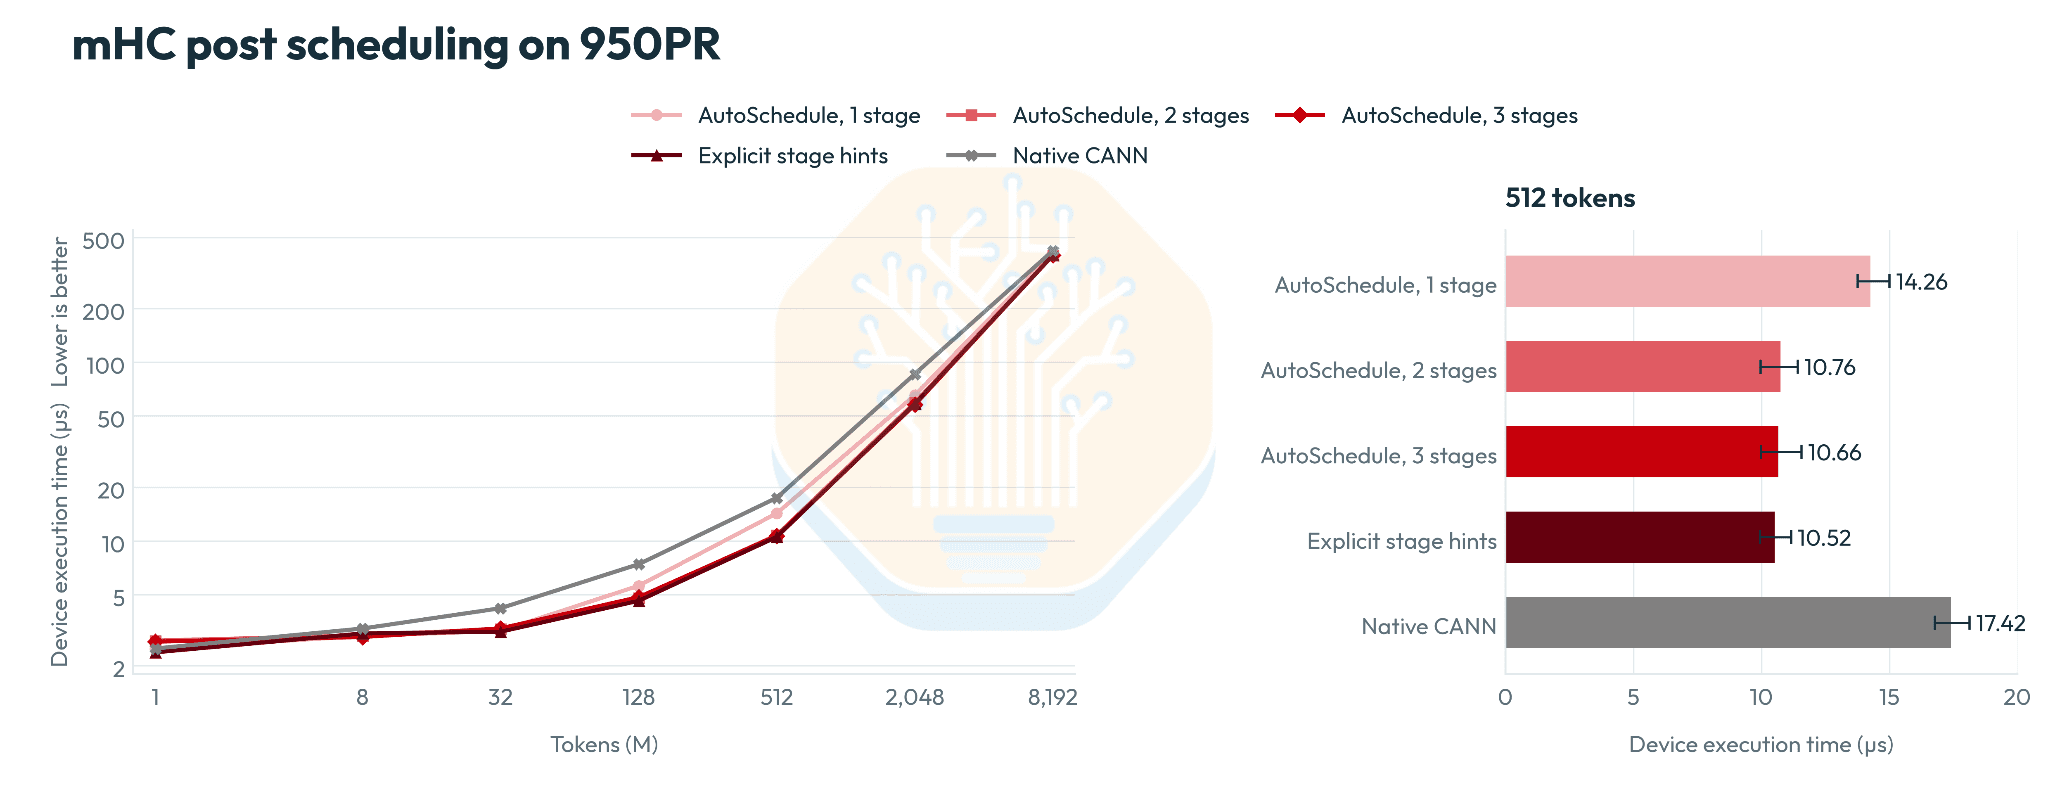
AutoSchedule 根据数据依赖和预计执行时间安排哪些操作可以重叠,还会在片上内存容量允许的范围内选择 buffer 槽位数,让下一批数据的加载与当前 tile 的处理重叠。默认调度不合适时,开发者可以介入引导。
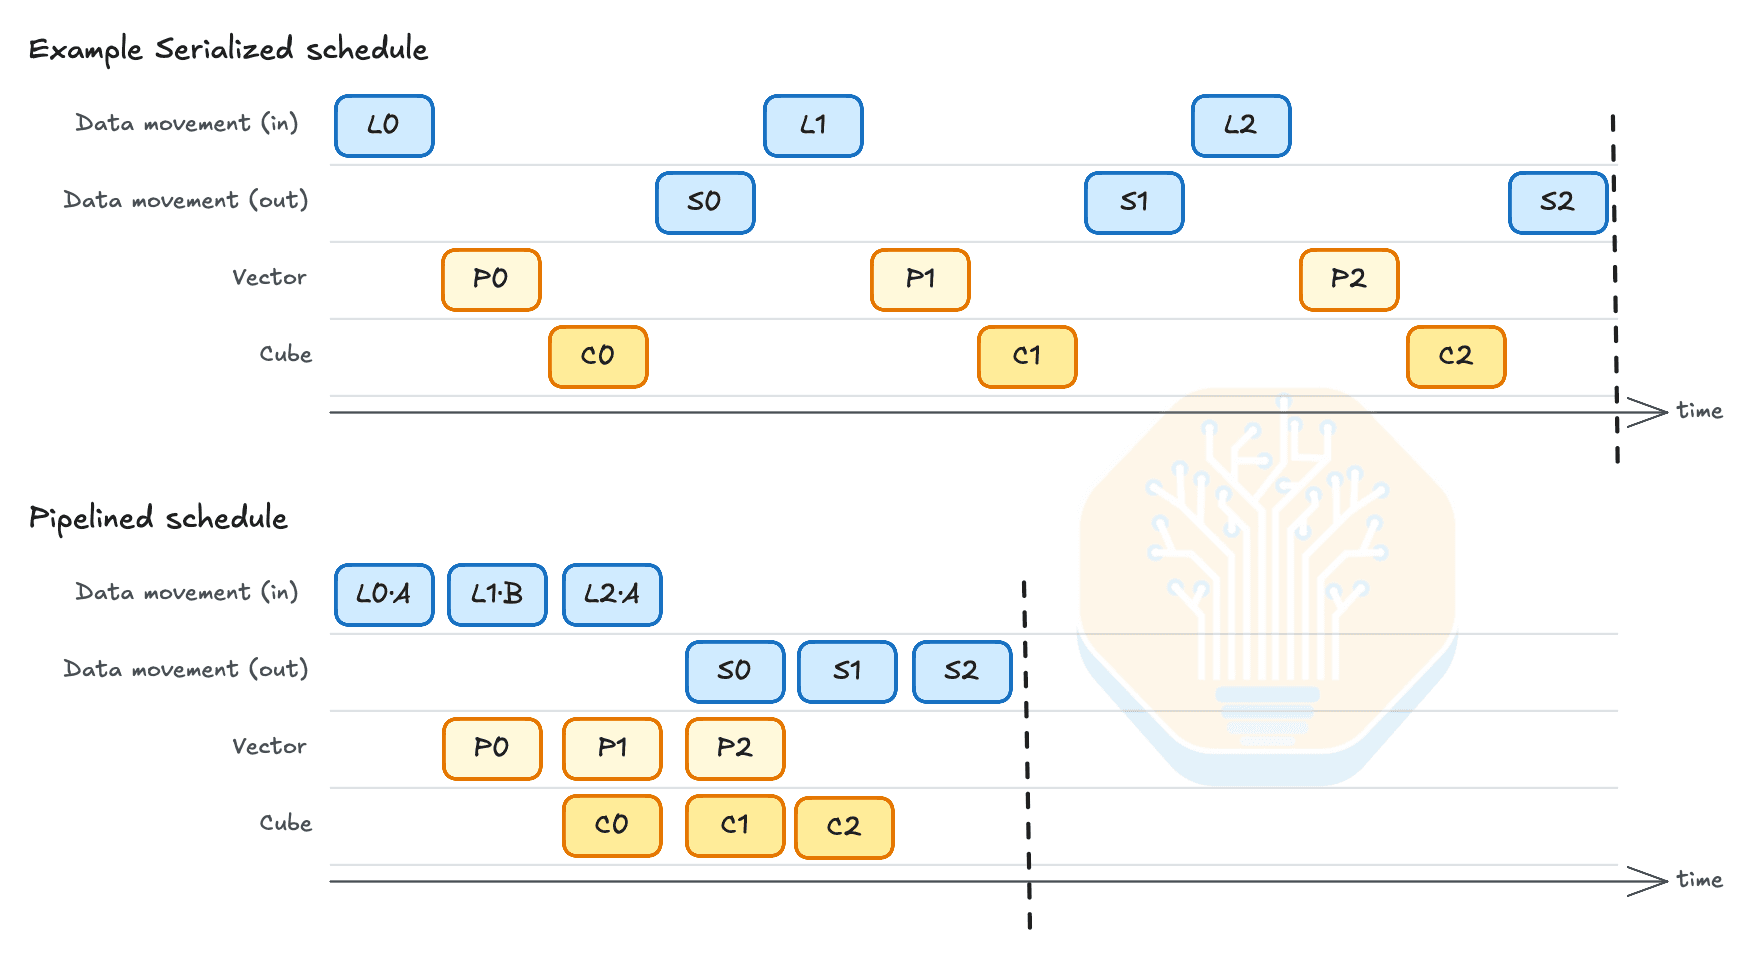
在 950PR 上,AutoSchedule 对较小的数据规模尤其有效,单个操作的执行时间最多缩短 40%。
编译器还会插入同步,让操作等待所需数据,同时去掉已经由其他依赖保证的多余等待。它也检查条件分支,不会假定一个可能根本未执行的分支已经完成操作。这减少了程序员需要手动处理的同步工作。
DeepEP
Huawei 已与 NVIDIA 一样,将大规模 scale-up AI 系统商业化。Ascend 超节点把紧耦合加速器互联扩展到多个机架,从 910 CloudMatrix384 到 950 SuperPod,支持 wide EP 扩展。在 9 月 30 日的发布中,Huawei 还提供了 950DT SuperPod 上基于 URMA 的 EP16 dispatch/combine 测试。
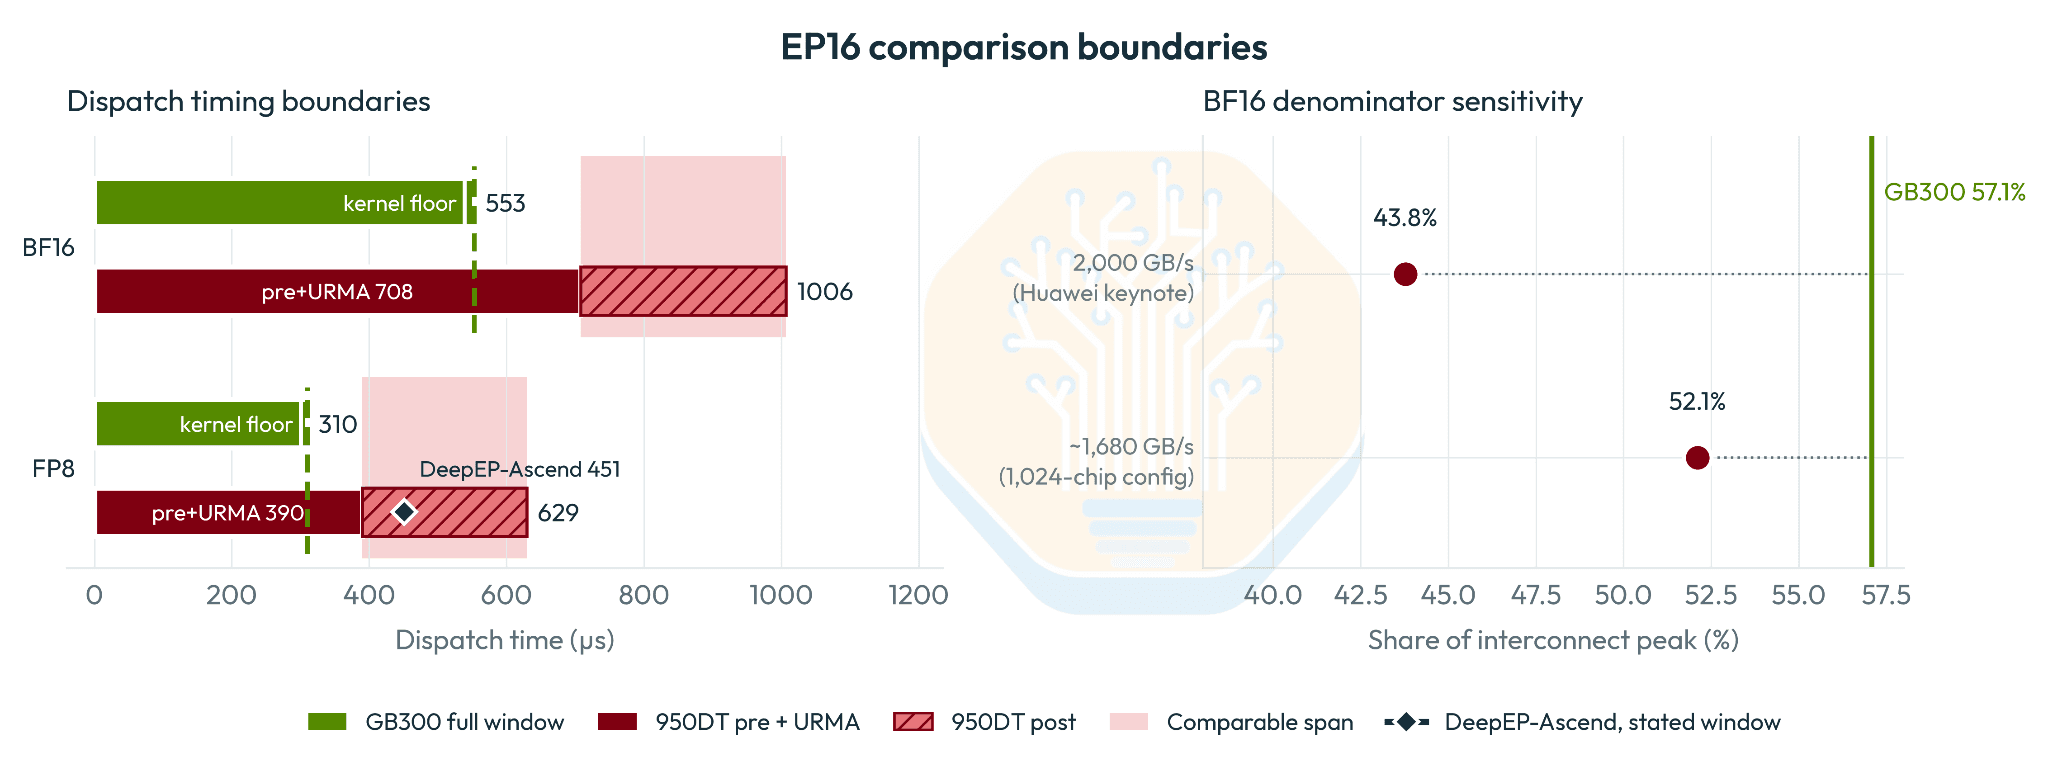
Huawei 的 dispatch 包含三个顺序算子,即 pre/URMA/post,而 GB300 是一次融合调用。Huawei 的 post 阶段包含接收完成处理,我们的测量也包括这一部分;但它还包括按 expert 展开数据,而 GB300 的结果不包含这项工作。
DeepEP-Ascend 移植自 DeepEP V2.5,沿用相同的 Python API,底层调用 URMA 和 HCCL。2025 年 7 月,Huawei Ascend 团队曾提议把 DeepEP-Ascend 放到 deepseek-ai 名下,但遭到 DeepEP 维护者拒绝。如今,DeepEP-Ascend 已在 DeepSeek 自己的组织下发布。
Ascend 分离的 Cube 和 Vector 执行路径,为通信与计算重叠提供了机会,但重叠并非没有成本。Expert 计算也可能需要 Vector 处理和数据移动,通信则会竞争共享内存带宽。因此,需要权衡能够隐藏多少通信,以及这会不会拖慢并行执行的计算。
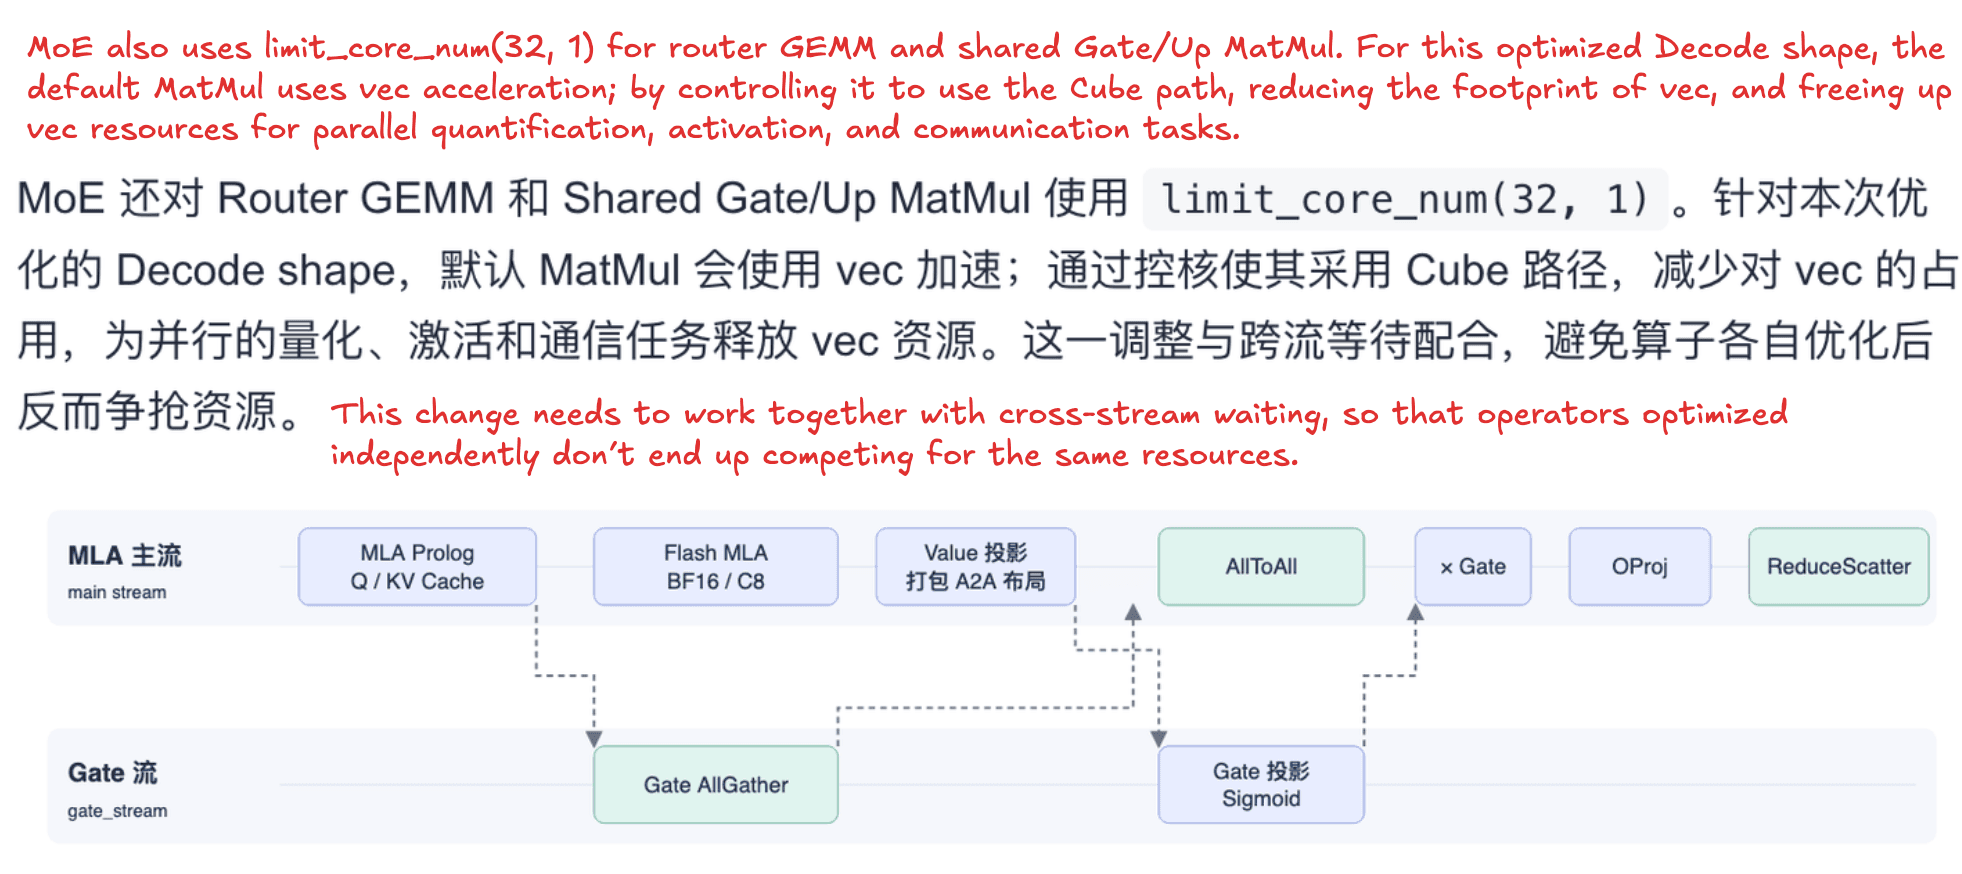
这种资源平衡问题并非 DeepSeek 独有。Huawei 的 Kimi K3 recipe 明确限制 Vector 使用量,为并发工作留出资源,并根据需要重叠的工作,在专用 CCU 和 Vector 通信之间选择。单个操作更快还不够,它们对资源的需求也必须能相互配合。
DeepEP-Ascend 文档指出,combine 处理与 URMA 通信会争用 HBM 资源,并提到 Huawei 计划通过固件优化缓解这一问题。这就是协同设计的具体过程:模型暴露瓶颈,实现据此调整,平台的后续开发再处理剩余问题。
早有规划
在 5 月一份未经证实的 DeepSeek 投资人会议记录中,梁文锋说:
“谈到中美芯片差距,我认为软件生态的差距最终会消失。但在硬件上,我们面临两个不同的劣势:一是需要四张 Huawei 加速卡才能匹敌一张 NVIDIA 卡,二是 Huawei 硬件上市时间还大约落后两年。”
4 个月后,生态差距确实缩小了。同一份记录也提到了 TileLang,以及帮助 Huawei 把生态做好。
DSv4.1 Flash 优化
DeepSeek-Huawei 合作的另一部分,是 DeepSeek 向 Huawei 提供权重,使其能在 DeepSeek V4、V4.1 等模型发布首日提供优化支持。
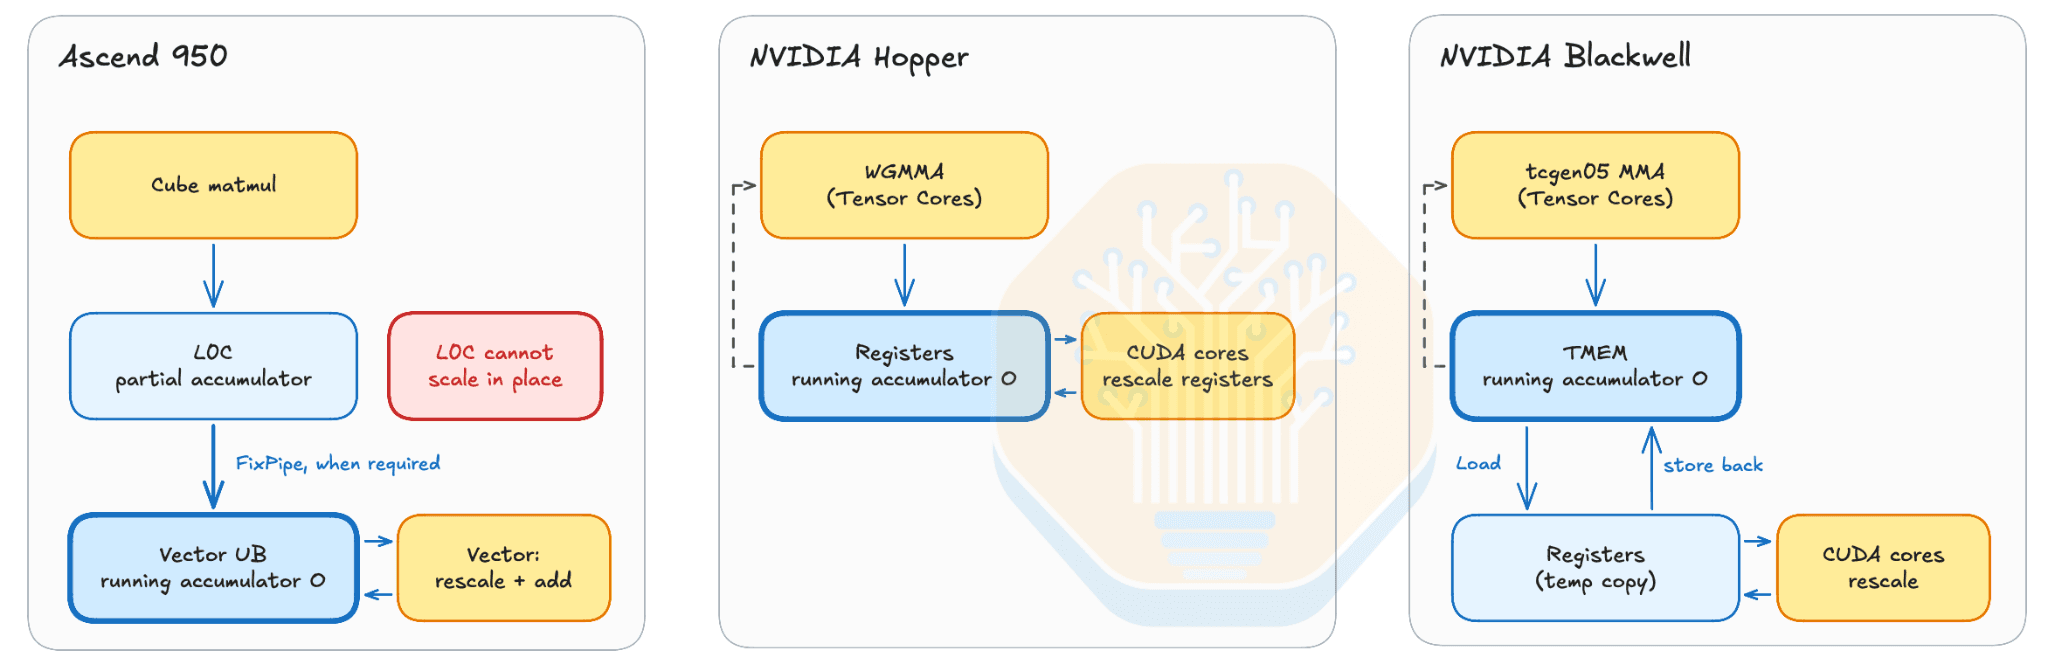
Ascend 的累加器设计要求注意力采用不同实现。Cube 的 L0C buffer 无法原地对累积输出重新缩放,而将缩放后的结果写回 L0C,需要一次代价较高的单位矩阵乘法。DeepSeek 因此把运行中的输出累加器放在 Vector UB,需要缩放和累加时,再从 L0C 搬出部分和。Hopper 将累加器放在寄存器中,Blackwell 则支持 tensor memory 与寄存器之间的 load/store,因而没有这一特定限制。
Profile
Huawei 还发布了 DeepSeek-V4.1-Flash 在 32 颗 Ascend 950DT 上部署时,一个 rank 及其主机线程的 profile。6 月,我们分析过类似的 DeepSeek V4 Pro profile。
DeepSeekV4 1.6T 从首日到第 43 天的性能变化:Huawei、GB300 NVL72、MI355X、B200
许多部分相似,例如使用 AICPU,以及把部分层分配到不同 stream。
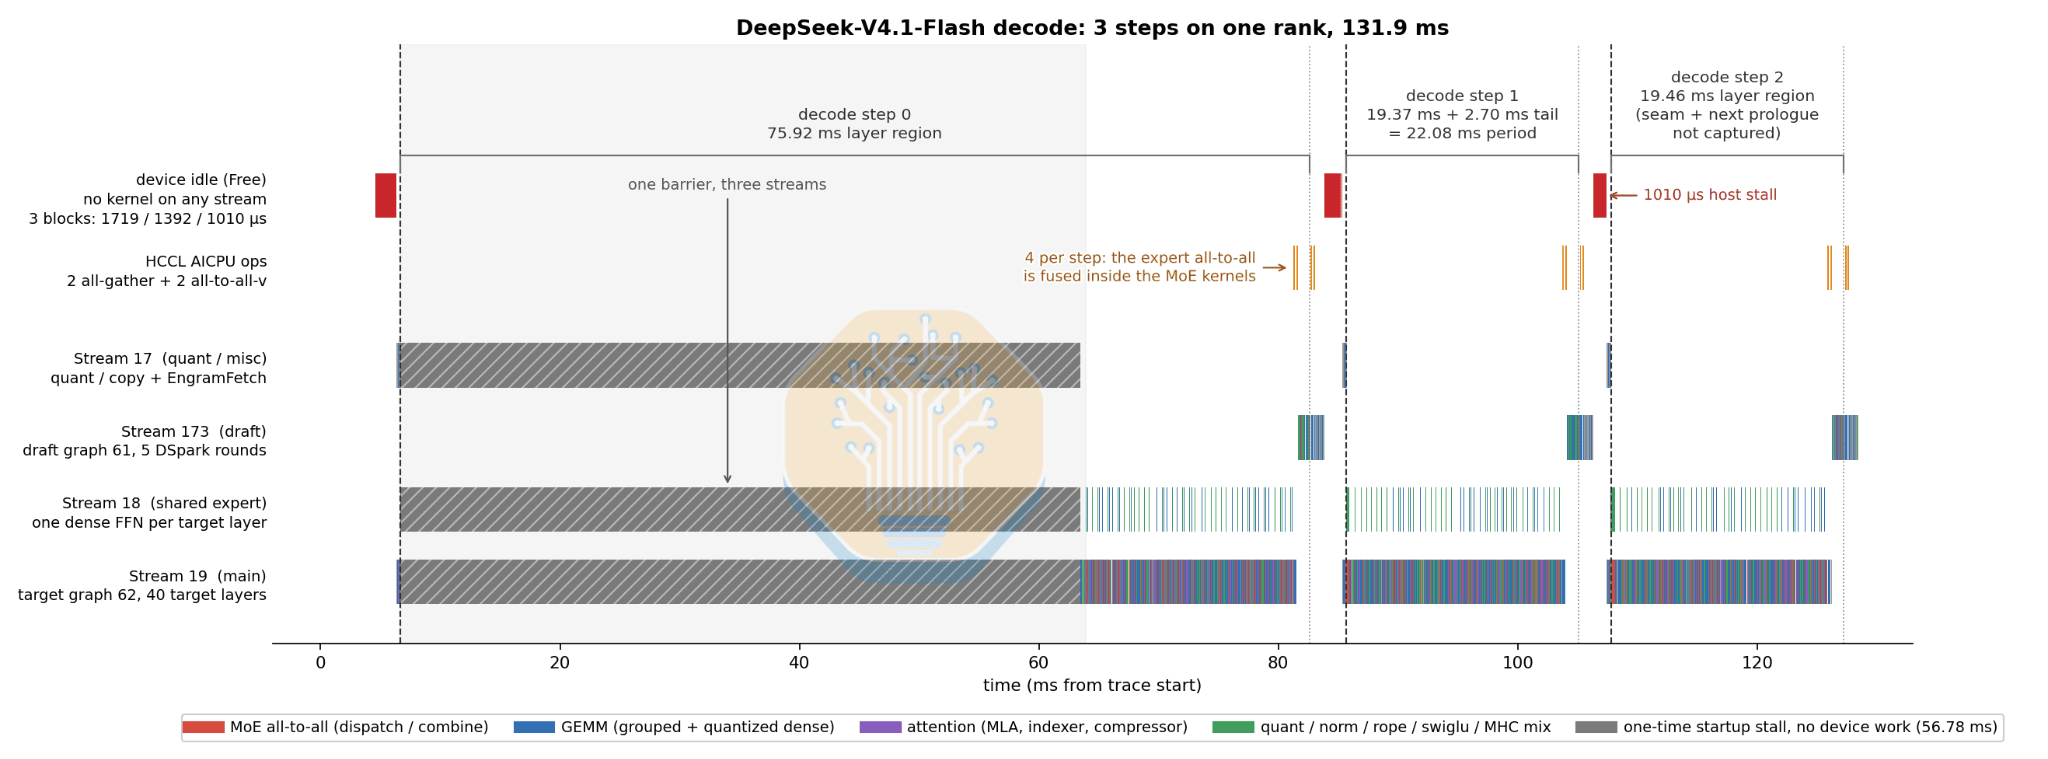
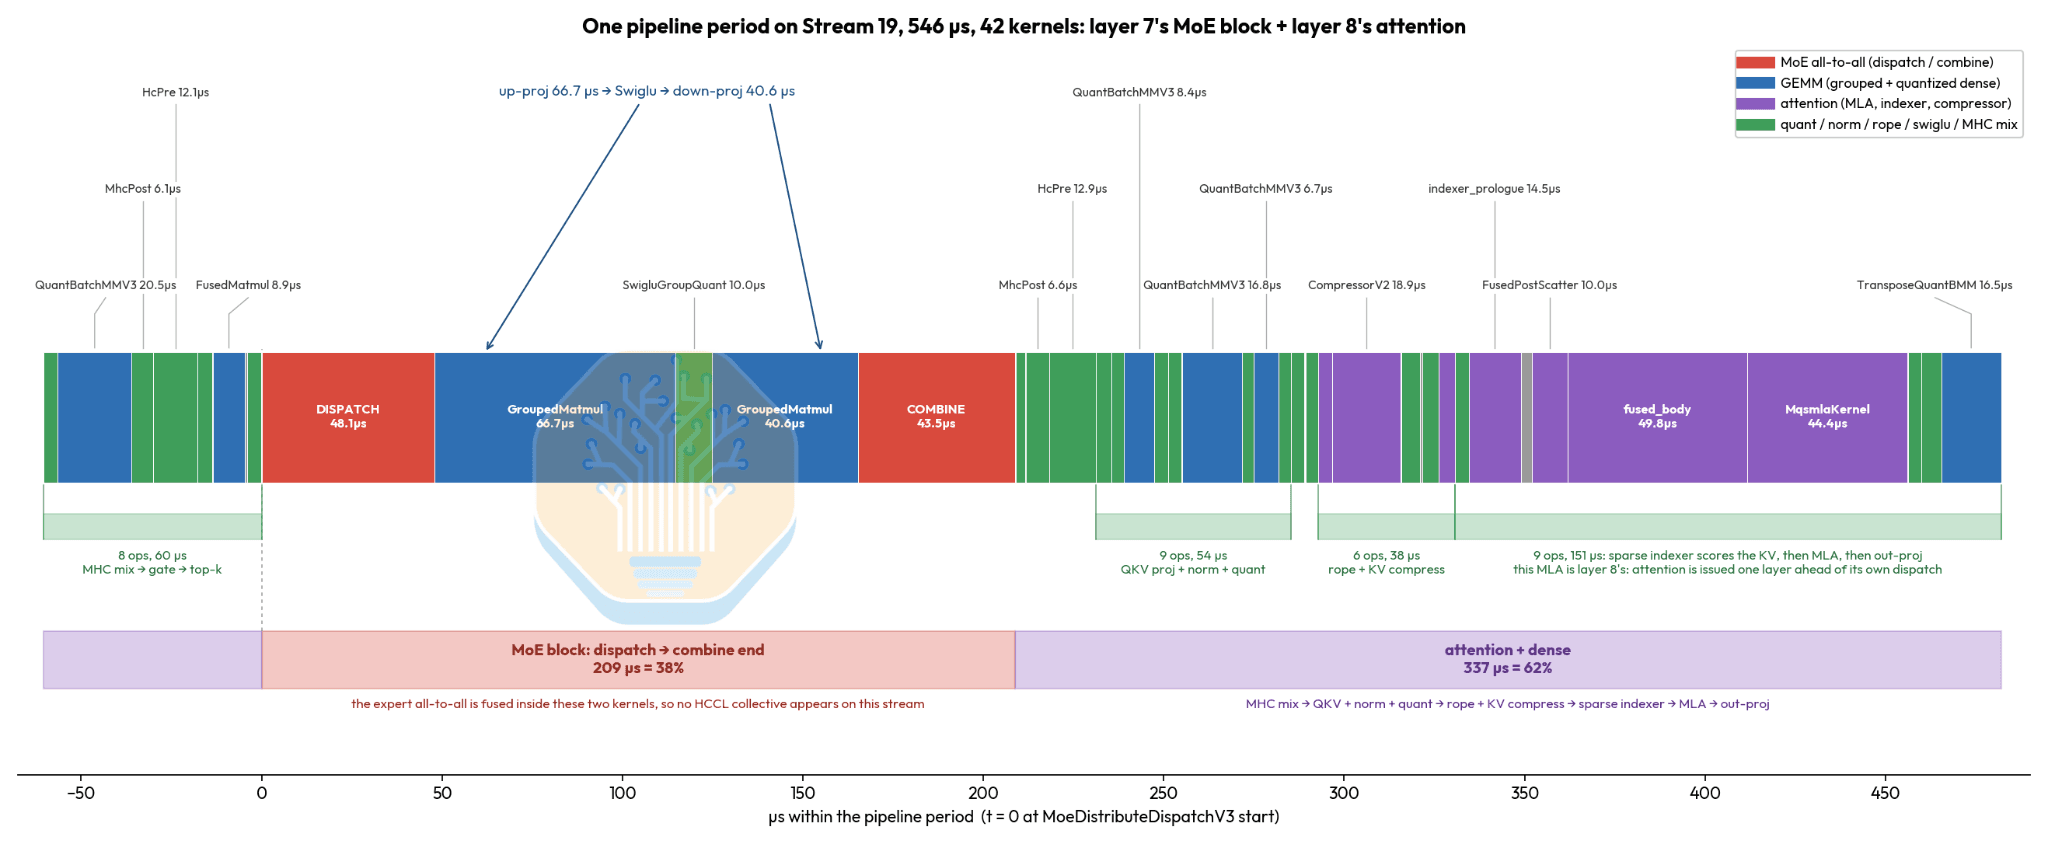
执行顺序是 40 个目标模型层、目标模型 LM head、3 个 DSpark drafter block、draft LM head,以及 5 轮采样。主要计算在 Stream 19 上运行,drafter 则在 Stream 173 上运行。DSv4 Pro trace 中融合计算和通信的 V2 MC² kernel 再次出现,这次是 V3。因此,每步虽然有 43 次 expert dispatch,却只看到 4 个由 AI CPU 发起的 HCCL 操作。这些操作是目标模型与 draft 模型词表 head 的 hcom_allGather 和 hcom_alltoallv:先 gather hidden state,再执行 LM-head GEMM,最后交换 logits。
Drafter block 只运行一次,生成各 draft 位置的基础 logits。后续 Markov head 通过采样和 embedding 反馈建模 token 依赖,不会为每个候选重新运行 Transformer block。因此,每步结尾的执行内容从 MoE 和注意力,转为一串小型投影和采样操作。
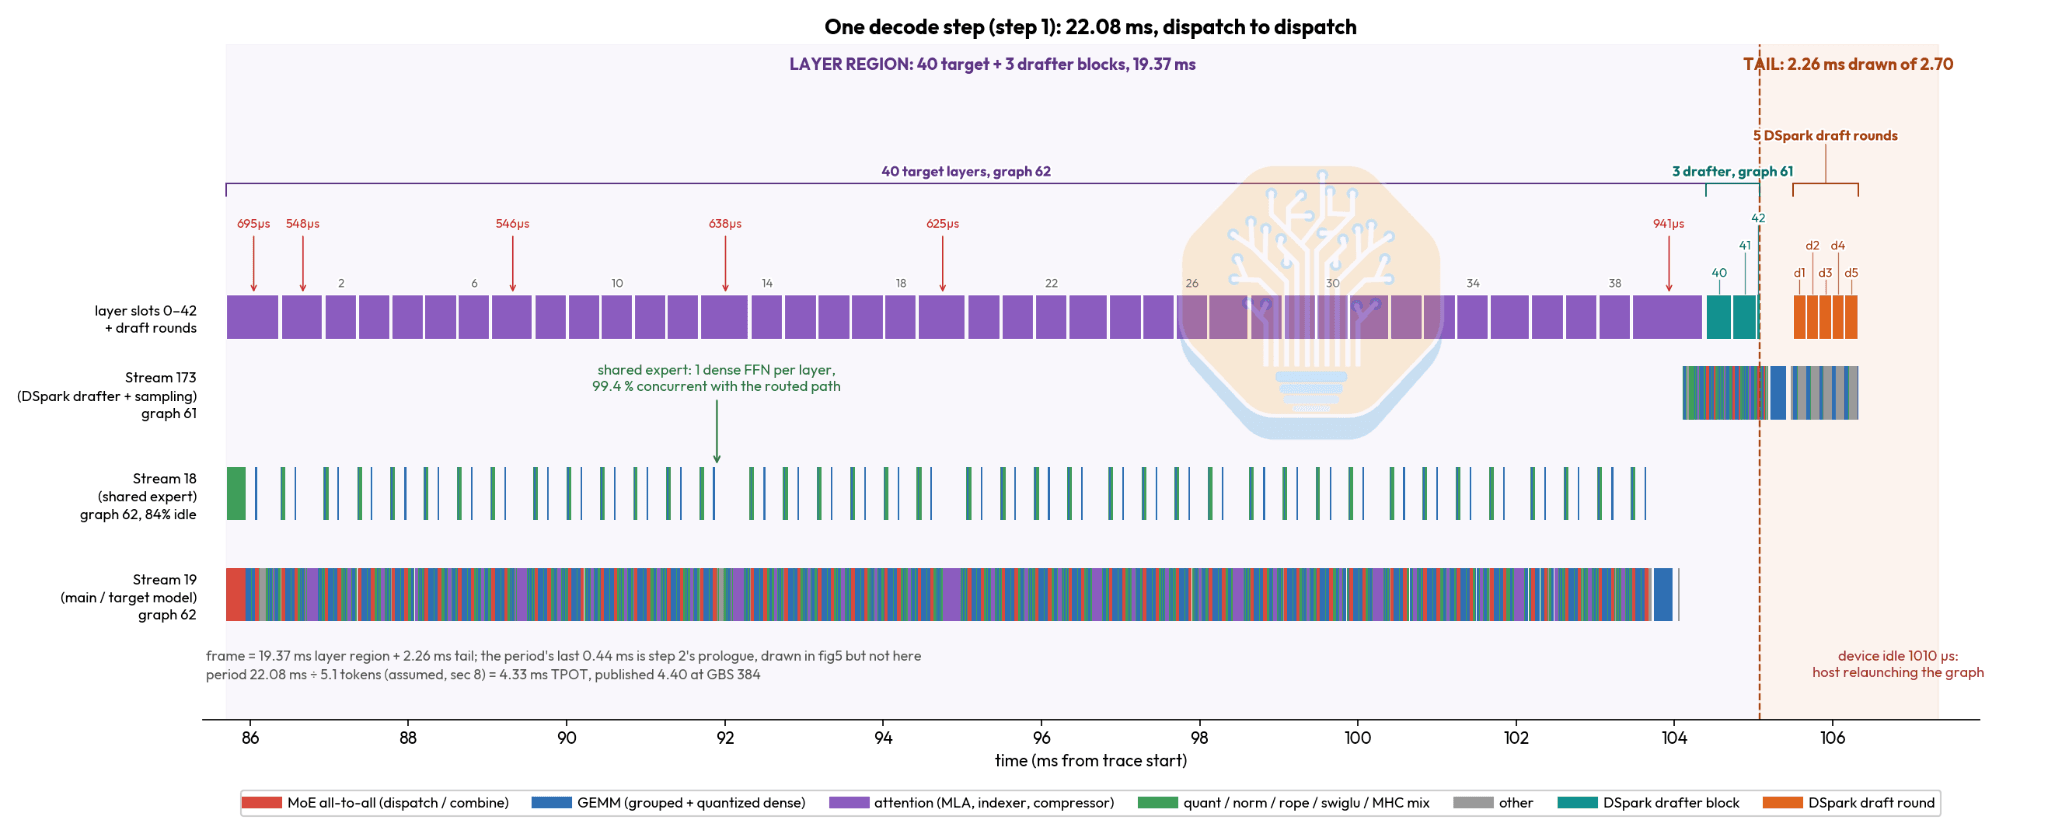
如前文所述,投机解码是一种无损方法:先预测 draft token,再用一次前向过程验证,摊薄权重加载成本。在上面的 decode 步骤图中,可以看到 DSpark 的 token drafting 比验证阶段快得多。
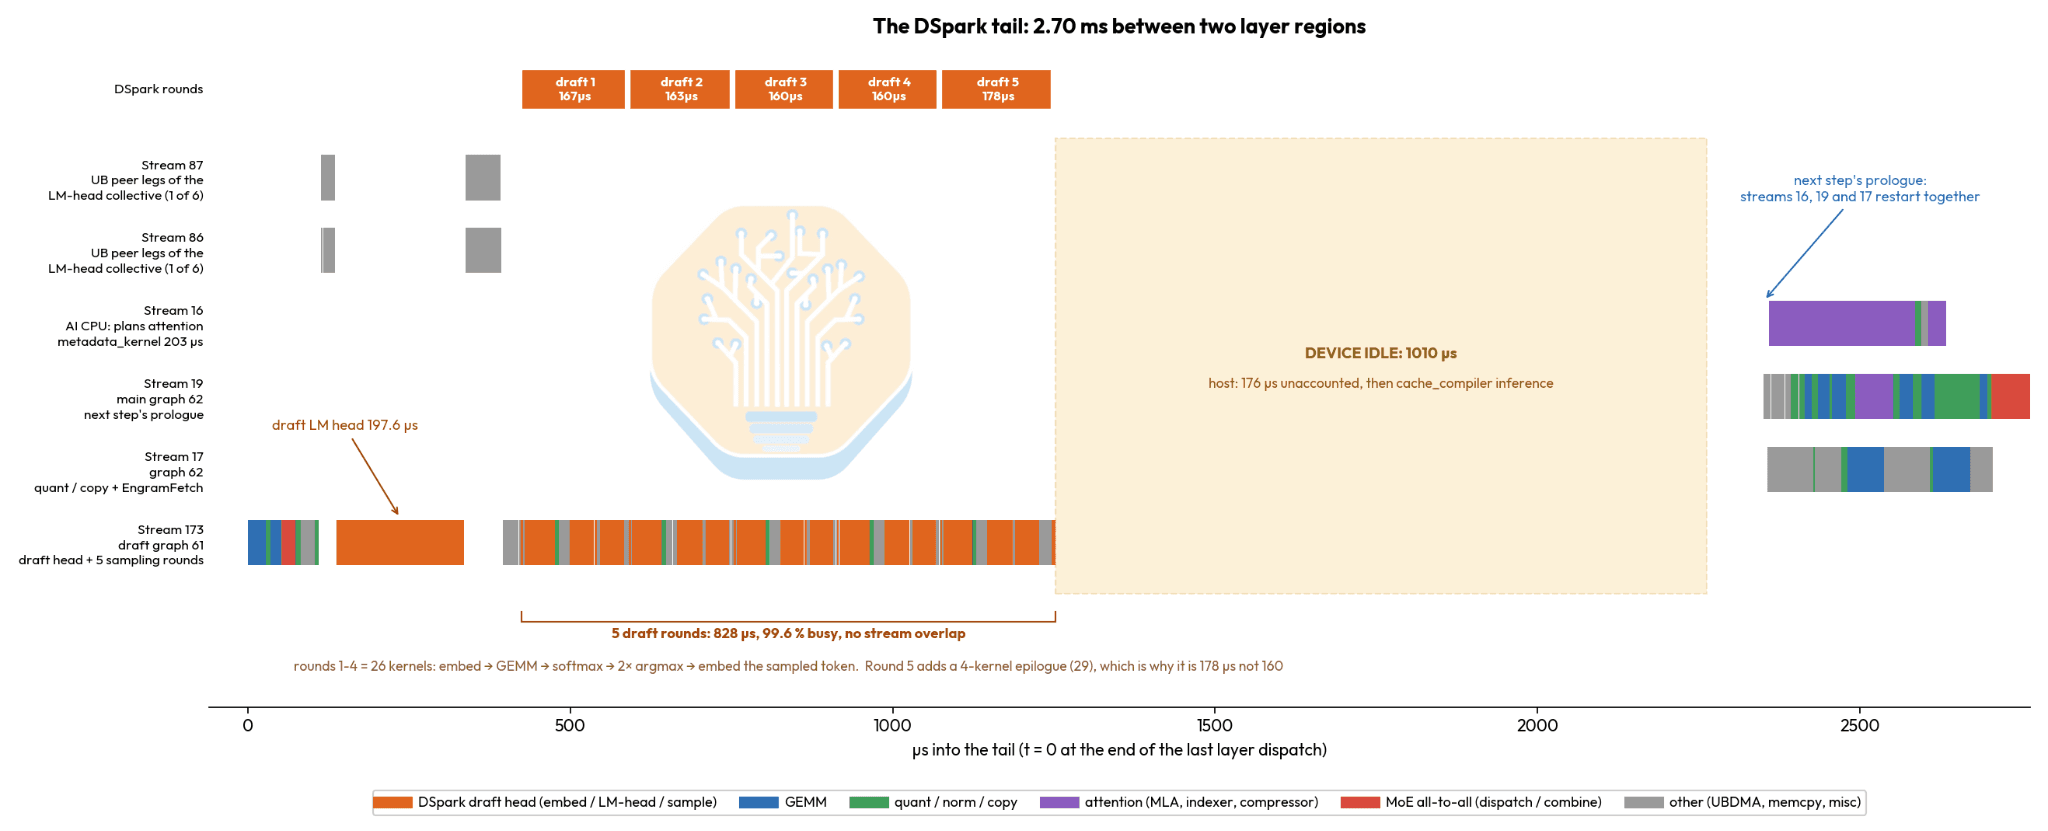
DSv4.1 Flash 也是第一个使用 Engram 的 DeepSeek 模型,但晚于 Qwen 和美团 LongCat。
Engrams Embedding Entendre:面向高效 DRAM/SSD offload 的协同设计
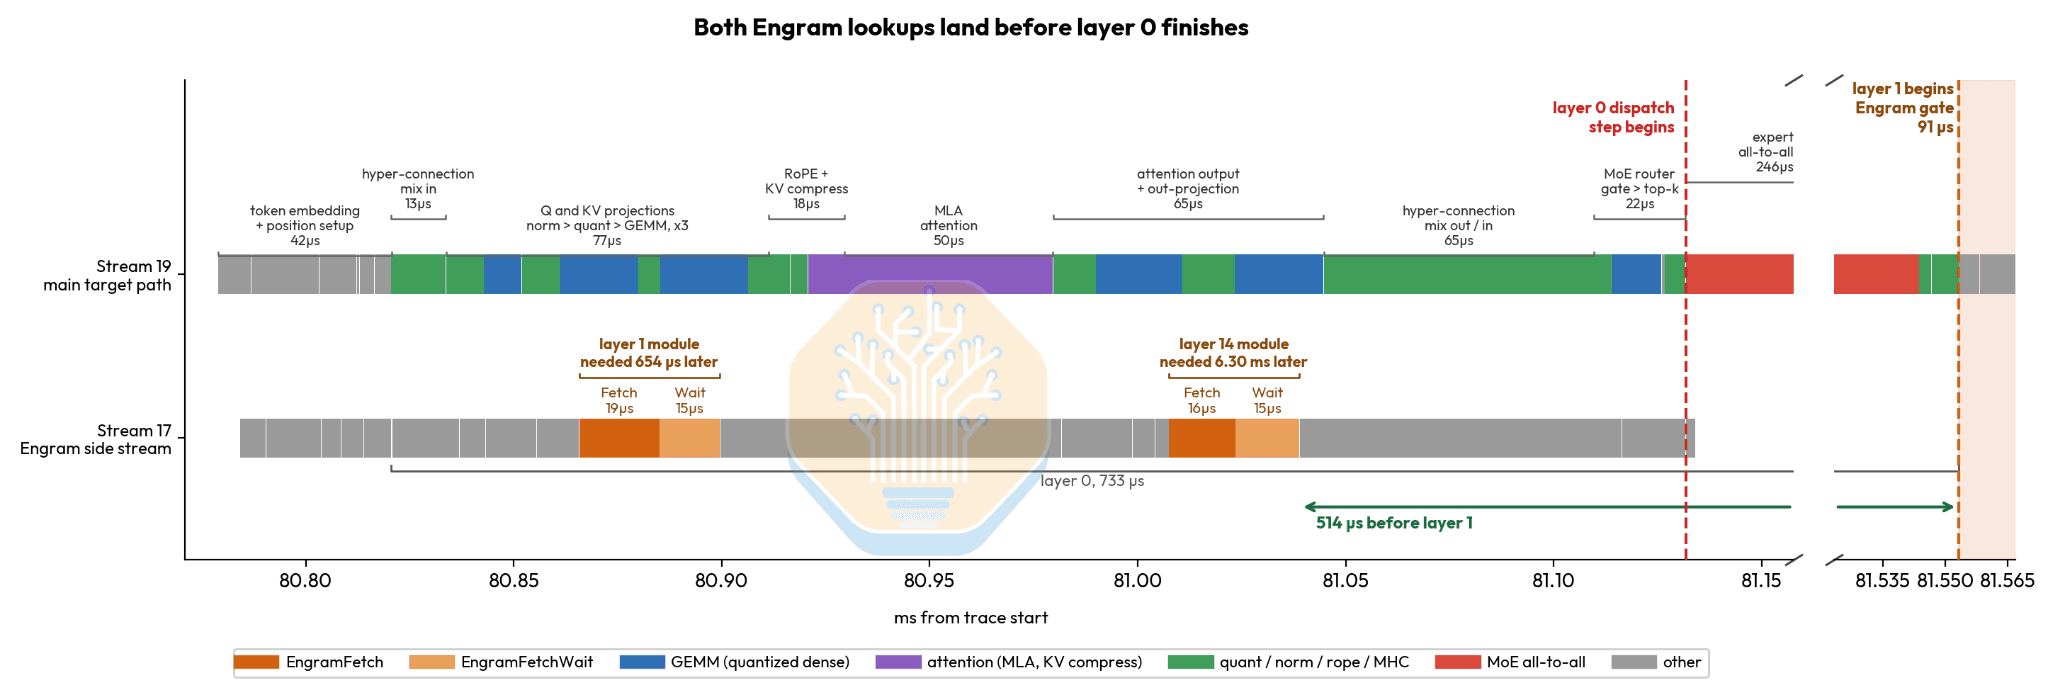
由于 Engram 以 token ID 为输入,查询可以异步执行,并与第 0 层计算重叠。因此,相比放在 HBM 中,offload 到 DRAM 可以不损失性能;但 offload 到 PCIe 4.0 SSD 会降低性能。更多细节见我们的 Engram 分析。
汇总稳态窗口中的 kernel 时长后,可以看到 Stream 19 占用了窗口的 88.8%,但仅占设备事件累计时长的 72.6%,因为其他 stream 与之重叠。图中大块的 MIX_AIV 和 AI_VECTOR_CORE 区域既包含 dispatch/combine,也包含量化工作。
Ascend 通过 MIX_AIC、MIX_AIV、AI_CORE 和 AI_VECTOR_CORE 暴露分别调度的 Cube 与 Vector 路径。每个事件都归属一种任务类型,因此按类型汇总时,同一个事件不会被重复计数。不过,混合类型仍涉及不止一个物理单元,不能仅凭名称就把 kernel 的耗时当作实测的 Cube 或 Vector 单元利用率。
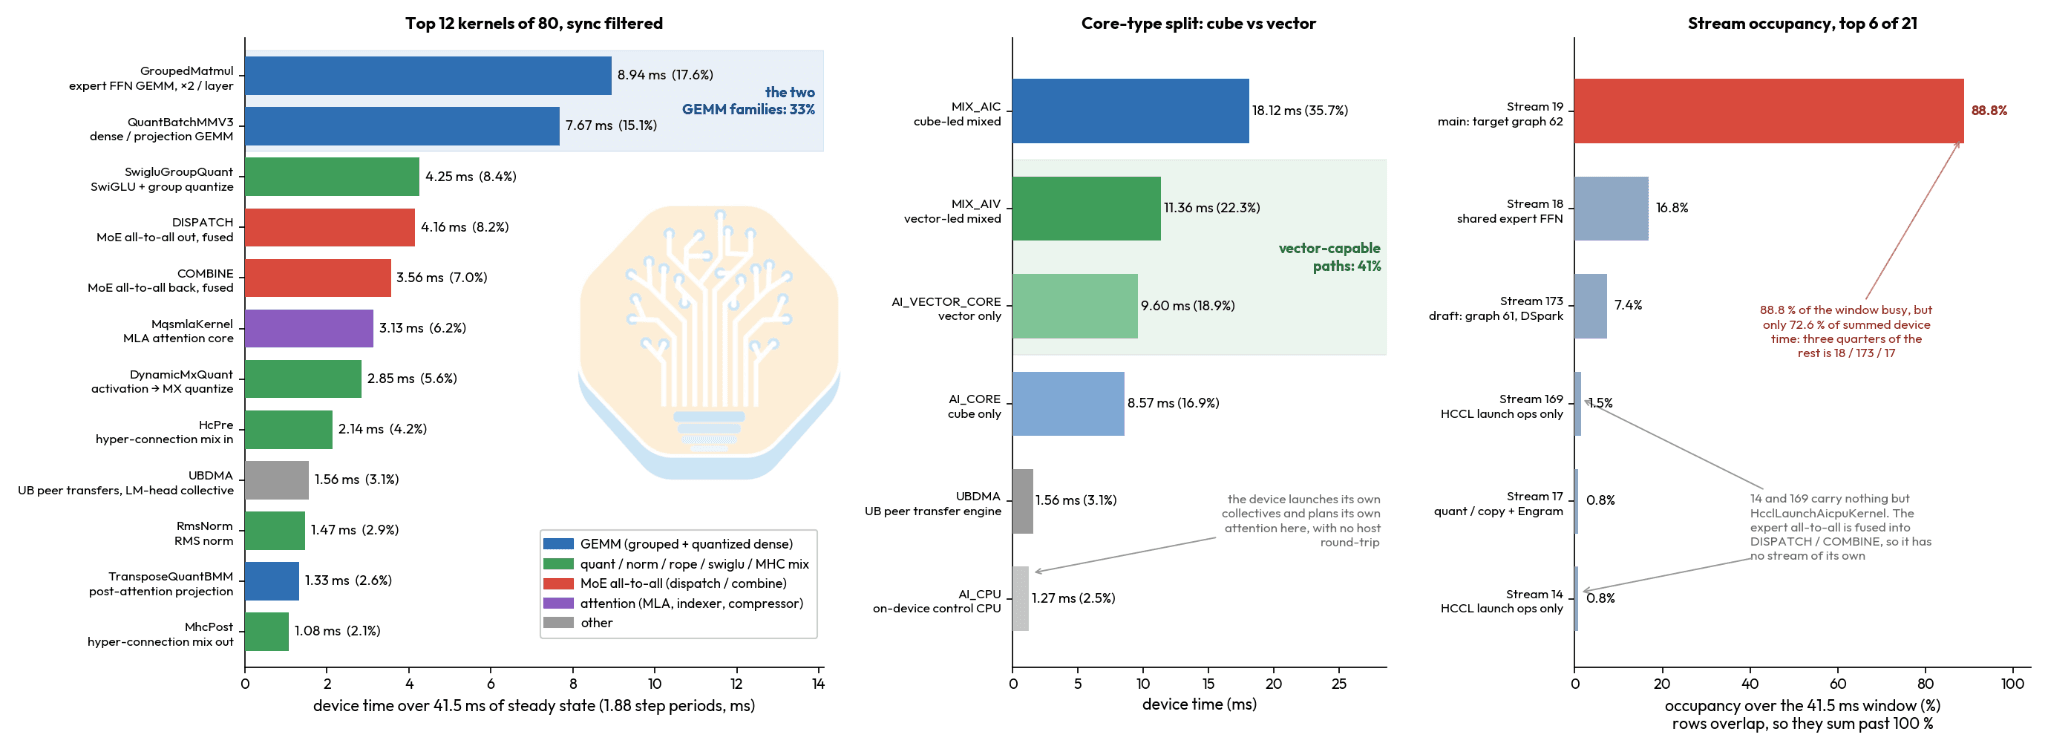
在一个一阶情景分析中,将 Cube 吞吐翻倍、其他设备工作保持不变,可得到 1.32× 的步骤加速。该情景固定了测得的 stream 重叠关系,也保持 idle 时间不变。它是工作构成分析,不是对新芯片的预测:混合任务类型并不是互斥的利用率测量,带宽、依赖和调度也都可能改变结果。
量化融合仍然是一个优化机会。其吸引力来自反复出现的生产者到消费者边界,以及它在 Vector 类别中的较大占比;这个类别还包含融合通信。
生态缺口
一个问题是,这种合作可能非常适合 DeepSeek,却不一定让其他用户同样容易使用 Ascend。
对 DeepSeek 而言,开发编译器、维护 kernel、调试供应商特有行为,会与模型研究和产品开发争夺资源,尽管这种情况可能是暂时的。
对其他用户而言,硬件配置与 DeepSeek 不一致时,可能遇到问题。大部分优化围绕超节点展开。截至 vLLM-Ascend_0.26.0rc1,Ascend 搭配 x86 主机仍存在不少问题:
- x86 主机不支持 DeepGEMM。
- vLLM-Ascend 依赖的
memfabric_hybrid包含硬编码 ARM header,会阻止启动,无法开箱即用。 - vLLM-Ascend 在非 ARM CPU 上跳过 CPU binding。
- 没有 NPU + x86 CI,部分 recipe 需要补丁。
相关术语
公开部分到此结束。订阅者专享的后续内容请见原文。
本文涉及的硬件与软件概念包括 Ascend、CANN、AICPU、Cube 与 vector 核心、内存传输引擎、TileLang、kernel 自动调度、URMA、DeepGEMM 和 DeepEP。
理解测试边界可参考微基准测试、指针追逐、芯片分档及 warm-cache 基准测试。相关模型与性能分析概念还包括稀疏注意力、KV cache 量化、投机解码、Engram、GPU 利用率和 kernel 融合。
本文由英文原文翻译而来,如有歧义以英文版为准。所有文章版权归 © SemiAnalysis 所有,保留所有权利。覆盖应用源代码的 AGPL-3.0 许可证不适用于文章内容。