预计阅读 3 分钟
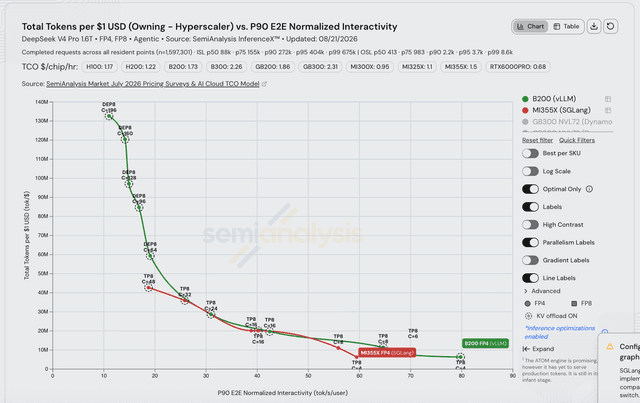
DeepSeek V4 Pro 的 AgentX 结果:MI355X 对比 B200,以及 8 月 21 日的反转
在端到端延迟的每美元性能上,AMD 一度追平 B200 vLLM,随后上游 vLLM 的优化改变了格局
- agentx
- agentic
- benchmark
- +6
InferenceX 研究
关于智能体推理、AgentX 结果、芯片与推理框架经济性的基准测试文章。
不熟悉相关概念? 浏览 AI 推理术语表。
12 篇文章
预计阅读 3 分钟
在端到端延迟的每美元性能上,AMD 一度追平 B200 vLLM,随后上游 vLLM 的优化改变了格局
预计阅读 3 分钟
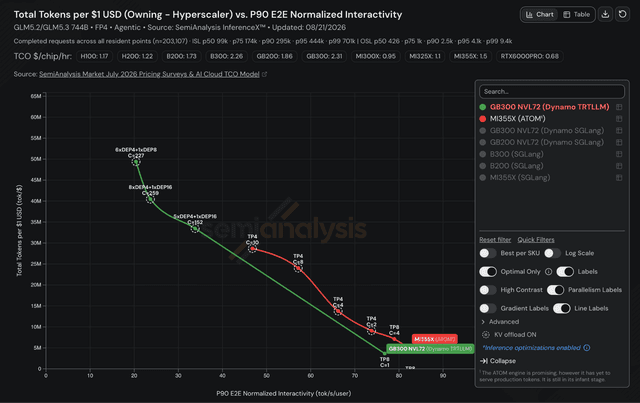
AMD 厂商引擎在每美元性能上胜出的区间,以及端到端归一化交互性究竟衡量什么
预计阅读 2 分钟
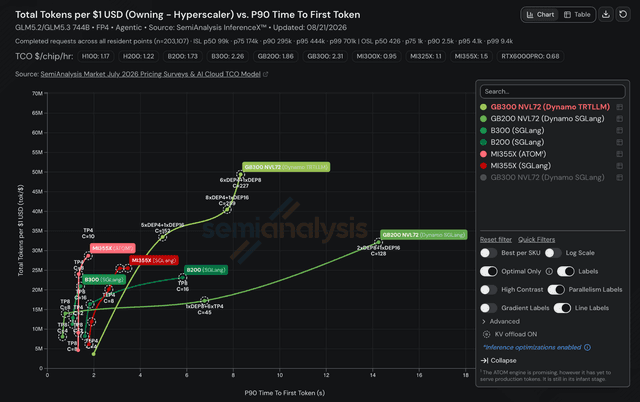
在这个运行点上,即便 AMD 硬件白送也仍然填不平差距
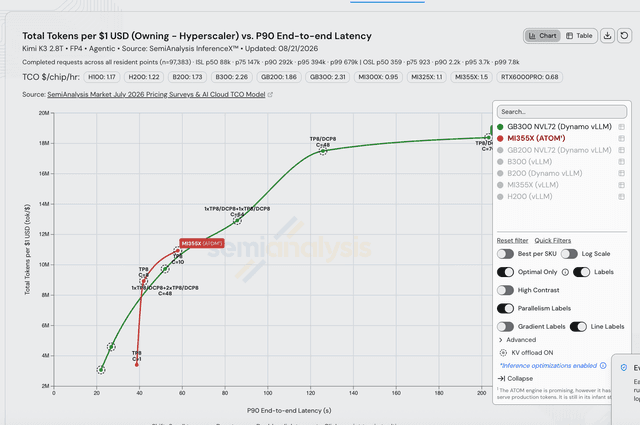
预计阅读 2 分钟
AMD 的厂商引擎在每美元性能前沿上赢下了实打实的一段,而 Hopper 连服务 K3 都很吃力
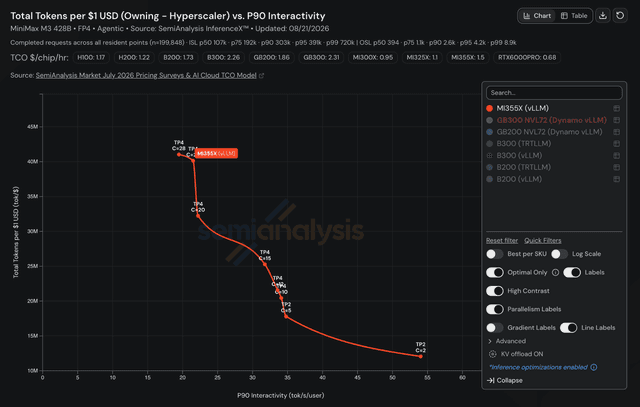
预计阅读 3 分钟
Dynamo router 成为瓶颈,没有提交使用上下文并行,而 AMD 完全没有用上 KV offload
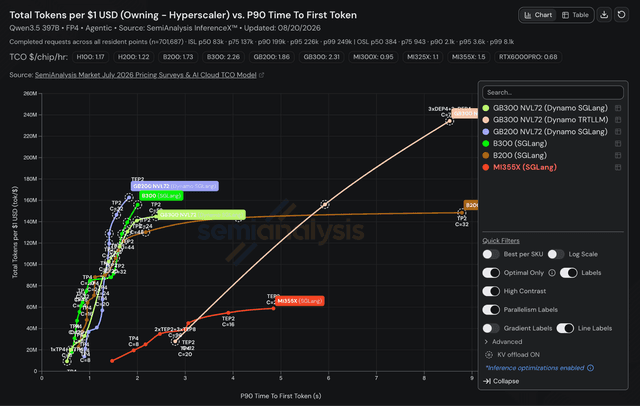
预计阅读 2 分钟
GatedDeltaNet、262k 原生上下文,以及同一引擎上 AMD 完全缺席的竞争
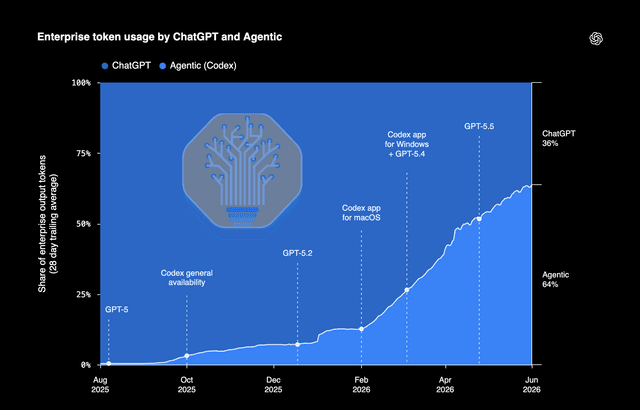
预计阅读 71 分钟
开源价值 300 万美元的数据集、100 万以上上下文长度、多轮、子智能体、95%+ KVCache 命中率、GB300 NVL72、MI355X、B200
预计阅读 31 分钟
第0天推理性能、InferenceX、26天内性能提升100倍、每百万 token 成本、Huawei 950DT 推理 Trace 分析

预计阅读 14 分钟
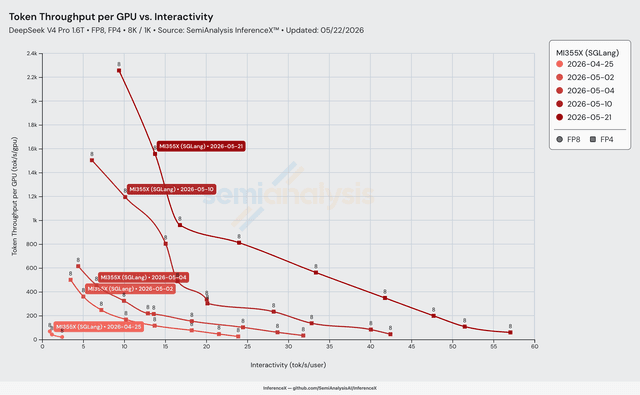
amd/deepseek_v4 分支合入了 TileLang 注意力索引器、Triton 稀疏 MLA、融合 RoPE/Hadamard、FlyDSL MoE 以及 FP4 权重,历经 31 个性能优化 PR——将首次点亮时 20 tok/s/GPU、2.4 tok/s/user 的水平提升至 8K/1K 负载下 2,256 tok/s/GPU、9.4 tok/s/user,吞吐量与交互性同步攀升

预计阅读 7 分钟
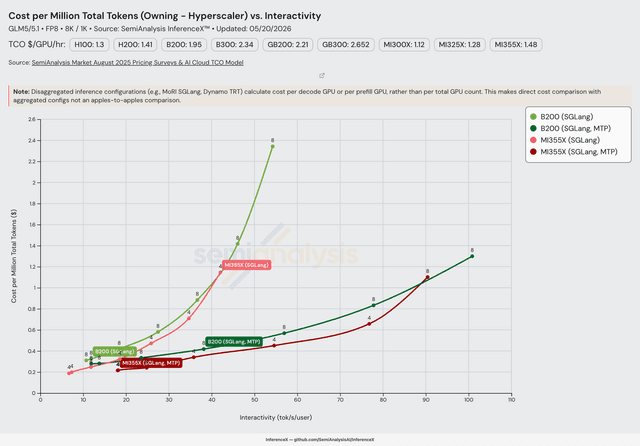
GLM-5 发布 14 周后,AMD 在 MI355X 上同时实现了 SGLang FP8 的 MTP 和非 MTP 方案 — 通过 TileLang 实现的融合 MLA + FP8 KV 缓存在大部分性能 Pareto 前沿上将单节点 FP8 成本曲线翻转为 AMD 占优

预计阅读 7 分钟
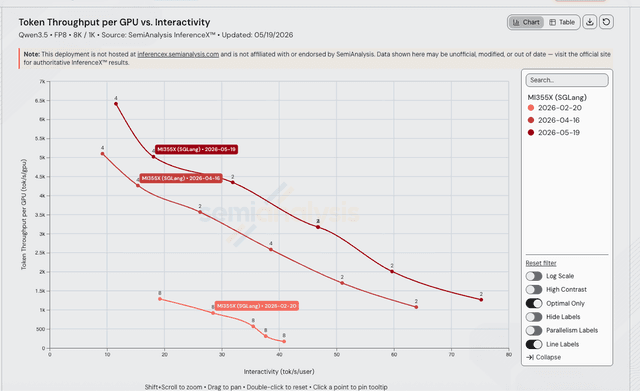
从 v0.5.8(2 月)→ v0.5.10rc0(4 月)→ v0.5.12(5 月),三次 AITER 内核合入 MI355X 加上从 TP=8 到 TP=2/TP=4 的重新调优,将 Qwen3.5 8k/1k 峰值从 1.3k 推高至 6.4k tok/s/GPU,并将曲线延伸至 75 tok/s/user

预计阅读 7 分钟
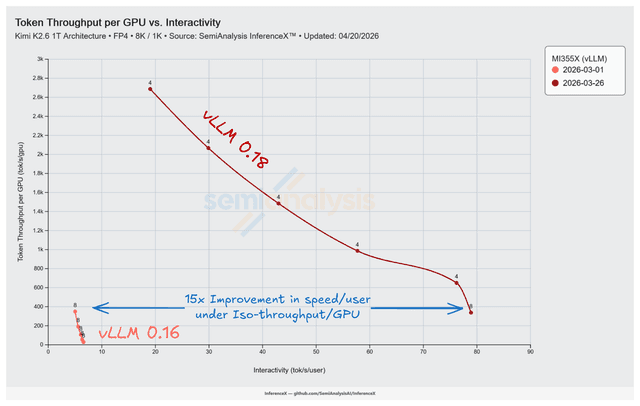
vLLM PR #35850 修复了 MI355X CDNA4 上的 AITER MLA 分发路径,解锁 TP=8 下的 Kimi K2.5 推理性能,随 vLLM 0.18 一同发布