
白皮书 · 执行摘要
AMD Instinct MI355X Kimi K3 每 GigaWatt 每年最高可创造 320 亿美元收入
执行摘要 - 智能体推理服务经济性分析
- AMD
- MI355X
- Kimi K3
- vLLM
- AgentX
- Economics
核心数字
- 每 GW·年收入
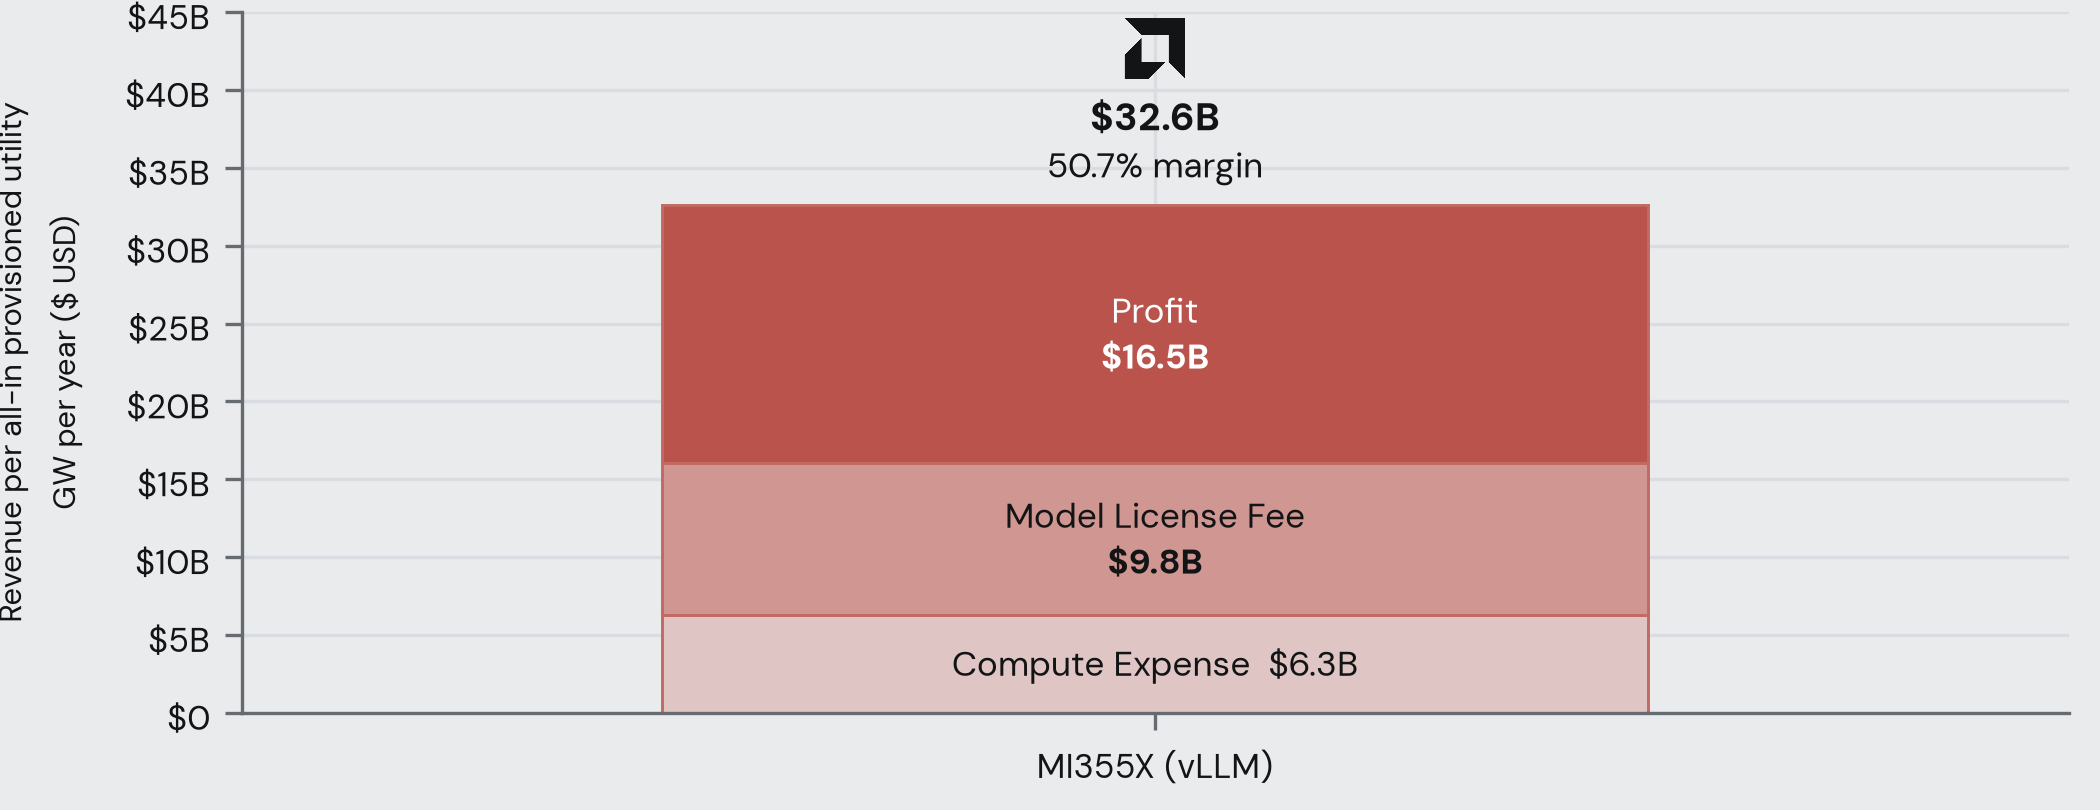
- $32.6B
- Kimi K3 按 OpenRouter 标价计费,60% 利用率
- 每 GW·年利润
- $16.5B
- 按超大规模云厂商采购规模自建,算力成本 $1.50/GPU/hr;每芯片小时利润 $3.95
- 利润率
- 50.7%
- 扣除算力支出和 30% 模型授权费之后
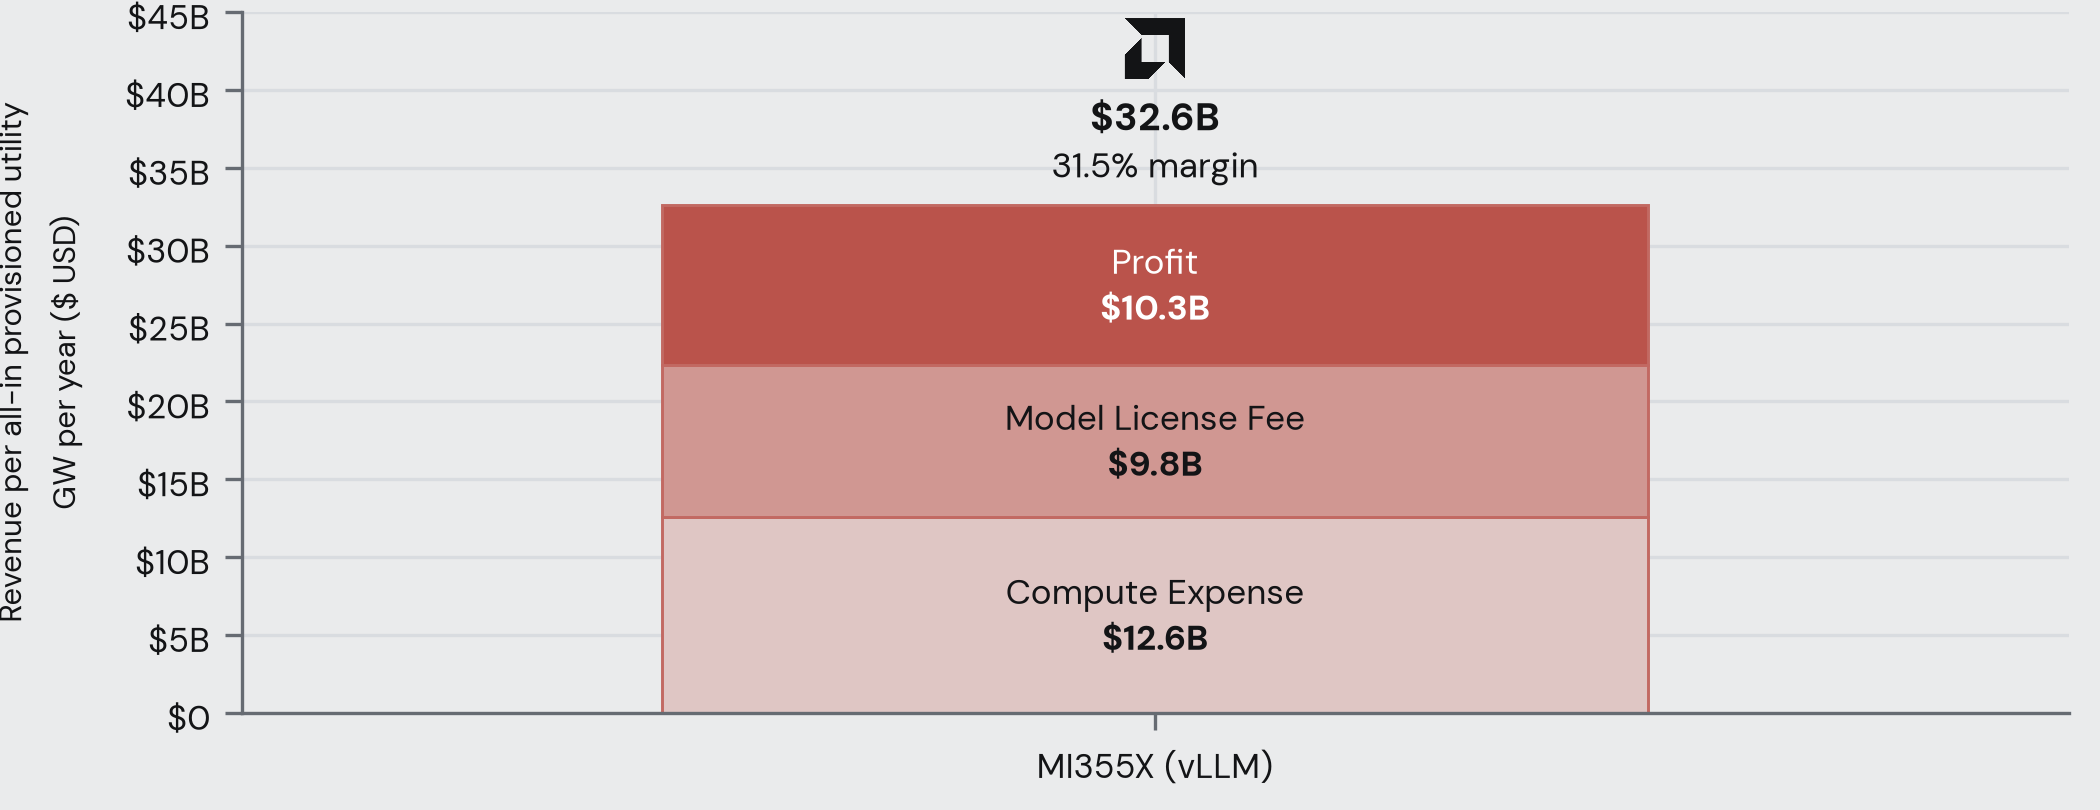
按 $3.00/GPU/hr 租用(2026 年 8 月 3 年期租约价格):$10.3B 利润31.5% 利润率$2.45 每芯片小时
图表
Kimi K3 2.8T 智能体 每吉瓦每年收入与利润估算(P90 交互性 45 tok/s/user)
 Kimi K3 2.8T 智能体 每吉瓦每年收入与利润估算(P90 交互性 45 tok/s/user)
- 成本层级:
- 自有(超大规模云大批量)
- 利用率:
- 60%
- 模型许可费假设:
- 30%
- 更新时间:
- 2026-09-04
- 来源:
- SemiAnalysis InferenceX™
TCO $/chip/hr: MI355X: 1.5
来源: SemiAnalysis Market August 2026 Pricing Surveys & AI Cloud TCO Model
每百万 token 售价: 输入 $3 · 缓存输入 $0.3 · 输出 $15(OpenRouter)

Kimi K3 2.8T 智能体 每吉瓦每年收入与利润估算(P90 交互性 45 tok/s/user)
- 成本层级:
- 自定义 $/GPU/hr(2026 年 8 月 3 年期租约价格)
- 利用率:
- 60%
- 模型许可费假设:
- 30%
- 更新时间:
- 2026-09-04
- 来源:
- SemiAnalysis InferenceX™
TCO $/chip/hr: MI355X: 3
来源: SemiAnalysis Market August 2026 Pricing Surveys & AI Cloud TCO Model
每百万 token 售价: 输入 $3 · 缓存输入 $0.3 · 输出 $15(OpenRouter)

摘要
在 InferenceX 用于智能体工作负载的 45 tok/s/user 运行点上,1 GW 电网供电的 MI355X 算力在 vLLM 上运行 Kimi K3 2.8T,每年最高可产生 326 亿美元的 token 收入。该数字来自单个 8 GPU MI355X 节点(FP4 权重、MTP 投机解码、TP8)上的 AgentX trace 回放实测,按 Kimi K3 在 OpenRouter 的价格计费(每百万 token 输入 $3.00、缓存输入 $0.30、输出 $15.00),并按 60% 利用率售出。两种成本情形界定了运营方的结果区间:以超大规模云厂商的采购规模自建集群,全口径成本为每 GPU 小时 $1.50,扣除 30% 模型授权费后剩余 165 亿美元利润,利润率 50.7%;以每 GPU 小时 $3.00(2026 年 8 月 MI355X 3 年期租约价格)租用同等规模集群,则剩余 103 亿美元,利润率 31.5%。
主要结论
每 GW·年 326 亿美元收入。按每 GPU 2.09 kW 的全口径功耗计算(芯片本身加上节点、网络和散热的分摊),1 GW 电网供电可容纳 478,469 张 MI355X GPU。在 P90 45 tok/s/user 运行点,每张 GPU 产生 6,115 tok/s,折合每 GPU 小时 $12.97 的毛收入,按 60% 利用率折减后为 $7.78。
算力不是最大的成本项。按 $1.50/GPU/hr 计算,集群每年成本 63 亿美元,低于以 30% 授权费支付给模型厂商的 98 亿美元。算力成本翻倍到 $3.00/GPU/hr 会增加 63 亿美元支出,利润从 165 亿美元降至 103 亿美元,运营方仍能保留 31.5% 的收入。
45 tok/s/user 位于实测曲线的中段,并非峰值。MI355X 在 vLLM 上的前沿曲线覆盖 10 到 116 tok/s/user 的 P90 交互性区间。把目标放宽到 30 tok/s/user,收入升至每 GW·年 428 亿美元;收紧到 60 tok/s/user,收入降至 173 亿美元,租用情形接近盈亏平衡。
利用率的盈亏平衡点很低。自建集群在 16.5% 利用率即可覆盖算力成本,租用集群为 33.0%。在两种成本情形下,利用率每提高 10 个百分点,每 GW·年收入增加 54 亿美元,利润增加 38 亿美元。
前缀缓存支撑了整个工作负载。智能体 trace 中 99.2% 是输入 token,vLLM 服务端在该运行点的 GPU 前缀缓存命中率为 93.7%,因此尽管输出 token 标价 $15,混合售价仅为每百万 token $0.59。
方法
每 GW·年 GPU 小时数 = 1,000,000 kW / 每 GPU 2.09 kW x 8,760 h = 41.9 亿 GPU 小时。
收入 = 每 GPU 小时毛收入 ($/GPU/hr) x GPU 小时数 x 利用率。
算力支出 = 成本档位 ($/GPU/hr) x GPU 小时数,无论集群是否繁忙都需支付。
模型授权费 = 收入 x 30%。
利润 = 收入 - 算力支出 - 授权费。
每 GPU 小时毛收入 ($/GPU/hr) = tok/s/GPU x 3,600 x 混合 $/M tok;混合价格按插值点的输入占比(99.2%)、缓存命中率(93.7%,缓存输入按 $0.30 计费)和输出占比(0.8%)加权。
插值方法:在 (P90 交互性, tok/s/GPU) 平面取左上 Pareto 前沿,使用单调三次 Hermite 样条(Steffen 1990),不做外推。
假设条件
| 项目 | 取值 |
|---|---|
| 模型 | Kimi K3 2.8T (moonshotai/Kimi-K3),FP4 权重 |
| 硬件 | AMD Instinct MI355X,8 GPU,TP8,单节点 |
| 框架 | vLLM,ROCm nightly 镜像 vllm/vllm-openai-rocm:nightly-7c5dc571 |
| 投机解码 | MTP |
| 工作负载 | InferenceX AgentX 智能体 trace 回放 |
| 运行点 | P90 交互性 45 tok/s/user |
| Token 价格 | 每百万 token 输入 $3.00、缓存输入 $0.30、输出 $15.00(OpenRouter,moonshotai/kimi-k3) |
| 利用率 | 售出基准测试吞吐量的 60% |
| 模型授权费 | 收入的 30% |
| 全口径功耗 | 每 GPU 2.09 kW(SemiAnalysis AI Cloud TCO Model) |
| 成本情形 A | 每 GPU 小时 $1.50,以超大规模云厂商采购规模自建(SemiAnalysis AI Cloud TCO Model) |
| 成本情形 B | 每 GPU 小时 $3.00,2026 年 8 月 MI355X 3 年期租约价格 |
| 每年小时数 | 8,760 |
| 数据日期 | 2026-09-04 |
数据来源
- InferenceX 每 GW 利润估算器https://inferencex.semianalysis.com/zh/profit-estimator-per-gigawatt
- InferenceX AgentX 仪表板https://inferencex.semianalysis.com/zh/agentx
- OpenRouter Kimi K3 定价https://openrouter.ai/moonshotai/kimi-k3
- SemiAnalysis AI Cloud TCO Modelhttps://semianalysis.com/ai-cloud-tco-model/
获取完整执行摘要
两页 PDF 包含两张图、假设条件表和数据来源链接。