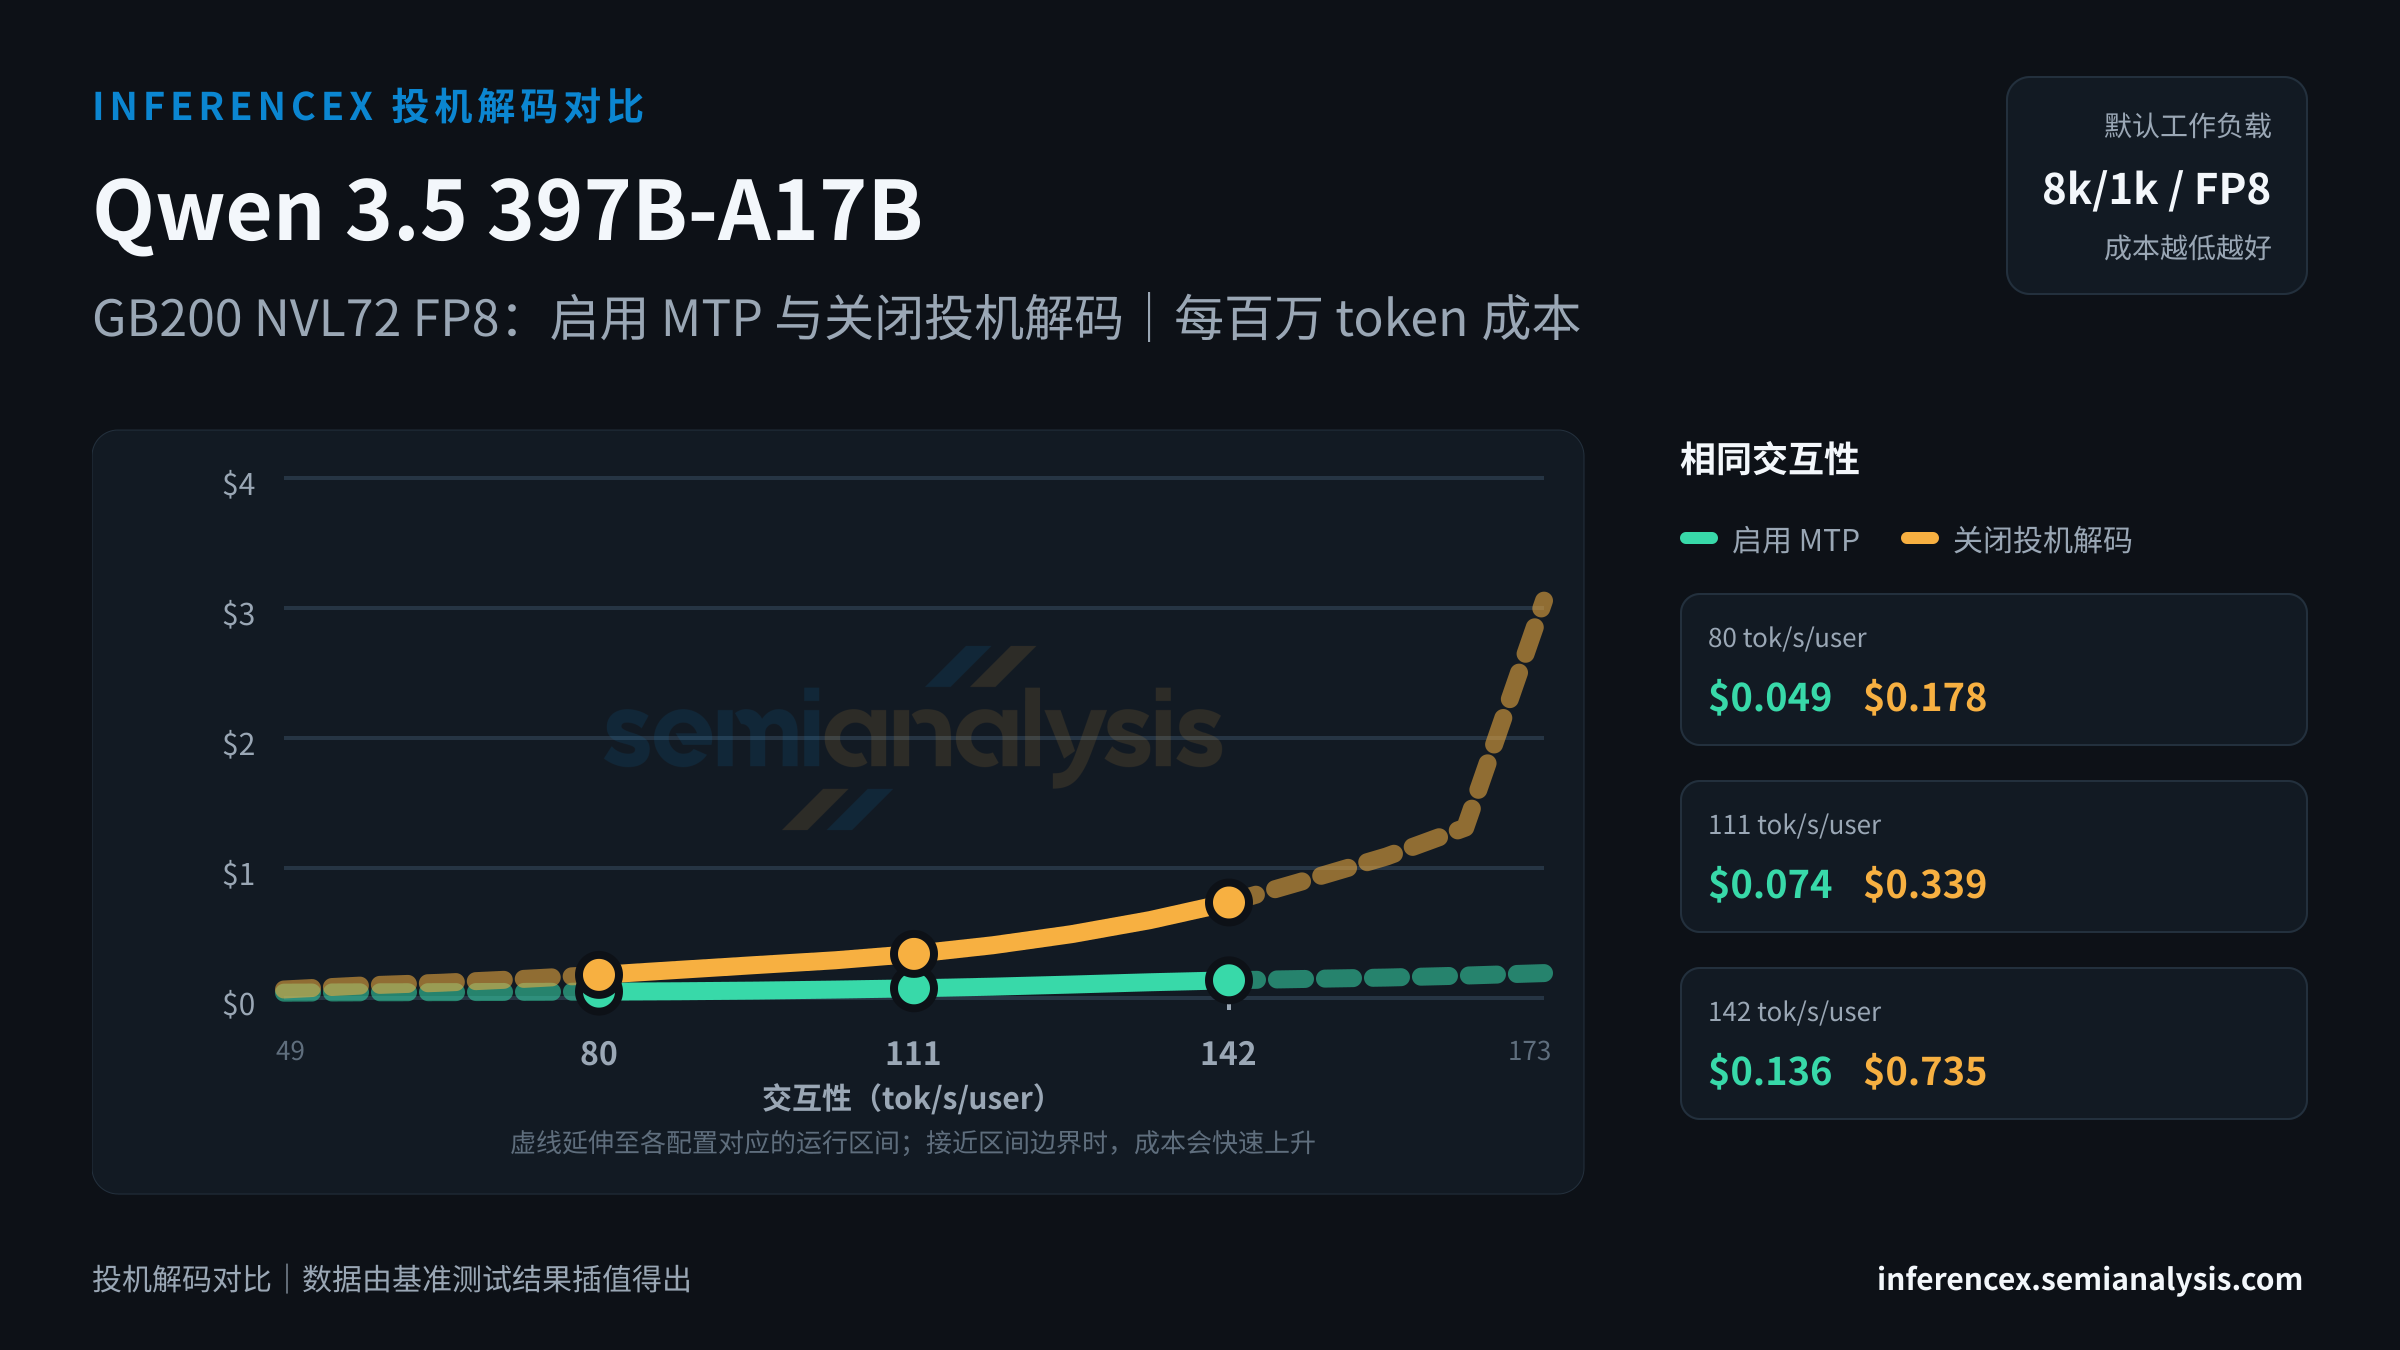
GB200 NVL72 FP8:启用 MTP 与关闭投机解码的对比
在 GB200 NVL72 FP8(NVIDIA Blackwell)上运行 Qwen 3.5 397B-A17B 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
87 tok/s/user 接近 45–213 tok/s/user 交互性区间的下限。在这一运行点,启用 MTP 时,吞吐量为 9674 tok/s/chip,每百万 token 成本为 $0.05;关闭投机解码时,吞吐量为 3576 tok/s/chip,每百万 token 成本为 $0.14。MTP 的成本效率高出 170%;MTP 的单芯片吞吐量高出 170%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。
在 GB200 NVL72 FP8 上运行 Qwen 3.5 397B-A17B,目标交互性设为 129 tok/s/user:启用 MTP 时,吞吐量为 6569 tok/s/chip,每百万 token 成本为 $0.08;关闭投机解码时,吞吐量为 1882 tok/s/chip,每百万 token 成本为 $0.27。MTP 的成本效率高出 249%;MTP 的单芯片吞吐量高出 249%。投机解码通过接受 draft token 降低每 token 延迟;收益因工作负载和 prompt 分布而异。
Qwen 3.5 397B-A17B 在 GB200 NVL72 FP8 上的目标交互性设为 171 tok/s/user:启用 MTP 时,吞吐量为 3525 tok/s/chip,每百万 token 成本为 $0.15;关闭投机解码时,吞吐量为 957 tok/s/chip,每百万 token 成本为 $0.54。MTP 的成本效率高出 268%;MTP 的单芯片吞吐量高出 268%。draft token 接受率决定了在给定并发数下,投机解码是提升性能还是拖累性能。 (以上数据基于此 URL 固定的 8k/1k · fp8 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP:9673.9关闭投机解码:3576.3 | 启用 MTP:6569.0关闭投机解码:1882.3 | 启用 MTP:3524.6关闭投机解码:957.5 |
| 成本($/M tok) | 启用 MTP:$0.053关闭投机解码:$0.144 | 启用 MTP:$0.079关闭投机解码:$0.274 | 启用 MTP:$0.147关闭投机解码:$0.540 |
| tok/s/MW | 启用 MTP:5173206关闭投机解码:1912467 | 启用 MTP:3512833关闭投机解码:1006594 | 启用 MTP:1884826关闭投机解码:512024 |
| 并发数 | 启用 MTP:~1079关闭投机解码:~40 | 启用 MTP:~339关闭投机解码:~14 | 启用 MTP:~48关闭投机解码:~5 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。