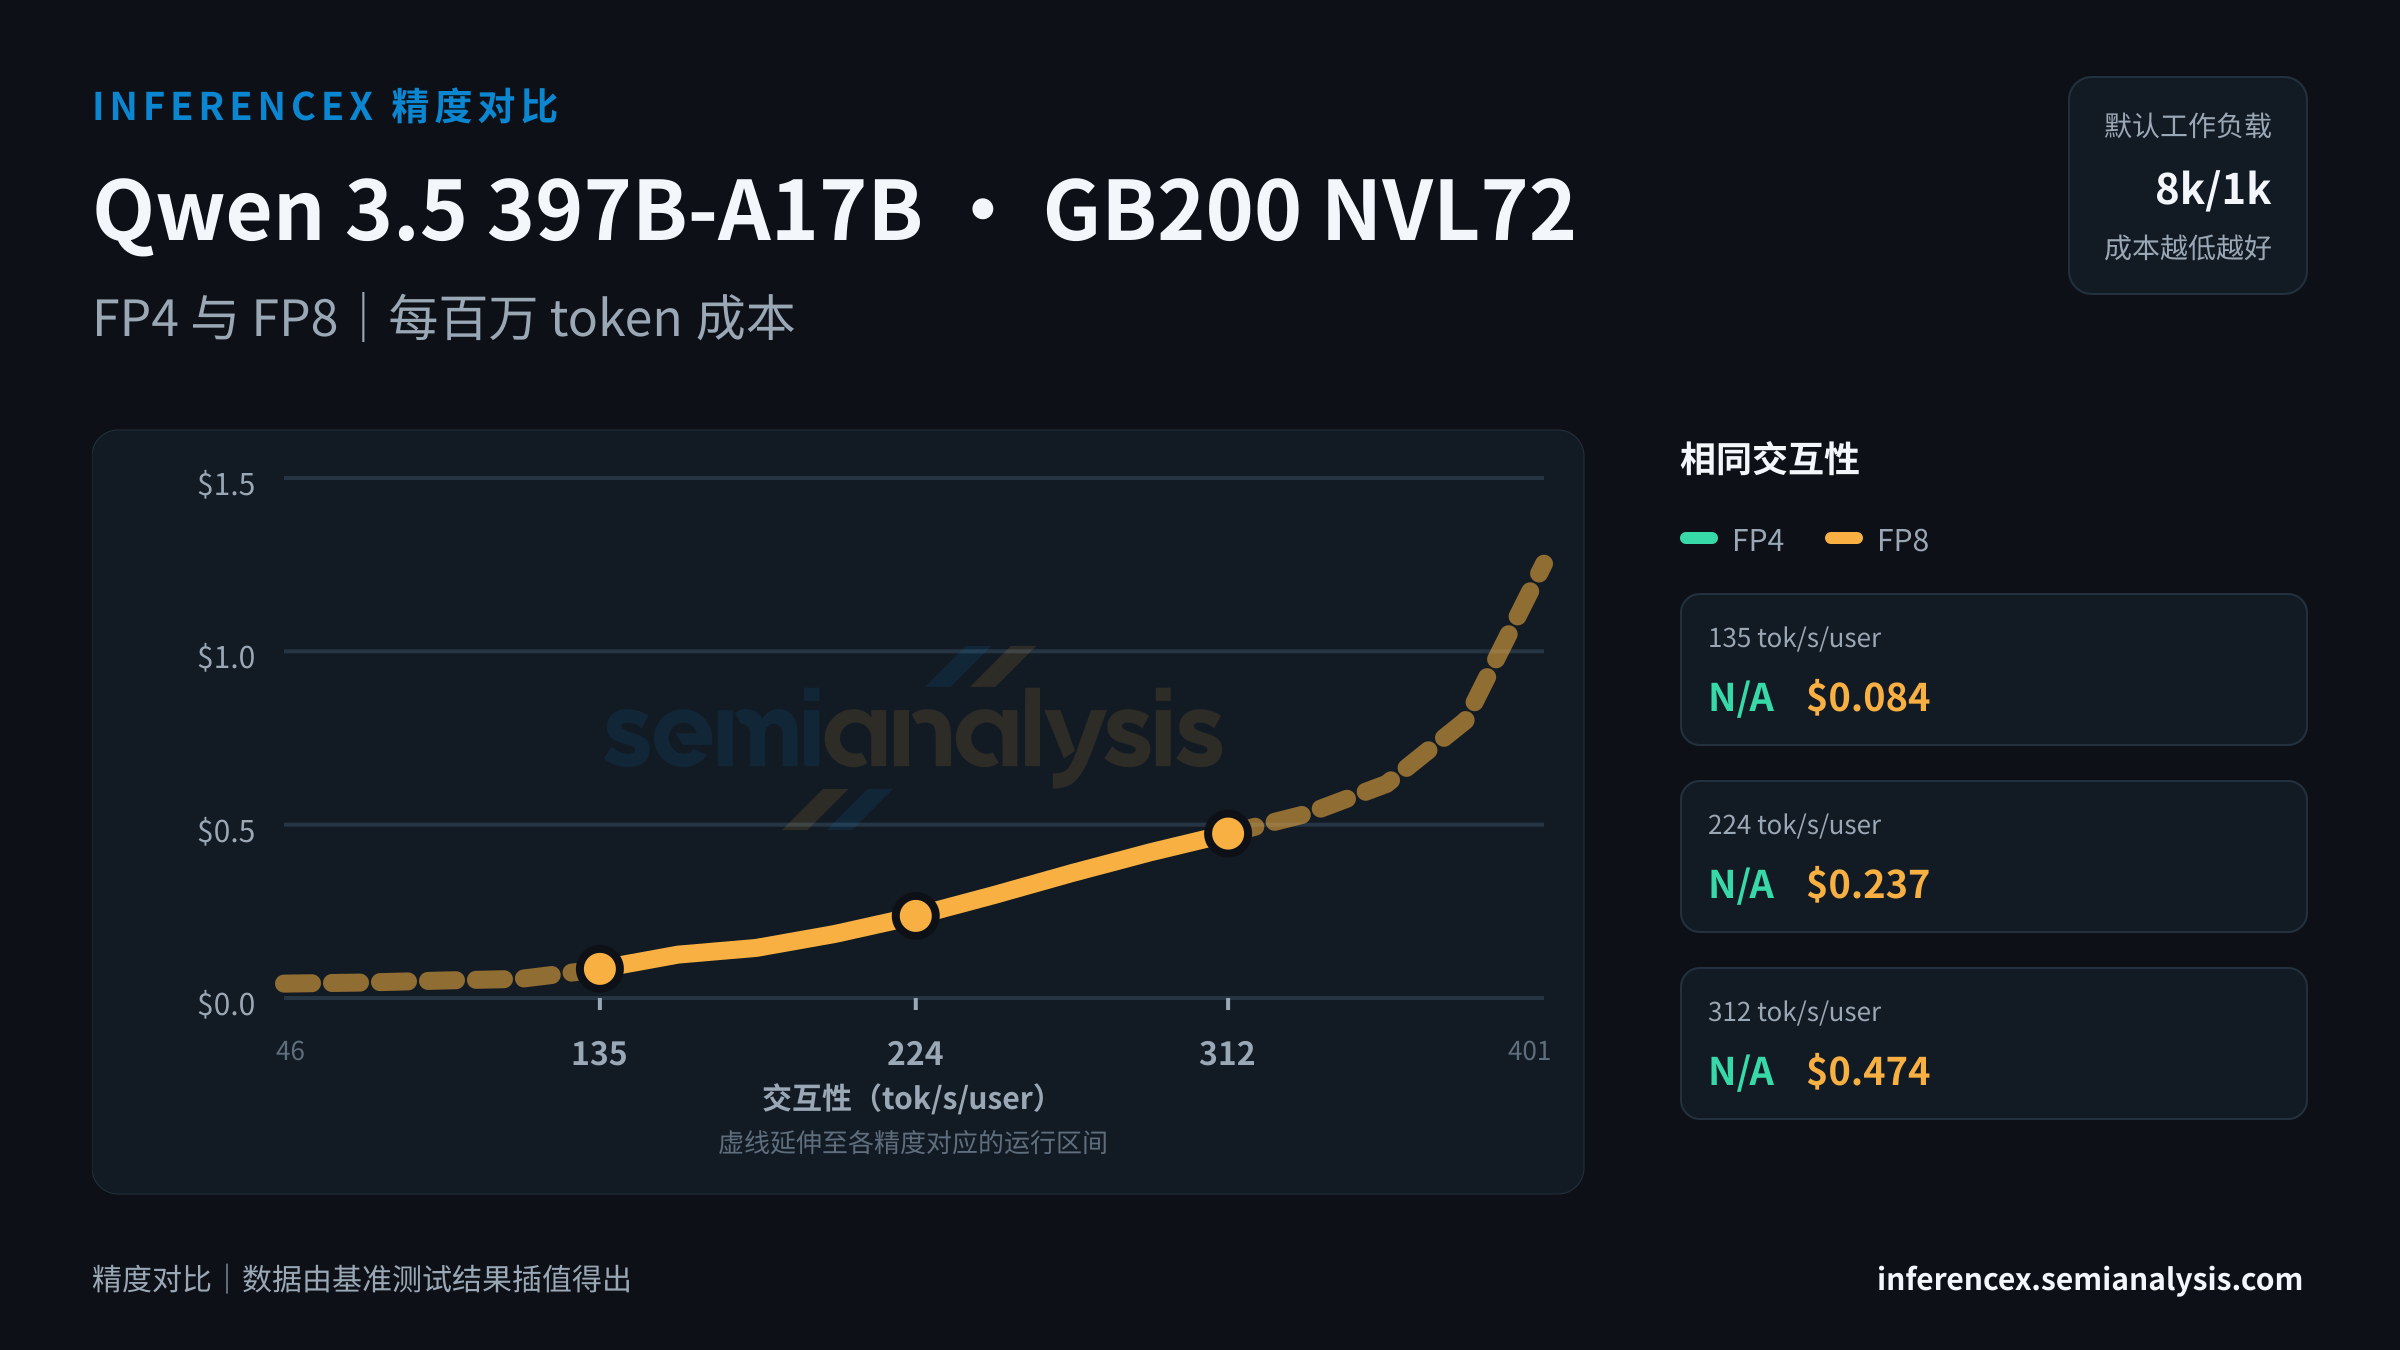
Qwen 3.5 397B-A17B · GB200 NVL72 · 精度对比
GB200 NVL72:FP4 与 FP8 精度对比
在 GB200 NVL72(NVIDIA Blackwell)上,比较 FP4 与 FP8 两种量化精度对 Qwen 3.5 397B-A17B 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
在 GB200 NVL72 上运行 Qwen 3.5 397B-A17B,目标交互性为 125 tok/s/user 时,FP4 的吞吐量为 11,554 tok/s/chip,每百万 token 成本为 $0.045;FP8 的吞吐量为 7,487 tok/s/chip,每百万 token 成本为 $0.069。在同一芯片上,FP4 的单芯片吞吐量高出 54%,因此每 token 成本低 35%。较低的量化精度以模型准确率为代价换取更高吞吐量;如需了解对模型质量的影响,请查看评估页。
当 Qwen 3.5 397B-A17B 在 GB200 NVL72 上的目标交互性为 208 tok/s/user 时,FP4 的吞吐量为 4,680 tok/s/chip,每百万 token 成本为 $0.11;FP8 的吞吐量为 2,496 tok/s/chip,每百万 token 成本为 $0.21。在同一芯片上,FP4 的单芯片吞吐量高出 87%,因此每 token 成本低 47%。不同量化精度下的模型准确率差异可在评估页查看。
在 GB200 NVL72 上运行 Qwen 3.5 397B-A17B,目标交互性为 291 tok/s/user 时,FP4 与 FP8 的吞吐量分别为 2,116 和 1,160 tok/s/chip,每百万 token 成本分别为 $0.24 和 $0.45。在同一芯片上,FP4 的单芯片吞吐量高出 82%,因此每 token 成本低 45%。较低量化精度下的成本与吞吐量权衡只是整体考量的一部分;模型准确率数据请参阅评估页。 (以上数据基于此 URL 对应的默认 8k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
数据由真实基准测试结果插值得出。调整下方的目标交互性数值,即可比较不同运行点。
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP411,554FP87,487 | FP44,680FP82,496 | FP42,116FP81,160 |
| 成本($/M tok) | FP4$0.045FP8$0.069 | FP4$0.11FP8$0.21 | FP4$0.24FP8$0.45 |
| tok/s/MW | FP46,178,632FP84,003,619 | FP42,502,521FP81,334,718 | FP41,131,692FP8620,160 |
| 并发数 | FP4~682FP8~466 | FP4~119FP8~28 | FP4~13FP8~5 |