AgentX 教程
通过详细遥测数据解析智能体负载
AgentX 上的一个数据点,背后是数千个请求,跨越不断增长的对话、subagent、warmup 阶段、cache 状态,以及动态变化的在途负载。本文介绍如何把这个点展开来看。
- 张单点遥测图表
- 11
- 种单点视图
- 3
- 个回放阶段
- 2
- 条曲线(每个 model、SKU 与引擎组合)
- 1
AgentX 需要的不只是新的基准测试框架和数据集。我们还花了一些时间重构 InferenceX 的可视化,让智能体测试结果更容易探索和理解。Pareto 曲线上的单个点会掩盖大量有价值的信息,因此 AgentX 图表上的每个点现在都是进入其背后完整运行数据的入口。
本教程会逐一介绍这个入口通向的内容:曲线本身如何构建、数据点 tooltip 暴露了哪些信息、详情页上的 11 张单点遥测图表、请求时间线,以及 AgentX 数据集页面上的单会话火焰图(flamegraph)。
为什么一个点不够用
固定序列长度的基准测试点,概括的是一个同质负载:每个请求的 input 和 output 长度都相同,因此用一个聚合吞吐量数字来描述整次运行是公平的。AgentX 的点则不然——它聚合了数千个请求,这些请求的 input 长度随对话延长而增长,subagent 会突发式到达,cache 状态也在整个回放过程中不断变化。
因此,两个聚合吞吐量几乎相同的点,底层行为可能截然不同:一个能稳定维持 prefix cache 命中率,另一个则在反复淘汰与重算。单点遥测数据正是让这种差异变得可见的手段。
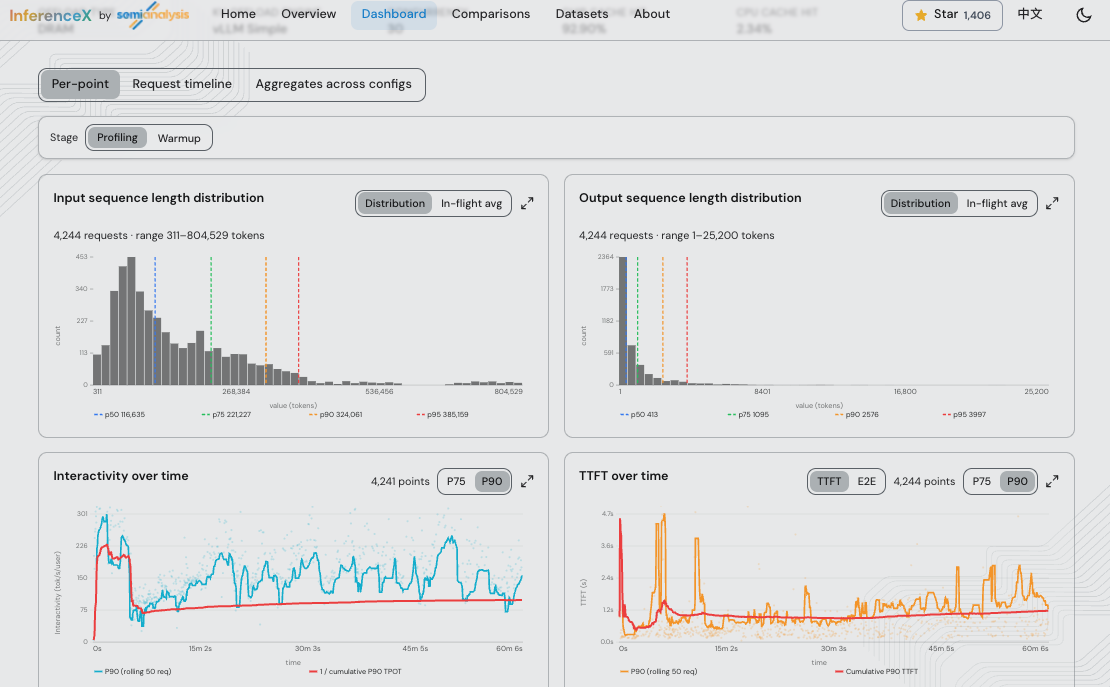
每个 model、SKU 与推理引擎组合只画一条曲线
本次的一项重要改动,是曲线本身的构建方式。在此前版本的 InferenceX 中,开启和关闭 speculative decoding 的配置往往被画成两条独立曲线。我们正在放弃这种做法:前端现在会合并允许使用的推理优化,为每个 model、SKU 与推理引擎组合展示当前可达的最佳曲线。
因此,同一条曲线上的各个点可能使用了不同的优化技术与配置,包括 speculative decoding、disaggregation 或 KV cache offload。我们的目标是呈现每套软硬件栈在生产环境下能达到的最佳性能,而不是为每种可能的优化组合都单独画一条曲线。
我们仍然会暴露每个点的底层配置与来源信息。点击一个数据点会弹出 tooltip,其中详细列出产生该点的具体配置、运行元数据、指向公开可查的 CI 来源链接,以及 AgentX 特有的统计数据。从那里点击 “View charts” 链接,即可打开完整的单点详情页。
单点详情页
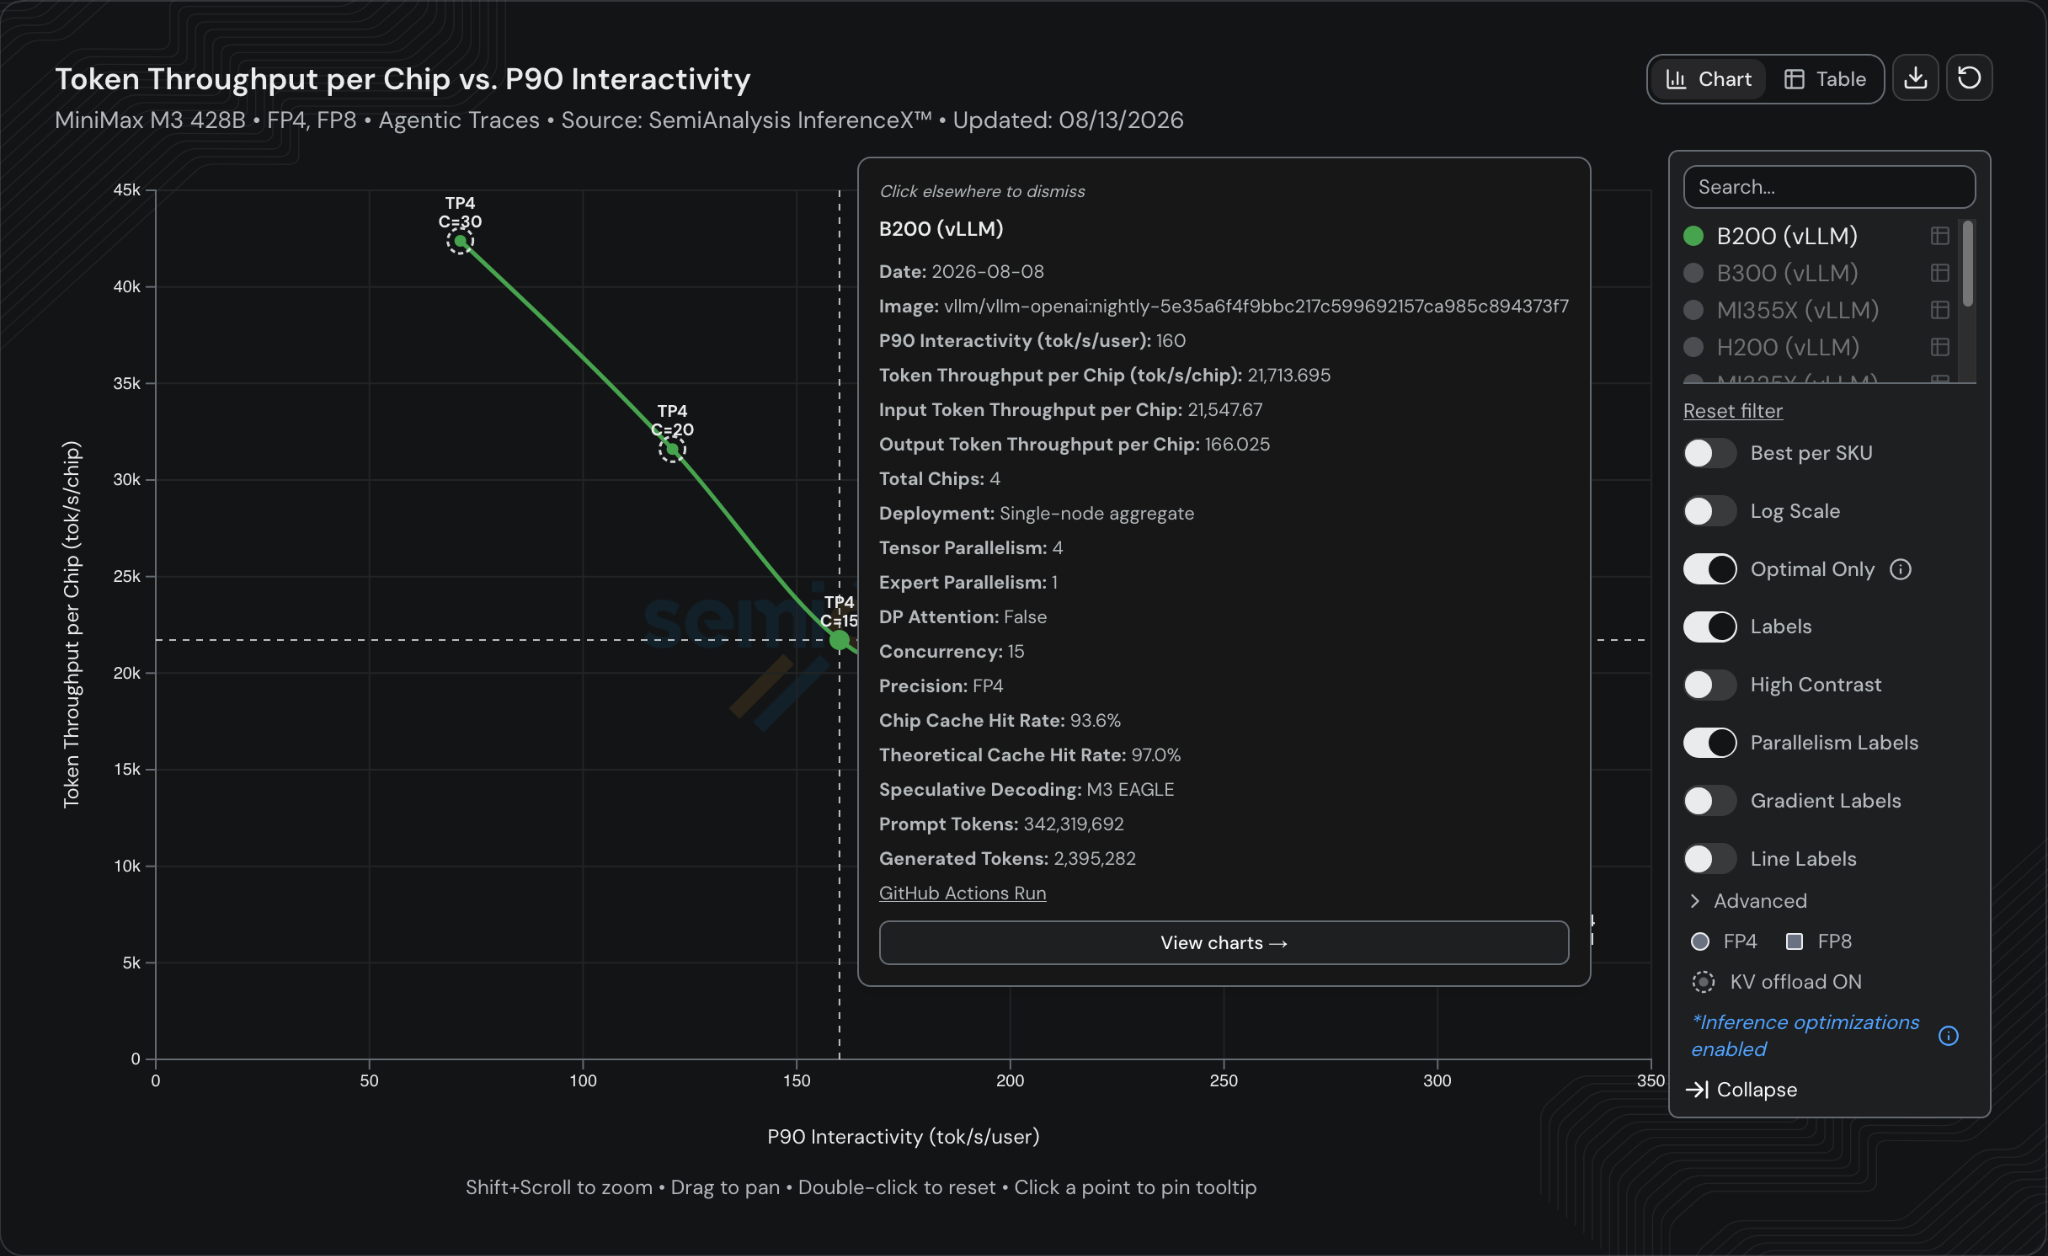
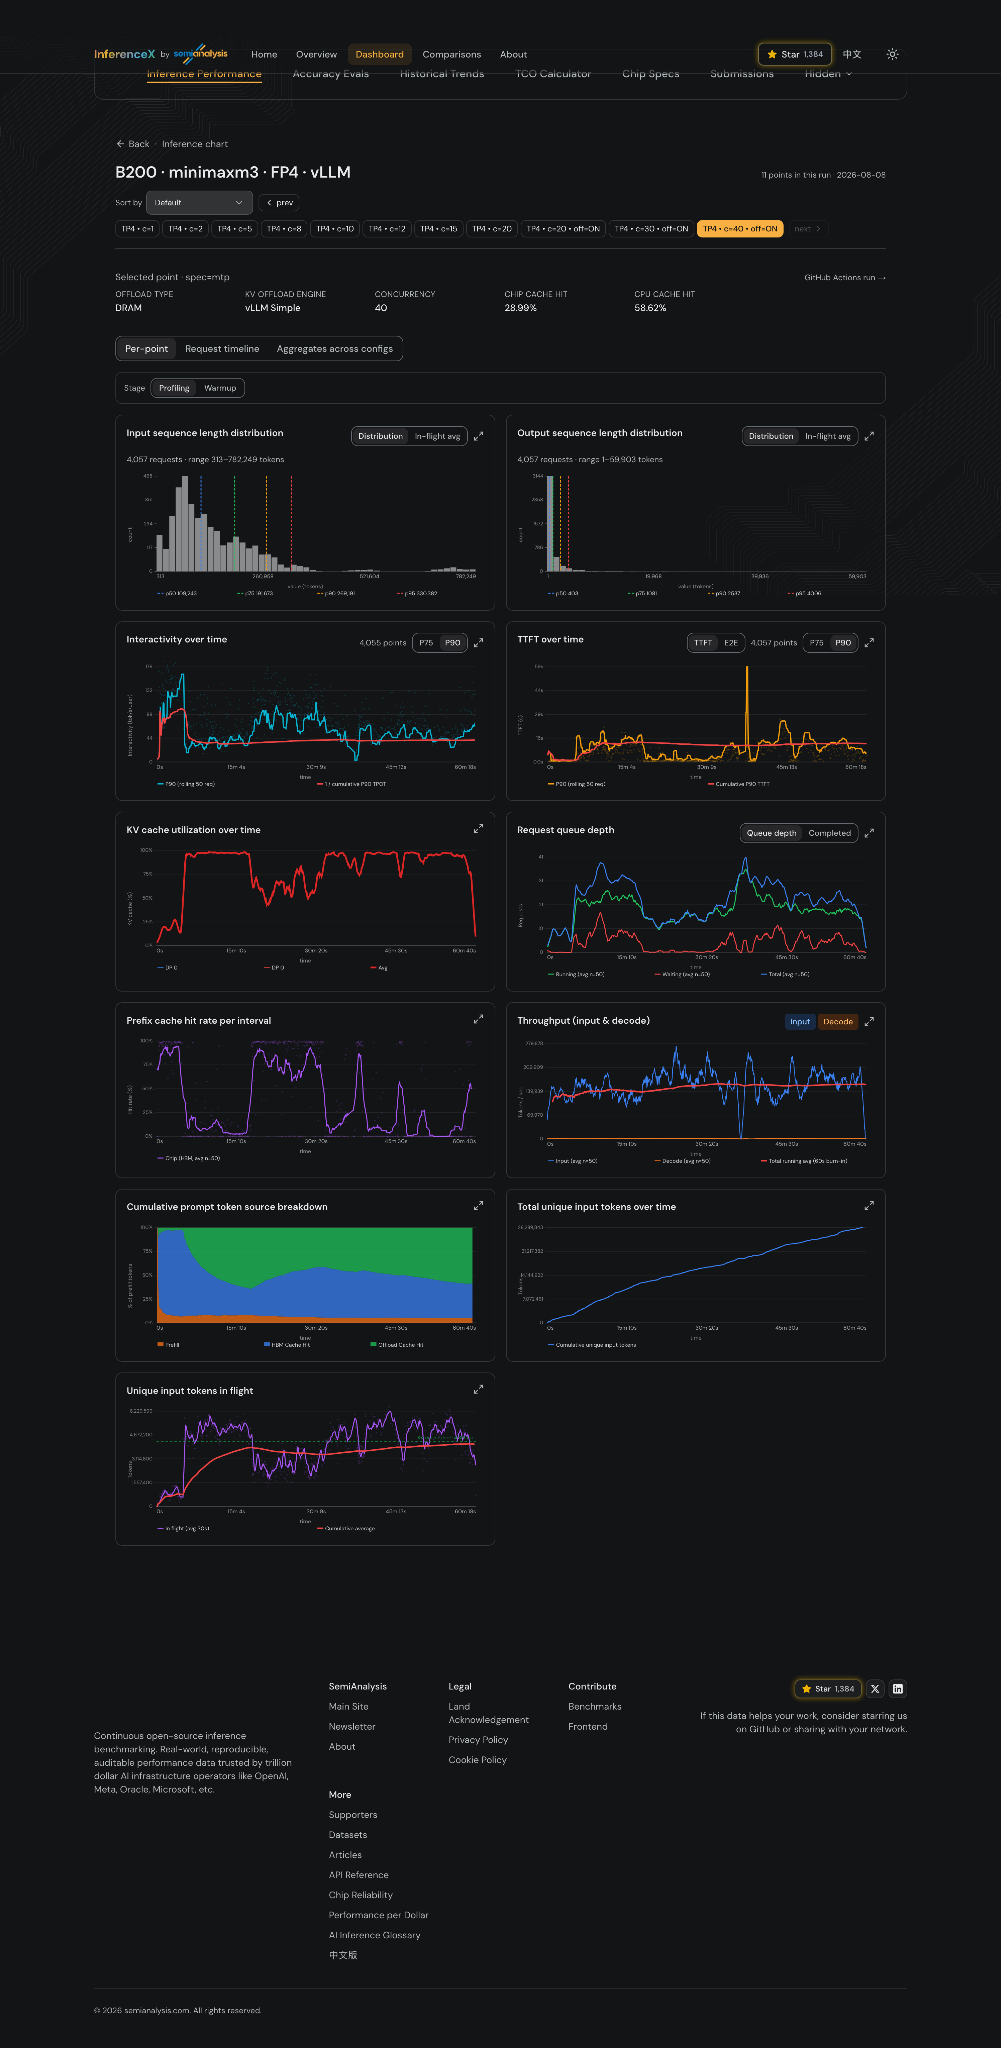
单点详情视图可以更深入地观察所选的 AgentX 运行。这些指标让人更容易理解:为什么两个聚合吞吐量相近的点,在整个回放过程中的表现却可能截然不同。
该页面还将 warmup 与 profiling 数据分开。读者可以在两个阶段之间切换,分别查看系统在建立 cache 状态期间,以及在基准测试所用的 profiling 阶段中的行为。对外报告的结果只覆盖 profiling 窗口,因此 warmup 阶段正是观察 cache 填充行为及其代价的地方。
- Input 与 output 序列长度分布,可切换为直方图或在途平均值。
- Interactivity 随时间变化,可选 P75 或 P90,并与其累计值对比。
- 首 token 延迟(TTFT)随时间变化,可在 TTFT 与端到端延迟之间切换。
- KV cache 利用率随时间变化;当有多个引擎上报时会分别拆开显示。
- 请求队列深度,以及已完成请求数。
- 每个区间的 prefix cache 命中率。
- Input 与 decode 吞吐量。
- 累计 prompt token 来源构成——prompt 中有多少来自 cache、多少来自重算。
- 累计唯一 input token 数随时间变化,以及在途唯一 input token 数与 KV cache pool 容量的对比。
如何解读启用 KV cache offload 的点
使用了 KV cache offload 的点,在主图上会额外套一圈虚线圆环,用于区分开启了 KV offload 的数据点。选中这类点后,详情页会显示 offload 类型、KV offload 引擎、芯片 cache 命中率和 CPU cache 命中率。
这样一来,无需为每种 offload 配置单独画一条曲线,也能看清 KV offload 在最佳曲线中的贡献——这与“把优化合并到同一条曲线”是同一个思路,只是应用在了效果最容易被忽略的那项优化上。
请求时间线
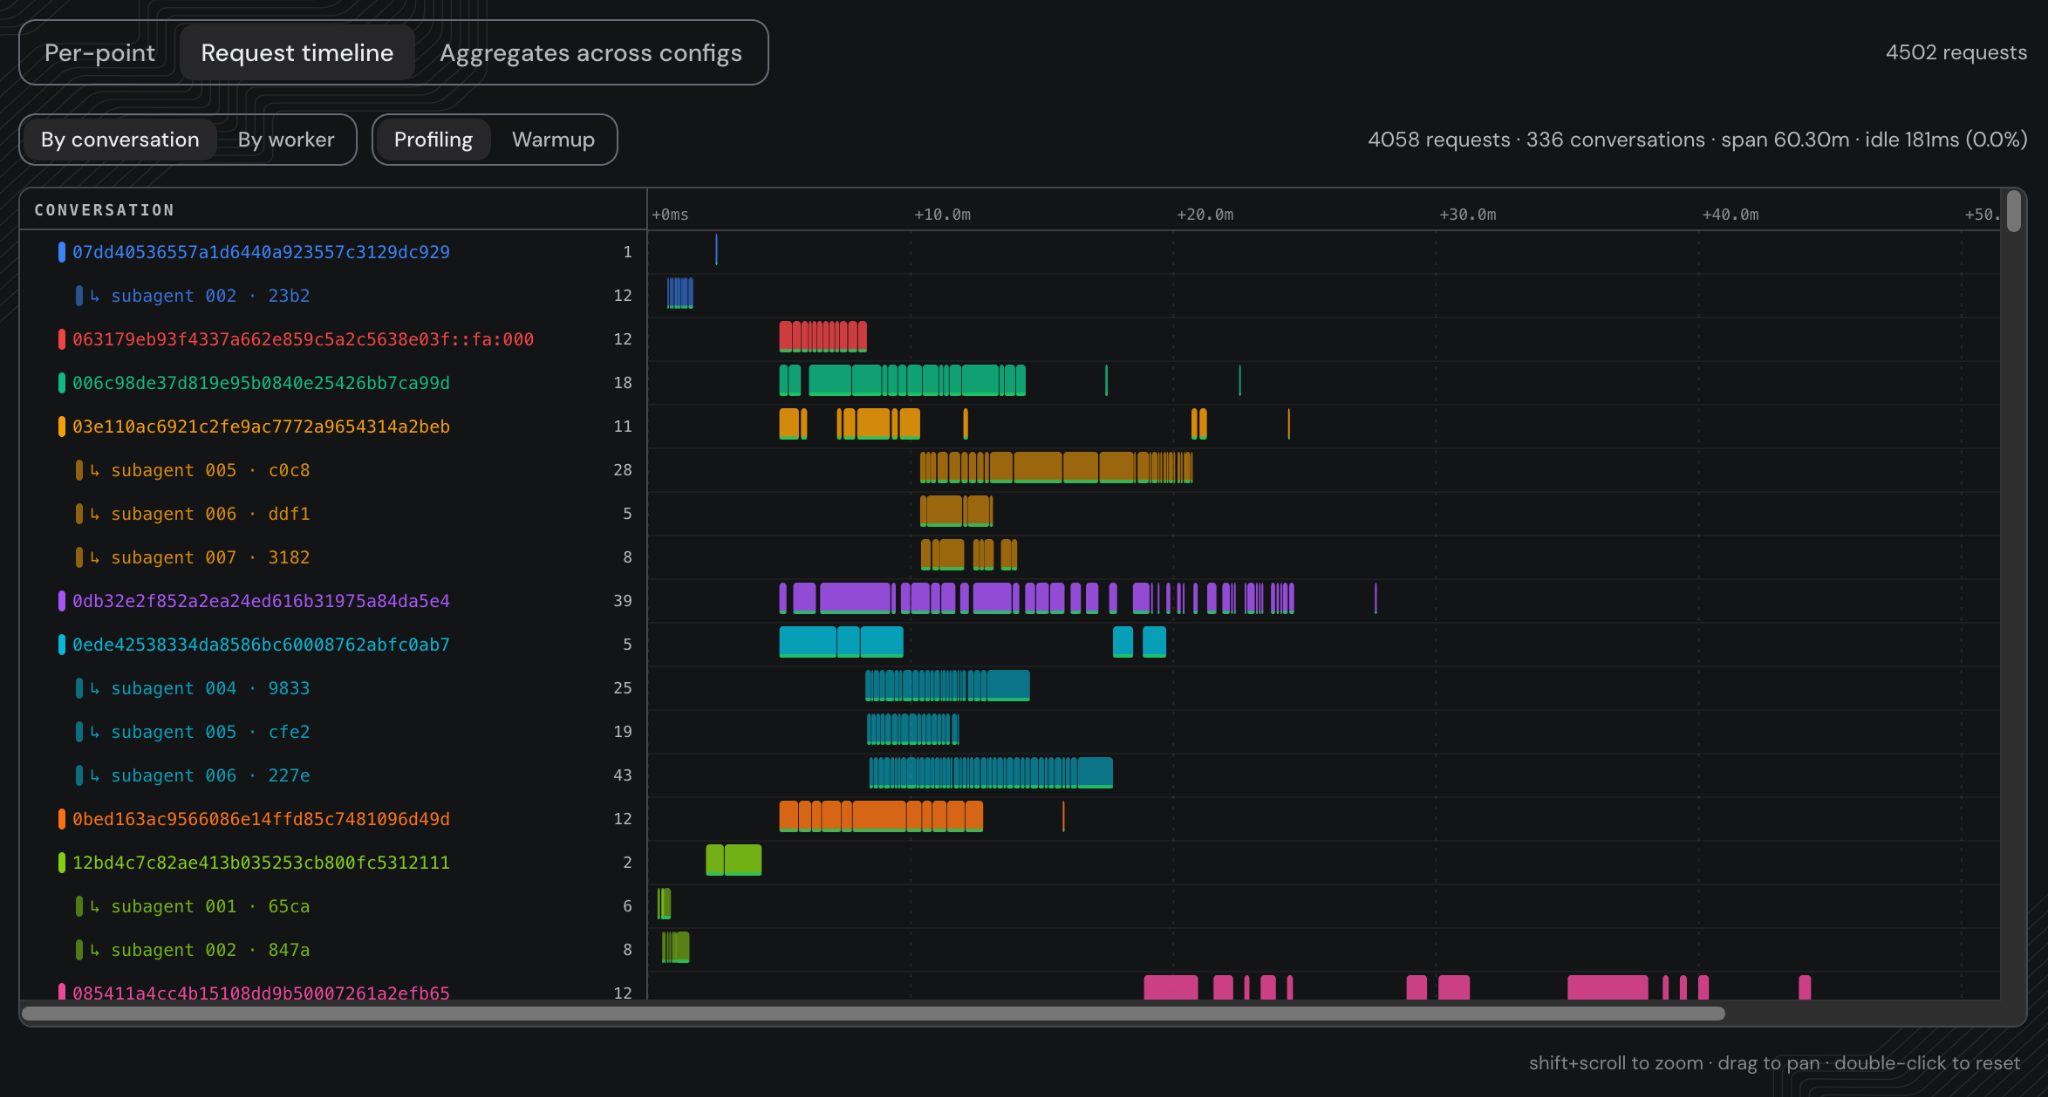
另一项新功能是请求时间线。该视图展示所选 AgentX 运行中回放的每个请求,可以按 conversation 或按 worker 组织。Conversation 视图会把 subagent 归到对应的根会话之下,便于观察会话与 subagent 何时并行发生。Warmup 与 profiling 请求同样可以分开查看。
时间线中的每个请求都可点击,会直接跳转到 InferenceX 数据集页面上对应的会话与轮次。读者因此可以从 Pareto 曲线上的一个聚合点,一路追到实际被回放的那条匿名化请求。
单会话火焰图
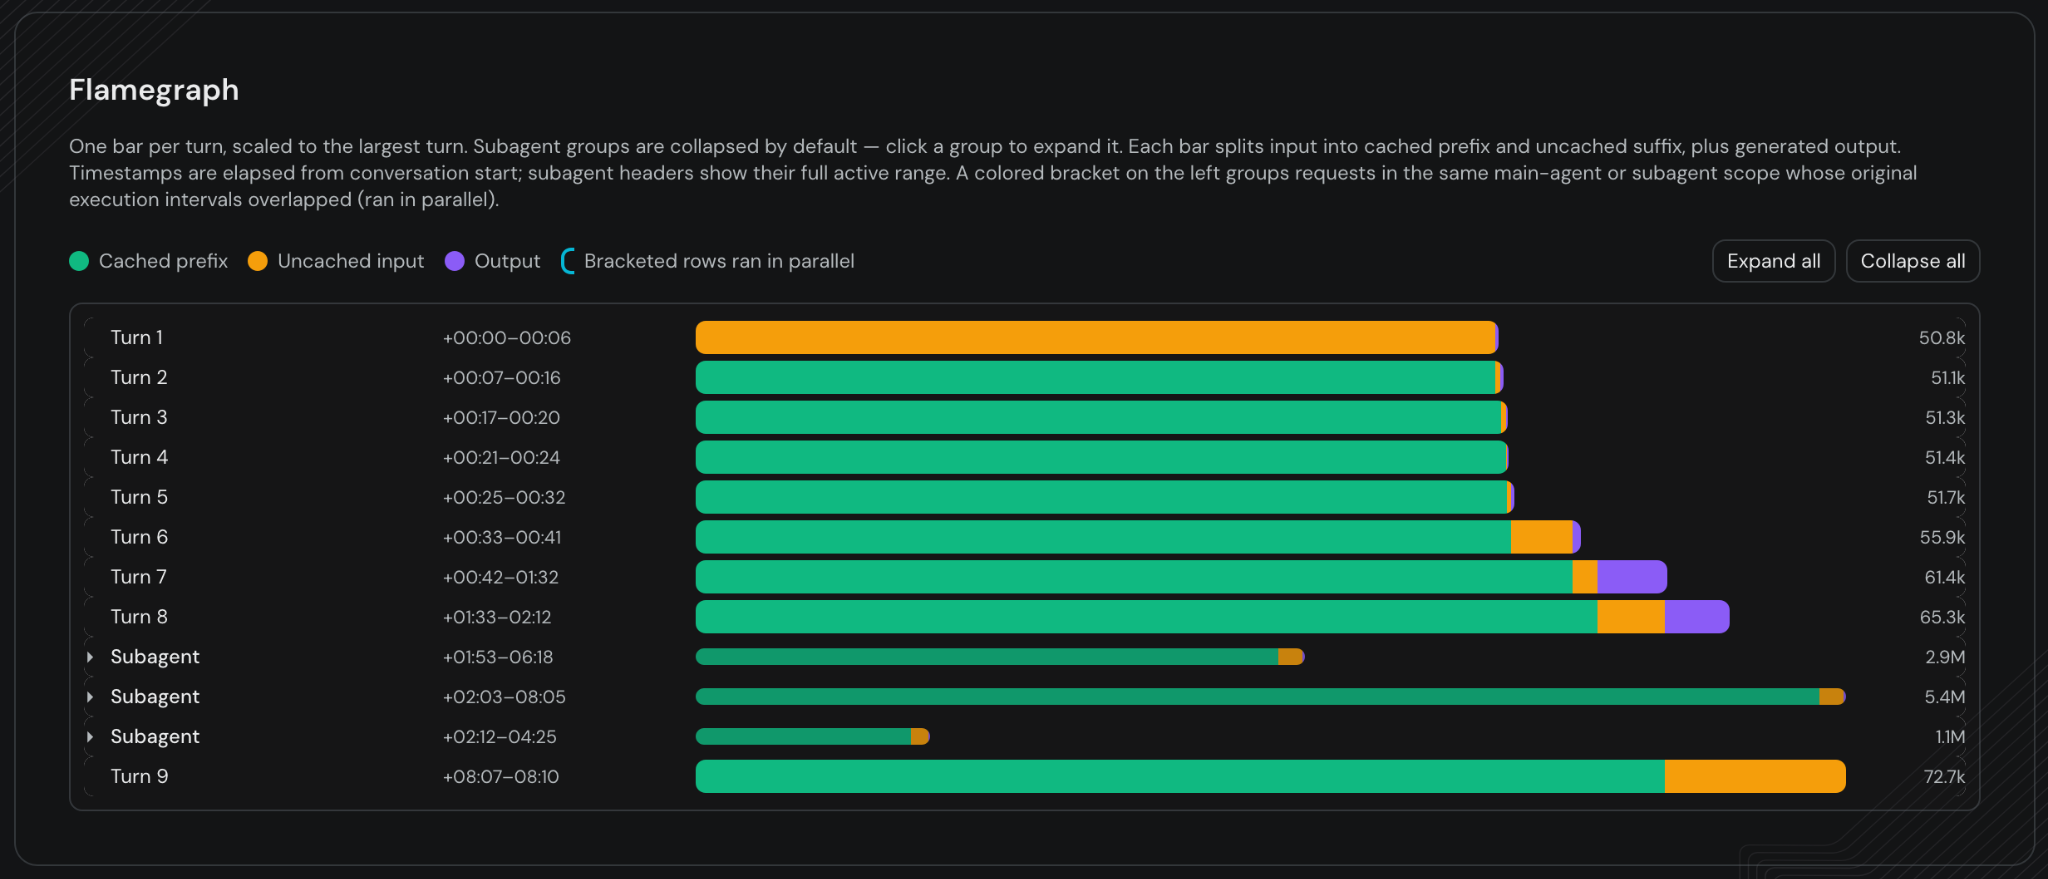
AgentX 页面还提供了用于展示单个会话结构的火焰图。每个柱条代表一个轮次,并按该会话中最长轮次进行归一化缩放。柱条内部划分为 cached prefix token、uncached input token 和生成的 output token 三段。
这直观呈现了上下文如何在一段会话中逐步增长,以及每个请求中有多大比例可以从 KV cache 复用。Subagent 分组默认折叠,点击即可展开;左侧的彩色括号会把同一主 agent 或 subagent 作用域内、原始执行区间存在重叠的请求归为一组,让并行的工作在视觉上也呈现为并行。