AgentX 的行业影响 · KV cache 层
MoRI UMBP
MoRI UMBP(Unified Memory & Bandwidth Pool)是 AMD MoRI 库中的分层分布式 KV cache 组件。它最初以 HiCache L3 后端的形式进入 SGLang,随后成为 KVCache Store Linker 的一等后端。下文的主要结果均在 AgentX 上测得:在 MI355X 上以 disaggregated 方式部署 DeepSeek-V4-Pro,并以 UMBP 作为 KV 池。
- TP8 下被复制的 MLA 与 DSA KV 的存储份数
- 8 → 1
- 开启 UMBP 后并发 256 下的 P90 TTFT
- −35%
- GPU 数量减少 25% 时的单 GPU 吞吐量
- +26–34%
为什么智能体服务需要的不只是被动的字节存储
AgentX 会话平均约 43 轮,整个生命周期内产生约 1M token 的上下文流量;每轮输入 token 的中位数为 142K,而输出只有 444 个。超过 96% 的 prompt token 是服务端已经见过的 prefix 的重复,因此在智能体并发下,一个 token 的成本取决于它的 KV 存放在哪里,而不是重算它有多快。
对于 MI355X 上的 DeepSeek-V4-Pro,这带来三个问题。一旦大量长会话及其 subagent 同时在线,KV cache 就放不进 HBM;它也无法在 TP rank 之间切分,因为 MLA latent 与 DSA indexer KV 会在每个 rank 上完整复制;而位于引擎进程内部的主机 cache,每次重启、每次滚动升级都会丢失。
大多数 L3 KV 后端——文件存储、Mooncake、NIXL、HF3FS——都是被动的字节存储:HBM 满了,引擎就把页下推;命中时再拉回来。UMBP 则围绕一个覆盖 HBM、主机 DRAM、UMBP DRAM 池和 SSD 的集群级放置目录来设计。它的 master 记录每个 key 的访问历史、节点容量和取回延迟,让 router 将来不仅能问“谁持有这个 prefix”,还能问“谁能最快提供它”;放置、淘汰与加载策略也都是可插拔接口,而不是写死的 LRU。
KVCache Store Linker:从 HBM 直达 KV 池
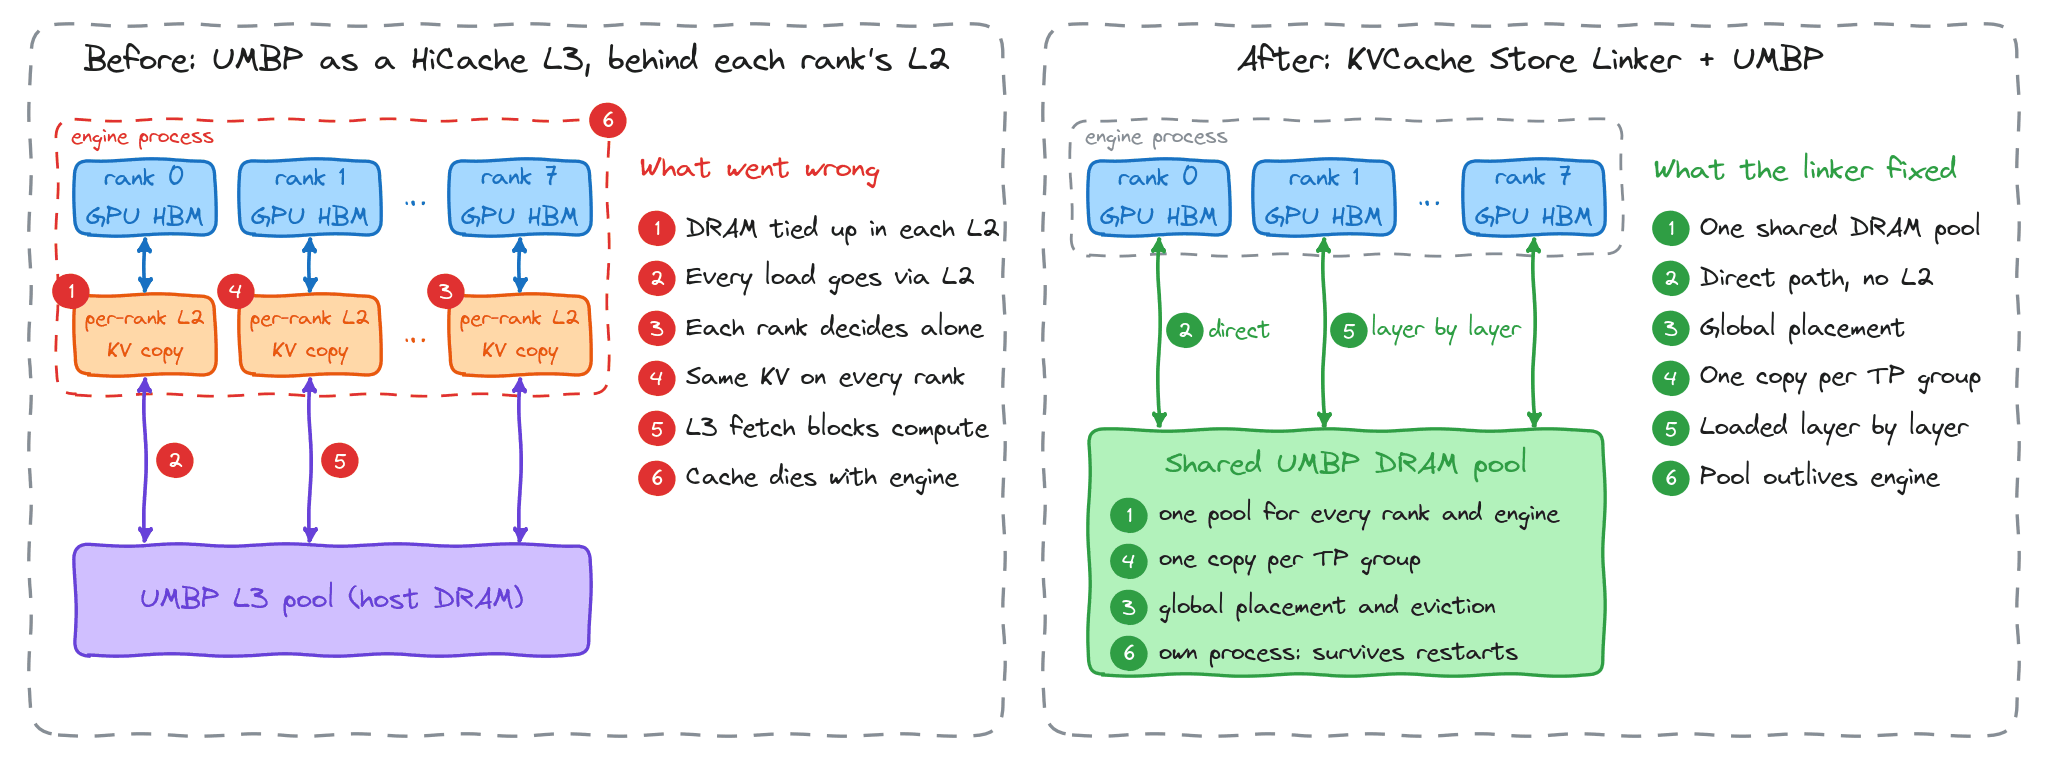
UMBP 最初以 HiCache L3 存储后端的形式进入 SGLang,位于每个 GPU rank 各自的 L2 主机 cache 之后。以这种方式在 AgentX 上运行暴露出六个问题,即下图左侧的编号项;右侧用相同的编号展示了下文介绍的新设计如何逐一解决这些问题。
AMD 提出完全跳过每张 GPU 各自的主机 cache,这与 SGLang 社区自身的规划不谋而合。随后,MoRI 团队与 SGLang 维护者共同开发了 KVCache Store Linker,UMBP 作为一等后端获得支持,与 HiCache 并列。借助这个 linker,SGLang 可以直接从 CPU 内存中的共享池读取已缓存的 KV,并逐层加载到 GPU 上,不必等整个 prefix 传完就能开始计算。这个池还可以在每台机器上作为独立进程运行,因此推理引擎重启或升级时 cache 不会丢失,多个引擎实例也能共享它。
linker 还避免了重复存储同一份数据。在 DeepSeek-V4 这类模型上,张量并行(tensor parallelism)组里的每张 GPU 都持有一份完全相同的 KV cache,因此一个 8 卡组过去会向 CPU 内存写入八份。现在只写一份:同样的内存可以容纳八倍的 cache,CPU 内存与 GPU 之间搬运的数据也减少到八分之一。一个仍在评审中的改动更进一步:不再让每张 GPU 都把完整副本读回来,而是各自读取一部分,再由 GPU 之间互相交换。
它在 AgentX 上带来的变化
即使 DRAM 层几乎没被用到,收益也会出现。并发 128–256 时 HBM 已经承担了约 95.6% 的 prompt token,DRAM 不到 1%。开启 UMBP 后,并发 256 下单 GPU 吞吐量仍提升 8.3%、P90 TTFT 降低 35%,并发 128 下分别为 2.7% 与 34%。关闭 UMBP 时,主机 KV 池占用率达到 72% 和 100%,却最多只承担了 0.1% 的 prompt token——因此收益来自直连路径,而不是 offload 本身。
足够大的 cache 进而改变了部署拓扑。一旦去重后的 DRAM 承载了 KV,prefill 就不再仅为容量而需要 TP8:在并发 16–48 时,配方改用 TP4 prefill 加 TP8 decode,共 12 张 GPU,而不是 16 张。在并发 16、32、48 下,UMBP 分别承担了 34%、71% 和 75% 的 prompt token,重算比例不到 3%;单 GPU 吞吐量在 GPU 数量减少 25% 的情况下提升 26–34%。
SGLang 针对 MI355X 上 DeepSeek-V4-Pro 的其他优化在 UMBP 之上进一步叠加,把并发 256 下的单 GPU 吞吐量从 55.8k 提升到 62.0k,并把曲线延伸到并发 384 和 512。完整配置见下方 10 月 4 日的 sweep 链接。
其他项目
推理引擎
vLLM
混合注意力 prefix 保留、面向 hybrid 模型的 CPU KV offload,以及收窄后的 store 与 load 路径。
查看优化详情 →推理引擎
SGLang
Sliding-window 分配、HiCache 混合 offload、以 runtime scalar 传入上下文长度,以及 cache 感知的 DP 路由。
查看优化详情 →推理引擎
TensorRT-LLM
边界感知的增量 tokenization、disaggregated KV 的 descriptor 合并,以及调度器生命周期修复。
查看优化详情 →推理引擎
AMD ATOM
稀疏 checkpoint 保留、recurrent 状态 checkpoint、CPU offload 归属管理,以及长 prefill 并行。
查看优化详情 →内核
ROCm AITER
Context-parallel 进程组、面向大 cache 池的 64 位寻址,以及常驻式 MLA decode 内核。
查看优化详情 →Router 与编排
NVIDIA Dynamo
批量化 KV 匹配、以 request lease 表示归属、更廉价的 router 状态,以及更精简的请求平面。
查看优化详情 →KV cache 层
LMCache
分块的外部 cache 加载、hybrid group 存储优化、AMD Instinct 支持,以及 DCP 感知的 offload。
查看优化详情 →传输引擎
Mooncake
通过 HIP dmabuf 在 ROCm 上实现 GPU-direct RDMA,并提供已发布的 ROCm wheel 与发版流程。
查看优化详情 →