
GB200 NVL72 FP4:启用 MTP 与关闭投机解码的对比
在 GB200 NVL72 FP4(NVIDIA Blackwell)上运行 GLM 5/5.1 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
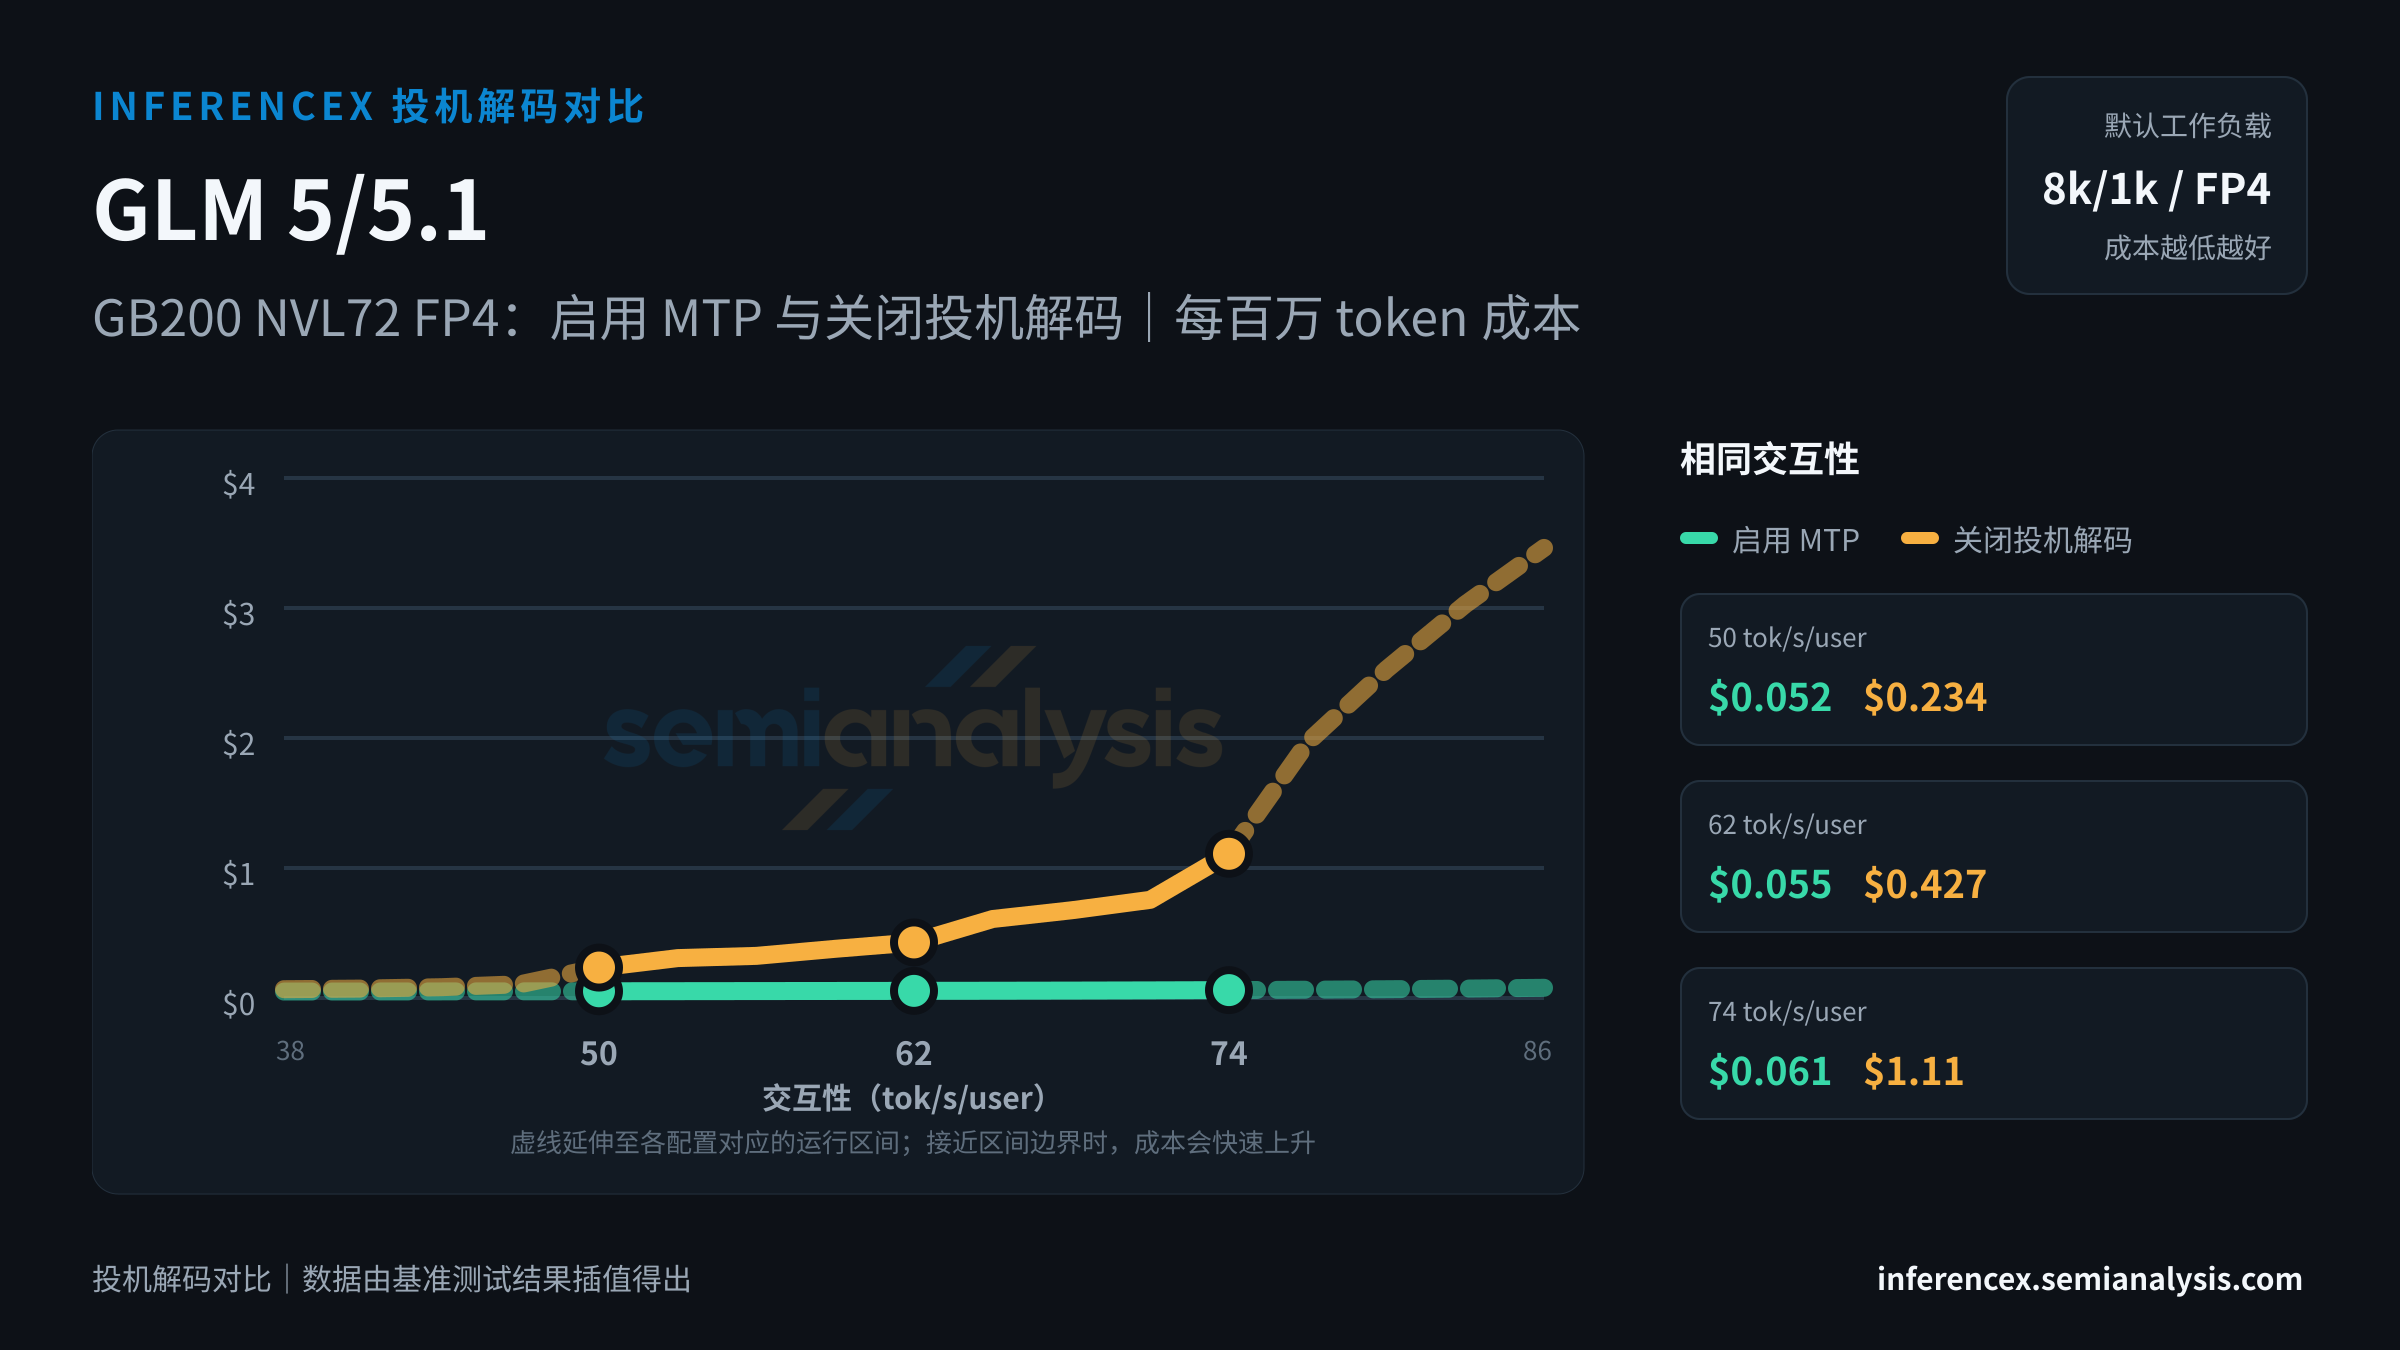
GLM 5/5.1 在 GB200 NVL72 FP4 上的目标交互性设为 50 tok/s/user:启用 MTP 时,吞吐量为 9984 tok/s/chip,每百万 token 成本为 $0.05;关闭投机解码时,吞吐量为 2207 tok/s/chip,每百万 token 成本为 $0.23。MTP 的成本效率高出 352%;MTP 的单芯片吞吐量高出 352%。draft token 接受率决定了在给定并发数下,投机解码是提升性能还是拖累性能。
在 GB200 NVL72 FP4 上运行 GLM 5/5.1,目标交互性设为 62 tok/s/user:启用 MTP 时,吞吐量为 9414 tok/s/chip,每百万 token 成本为 $0.05;关闭投机解码时,吞吐量为 1209 tok/s/chip,每百万 token 成本为 $0.43。MTP 的成本效率高出 679%;MTP 的单芯片吞吐量高出 679%。投机解码会增加 draft token 的计算量,以减少解码步数;收益取决于序列长度和批大小。
74 tok/s/user 接近 38–86 tok/s/user 交互性区间的上限。在这一运行点,启用 MTP 时,吞吐量为 8514 tok/s/chip,每百万 token 成本为 $0.06;关闭投机解码时,吞吐量为 466 tok/s/chip,每百万 token 成本为 $1.11。MTP 的成本效率高出 1728%;MTP 的单芯片吞吐量高出 1728%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。 (以上数据基于此 URL 固定的 8k/1k · fp4 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP:9983.9关闭投机解码:2206.8 | 启用 MTP:9414.2关闭投机解码:1208.6 | 启用 MTP:8513.9关闭投机解码:465.8 |
| 成本($/M tok) | 启用 MTP:$0.052关闭投机解码:$0.234 | 启用 MTP:$0.055关闭投机解码:$0.427 | 启用 MTP:$0.061关闭投机解码:$1.109 |
| tok/s/MW | 启用 MTP:5338994关闭投机解码:1180133 | 启用 MTP:5034330关闭投机解码:646310 | 启用 MTP:4552911关闭投机解码:249075 |
| 并发数 | 启用 MTP:~1340关闭投机解码:~227 | 启用 MTP:~818关闭投机解码:~105 | 启用 MTP:~618关闭投机解码:~74 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。