GB300 NVL72:FP4 与 FP8 精度对比
在 GB300 NVL72(NVIDIA Blackwell)上,比较 FP4 与 FP8 两种量化精度对 Qwen 3.5 397B-A17B 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
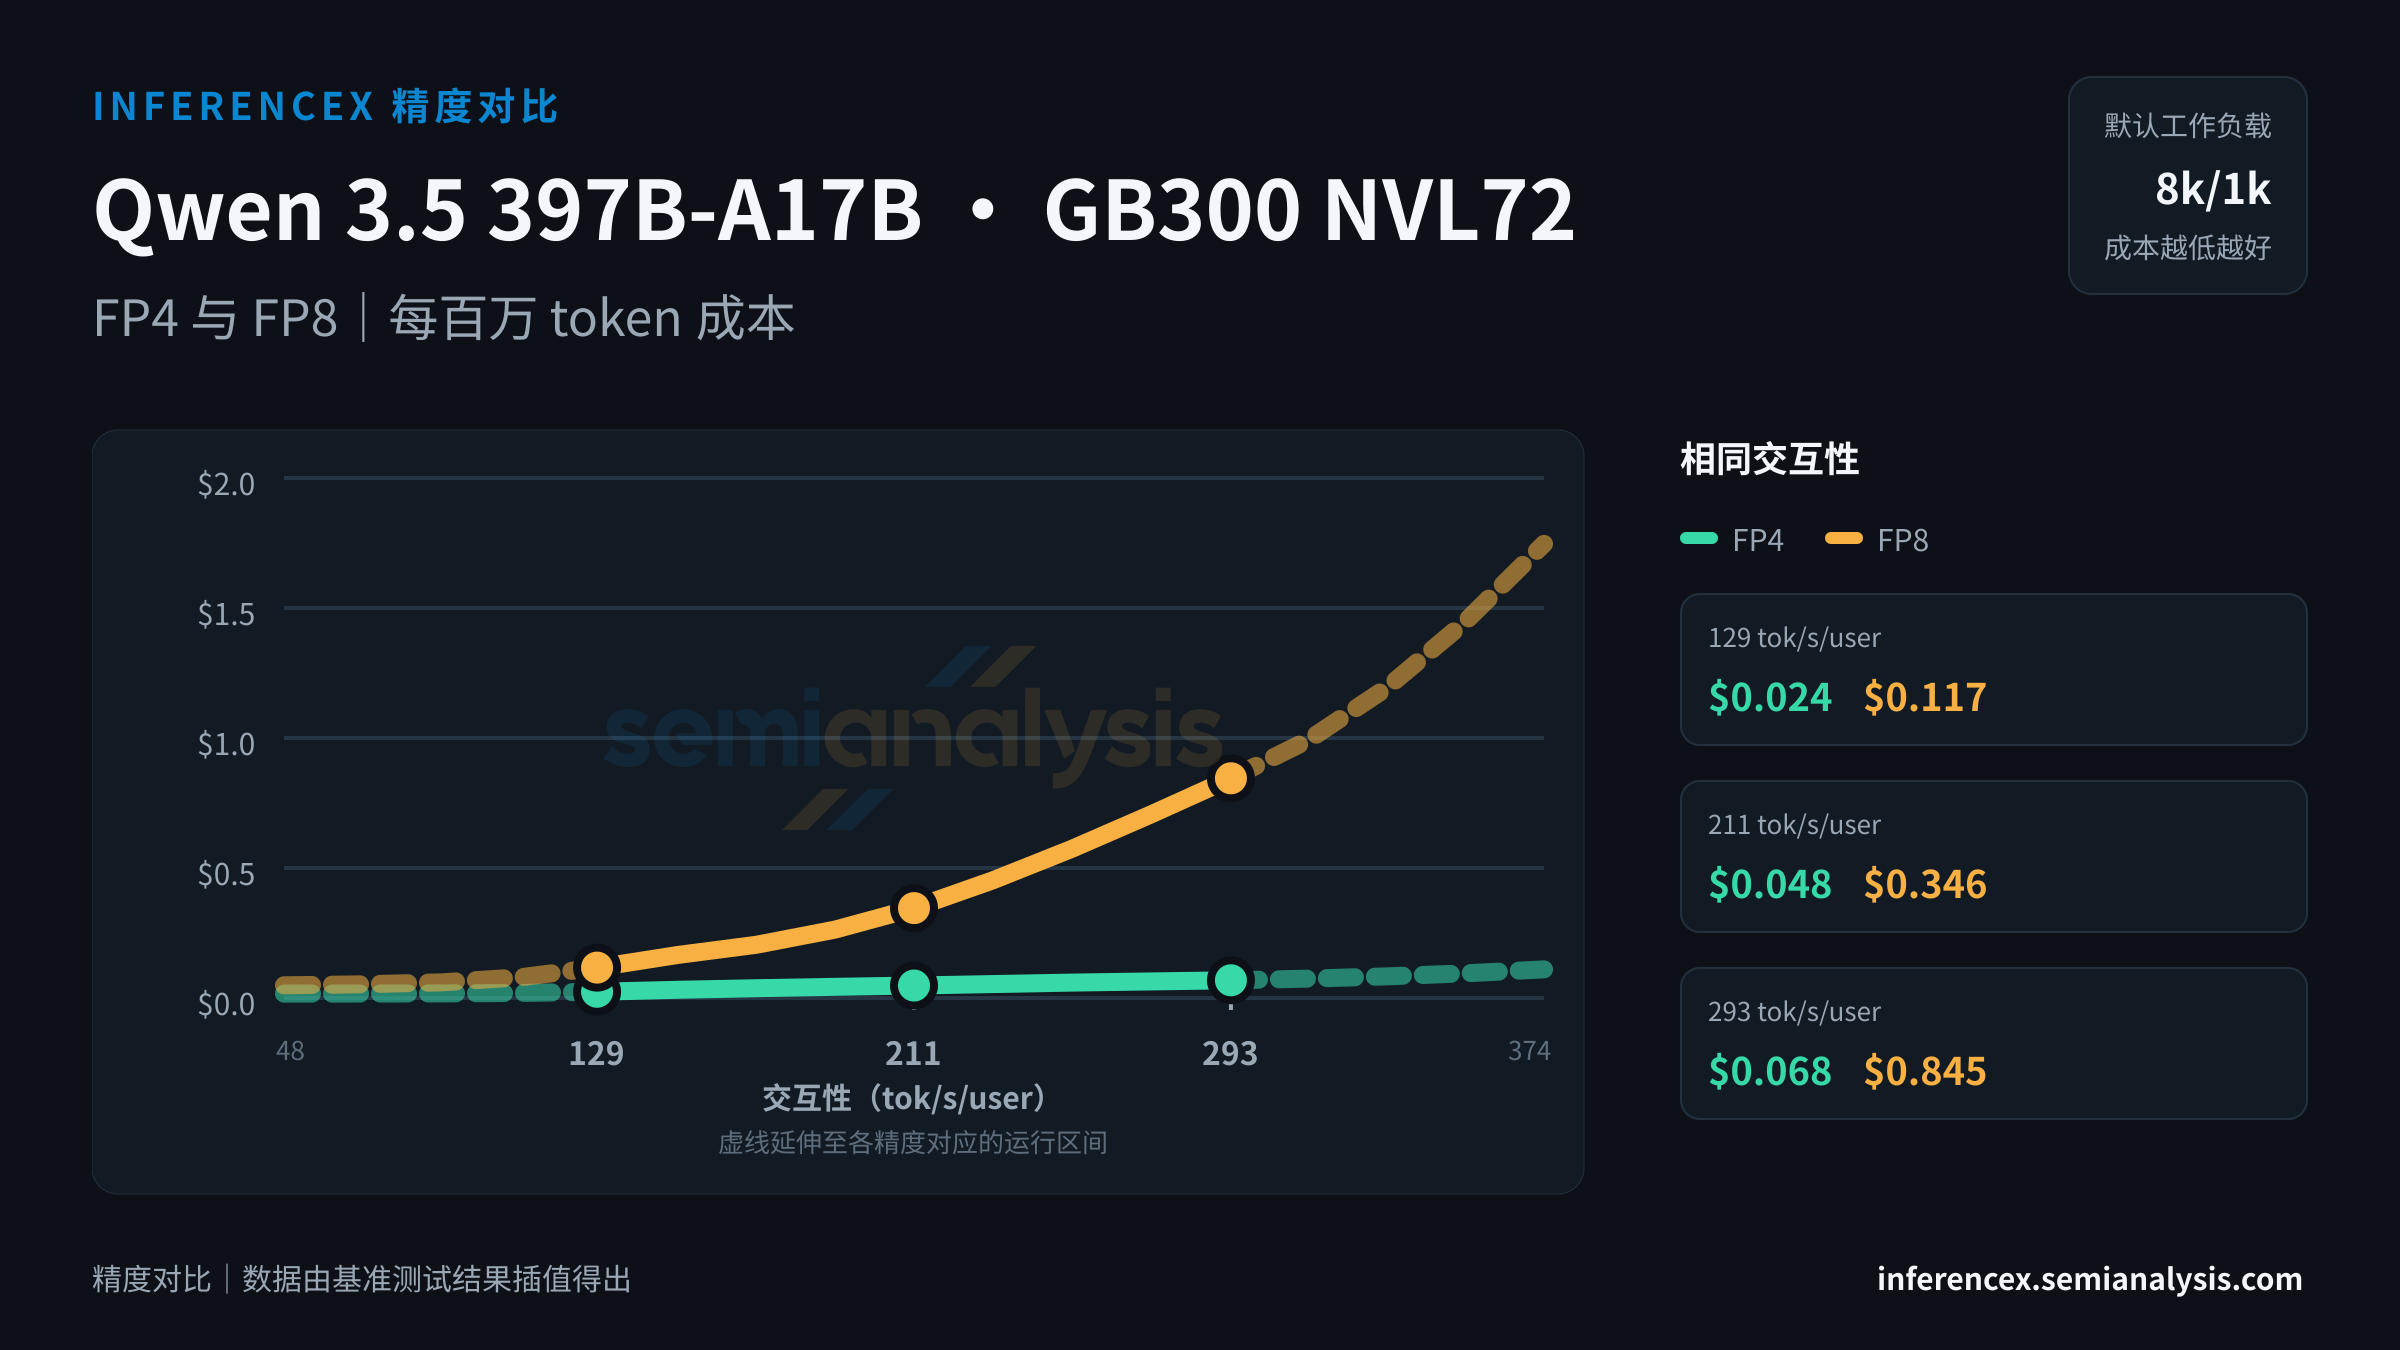
129 tok/s/user 接近 48–374 tok/s/user 交互性区间的下限。在这一运行点,FP4 在 GB300 NVL72 上运行 Qwen 3.5 397B-A17B 的吞吐量为 26805 tok/s/chip,每百万 token 成本为 $0.02;FP8 的吞吐量为 5487 tok/s/chip,每百万 token 成本为 $0.12。FP4 的成本效率高出 389%;FP4 的单芯片吞吐量高出 389%。调整量化精度会同时影响推理速度和模型质量;模型准确率基准测试请参阅评估页。
在 GB300 NVL72 上运行 Qwen 3.5 397B-A17B,目标交互性为 211 tok/s/user 时,FP4 的吞吐量为 13394 tok/s/chip,每百万 token 成本为 $0.05;FP8 的吞吐量为 1856 tok/s/chip,每百万 token 成本为 $0.35。FP4 的成本效率高出 622%;FP4 的单芯片吞吐量高出 622%。较低的量化精度以模型准确率为代价换取更高吞吐量;如需了解对模型质量的影响,请查看评估页。
当 Qwen 3.5 397B-A17B 在 GB300 NVL72 上的目标交互性为 293 tok/s/user 时,FP4 的吞吐量为 9415 tok/s/chip,每百万 token 成本为 $0.07;FP8 的吞吐量为 759 tok/s/chip,每百万 token 成本为 $0.85。FP4 的成本效率高出 1140%;FP4 的单芯片吞吐量高出 1140%。不同量化精度下的模型准确率差异可在评估页查看。 (以上数据基于此 URL 对应的默认 8k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP4:26805.4FP8:5487.2 | FP4:13394.2FP8:1855.9 | FP4:9414.6FP8:759.3 |
| 成本($/M tok) | FP4:$0.024FP8:$0.117 | FP4:$0.048FP8:$0.346 | FP4:$0.068FP8:$0.845 |
| tok/s/MW | FP4:12644063FP8:2588300 | FP4:6318039FP8:875409 | FP4:4440838FP8:358168 |
| 并发数 | FP4:~953FP8:~140 | FP4:~187FP8:~17 | FP4:~131FP8:~3 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。