
B300:FP4 与 BF16 精度对比
在 B300(NVIDIA Blackwell)上,比较 FP4 与 BF16 两种量化精度对 Qwen 3.5 397B-A17B 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
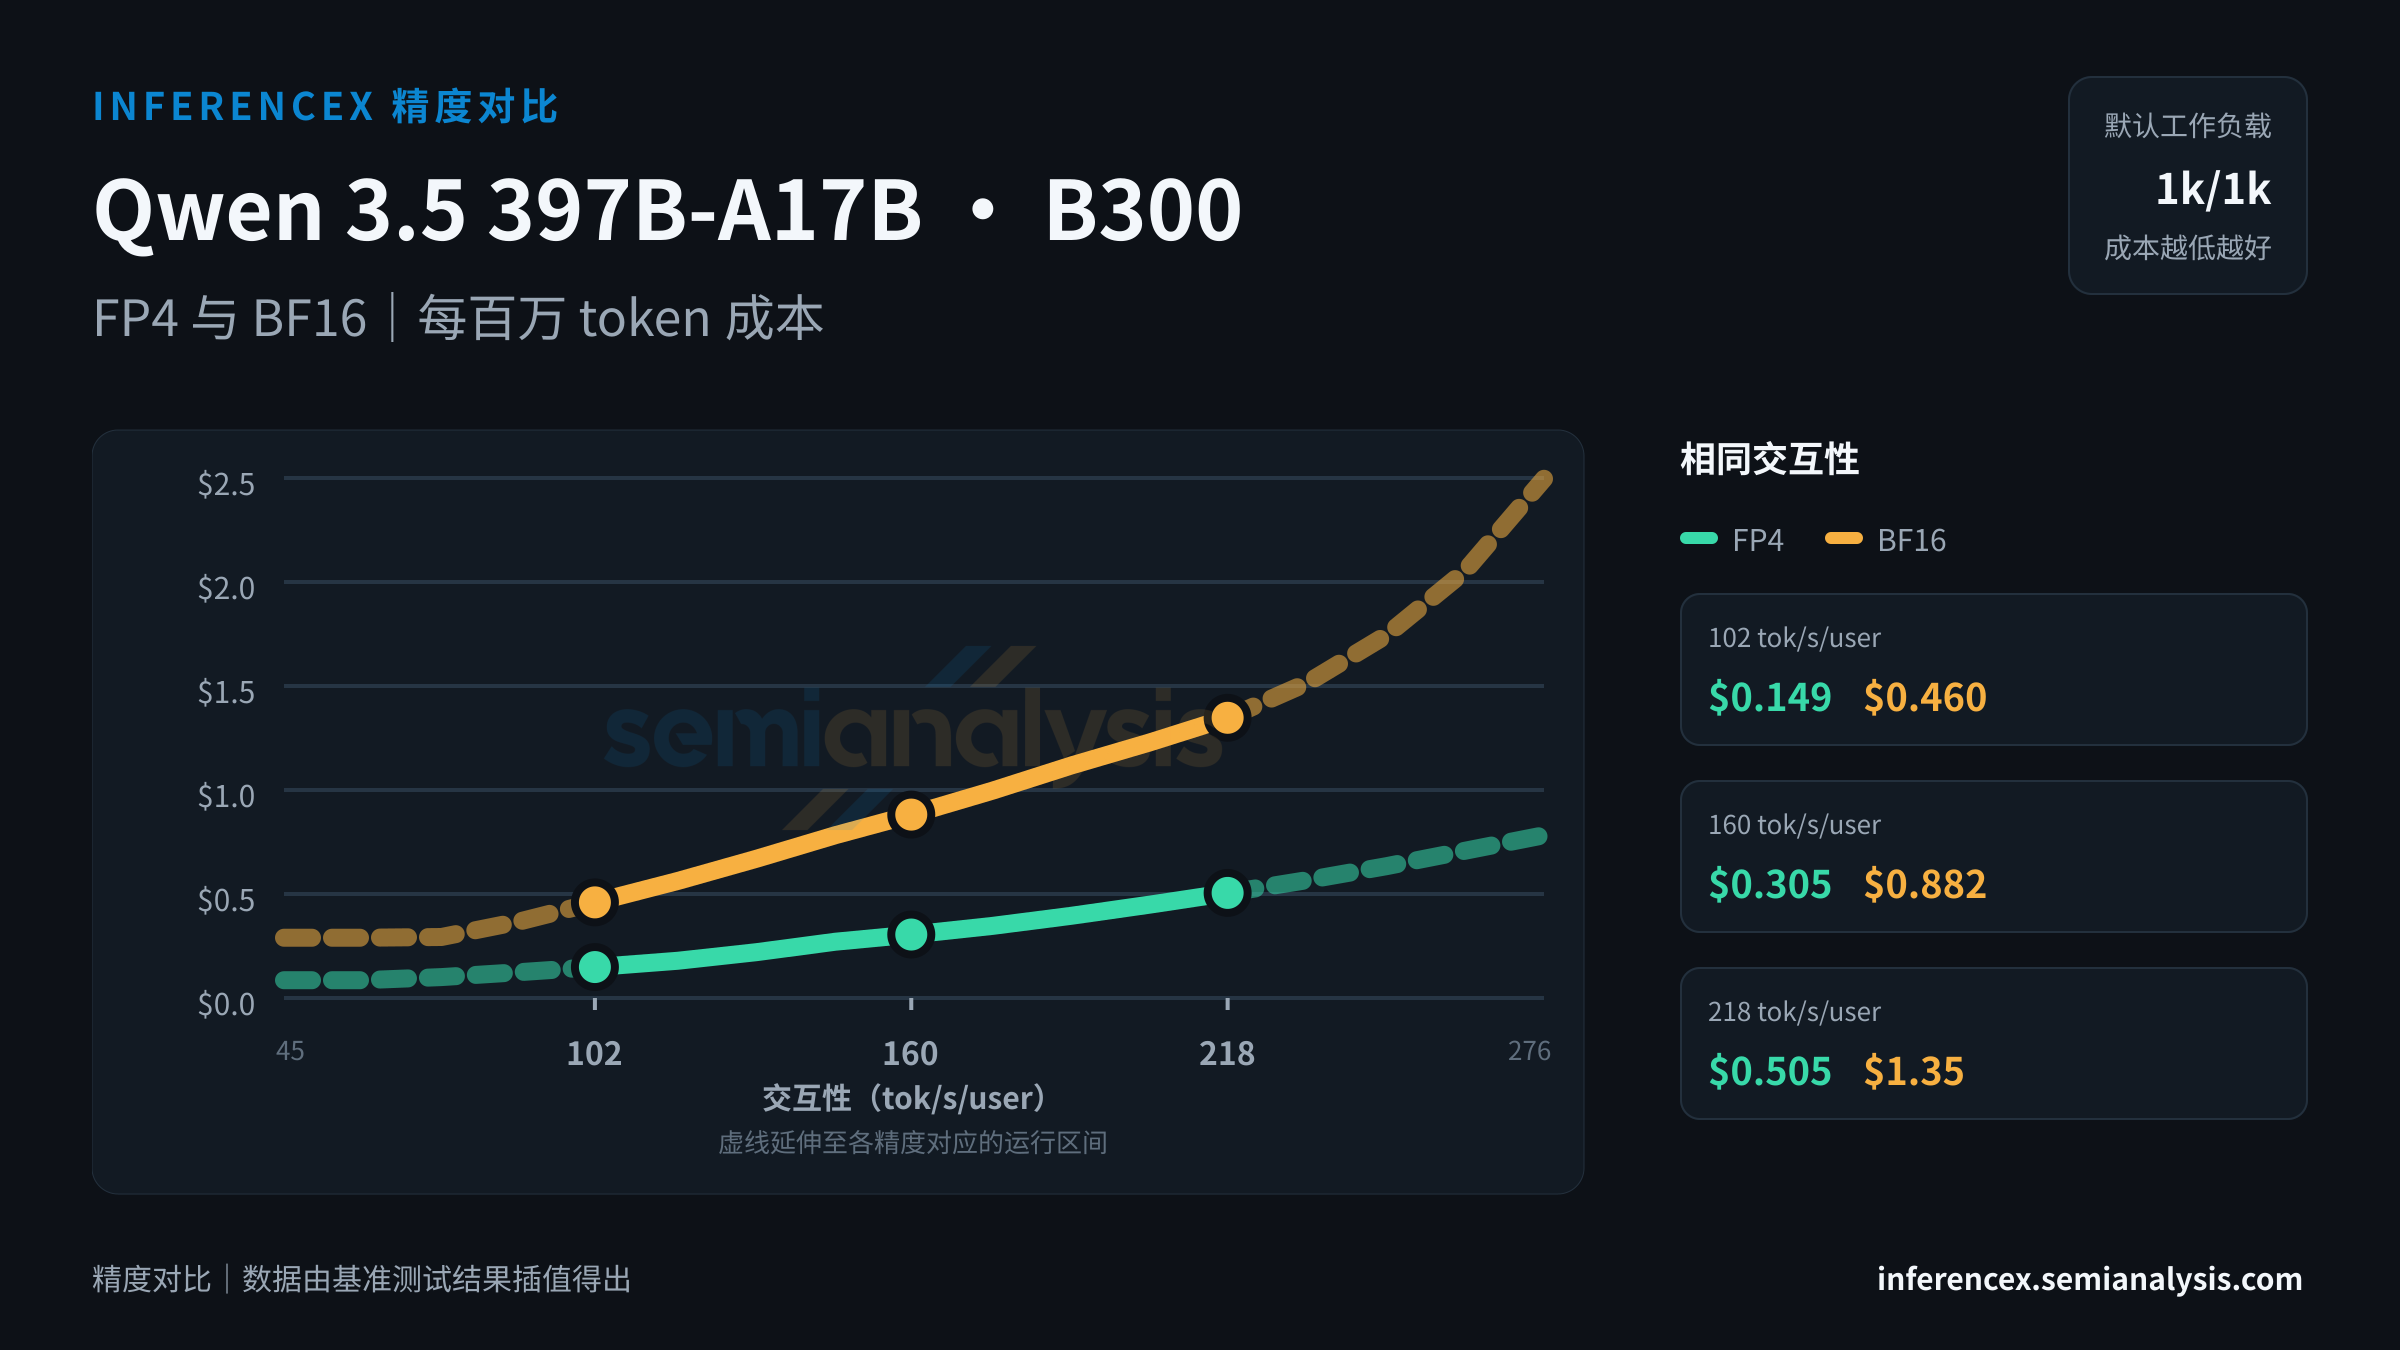
在 B300 上运行 Qwen 3.5 397B-A17B,目标交互性为 102 tok/s/user 时,FP4 的吞吐量为 4220 tok/s/chip,每百万 token 成本为 $0.15;BF16 的吞吐量为 1366 tok/s/chip,每百万 token 成本为 $0.46。FP4 的成本效率高出 209%;FP4 的单芯片吞吐量高出 209%。较低的量化精度以模型准确率为代价换取更高吞吐量;如需了解对模型质量的影响,请查看评估页。
当 Qwen 3.5 397B-A17B 在 B300 上的目标交互性为 160 tok/s/user 时,FP4 的吞吐量为 2057 tok/s/chip,每百万 token 成本为 $0.31;BF16 的吞吐量为 712 tok/s/chip,每百万 token 成本为 $0.88。FP4 的成本效率高出 189%;FP4 的单芯片吞吐量高出 189%。不同量化精度下的模型准确率差异可在评估页查看。
在 B300 上运行 Qwen 3.5 397B-A17B,目标交互性为 218 tok/s/user 时,FP4 与 BF16 的吞吐量分别为 1242 和 466 tok/s/chip,每百万 token 成本分别为 $0.51 和 $1.35。FP4 的成本效率高出 167%;FP4 的单芯片吞吐量高出 167%。较低量化精度下的成本与吞吐量权衡只是整体考量的一部分;模型准确率数据请参阅评估页。 (以上数据基于此 URL 对应的默认 1k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP4:4219.8BF16:1365.6 | FP4:2057.5BF16:712.0 | FP4:1242.4BF16:466.0 |
| 成本($/M tok) | FP4:$0.149BF16:$0.460 | FP4:$0.305BF16:$0.882 | FP4:$0.505BF16:$1.347 |
| tok/s/MW | FP4:2220925BF16:718720 | FP4:1082881BF16:374720 | FP4:653919BF16:245270 |
| 并发数 | FP4:~64BF16:~63 | FP4:~16BF16:~20 | FP4:~12BF16:~5 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。