
B300:FP4 与 FP8 精度对比
在 B300(NVIDIA Blackwell)上,比较 FP4 与 FP8 两种量化精度对 GLM 5/5.1 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
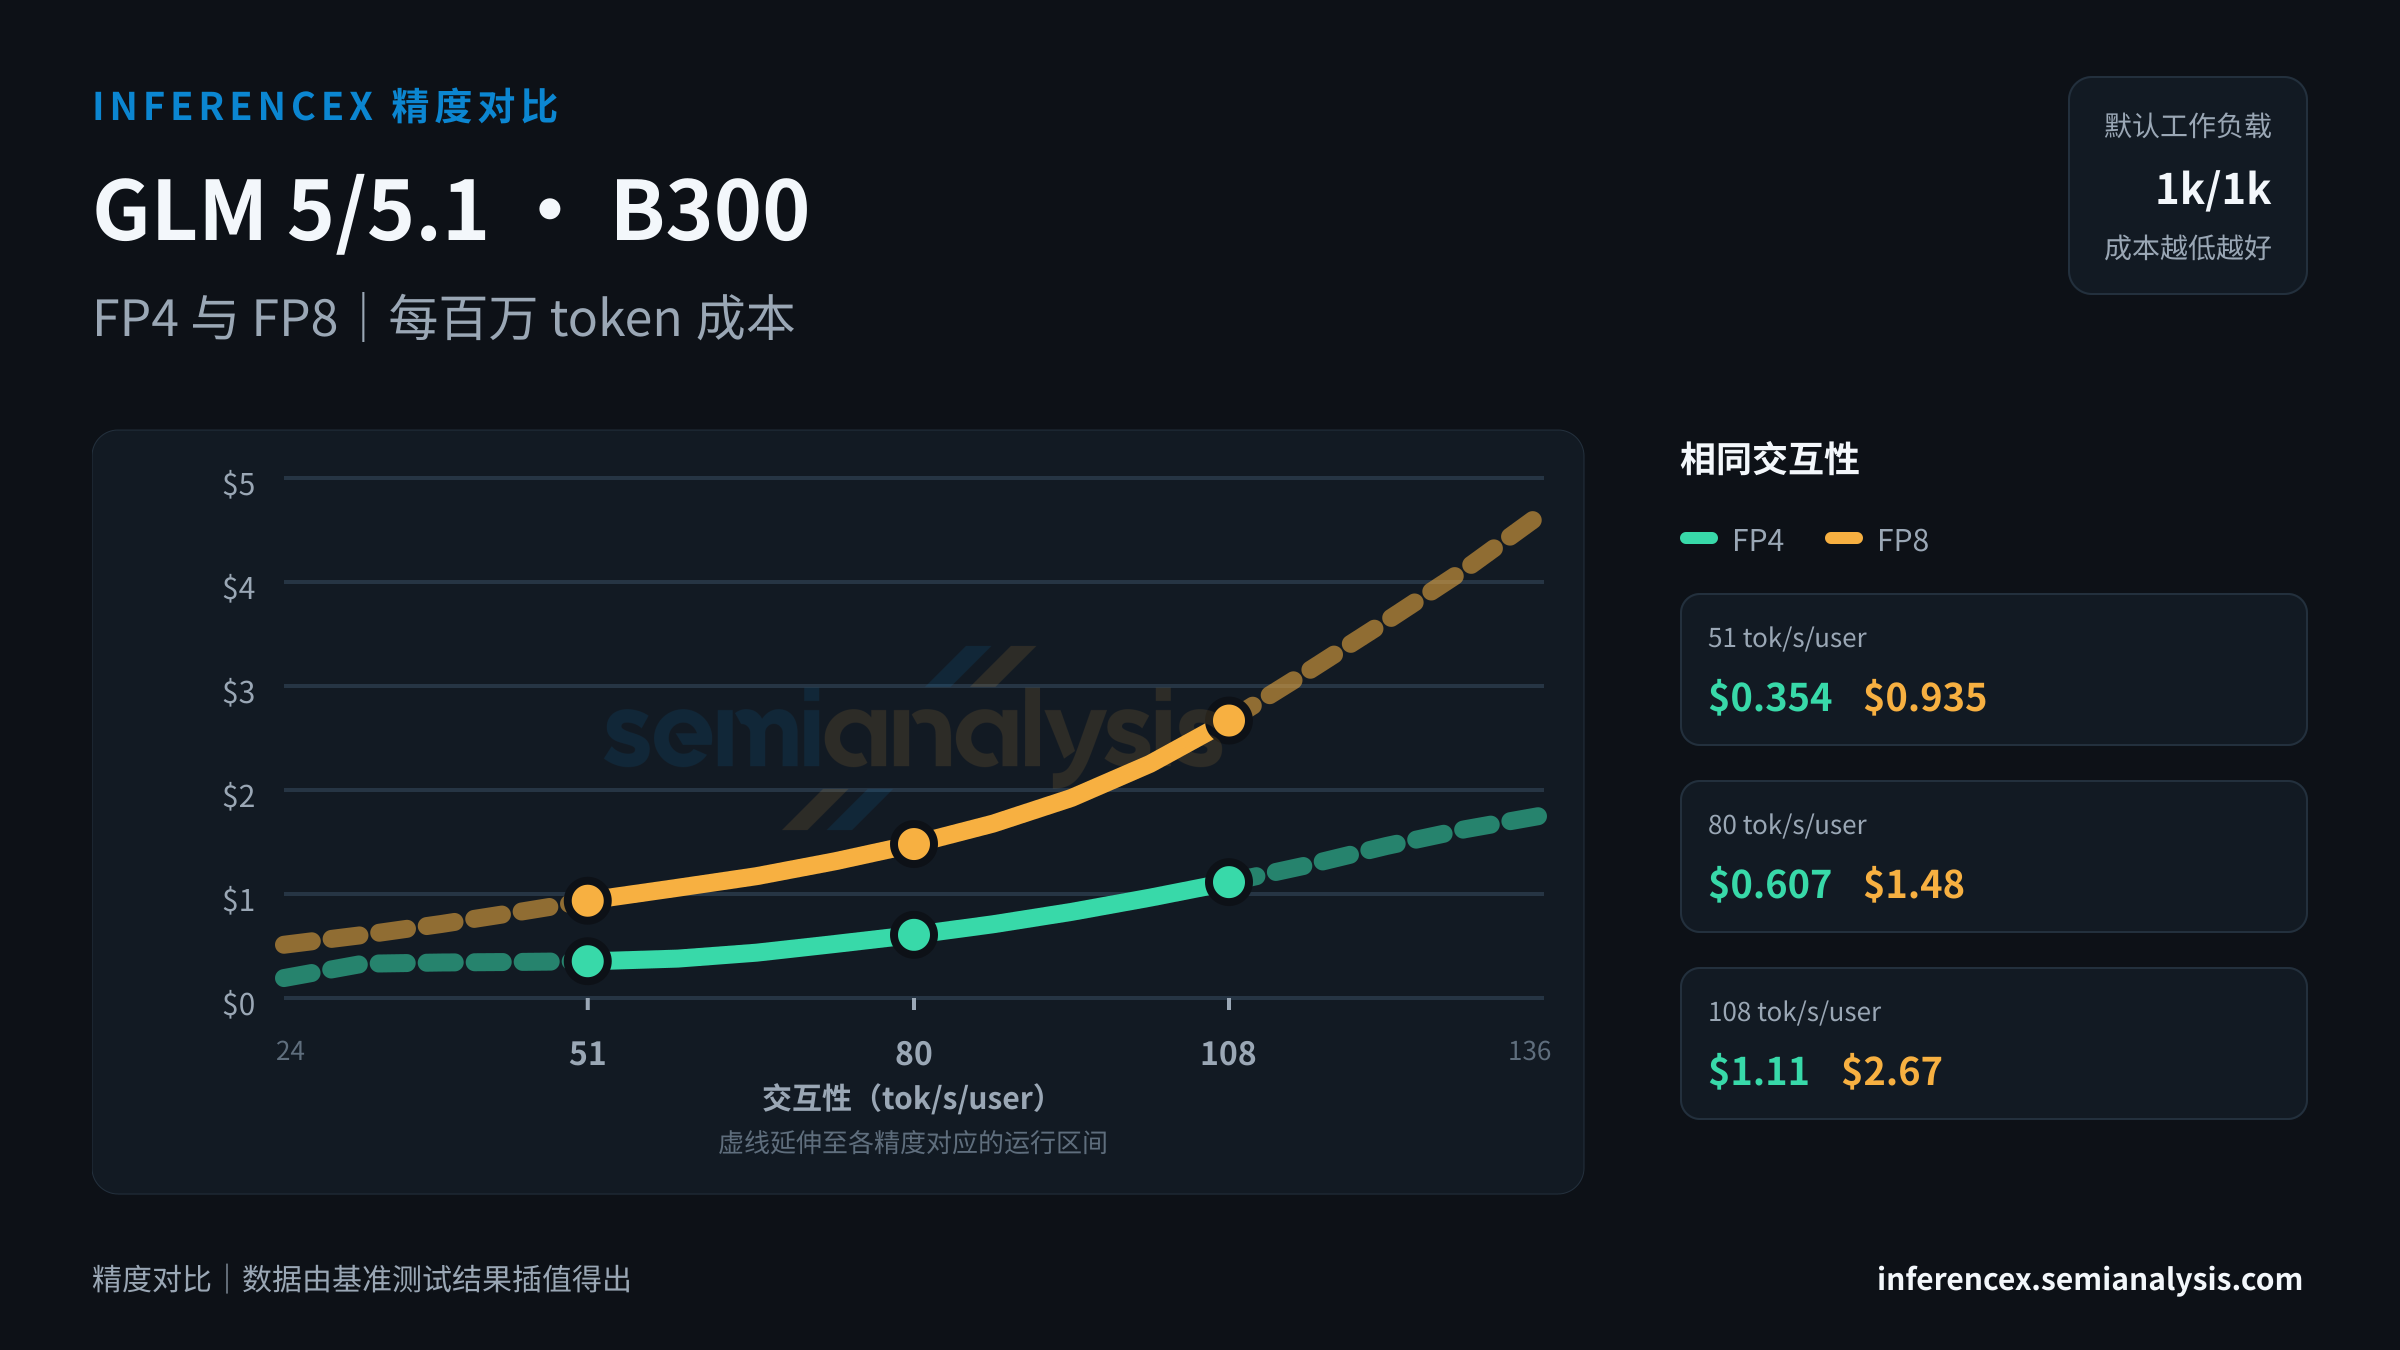
当 GLM 5/5.1 在 B300 上的目标交互性为 51 tok/s/user 时,FP4 的吞吐量为 1775 tok/s/chip,每百万 token 成本为 $0.35;FP8 的吞吐量为 671 tok/s/chip,每百万 token 成本为 $0.94。FP4 的成本效率高出 164%;FP4 的单芯片吞吐量高出 164%。不同量化精度下的模型准确率差异可在评估页查看。
在 B300 上运行 GLM 5/5.1,目标交互性为 80 tok/s/user 时,FP4 与 FP8 的吞吐量分别为 1034 和 424 tok/s/chip,每百万 token 成本分别为 $0.61 和 $1.48。FP4 的成本效率高出 144%;FP4 的单芯片吞吐量高出 144%。较低量化精度下的成本与吞吐量权衡只是整体考量的一部分;模型准确率数据请参阅评估页。
108 tok/s/user 接近 24–136 tok/s/user 交互性区间的上限。在这一运行点,FP4 在 B300 上运行 GLM 5/5.1 的吞吐量为 563 tok/s/chip,每百万 token 成本为 $1.11;FP8 的吞吐量为 235 tok/s/chip,每百万 token 成本为 $2.67。FP4 的成本效率高出 139%;FP4 的单芯片吞吐量高出 139%。调整量化精度会同时影响推理速度和模型质量;模型准确率基准测试请参阅评估页。 (以上数据基于此 URL 对应的默认 1k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP4:1775.3FP8:671.2 | FP4:1033.7FP8:424.1 | FP4:563.5FP8:235.3 |
| 成本($/M tok) | FP4:$0.354FP8:$0.935 | FP4:$0.607FP8:$1.480 | FP4:$1.114FP8:$2.668 |
| tok/s/MW | FP4:934379FP8:353288 | FP4:544052FP8:223210 | FP4:296573FP8:123852 |
| 并发数 | FP4:~73FP8:~54 | FP4:~26FP8:~22 | FP4:~11FP8:~9 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。