MI355X:FP4 与 FP8 精度对比
在 MI355X(AMD CDNA 4)上,比较 FP4 与 FP8 两种量化精度对 DeepSeekv4 Pro 0813 1.6T 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
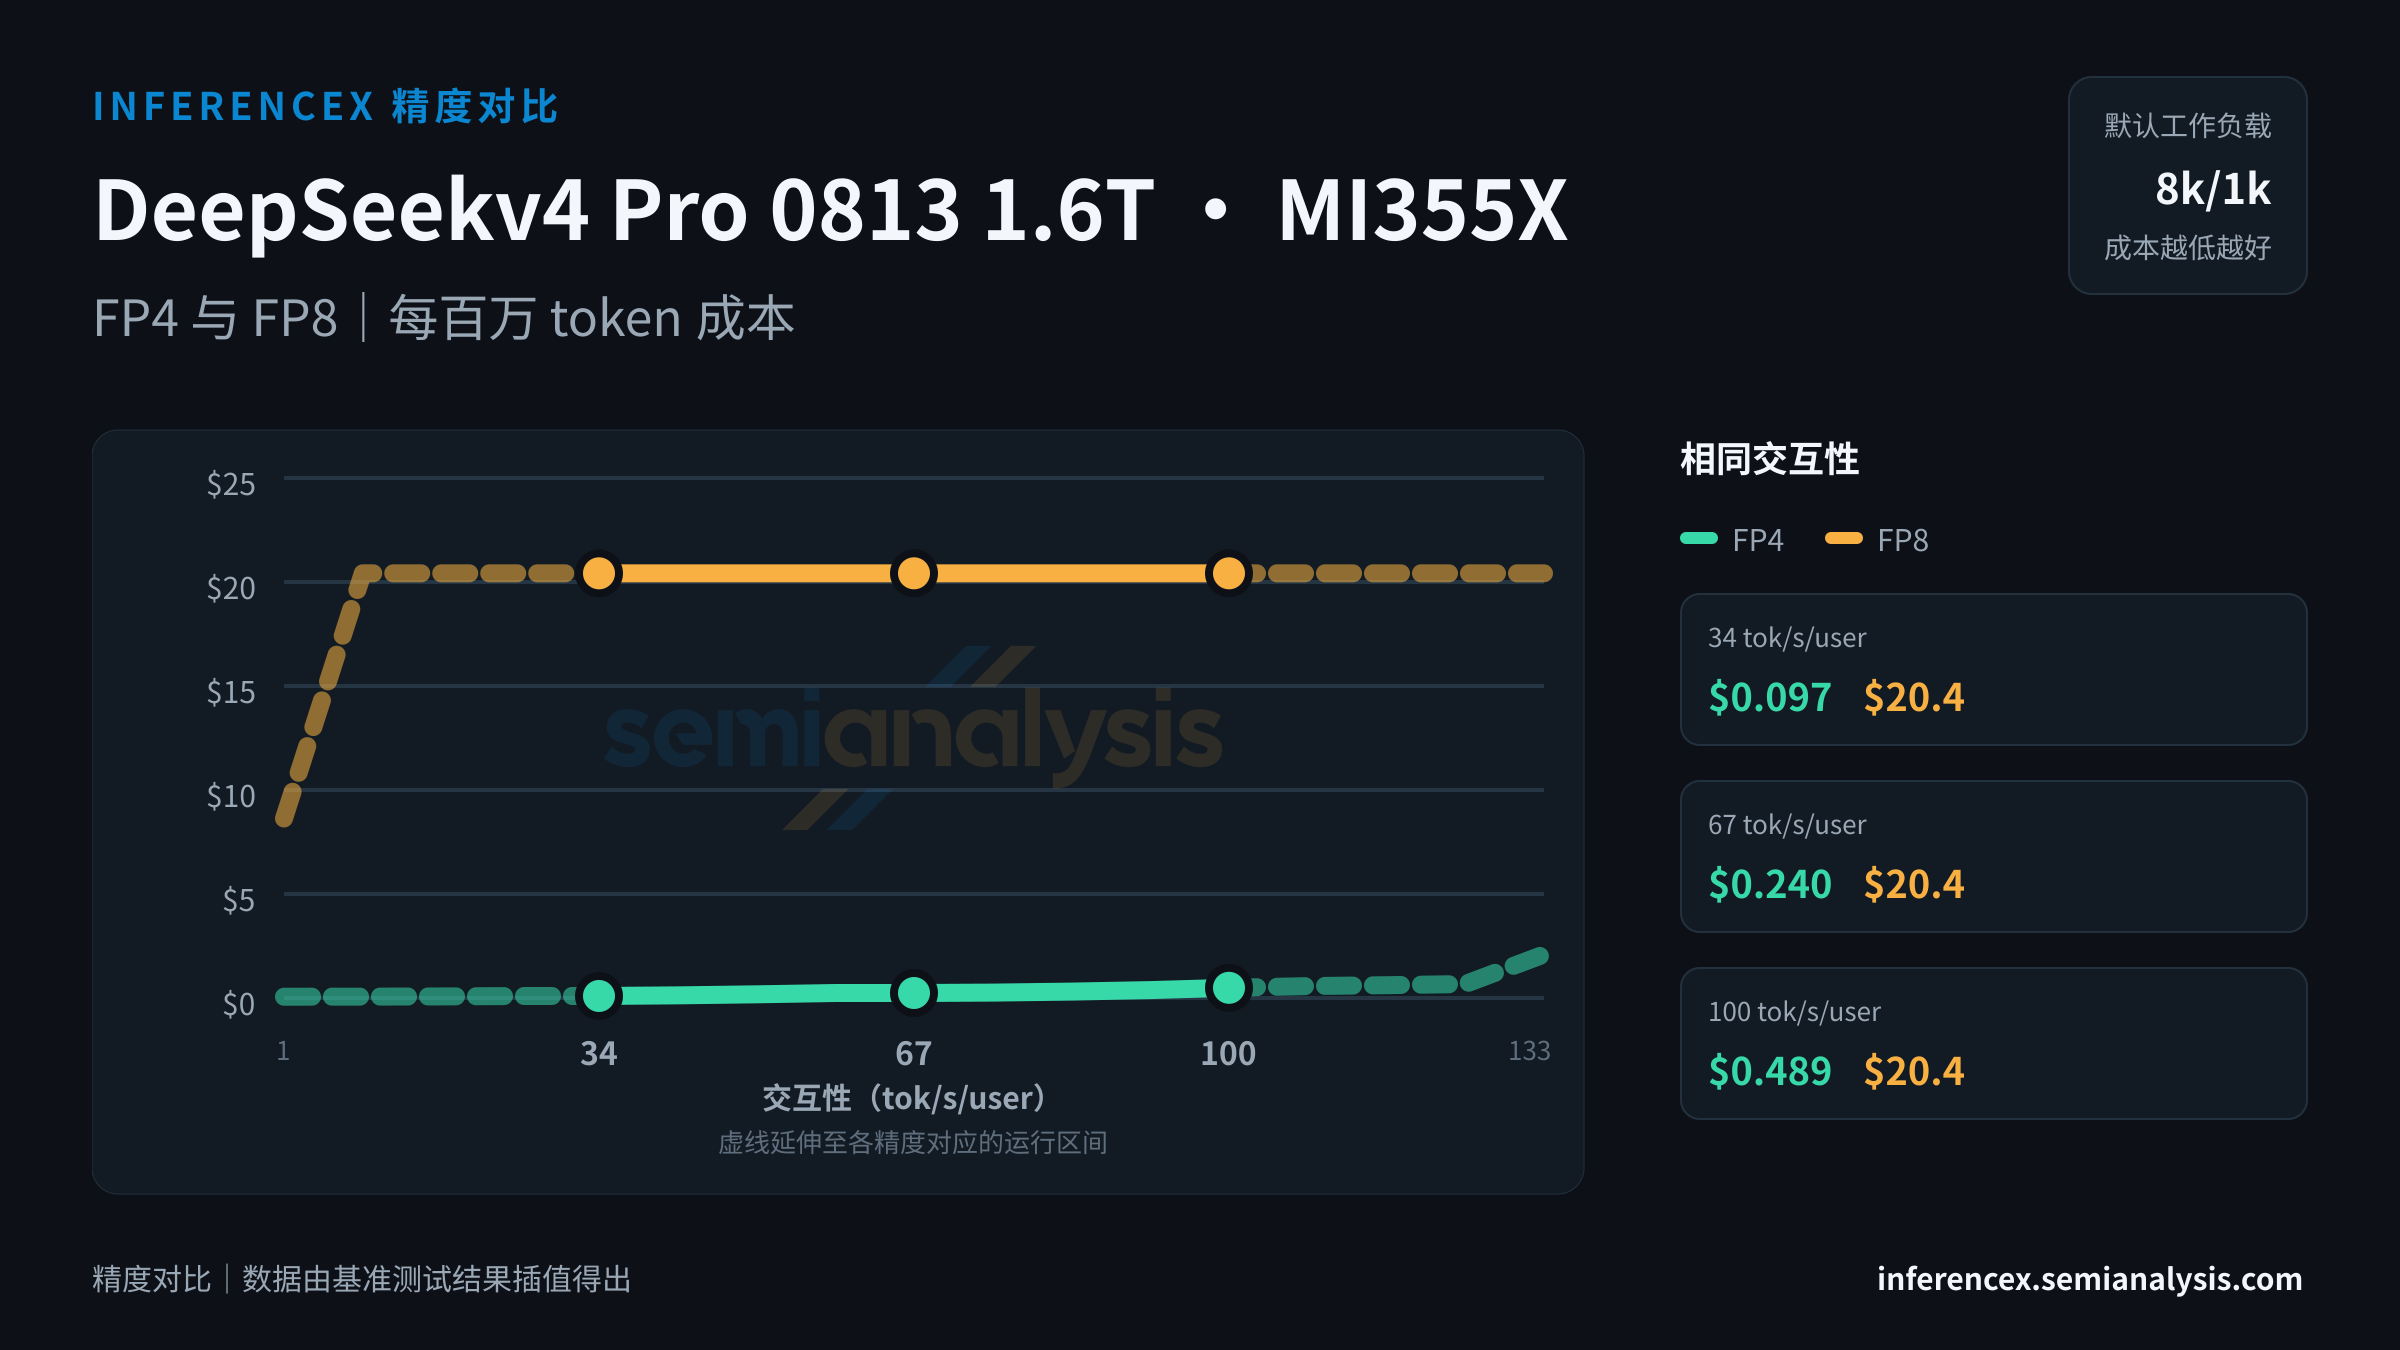
34 tok/s/user 接近 1–133 tok/s/user 交互性区间的下限。在这一运行点,FP4 在 MI355X 上运行 DeepSeekv4 Pro 0813 1.6T 的吞吐量为 4294 tok/s/chip,每百万 token 成本为 $0.10;FP8 的吞吐量为 20 tok/s/chip,每百万 token 成本为 $20.4。FP4 的成本效率高出 20939%;FP4 的单芯片吞吐量高出 20939%。调整量化精度会同时影响推理速度和模型质量;模型准确率基准测试请参阅评估页。
在 MI355X 上运行 DeepSeekv4 Pro 0813 1.6T,目标交互性为 67 tok/s/user 时,FP4 的吞吐量为 1733 tok/s/chip,每百万 token 成本为 $0.24;FP8 的吞吐量为 20 tok/s/chip,每百万 token 成本为 $20.4。FP4 的成本效率高出 8391%;FP4 的单芯片吞吐量高出 8391%。较低的量化精度以模型准确率为代价换取更高吞吐量;如需了解对模型质量的影响,请查看评估页。
当 DeepSeekv4 Pro 0813 1.6T 在 MI355X 上的目标交互性为 100 tok/s/user 时,FP4 的吞吐量为 851 tok/s/chip,每百万 token 成本为 $0.49;FP8 的吞吐量为 20 tok/s/chip,每百万 token 成本为 $20.4。FP4 的成本效率高出 4071%;FP4 的单芯片吞吐量高出 4071%。不同量化精度下的模型准确率差异可在评估页查看。 (以上数据基于此 URL 对应的默认 8k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP4:4293.5FP8:20.4 | FP4:1732.8FP8:20.4 | FP4:851.3FP8:20.4 |
| 成本($/M tok) | FP4:$0.097FP8:$20.417 | FP4:$0.240FP8:$20.417 | FP4:$0.489FP8:$20.417 |
| tok/s/MW | FP4:2054308FP8:9764 | FP4:829088FP8:9764 | FP4:407322FP8:9764 |
| 并发数 | FP4:~512FP8:~8 | FP4:~32FP8:~8 | FP4:~8FP8:~8 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。