
GB300 NVL72:FP4 与 FP8 精度对比
在 GB300 NVL72(NVIDIA Blackwell)上,比较 FP4 与 FP8 两种量化精度对 DeepSeek R1 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
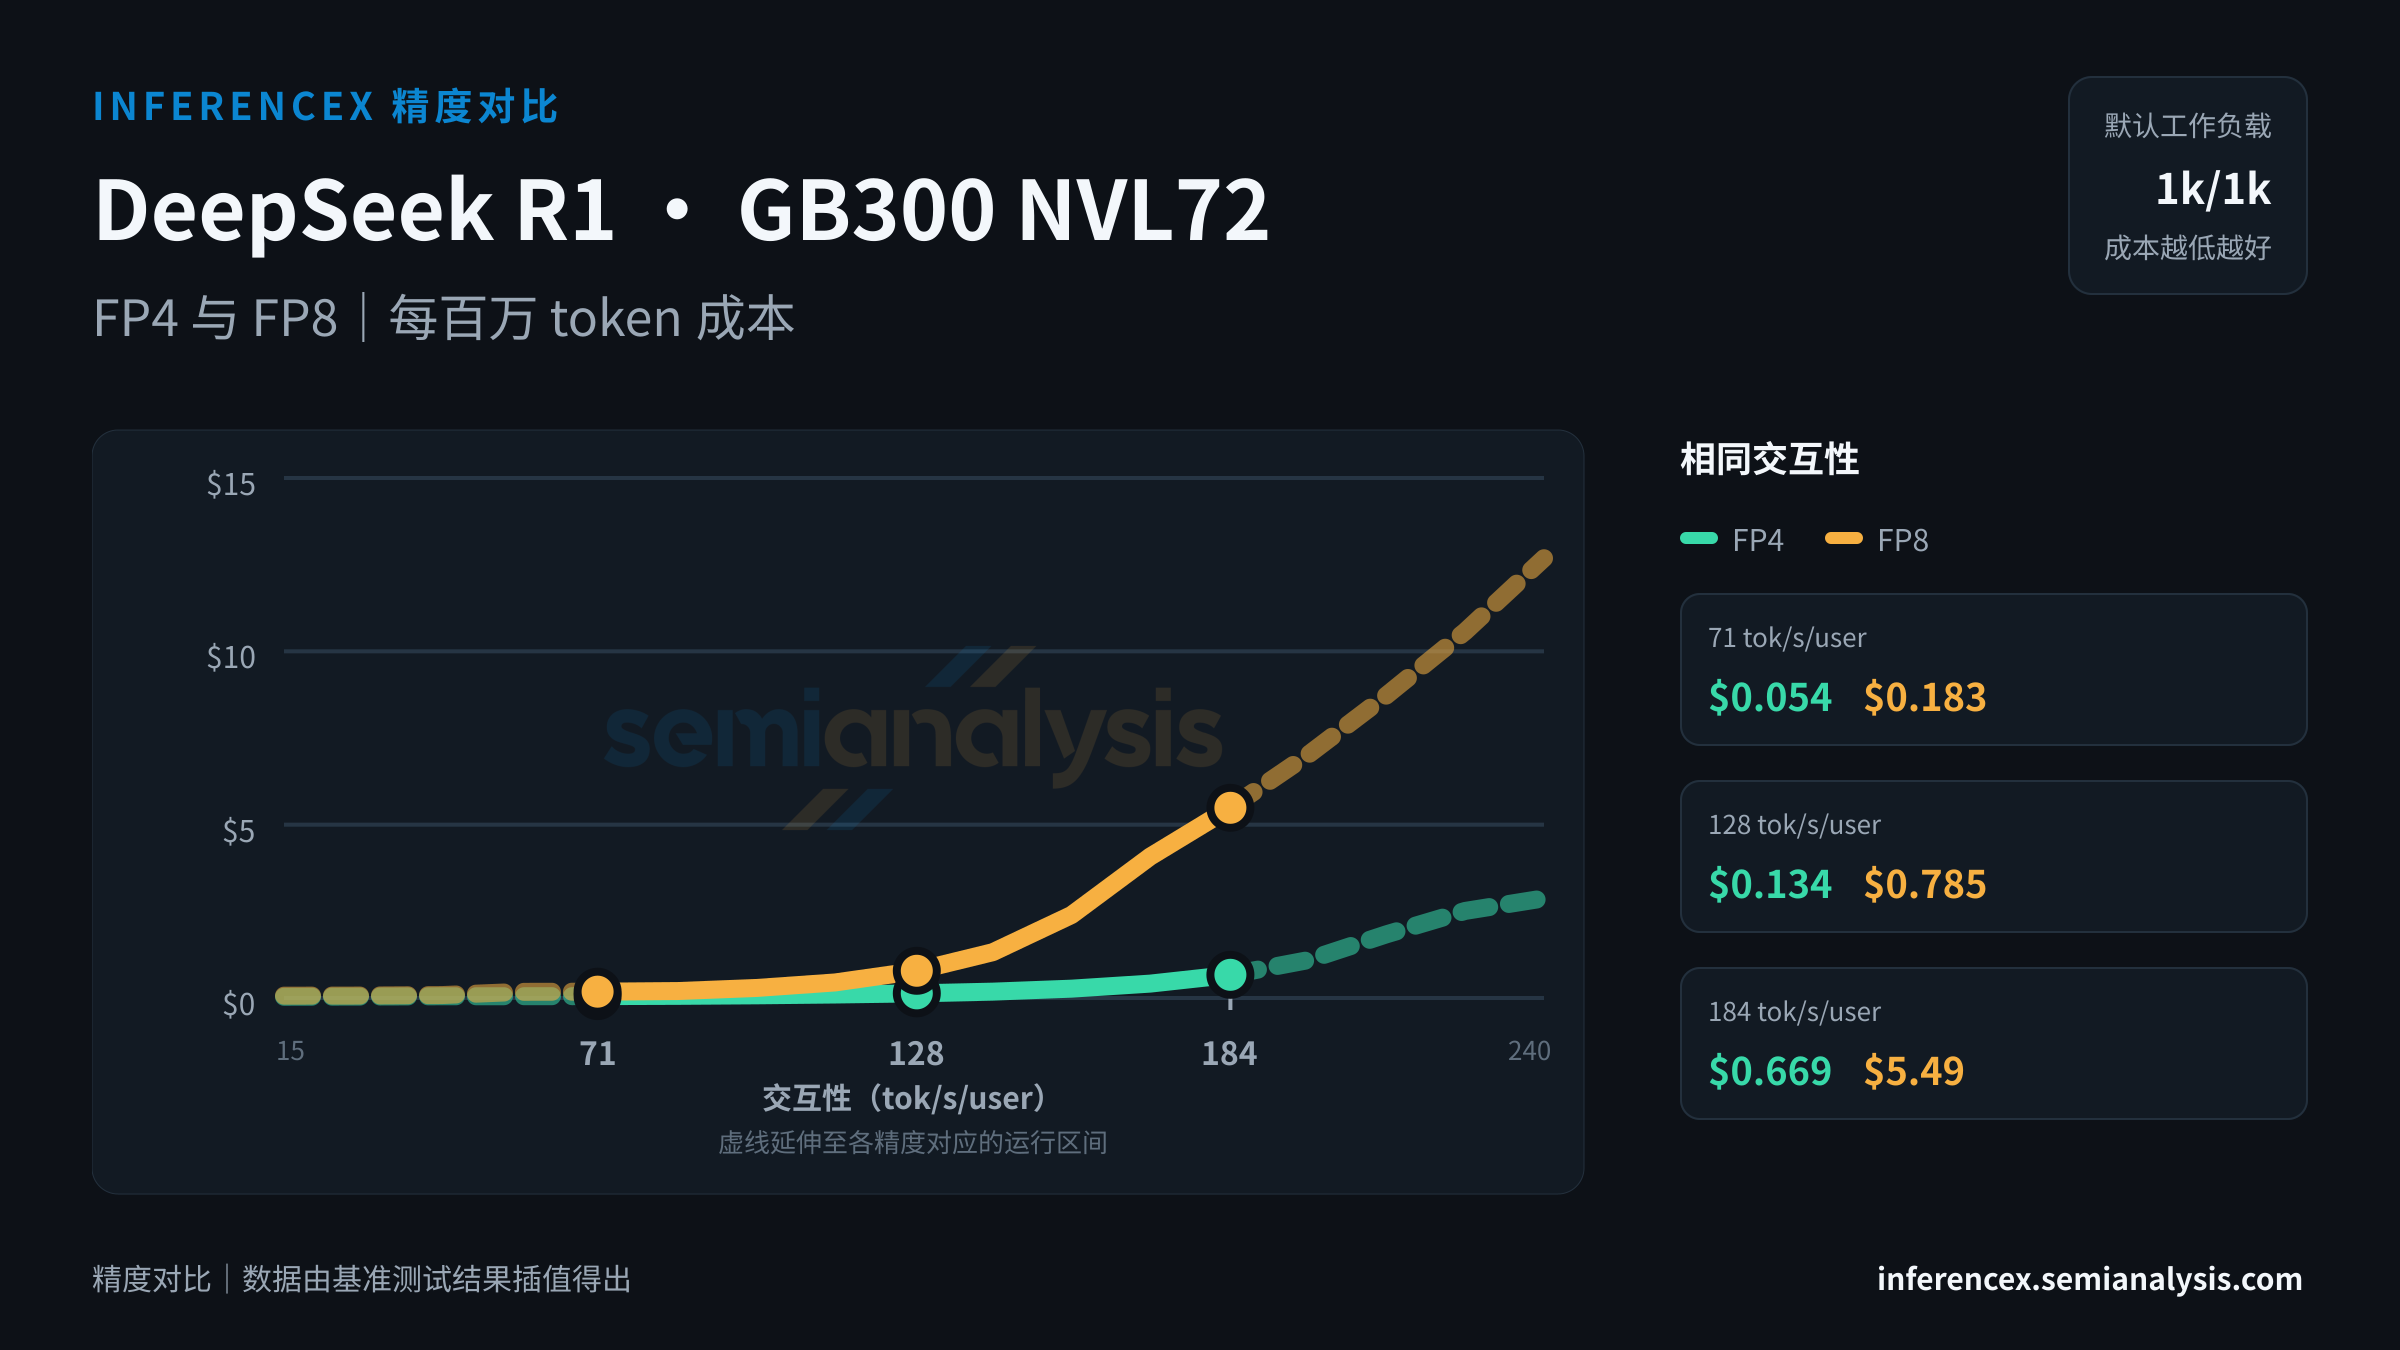
在 GB300 NVL72 上运行 DeepSeek R1,目标交互性为 71 tok/s/user 时,FP4 的吞吐量为 11951 tok/s/chip,每百万 token 成本为 $0.05;FP8 的吞吐量为 3513 tok/s/chip,每百万 token 成本为 $0.18。FP4 的成本效率高出 240%;FP4 的单芯片吞吐量高出 240%。较低的量化精度以模型准确率为代价换取更高吞吐量;如需了解对模型质量的影响,请查看评估页。
当 DeepSeek R1 在 GB300 NVL72 上的目标交互性为 128 tok/s/user 时,FP4 的吞吐量为 4793 tok/s/chip,每百万 token 成本为 $0.13;FP8 的吞吐量为 817 tok/s/chip,每百万 token 成本为 $0.79。FP4 的成本效率高出 487%;FP4 的单芯片吞吐量高出 487%。不同量化精度下的模型准确率差异可在评估页查看。
在 GB300 NVL72 上运行 DeepSeek R1,目标交互性为 184 tok/s/user 时,FP4 与 FP8 的吞吐量分别为 959 和 117 tok/s/chip,每百万 token 成本分别为 $0.67 和 $5.49。FP4 的成本效率高出 720%;FP4 的单芯片吞吐量高出 720%。较低量化精度下的成本与吞吐量权衡只是整体考量的一部分;模型准确率数据请参阅评估页。 (以上数据基于此 URL 对应的默认 1k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP4:11951.3FP8:3513.0 | FP4:4792.5FP8:817.0 | FP4:959.4FP8:117.0 |
| 成本($/M tok) | FP4:$0.054FP8:$0.183 | FP4:$0.134FP8:$0.785 | FP4:$0.669FP8:$5.486 |
| tok/s/MW | FP4:5637396FP8:1657060 | FP4:2260634FP8:385398 | FP4:452544FP8:55169 |
| 并发数 | FP4:~2227FP8:~938 | FP4:~958FP8:~181 | FP4:~136FP8:~20 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。