DeepSeek R1 · B300 · 精度对比
B300:FP4 与 FP8 精度对比
在 B300(NVIDIA Blackwell)上,比较 FP4 与 FP8 两种量化精度对 DeepSeek R1 推理的影响,涵盖不同 LLM 工作负载下的吞吐量、延迟和成本。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
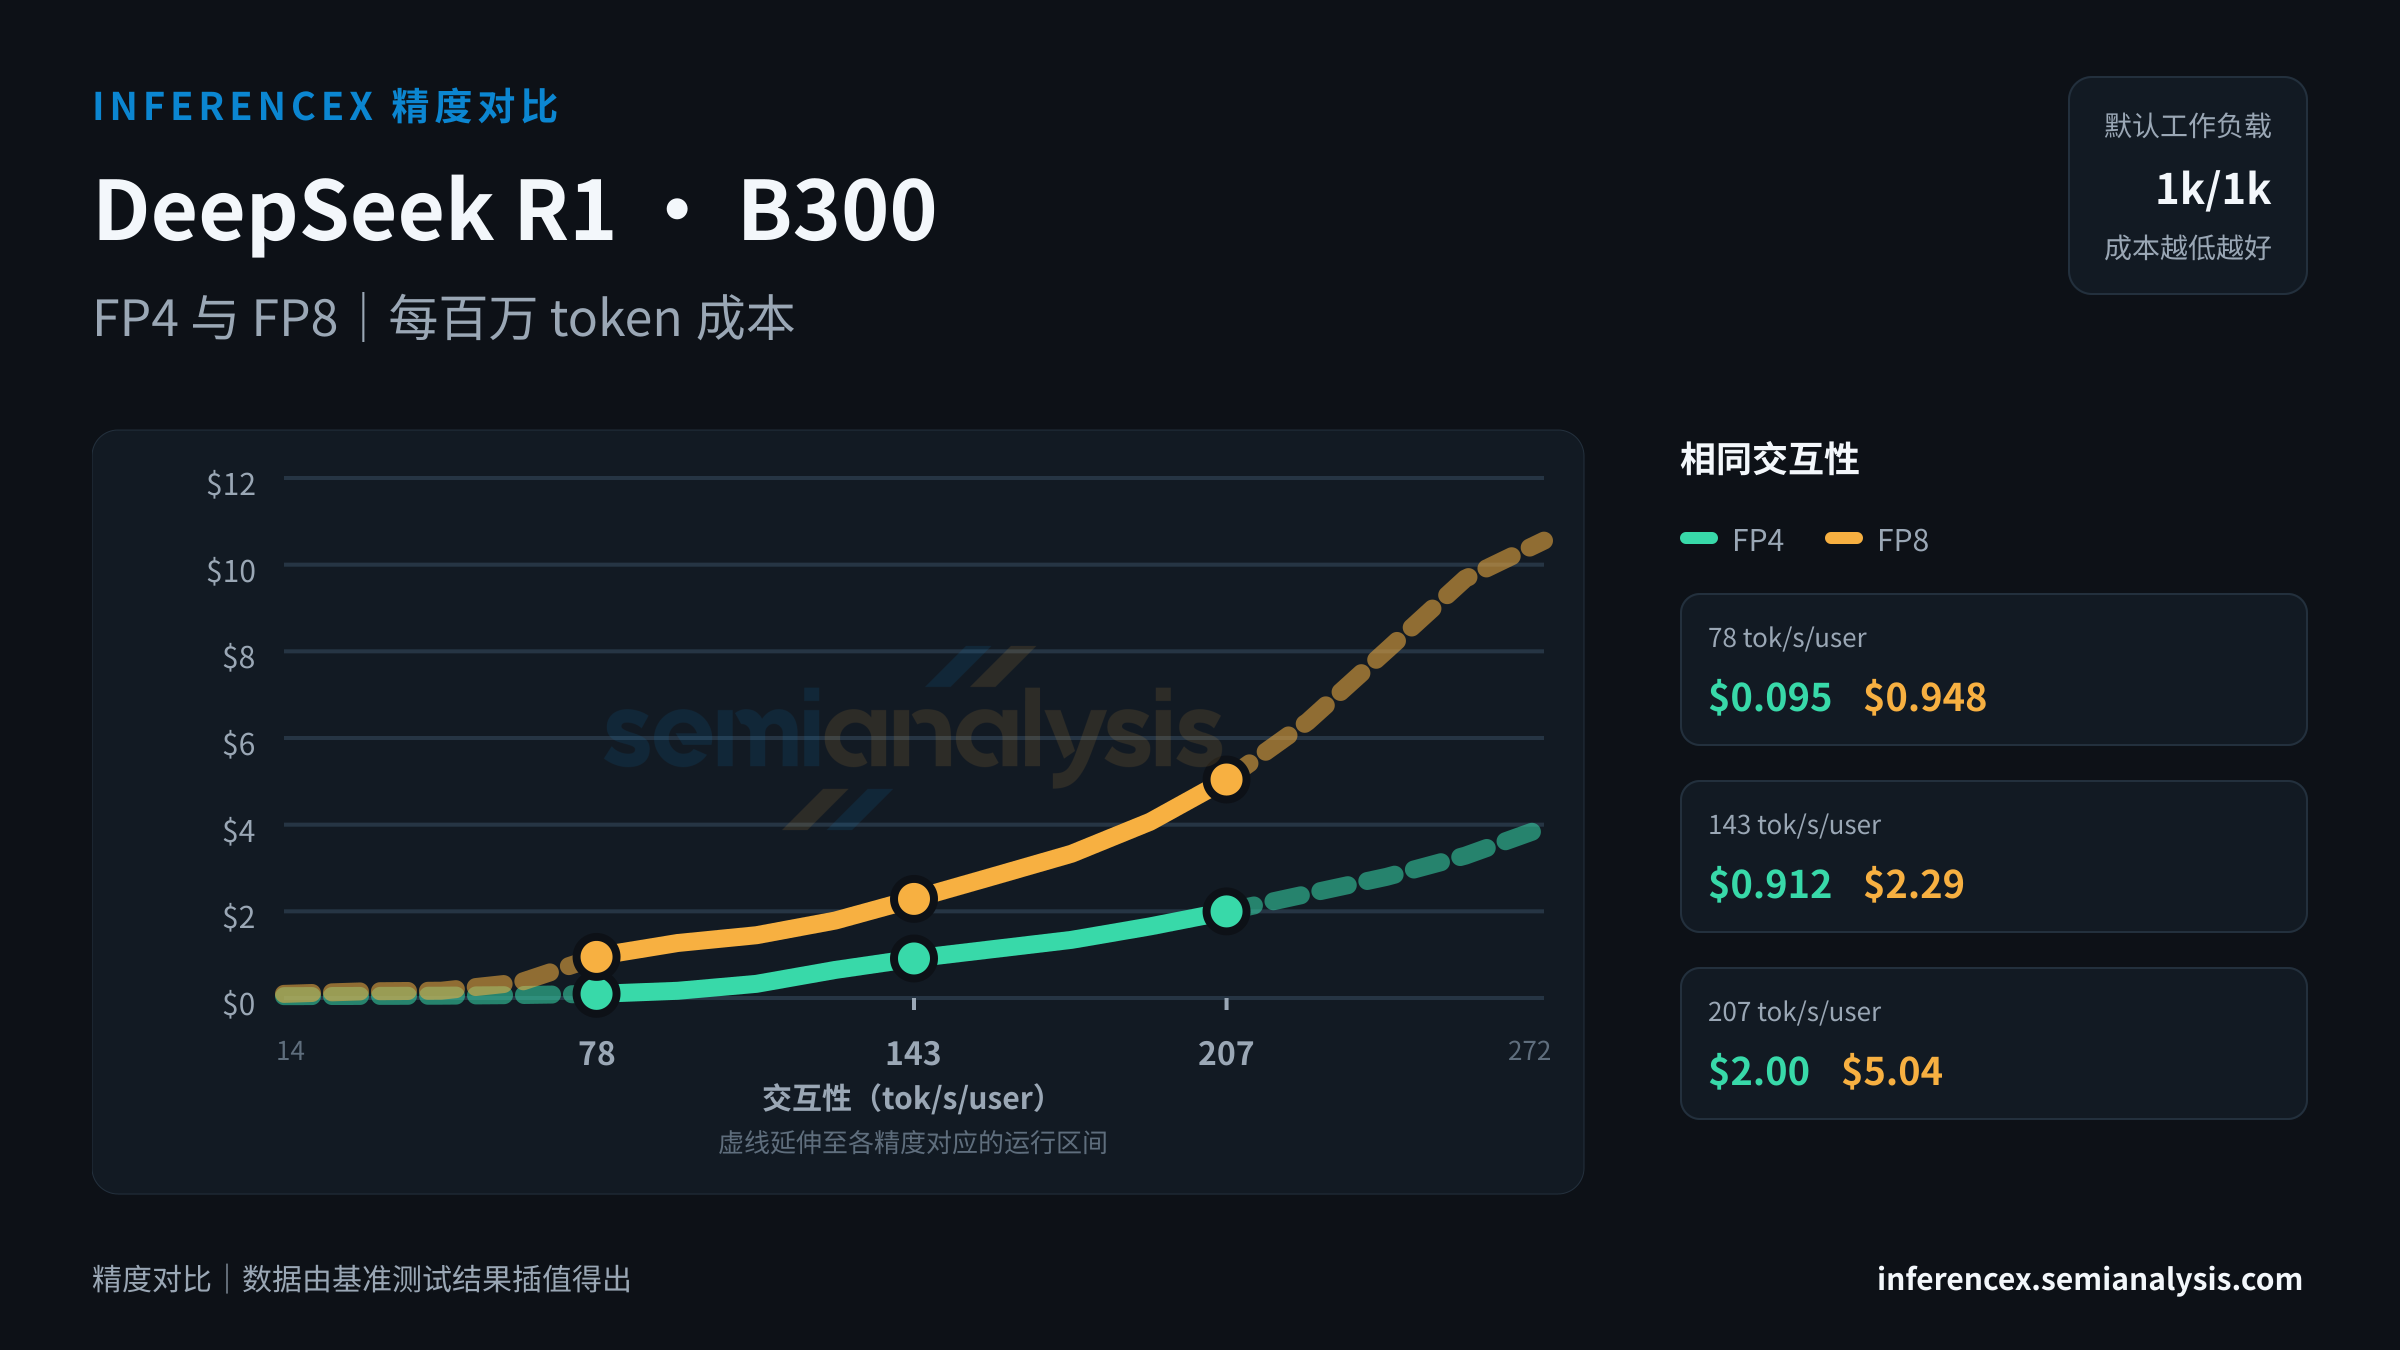
在 B300 上运行 DeepSeek R1,目标交互性为 78 tok/s/user 时,FP4 的吞吐量为 6,579 tok/s/chip,每百万 token 成本为 $0.095;FP8 的吞吐量为 662 tok/s/chip,每百万 token 成本为 $0.95。在同一芯片上,FP4 的单芯片吞吐量为对方的 9.9 倍,因此每 token 成本低 90%。较低的量化精度以模型准确率为代价换取更高吞吐量;如需了解对模型质量的影响,请查看评估页。
当 DeepSeek R1 在 B300 上的目标交互性为 143 tok/s/user 时,FP4 的吞吐量为 688 tok/s/chip,每百万 token 成本为 $0.91;FP8 的吞吐量为 275 tok/s/chip,每百万 token 成本为 $2.29。在同一芯片上,FP4 的单芯片吞吐量高出 151%,因此每 token 成本低 60%。不同量化精度下的模型准确率差异可在评估页查看。
在 B300 上运行 DeepSeek R1,目标交互性为 207 tok/s/user 时,FP4 与 FP8 的吞吐量分别为 314 和 125 tok/s/chip,每百万 token 成本分别为 $2.00 和 $5.04。在同一芯片上,FP4 的单芯片吞吐量高出 152%,因此每 token 成本低 60%。较低量化精度下的成本与吞吐量权衡只是整体考量的一部分;模型准确率数据请参阅评估页。 (以上数据基于此 URL 对应的默认 1k/1k 配置;在控件中切换序列长度或模型后,下方表格和图表会同步更新。两侧均采用各自精度下可用的最优推理配置;只有存在相应测试配置时,才可能纳入 MTP 等投机解码方法。该口径与其他对比页面一致。)
数据由真实基准测试结果插值得出。调整下方的目标交互性数值,即可比较不同运行点。
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | FP46,579FP8662 | FP4688FP8275 | FP4314FP8125 |
| 成本($/M tok) | FP4$0.095FP8$0.95 | FP4$0.91FP8$2.29 | FP4$2.00FP8$5.04 |
| tok/s/MW | FP43,462,773FP8348,375 | FP4362,225FP8144,483 | FP4165,341FP865,536 |
| 并发数 | FP4~548FP8~61 | FP4~105FP8~8 | FP4~33FP8~3 |