
MI355X FP4:启用 MTP 与关闭投机解码的对比
在 MI355X FP4(AMD CDNA 4)上运行 Qwen 3.5 397B-A17B 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
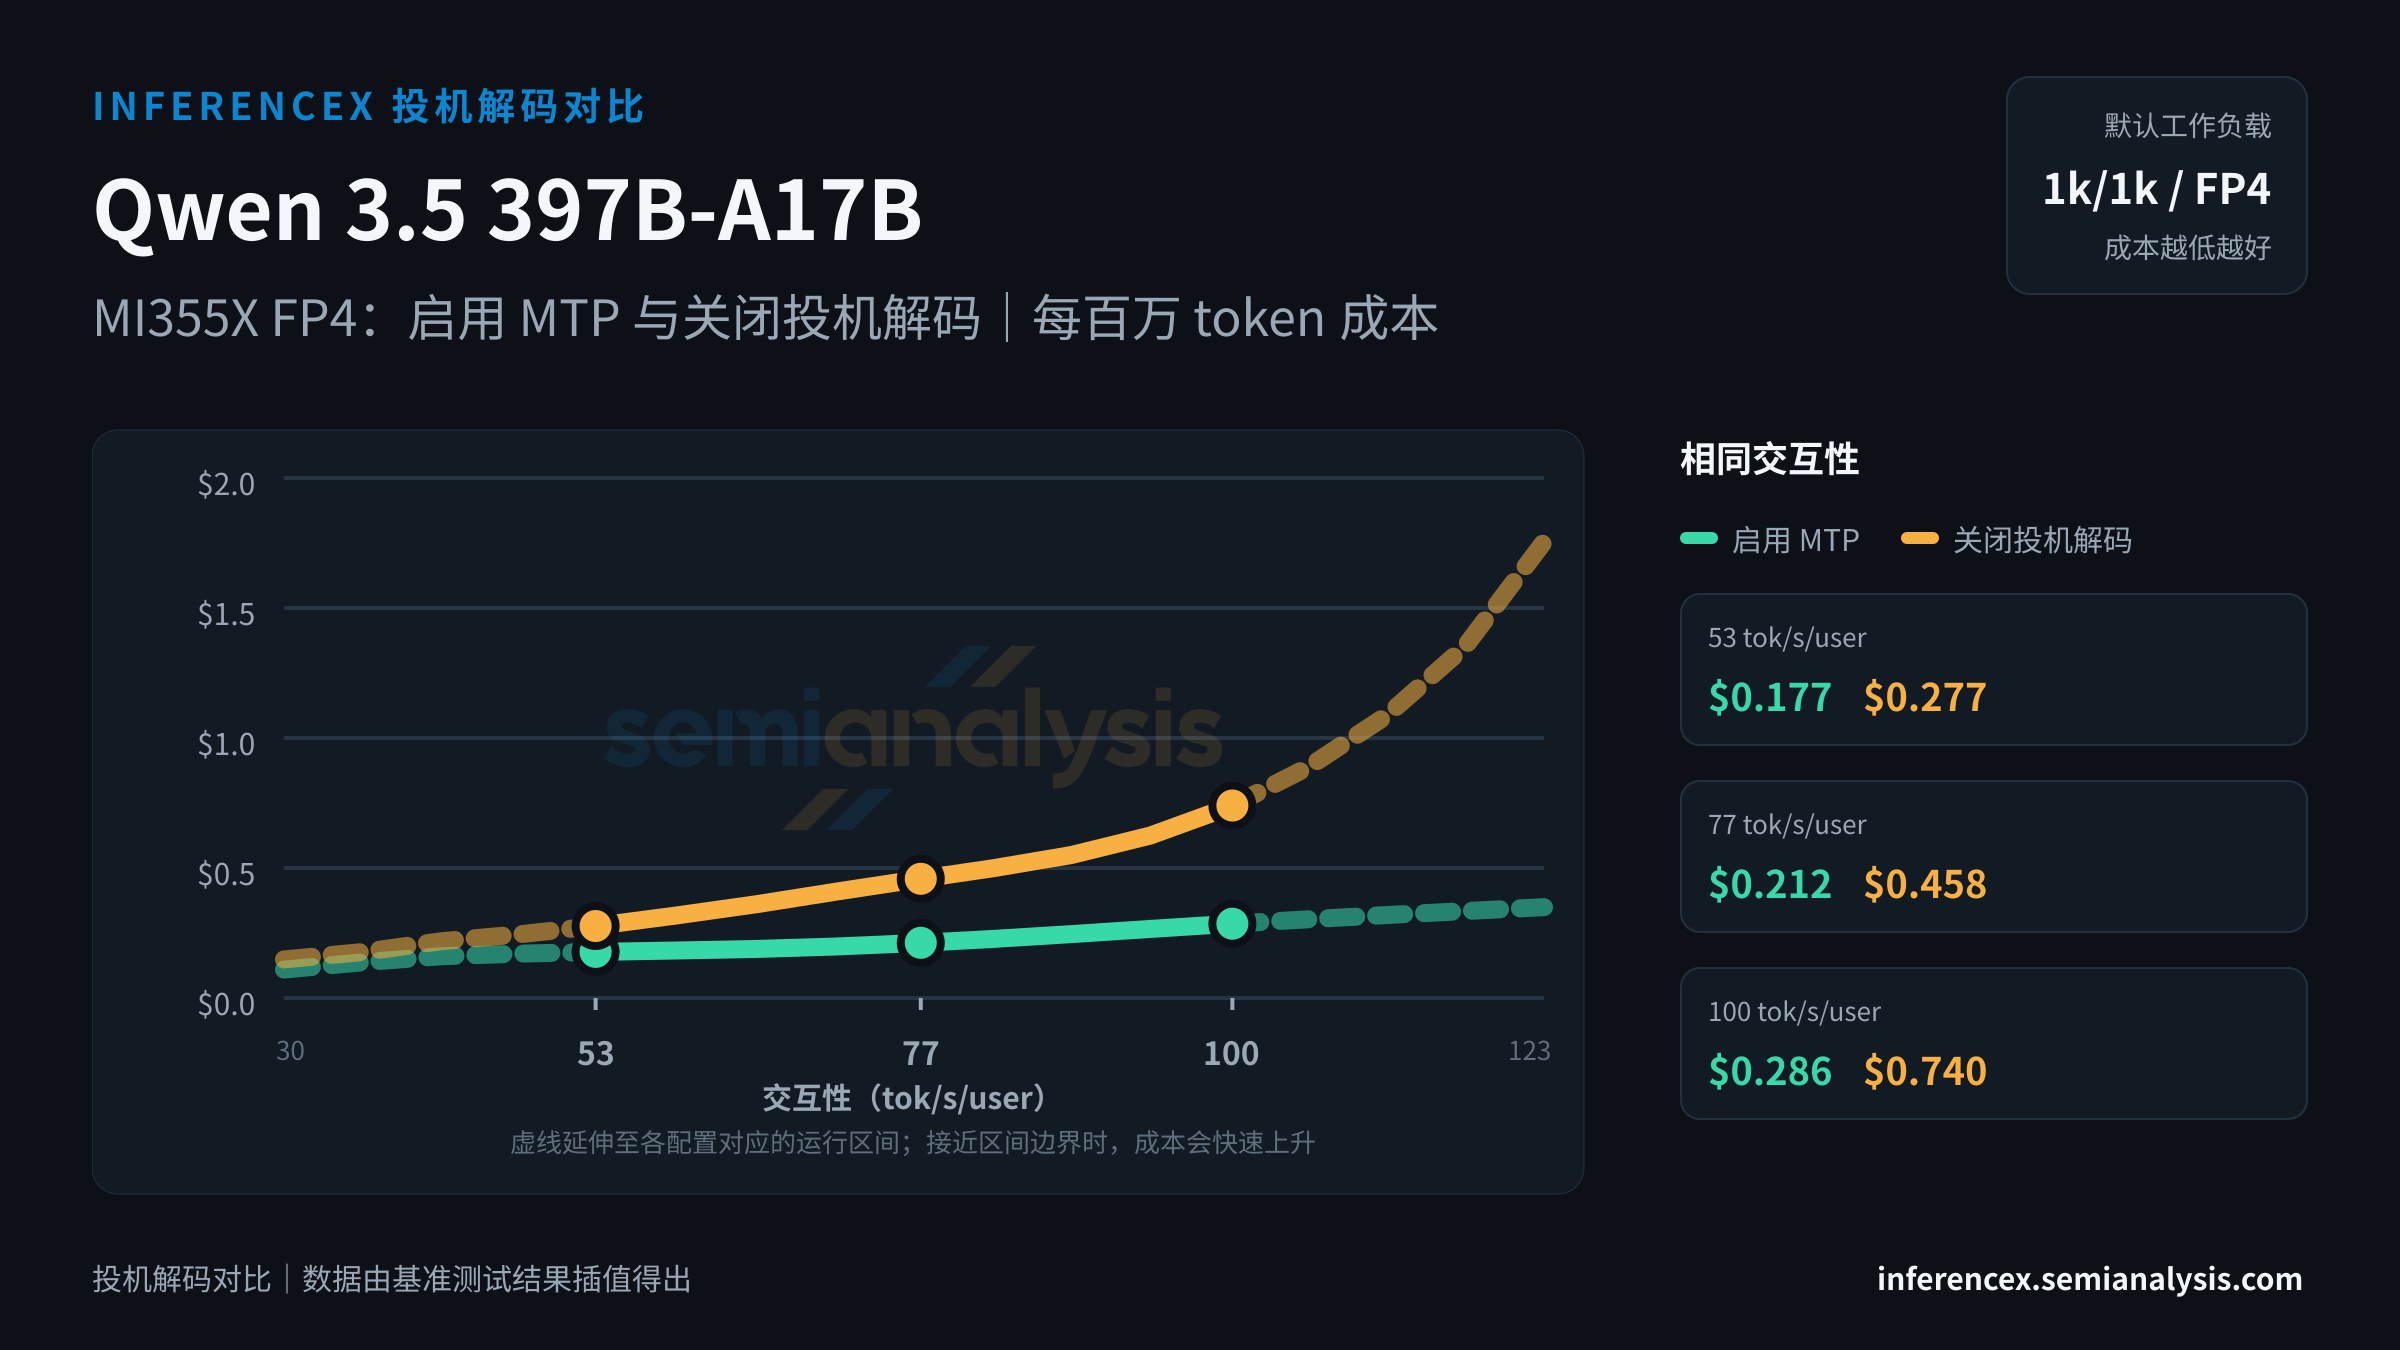
在 MI355X FP4 上运行 Qwen 3.5 397B-A17B,目标交互性设为 53 tok/s/user:启用 MTP 时,吞吐量为 2351 tok/s/chip,每百万 token 成本为 $0.18;关闭投机解码时,吞吐量为 1505 tok/s/chip,每百万 token 成本为 $0.28。MTP 的成本效率高出 56%;MTP 的单芯片吞吐量高出 56%。投机解码会增加 draft token 的计算量,以减少解码步数;收益取决于序列长度和批大小。
77 tok/s/user 位于 30–123 tok/s/user 交互性区间的中段。在这一运行点,启用 MTP 时,吞吐量为 1963 tok/s/chip,每百万 token 成本为 $0.21;关闭投机解码时,吞吐量为 909 tok/s/chip,每百万 token 成本为 $0.46。MTP 的成本效率高出 116%;MTP 的单芯片吞吐量高出 116%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。
在 MI355X FP4 上运行 Qwen 3.5 397B-A17B,目标交互性设为 100 tok/s/user:启用 MTP 时,吞吐量为 1459 tok/s/chip,每百万 token 成本为 $0.29;关闭投机解码时,吞吐量为 563 tok/s/chip,每百万 token 成本为 $0.74。MTP 的成本效率高出 159%;MTP 的单芯片吞吐量高出 159%。投机解码通过接受 draft token 降低每 token 延迟;收益因工作负载和 prompt 分布而异。 (以上数据基于此 URL 固定的 1k/1k · fp4 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP:2350.7关闭投机解码:1505.1 | 启用 MTP:1963.5关闭投机解码:909.0 | 启用 MTP:1458.6关闭投机解码:562.9 |
| 成本($/M tok) | 启用 MTP:$0.177关闭投机解码:$0.277 | 启用 MTP:$0.212关闭投机解码:$0.458 | 启用 MTP:$0.286关闭投机解码:$0.740 |
| tok/s/MW | 启用 MTP:1124716关闭投机解码:720132 | 启用 MTP:939462关闭投机解码:434913 | 启用 MTP:697900关闭投机解码:269311 |
| 并发数 | 启用 MTP:~45关闭投机解码:~29 | 启用 MTP:~26关闭投机解码:~11 | 启用 MTP:~15关闭投机解码:~8 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。