
H200 FP8:启用 MTP 与关闭投机解码的对比
在 H200 FP8(NVIDIA Hopper)上运行 Qwen 3.5 397B-A17B 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
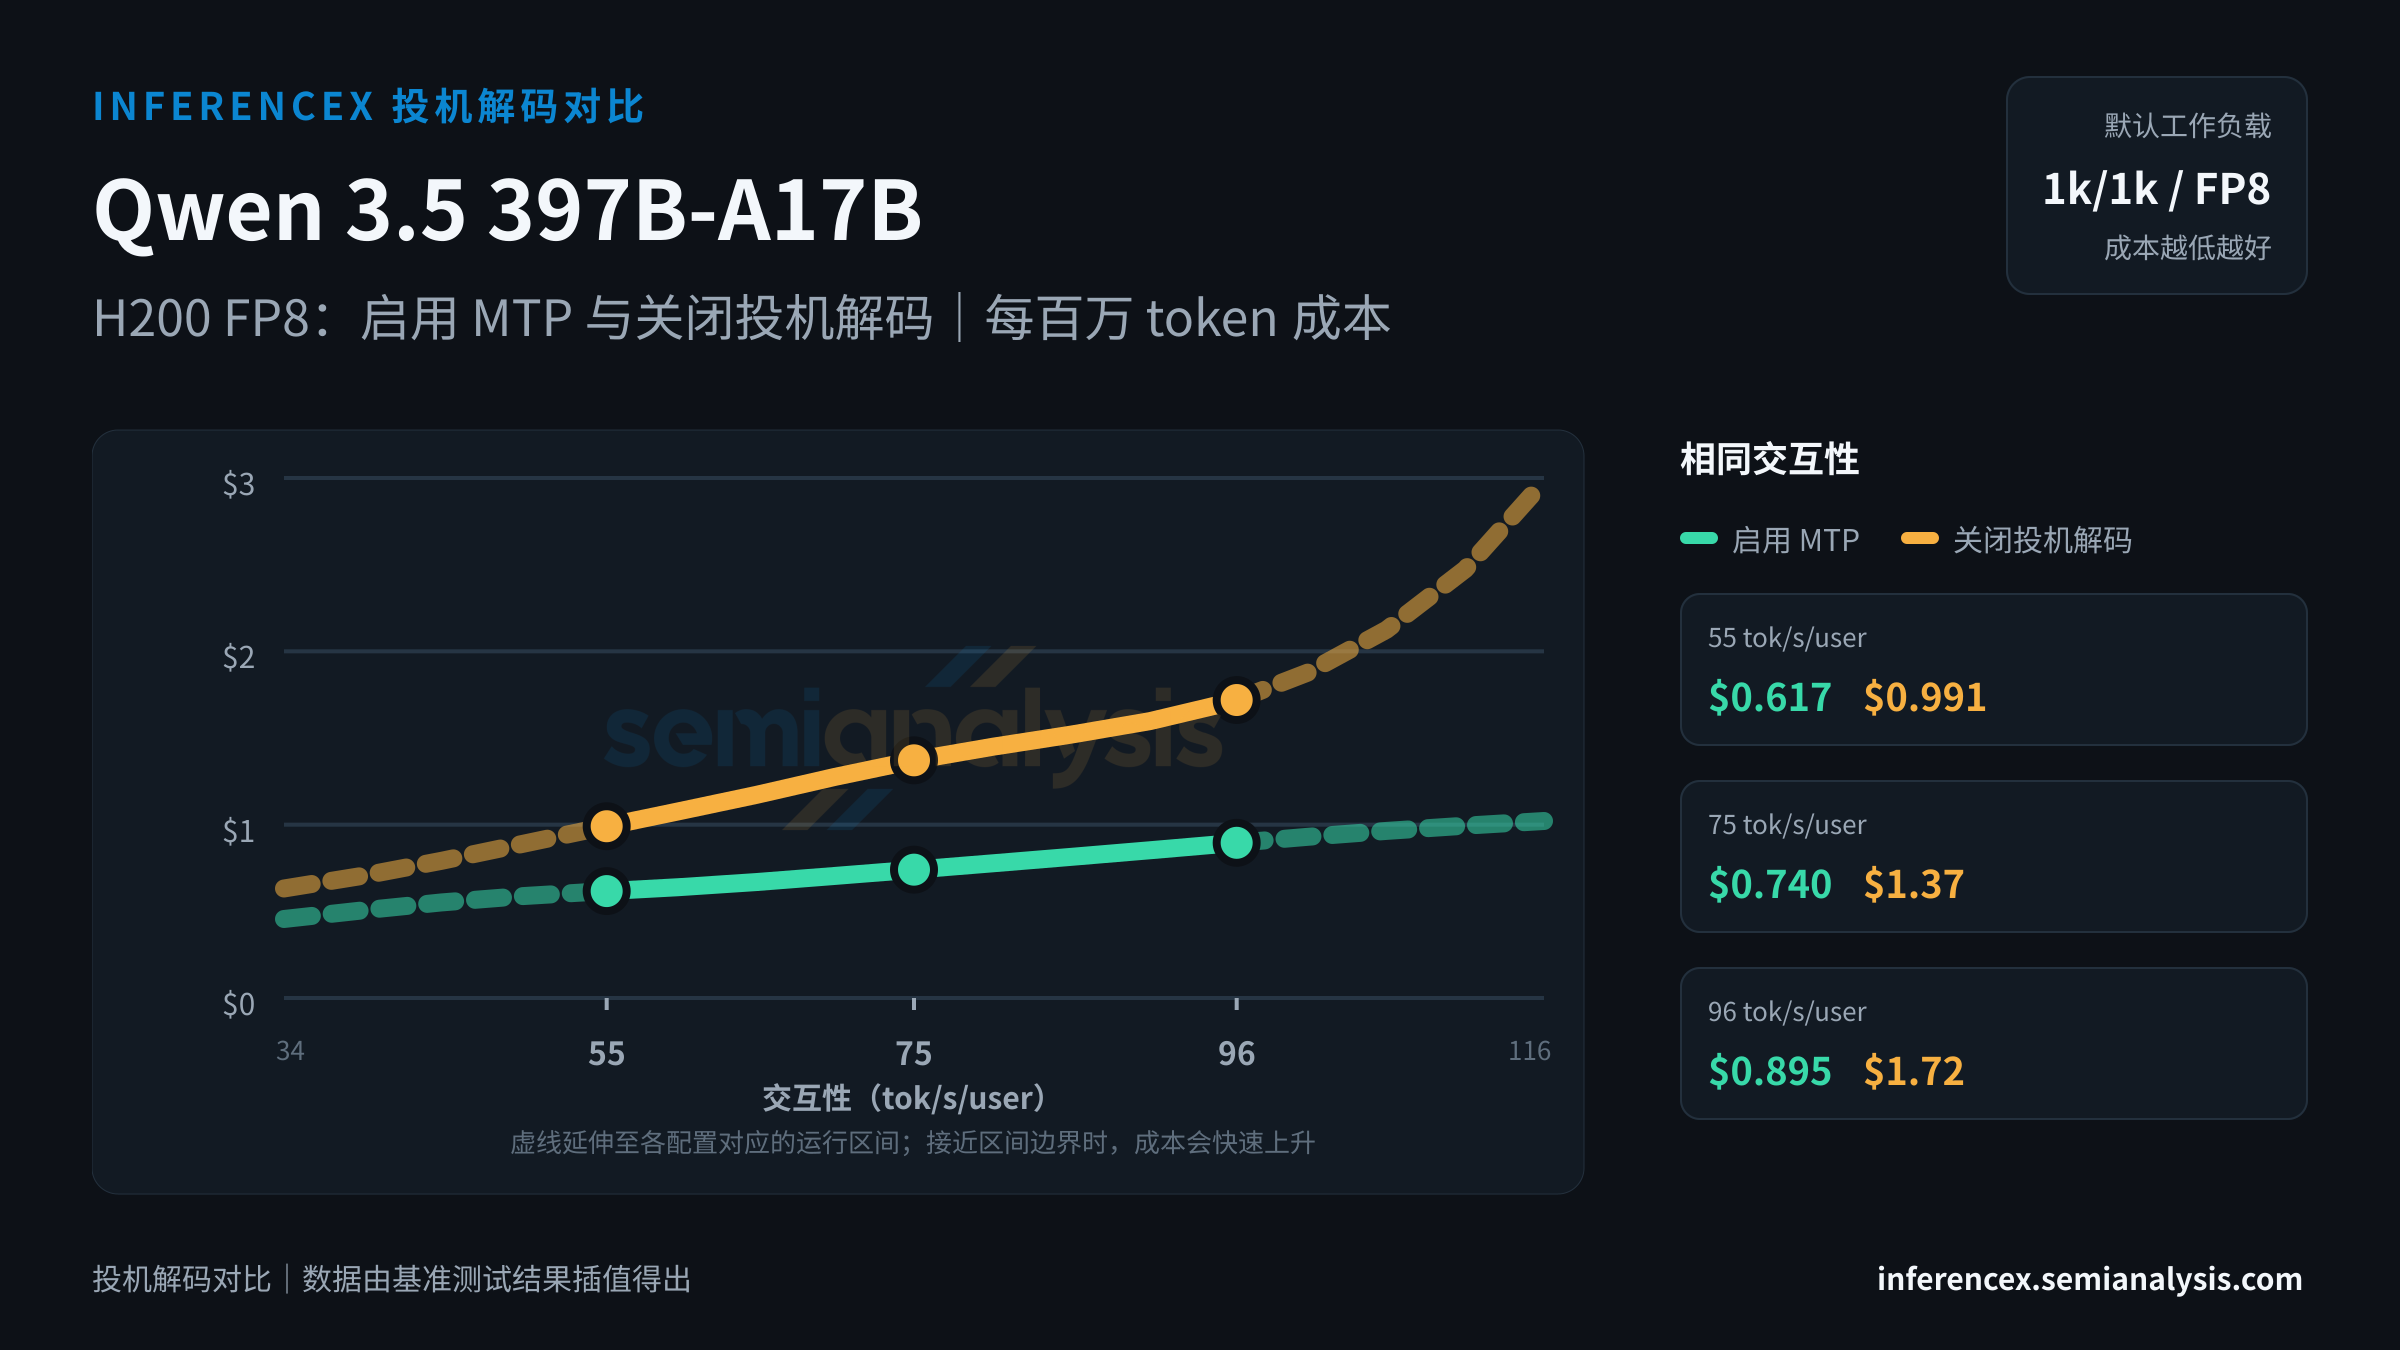
55 tok/s/user 接近 34–116 tok/s/user 交互性区间的下限。在这一运行点,启用 MTP 时,吞吐量为 549 tok/s/chip,每百万 token 成本为 $0.62;关闭投机解码时,吞吐量为 342 tok/s/chip,每百万 token 成本为 $0.99。MTP 的成本效率高出 61%;MTP 的单芯片吞吐量高出 61%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。
在 H200 FP8 上运行 Qwen 3.5 397B-A17B,目标交互性设为 75 tok/s/user:启用 MTP 时,吞吐量为 458 tok/s/chip,每百万 token 成本为 $0.74;关闭投机解码时,吞吐量为 247 tok/s/chip,每百万 token 成本为 $1.37。MTP 的成本效率高出 85%;MTP 的单芯片吞吐量高出 85%。投机解码通过接受 draft token 降低每 token 延迟;收益因工作负载和 prompt 分布而异。
Qwen 3.5 397B-A17B 在 H200 FP8 上的目标交互性设为 96 tok/s/user:启用 MTP 时,吞吐量为 378 tok/s/chip,每百万 token 成本为 $0.90;关闭投机解码时,吞吐量为 197 tok/s/chip,每百万 token 成本为 $1.72。MTP 的成本效率高出 92%;MTP 的单芯片吞吐量高出 92%。draft token 接受率决定了在给定并发数下,投机解码是提升性能还是拖累性能。 (以上数据基于此 URL 固定的 1k/1k · fp8 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP:549.4关闭投机解码:342.0 | 启用 MTP:457.7关闭投机解码:247.2 | 启用 MTP:378.5关闭投机解码:197.1 |
| 成本($/M tok) | 启用 MTP:$0.617关闭投机解码:$0.991 | 启用 MTP:$0.740关闭投机解码:$1.371 | 启用 MTP:$0.895关闭投机解码:$1.719 |
| tok/s/MW | 启用 MTP:401050关闭投机解码:249632 | 启用 MTP:334098关闭投机解码:180402 | 启用 MTP:276271关闭投机解码:143891 |
| 并发数 | 启用 MTP:~40关闭投机解码:~25 | 启用 MTP:~24关闭投机解码:~13 | 启用 MTP:~16关闭投机解码:~9 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。