
GB200 NVL72 FP8:启用 MTP 与关闭投机解码的对比
在 GB200 NVL72 FP8(NVIDIA Blackwell)上运行 DeepSeek R1 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
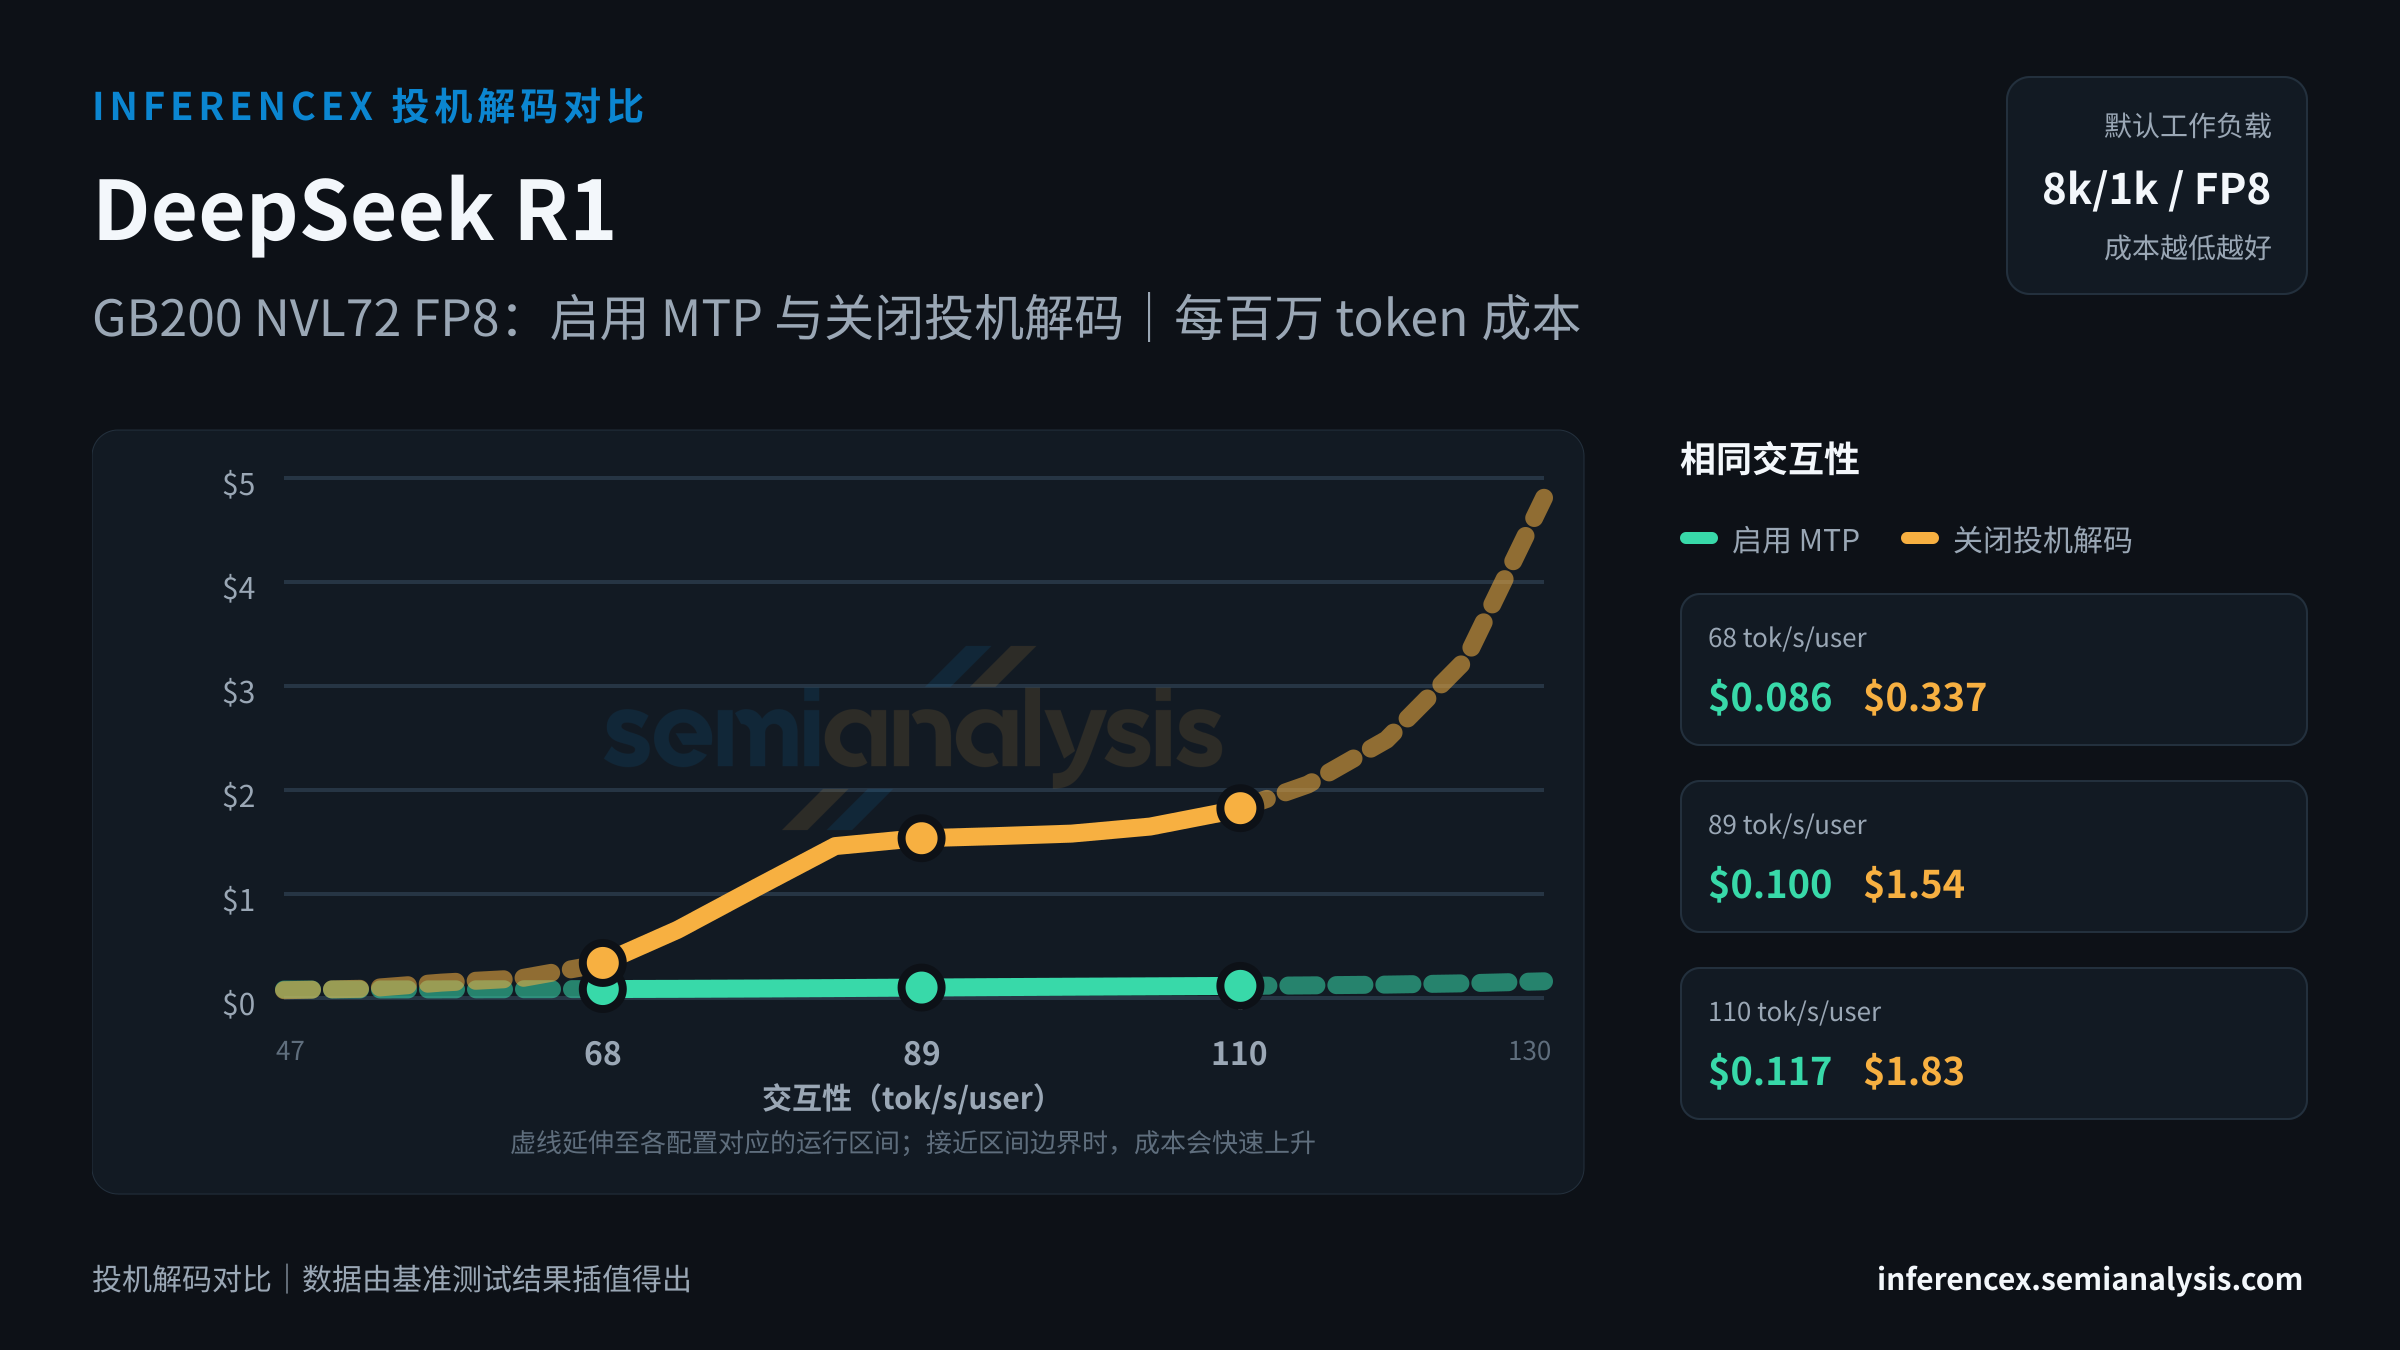
在 GB200 NVL72 FP8 上运行 DeepSeek R1,目标交互性设为 68 tok/s/user:启用 MTP 时,吞吐量为 6008 tok/s/chip,每百万 token 成本为 $0.09;关闭投机解码时,吞吐量为 1533 tok/s/chip,每百万 token 成本为 $0.34。MTP 的成本效率高出 292%;MTP 的单芯片吞吐量高出 292%。投机解码会增加 draft token 的计算量,以减少解码步数;收益取决于序列长度和批大小。
89 tok/s/user 位于 47–130 tok/s/user 交互性区间的中段。在这一运行点,启用 MTP 时,吞吐量为 5149 tok/s/chip,每百万 token 成本为 $0.10;关闭投机解码时,吞吐量为 336 tok/s/chip,每百万 token 成本为 $1.54。MTP 的成本效率高出 1431%;MTP 的单芯片吞吐量高出 1431%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。
在 GB200 NVL72 FP8 上运行 DeepSeek R1,目标交互性设为 110 tok/s/user:启用 MTP 时,吞吐量为 4430 tok/s/chip,每百万 token 成本为 $0.12;关闭投机解码时,吞吐量为 283 tok/s/chip,每百万 token 成本为 $1.83。MTP 的成本效率高出 1465%;MTP 的单芯片吞吐量高出 1465%。投机解码通过接受 draft token 降低每 token 延迟;收益因工作负载和 prompt 分布而异。 (以上数据基于此 URL 固定的 8k/1k · fp8 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP:6007.8关闭投机解码:1532.6 | 启用 MTP:5148.6关闭投机解码:336.3 | 启用 MTP:4429.8关闭投机解码:283.1 |
| 成本($/M tok) | 启用 MTP:$0.086关闭投机解码:$0.337 | 启用 MTP:$0.100关闭投机解码:$1.536 | 启用 MTP:$0.117关闭投机解码:$1.825 |
| tok/s/MW | 启用 MTP:3212713关闭投机解码:819566 | 启用 MTP:2753252关闭投机解码:179847 | 启用 MTP:2368862关闭投机解码:151379 |
| 并发数 | 启用 MTP:~666关闭投机解码:~128 | 启用 MTP:~368关闭投机解码:~10 | 启用 MTP:~333关闭投机解码:~17 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。