DeepSeek R1 · 投机解码
B300 FP4:启用 MTP 与关闭投机解码的对比
在 B300 FP4(NVIDIA Blackwell)上运行 DeepSeek R1 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
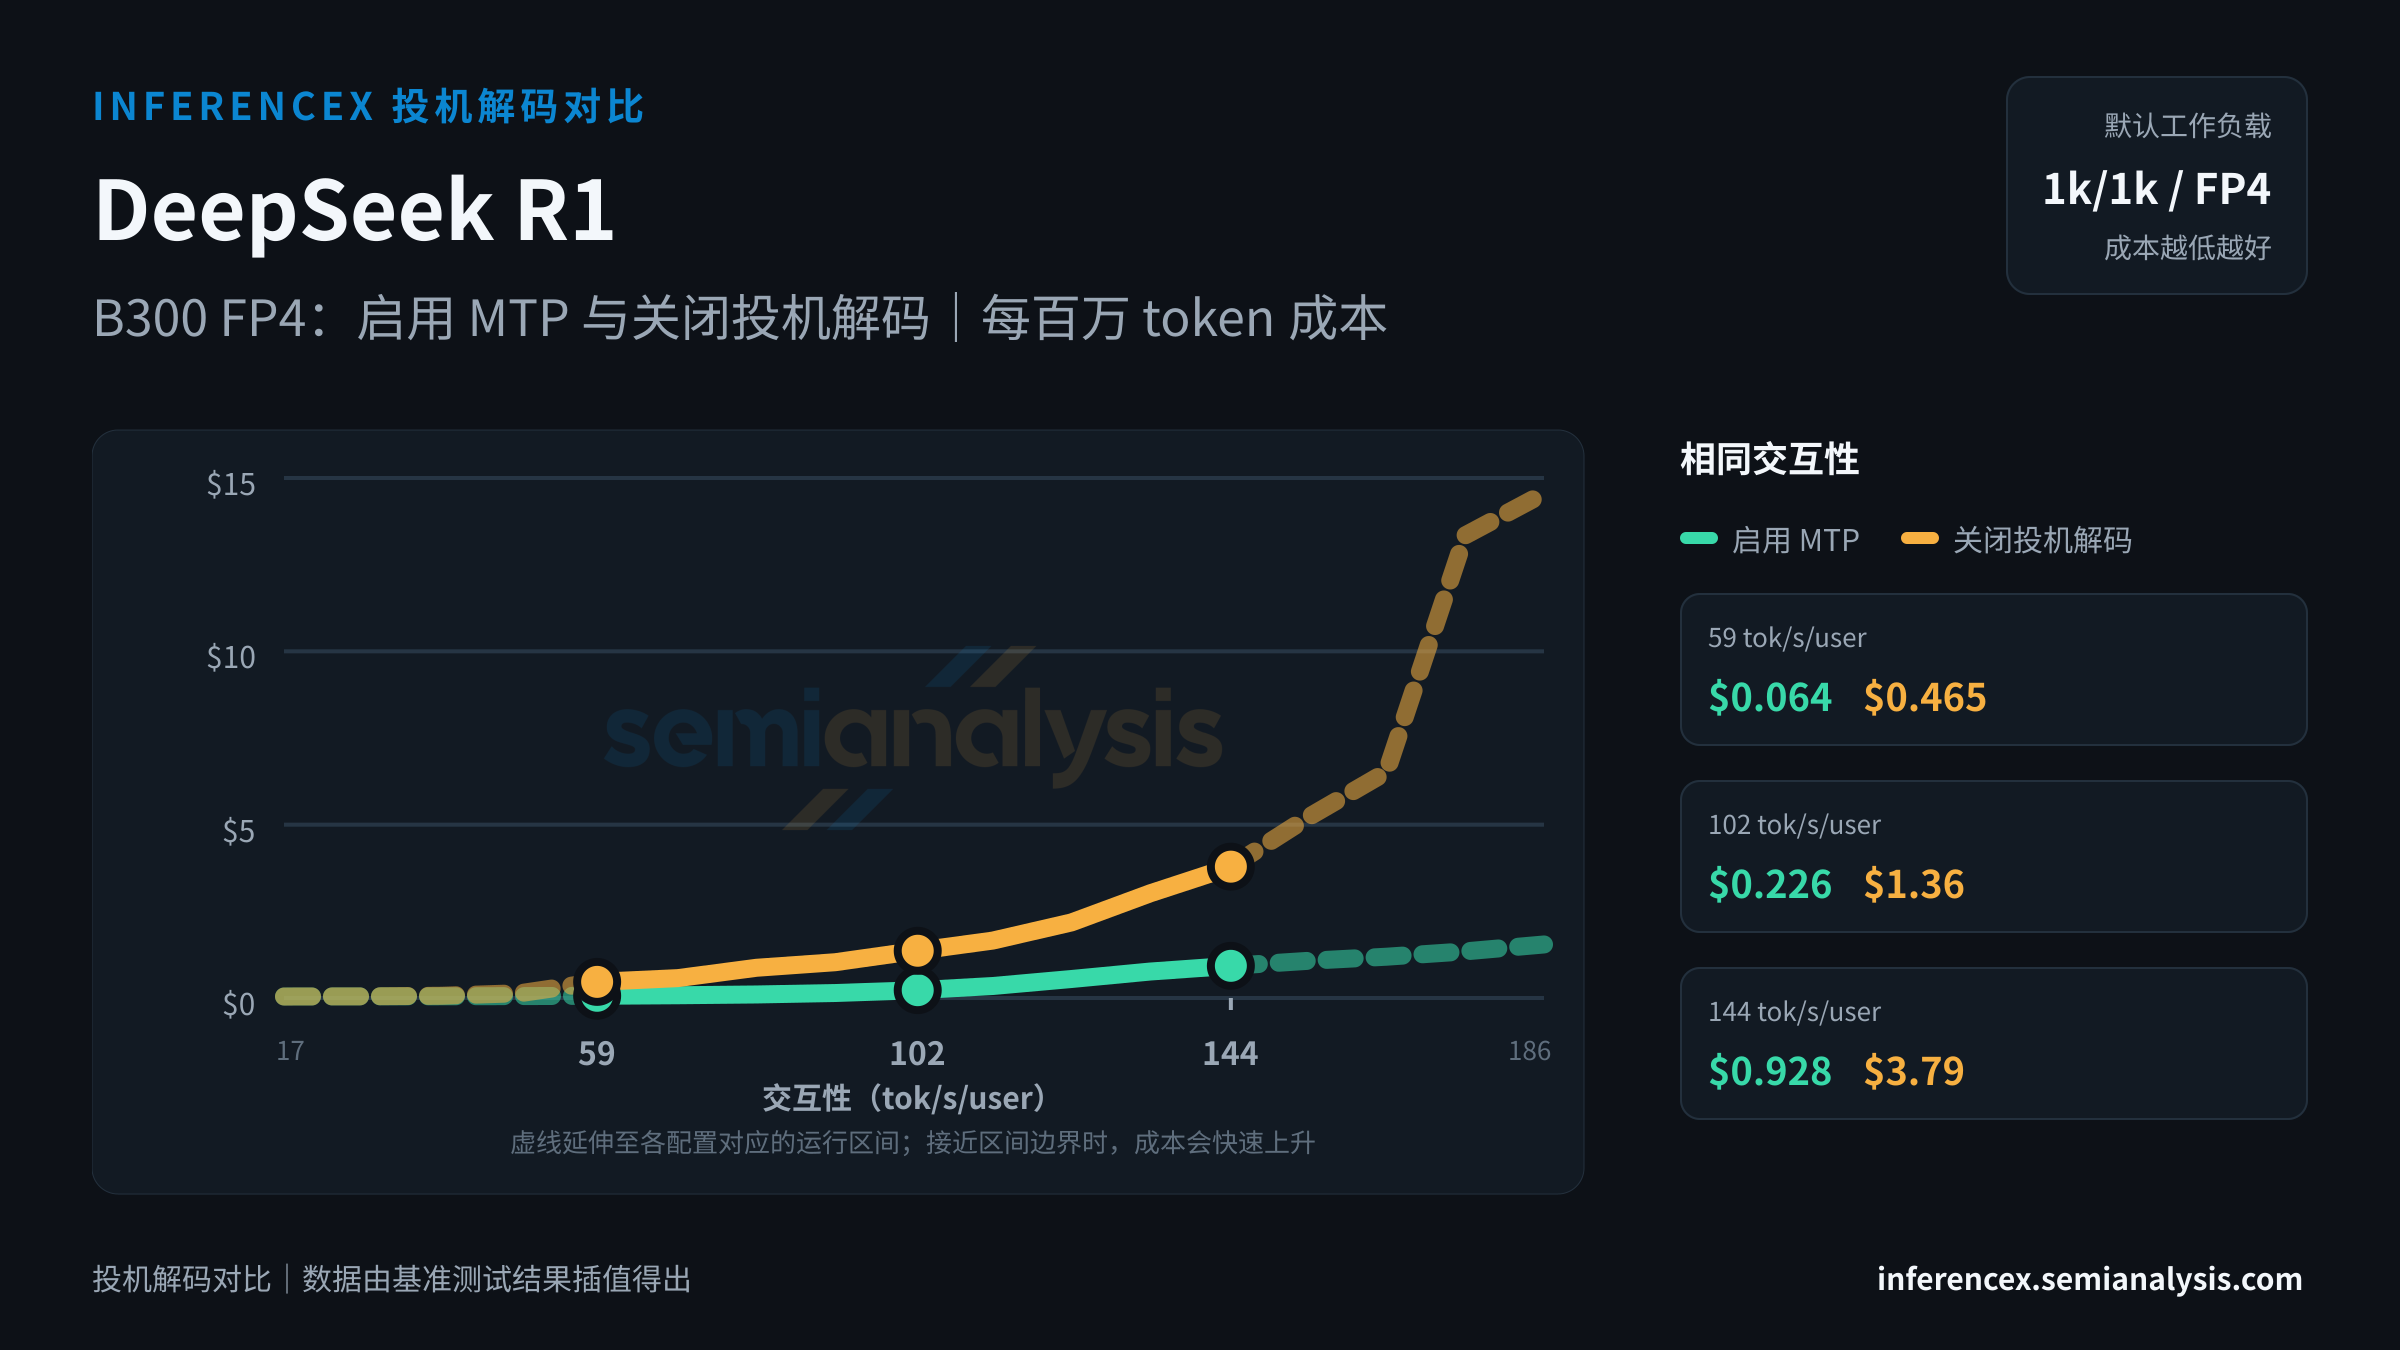
DeepSeek R1 在 B300 FP4 上的目标交互性设为 59 tok/s/user:启用 MTP 时,吞吐量为 9,811 tok/s/chip,每百万 token 成本为 $0.064;关闭投机解码时,吞吐量为 1,349 tok/s/chip,每百万 token 成本为 $0.47。在同一芯片上,MTP 的单芯片吞吐量为对方的 7.3 倍,因此每 token 成本低 86%。draft token 接受率决定了在给定并发数下,投机解码是提升性能还是拖累性能。
在 B300 FP4 上运行 DeepSeek R1,目标交互性设为 102 tok/s/user:启用 MTP 时,吞吐量为 2,781 tok/s/chip,每百万 token 成本为 $0.23;关闭投机解码时,吞吐量为 461 tok/s/chip,每百万 token 成本为 $1.36。在同一芯片上,MTP 的单芯片吞吐量为对方的 6.0 倍,因此每 token 成本低 83%。投机解码会增加 draft token 的计算量,以减少解码步数;收益取决于序列长度和批大小。
144 tok/s/user 接近 17–186 tok/s/user 交互性区间的上限。在这一运行点,启用 MTP 时,吞吐量为 676 tok/s/chip,每百万 token 成本为 $0.93;关闭投机解码时,吞吐量为 166 tok/s/chip,每百万 token 成本为 $3.79。在同一芯片上,MTP 的单芯片吞吐量为对方的 4.1 倍,因此每 token 成本低 76%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。 (以上数据基于此 URL 固定的 1k/1k · fp4 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
数据由真实基准测试结果插值得出。调整下方的目标交互性数值,即可比较不同运行点。
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP9,811关闭投机解码1,349 | 启用 MTP2,781关闭投机解码461 | 启用 MTP676关闭投机解码166 |
| 成本($/M tok) | 启用 MTP$0.064关闭投机解码$0.47 | 启用 MTP$0.23关闭投机解码$1.36 | 启用 MTP$0.93关闭投机解码$3.79 |
| tok/s/MW | 启用 MTP5,163,529关闭投机解码710,207 | 启用 MTP1,463,630关闭投机解码242,461 | 启用 MTP356,029关闭投机解码87,213 |
| 并发数 | 启用 MTP~1,092关闭投机解码~137 | 启用 MTP~272关闭投机解码~84 | 启用 MTP~103关闭投机解码~8 |