
Qwen 3.8 Flash Next 176B-A6B — H100 与 H200 每美元性能
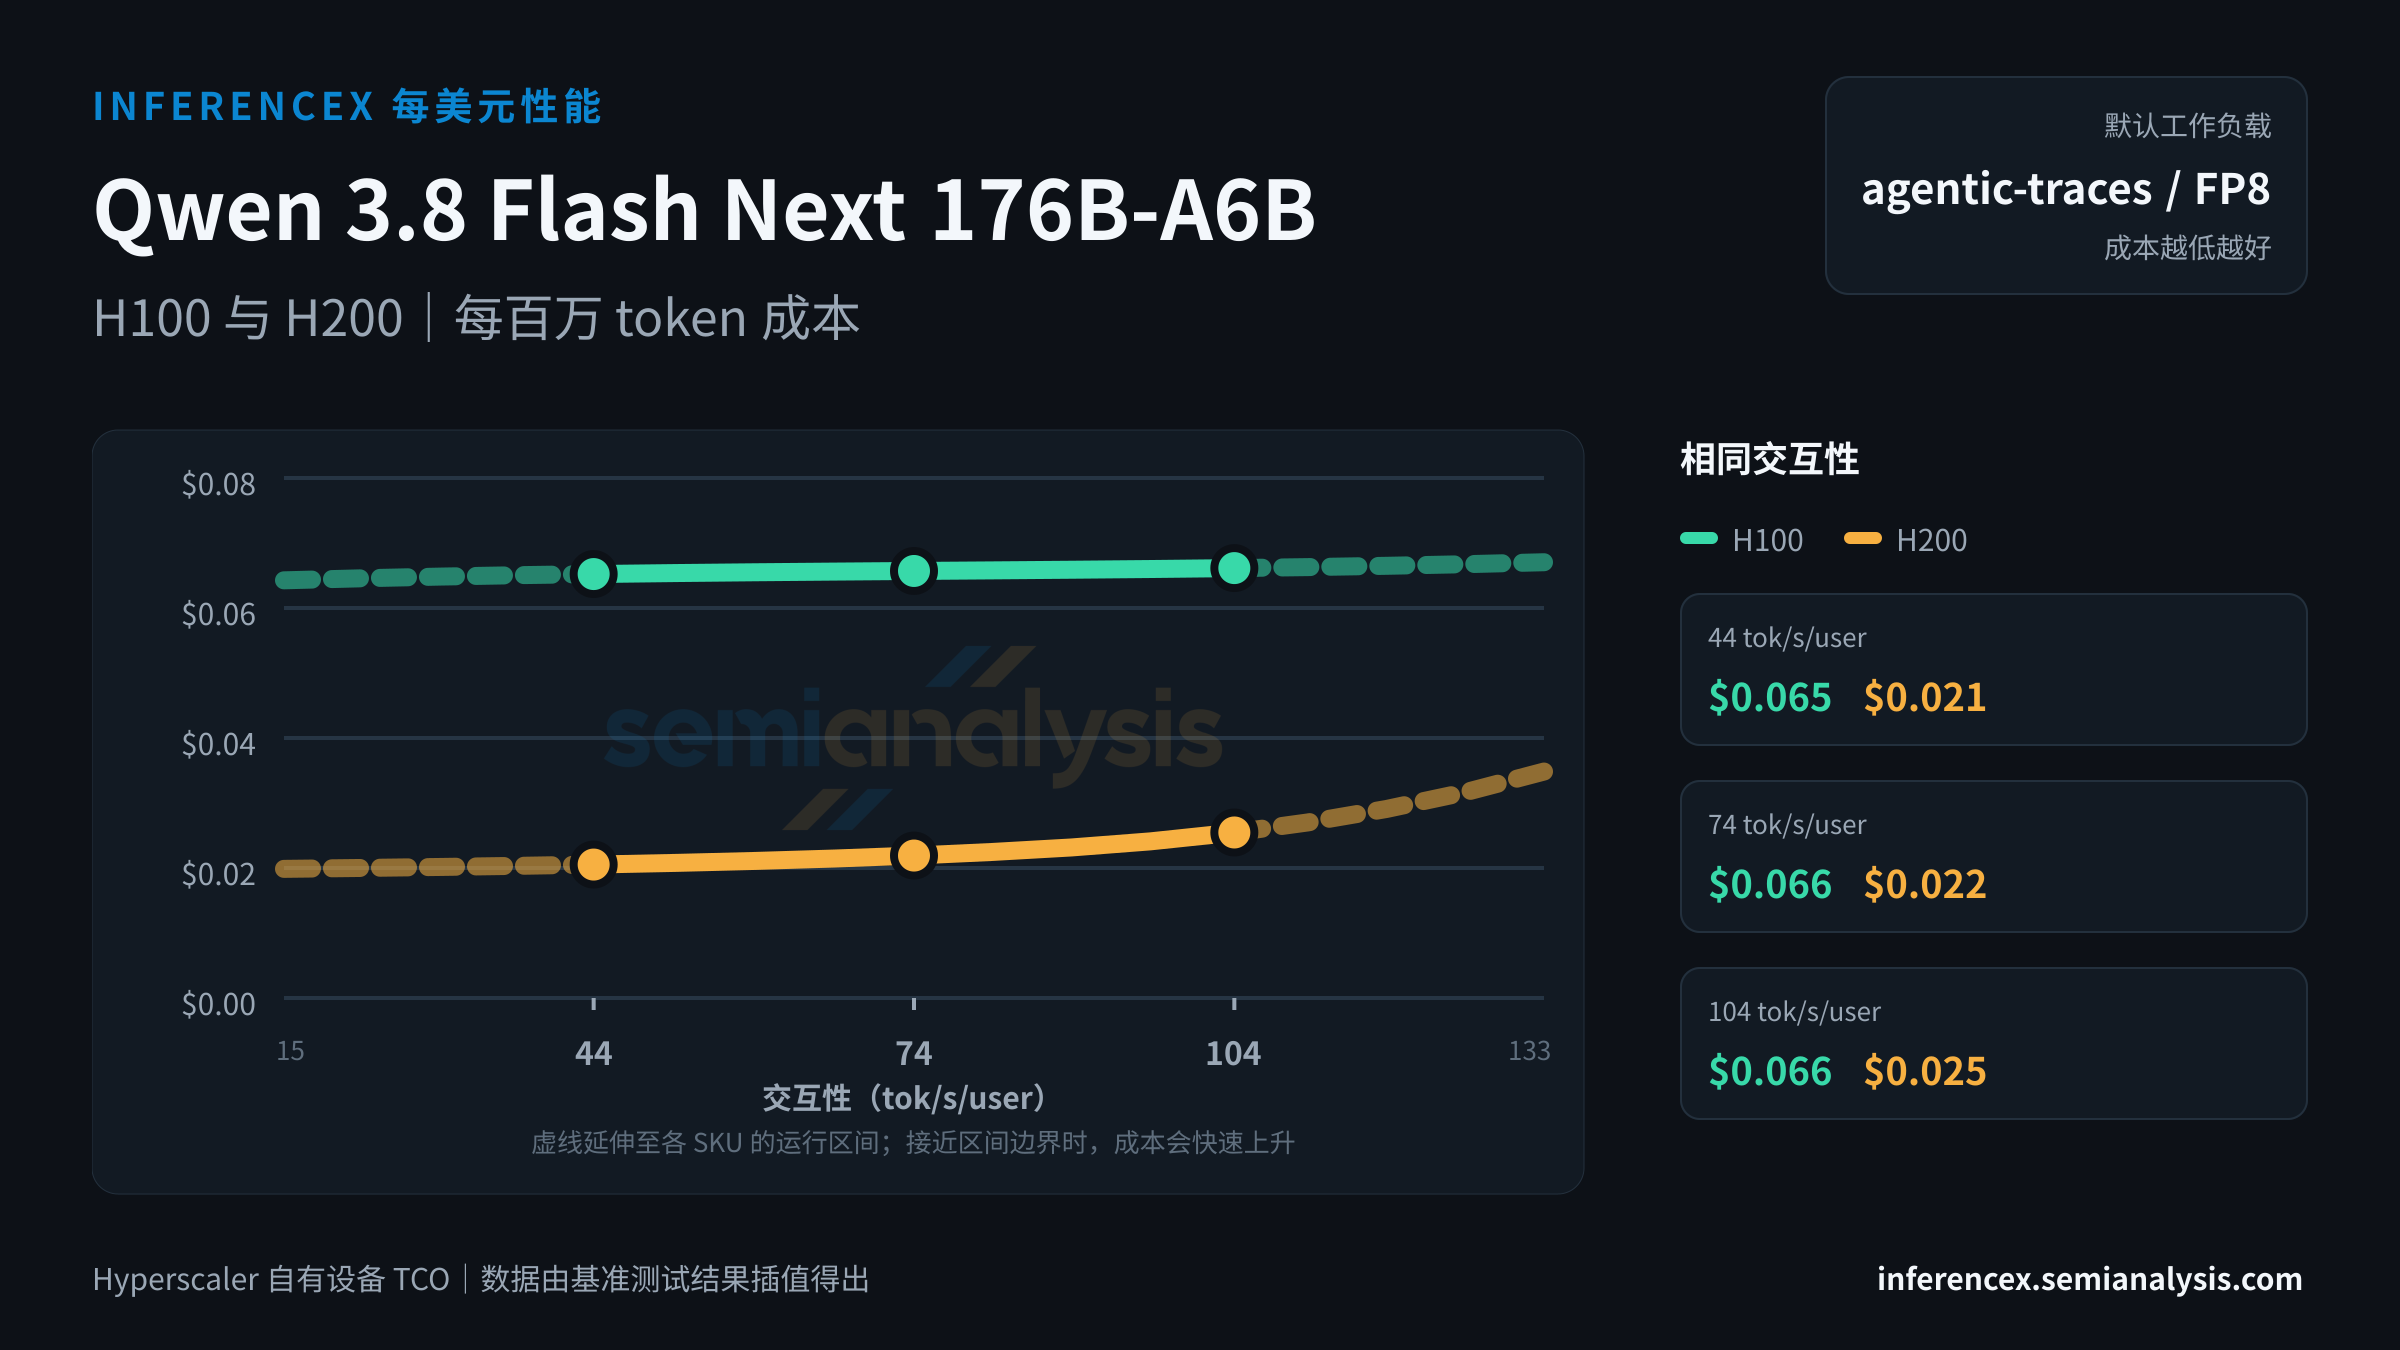
对比 H100(NVIDIA Hopper)与 H200(NVIDIA Hopper)在 Qwen 3.8 Flash Next 176B-A6B 上的每百万 token 成本。该指标采用 Hyperscaler 自有设备 TCO 口径,并按总 token 数归一化,用于比较不同 LLM 工作负载下的每美元性能。可在任一目标交互性下找出成本更低的 SKU,并通过下方图表控件切换序列长度、精度和指标;操作方式与主推理图表相同。
AgentX 回放真实的 coding agent 会话,而非定长 prompt。随着会话轮次增加,上下文不断增长;每个请求的大部分内容都可直接从 cache 读取,无需重新计算。因此,这项对比不仅取决于芯片本身的吞吐量,还会受到跨节点 KV 传输、prefix-aware routing 和 cache 容量等系统因素影响。定长序列工作负载仍是衡量 kernel 与芯片性能的清晰基线;两种场景从不同角度回答同一硬件的性能问题。 进一步了解 AgentX →
44 tok/s/user 接近 15–133 tok/s/user 交互性区间的下限。在这一运行点,H100 运行 Qwen 3.8 Flash Next 176B-A6B 的每百万 token 成本为 $0.07,H200 为 $0.02;H200 的成本效率高出 218%。
当 Qwen 3.8 Flash Next 176B-A6B 的目标交互性为 74 tok/s/user 时,H100 与 H200 的每百万 token 成本分别为 $0.07 和 $0.02;H200 每美元可处理的总 token 数多出 200%。
当 Qwen 3.8 Flash Next 176B-A6B 的目标交互性为 104 tok/s/user 时,H100 的每百万 token 成本为 $0.07,H200 为 $0.03;在这一运行点,H200 的成本效率高出 160%。 (以上数据基于此 URL 对应的默认 agentic-traces · fp8 配置;在控件中切换序列长度、精度或模型后,下方表格和图表会同步更新。)
芯片价格(Hyperscaler 自有设备口径): H100 $1.17/chip/hr · H200 $1.22/chip/hr. 来源: SemiAnalysis Market July 2026 Pricing Surveys & AI Cloud TCO Model.
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 每百万 token 成本(美元) | H100:$0.065H200:$0.021 | H100:$0.066H200:$0.022 | H100:$0.066H200:$0.025 |
| 并发数 | H100:~11H200:~15 | H100:~10H200:~13 | H100:~9H200:~11 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。
暂无数据
当前选择没有可绘制的测量数据。请检查上方的基准测试设置,或调整快捷筛选。