MiniMax M2.5/M2.7 · 每美元性能
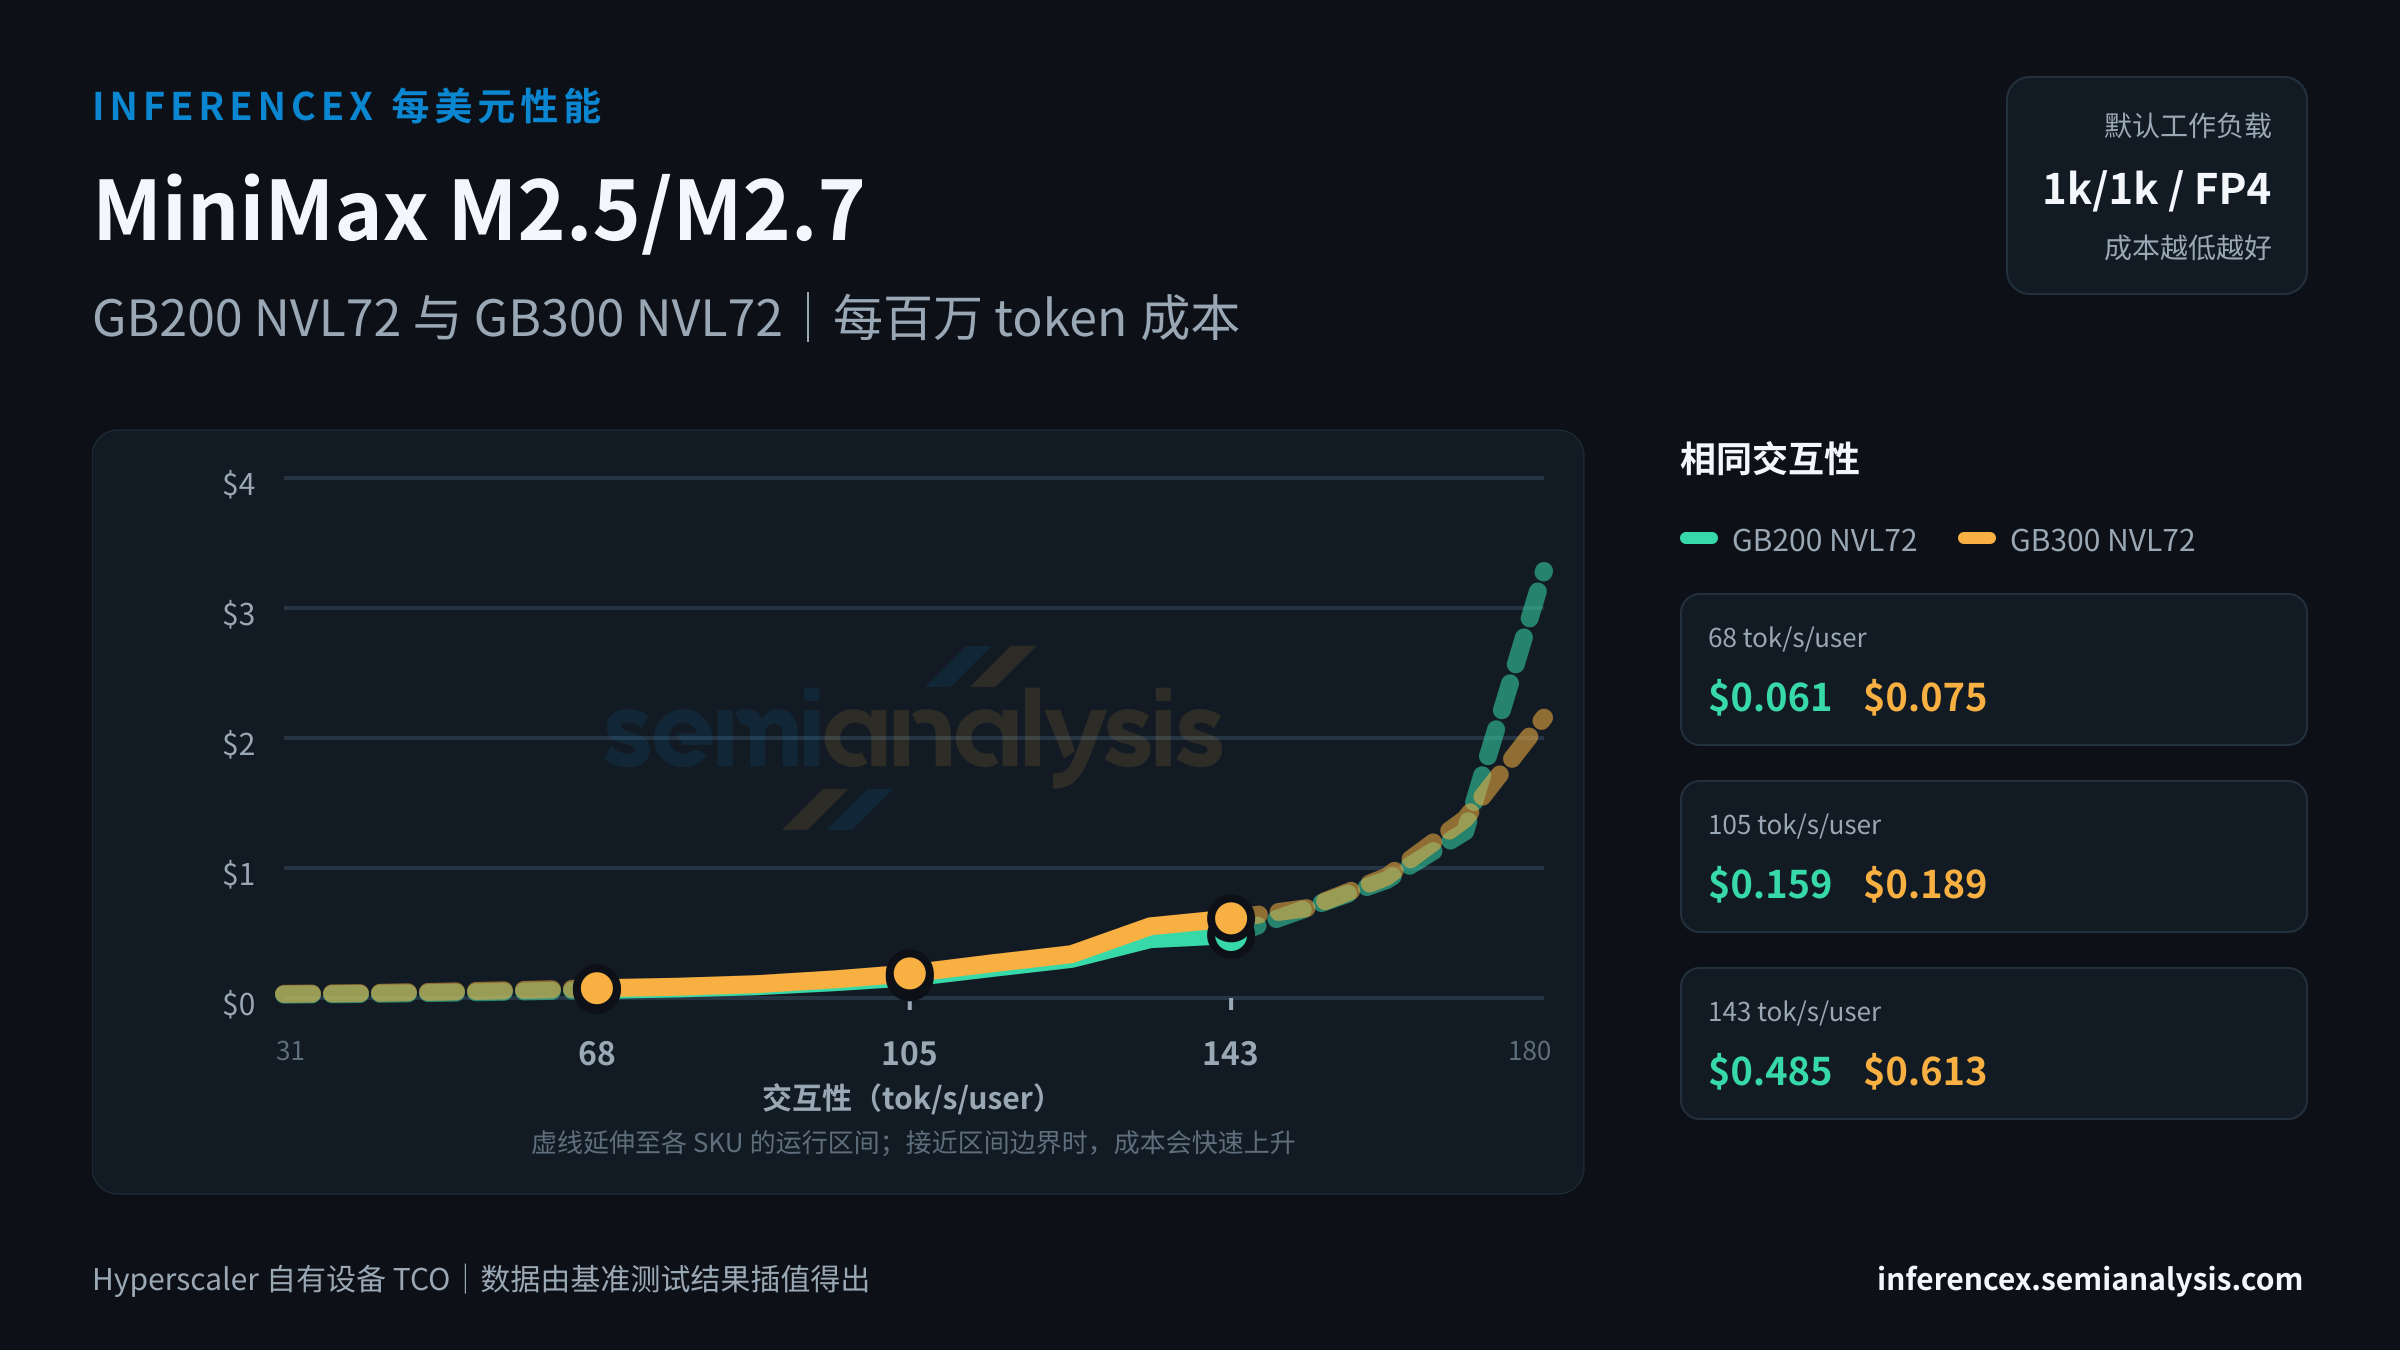
MiniMax M2.5/M2.7 — GB200 NVL72 与 GB300 NVL72 每美元性能
对比 GB200 NVL72(NVIDIA Blackwell)与 GB300 NVL72(NVIDIA Blackwell)在 MiniMax M2.5/M2.7 上的每百万 token 成本。该指标采用 Hyperscaler 自有设备 TCO 口径,并按总 token 数归一化,用于比较不同 LLM 工作负载下的每美元性能。可在任一目标交互性下找出成本更低的 SKU,并通过下方图表控件切换序列长度、精度和指标;操作方式与主推理图表相同。
在 MiniMax M2.5/M2.7 的 48 tok/s/user 运行点,GB200 NVL72 的每百万 token 成本为 $0.058,GB300 NVL72 为 $0.068;GB200 NVL72 便宜 16%。
65 tok/s/user 位于 31–100 tok/s/user 交互性区间的中段。在这一运行点,GB200 NVL72 运行 MiniMax M2.5/M2.7 的每百万 token 成本为 $0.093,GB300 NVL72 为 $0.12;GB200 NVL72 的成本低 19%。
当 MiniMax M2.5/M2.7 的目标交互性为 83 tok/s/user 时,GB200 NVL72 与 GB300 NVL72 的每百万 token 成本分别为 $0.17 和 $0.18;GB200 NVL72 每美元可处理的总 token 数高出 9%。 (以上数据基于此 URL 对应的默认 8k/1k · fp8 配置;在控件中切换序列长度、精度或模型后,下方表格和图表会同步更新。)
芯片价格(Hyperscaler 自有设备口径): GB200 NVL72 $1.86/chip/hr · GB300 NVL72 $2.31/chip/hr. 来源: SemiAnalysis Market July 2026 Pricing Surveys & AI Cloud TCO Model.
数据由真实基准测试结果插值得出。调整下方的目标交互性数值,即可比较不同运行点。
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 每百万 token 成本(美元) | GB200 NVL72$0.058GB300 NVL72$0.068 | GB200 NVL72$0.093GB300 NVL72$0.12 | GB200 NVL72$0.17GB300 NVL72$0.18 |
| 并发数 | GB200 NVL72~146GB300 NVL72~136 | GB200 NVL72~64GB300 NVL72~64 | GB200 NVL72~27GB300 NVL72~48 |